새소식
300x250
안녕하세요! 갓대희 입니다.
이번 포스팅은 [ GPT-6 Astra 출시 살펴보기 ] 입니다. : )
새 모델이 나오면 늘 비슷한 고민을 하게 된다. 얼마나 똑똑해졌는지도 궁금하지만, 결국 알고 싶은 것은 “지금 하던 일을 얼마나 덜 번거롭게 만들어줄까?”이다.
개발자라면 수정한 코드가 실제 화면에서 동작하는지까지 봐주길 원할 수 있다.
개발을 하지 않는 사람이라면 자료를 읽고, 표로 정리하고, 제출할 문서까지 만들어주길 바랄 것이다.
이번 Astra 소식은 이런 여러 단계의 작업을 이어서 수행하는 능력을 중심으로 살펴볼 만하다.
이름부터 짚어두자.
여기서 다루는 Astra는 OpenAI의 GPT-6 계열 모델이다.
구글 딥마인드가 예전에 공개한 'Project Astra'(스마트글래스·실시간 멀티모달 비서 프로젝트)와는 이름만 같을 뿐 전혀 다른 회사, 다른 제품이다. 실제로 이번 소식을 모아둔 국내 뉴스 요약 중에도 두 Astra를 섞어 쓴 경우가 있었다. 검색하다 구글 쪽 결과가 나오면 다른 제품이라고 보면 된다.
다만 출시 직후의 호평, 공식 평가, 직접 써본 후기는 서로 성격이 다르다.
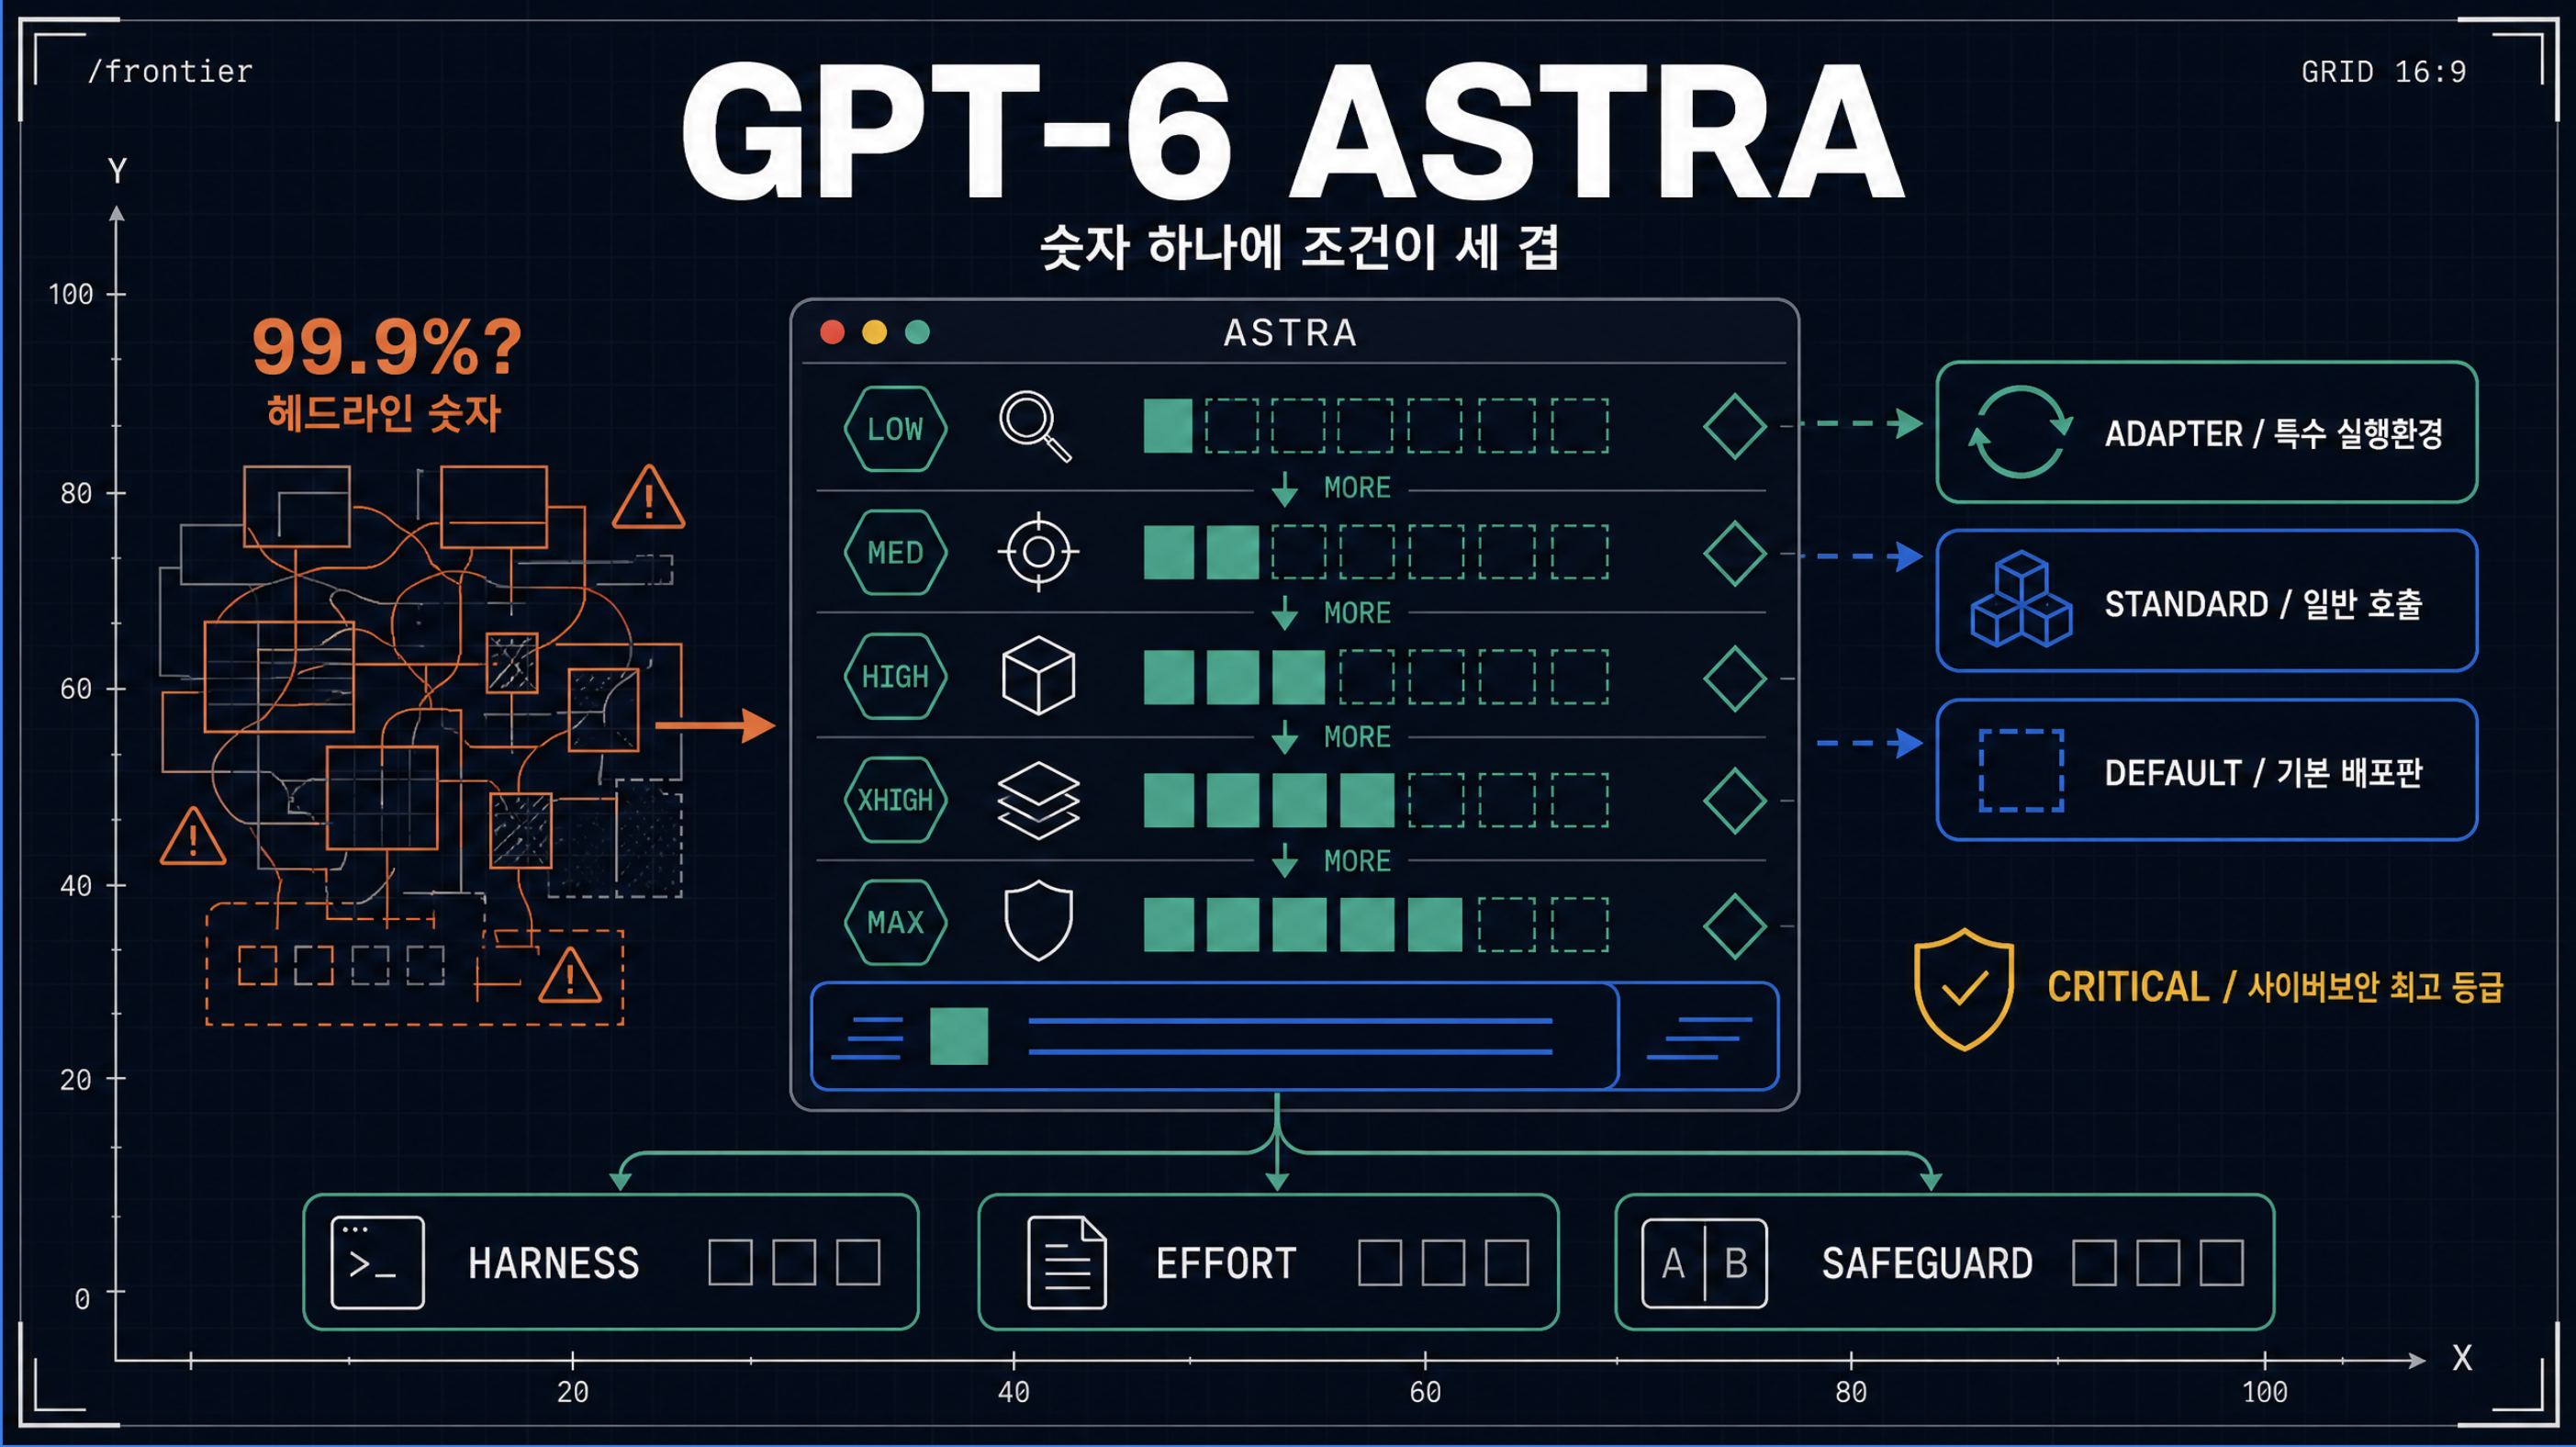
특히 “ARC-AGI-3 99.9%”, “토큰 효율 향상”, “환각 감소”는 어떤 조건에서 나온 결과인지 함께 봐야 한다.
환각(Hallucination)은 AI가 사실이 아닌 내용을 사실처럼 답하는 현상을 말한다.

OpenAI는 Astra를 복잡한 추론, 코딩, 컴퓨터 조작, 조사, 문서 작성에 쓰는 최상위 모델로 소개한다.
발표문에서는 기존 양식에 맞춘 결과물, 작업 중 추가 지시 반영, 브라우저를 통한 확인 작업을 강조했다.
여기서 컴퓨터 조작(Computer use)은 화면을 읽고 클릭하거나 입력하면서 작업하는 능력을 뜻한다.
가령 “이 버튼이 안 눌리는 이유를 설명해줘”에 답하는 것과, 테스트 화면에서 버튼을 눌러보고 수정 후 다시 확인하는 것은 맡기는 일의 범위가 다르다.
그렇다고 모델을 선택하는 순간 모든 앱에 자동으로 접근하는 것은 아니다.
모델, 실행 도구, 접근 권한이 함께 준비돼야 한다.
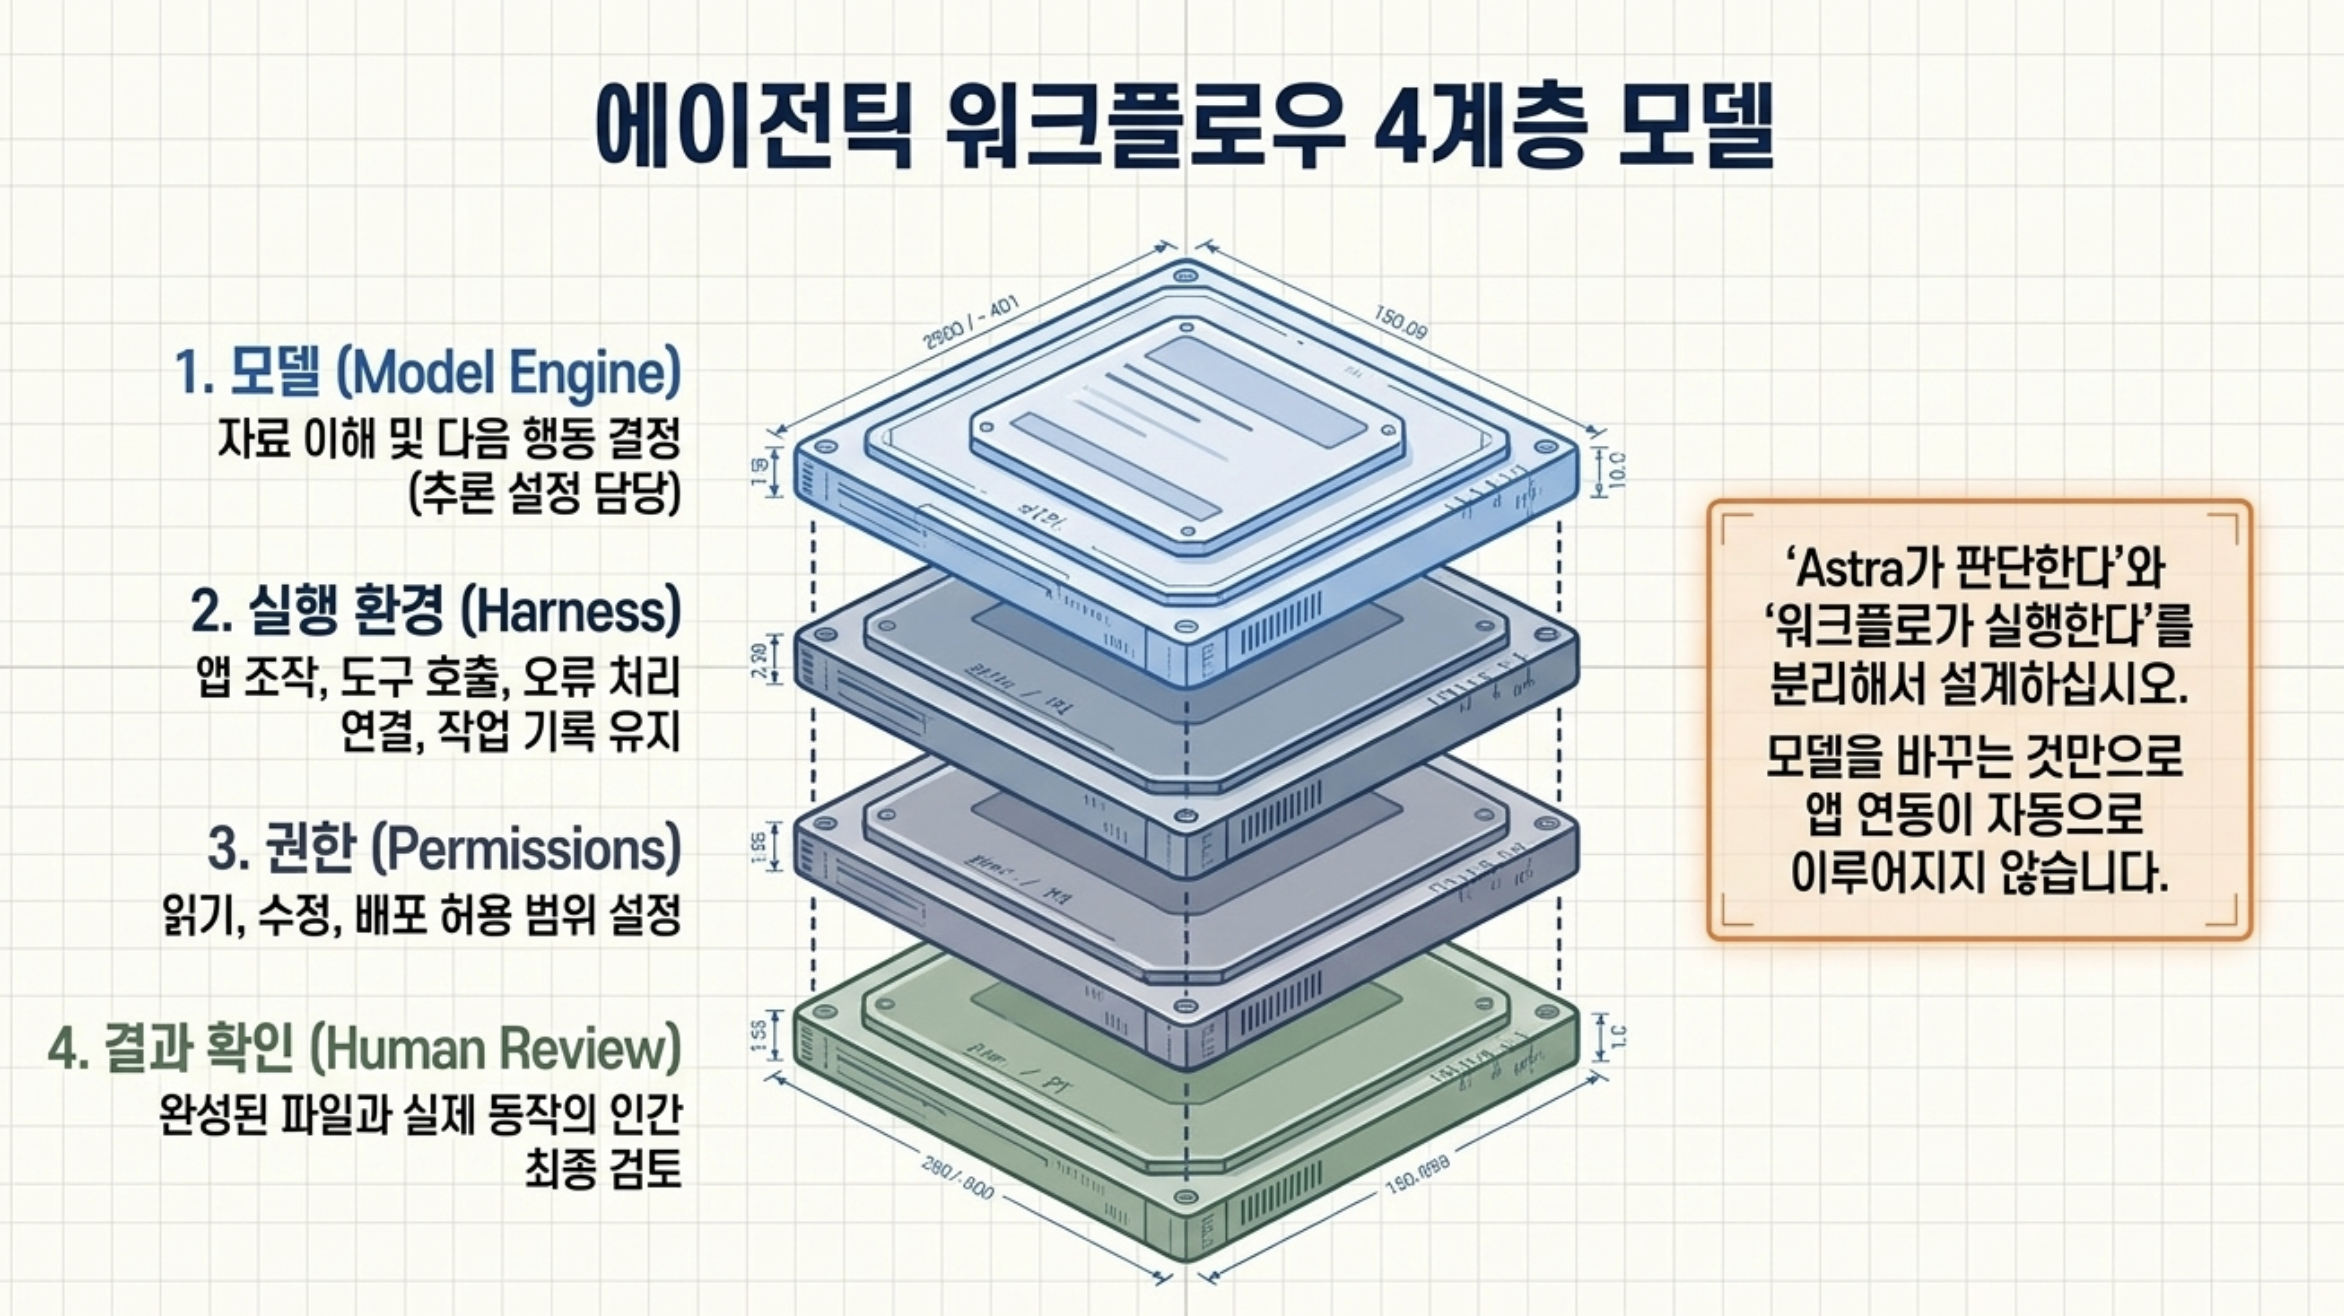
API로 질문만 보내는 프로그램과 브라우저·파일 도구를 연결한 에이전트는 같은 Astra를 사용해도 할 수 있는 일이 다르다.
| 구분 | 일반인이 이해할 설명 | 개발자가 확인할 부분 |
|---|---|---|
| 모델 | 자료를 이해하고 다음 행동을 판단하는 부분 | 어떤 모델과 추론 설정을 사용하는가 |
| 실행 환경 | 파일을 열고 앱을 조작할 수 있게 해주는 작업 공간 | 도구 호출, 작업 기록, 오류 처리를 어떻게 연결하는가 |
| 권한 | 어느 자료를 읽고 무엇을 바꿔도 되는지 | 읽기·수정·배포 권한을 어디까지 주는가 |
| 결과 확인 | 완성된 파일과 실제 동작을 확인하는 과정 | 테스트 결과와 변경 내용을 사람이 검토할 수 있는가 |
위 표는 동작을 이해하기 위한 설명이다.
특히 n8n 같은 자동화에 모델을 붙일 때는 “Astra가 판단한다”와 “워크플로가 실제로 실행한다”를 나눠 설계하면 이해하기 쉽다.

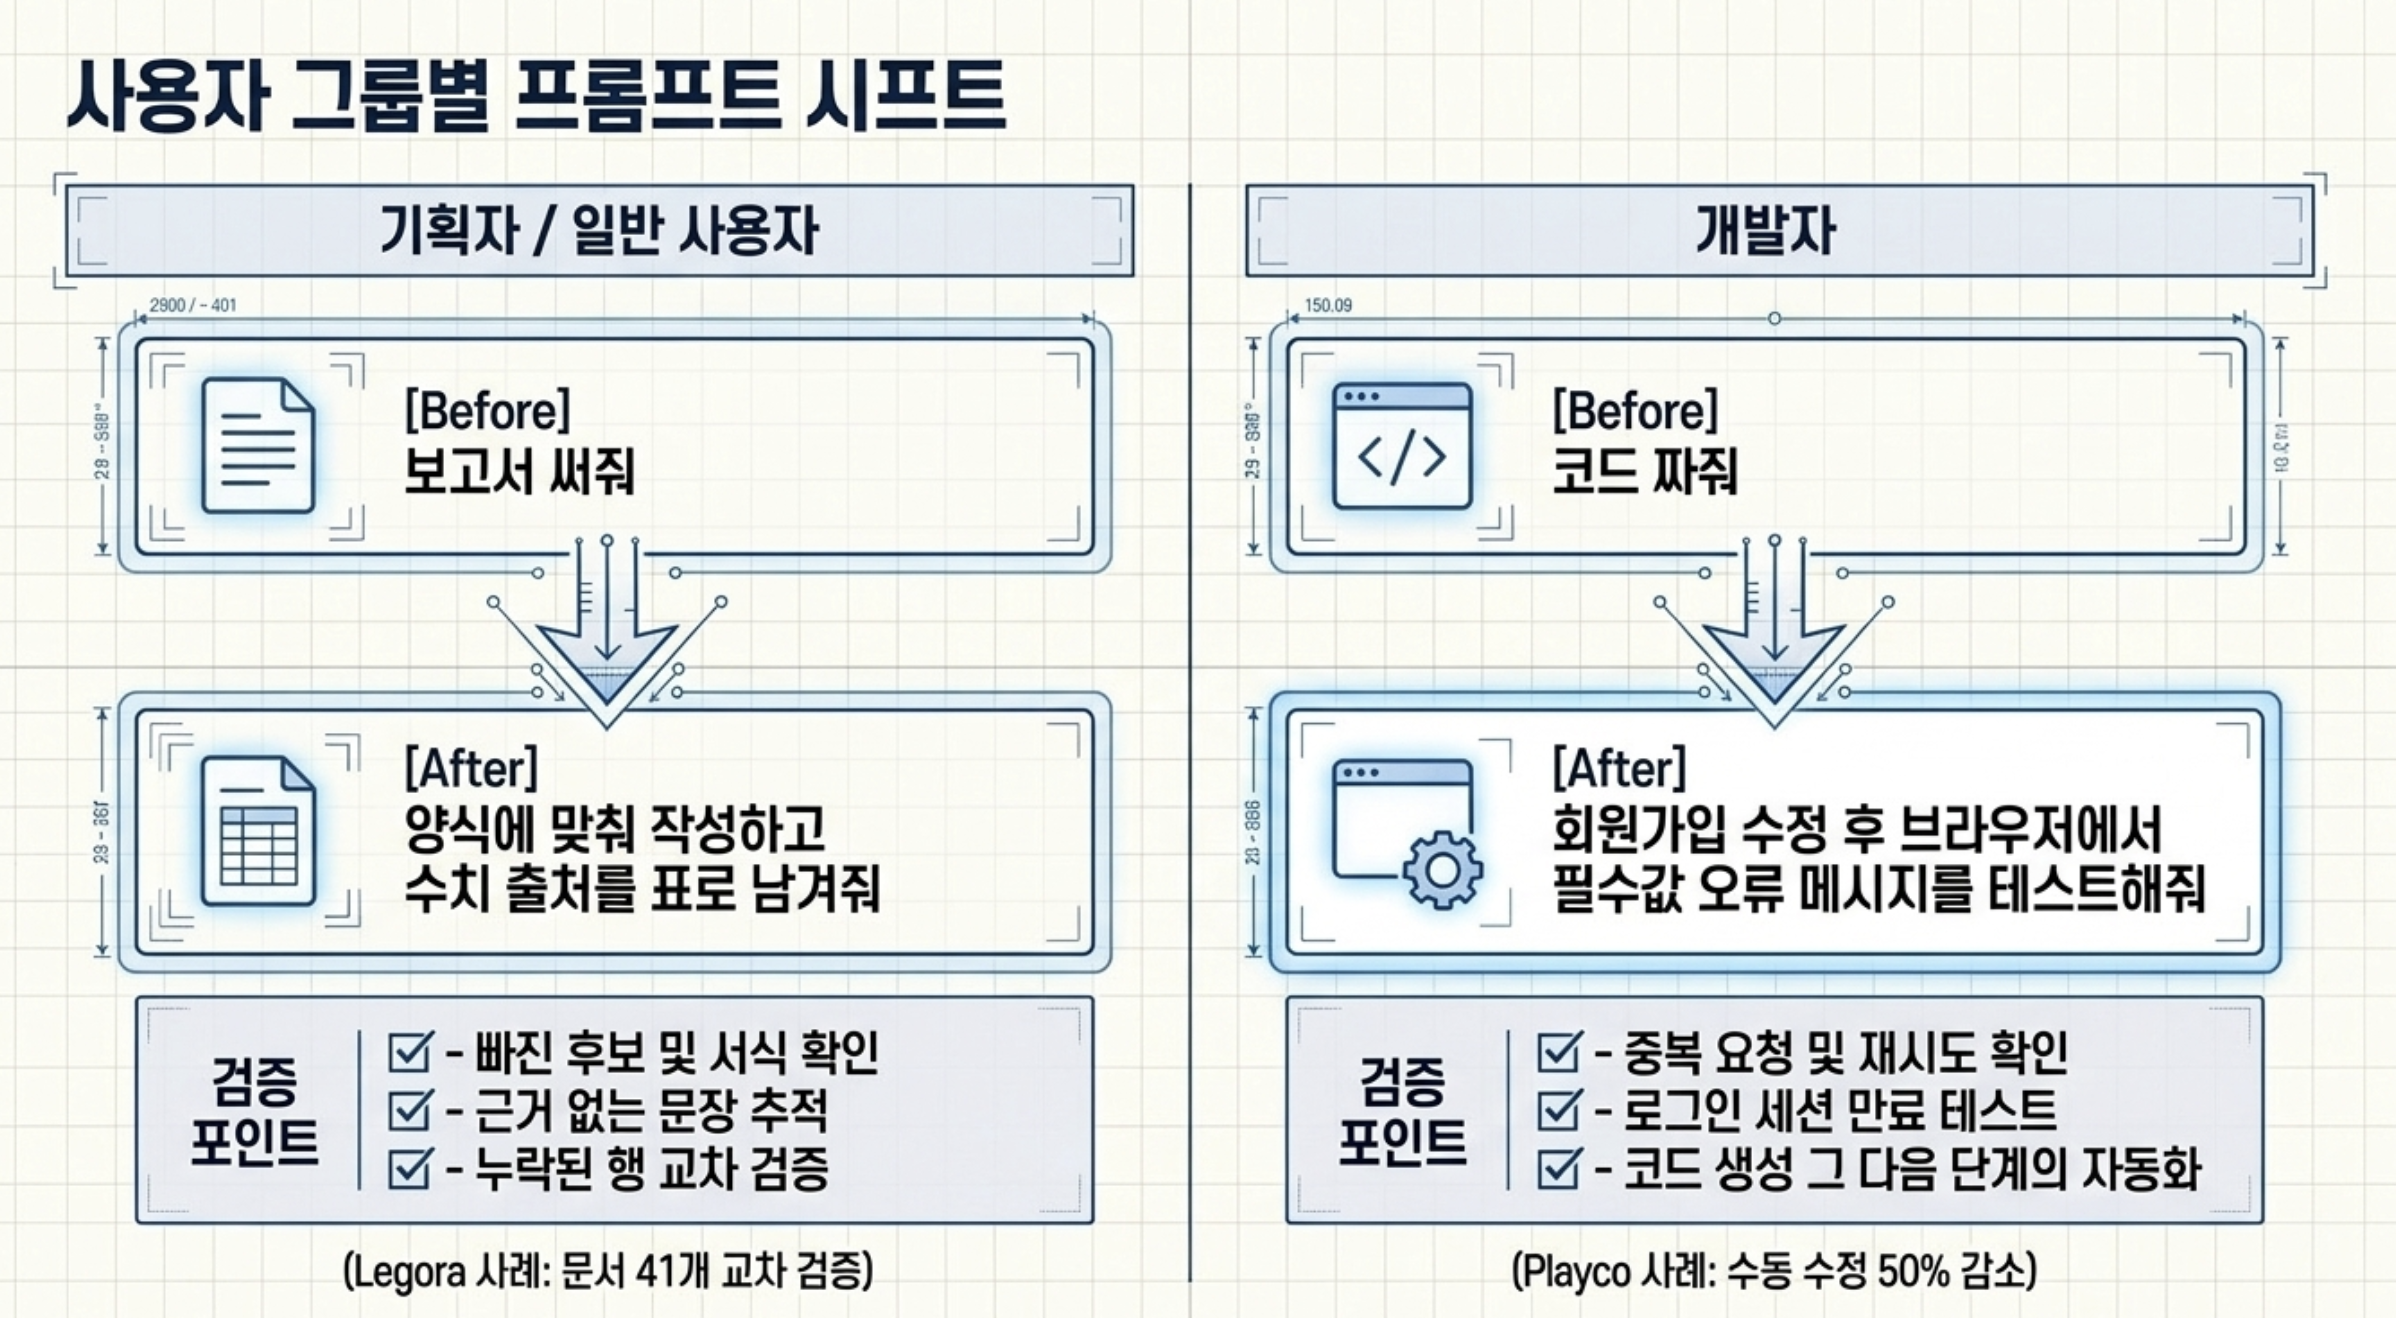
모델 이름보다 먼저 자신이 원하는 결과물을 떠올려보면 된다. “보고서에 쓸 내용을 알려줘”와 “첨부 양식에 맞춰 보고서를 작성하고 숫자의 출처를 붙여줘”는 확인해야 할 항목부터 달라진다.
| 맡겨볼 일 | 요청에 함께 넣으면 좋은 내용 | 결과에서 확인할 것 |
|---|---|---|
| 여러 자료 비교 | 비교 항목, 우선순위, 기준 날짜 | 빠진 후보, 서로 다른 조건을 섞은 비교 |
| 문서·발표자료 작성 | 실제 양식, 독자, 분량, 문체 예시 | 서식, 근거 없는 문장, 숫자 출처 |
| 스프레드시트 정리 | 열의 의미, 계산 규칙, 빈 값 처리 | 합계, 중복, 계산식, 누락된 행 |
| 생활 정보 조사 | 지역·예산·일정 등 필요한 조건 | 운영 여부, 예약 조건, 확인하지 못한 정보 |
이 표는 활용 아이디어이며 성공 사례를 재현한 결과는 아니다. 처음에는 자신이 정답을 확인할 수 있는 작은 자료로 시작하는 편이 좋다. 결과가 그럴듯한지에 더해 원문과 맞는지, 부탁한 항목을 빠짐없이 처리했는지를 볼 수 있기 때문이다.
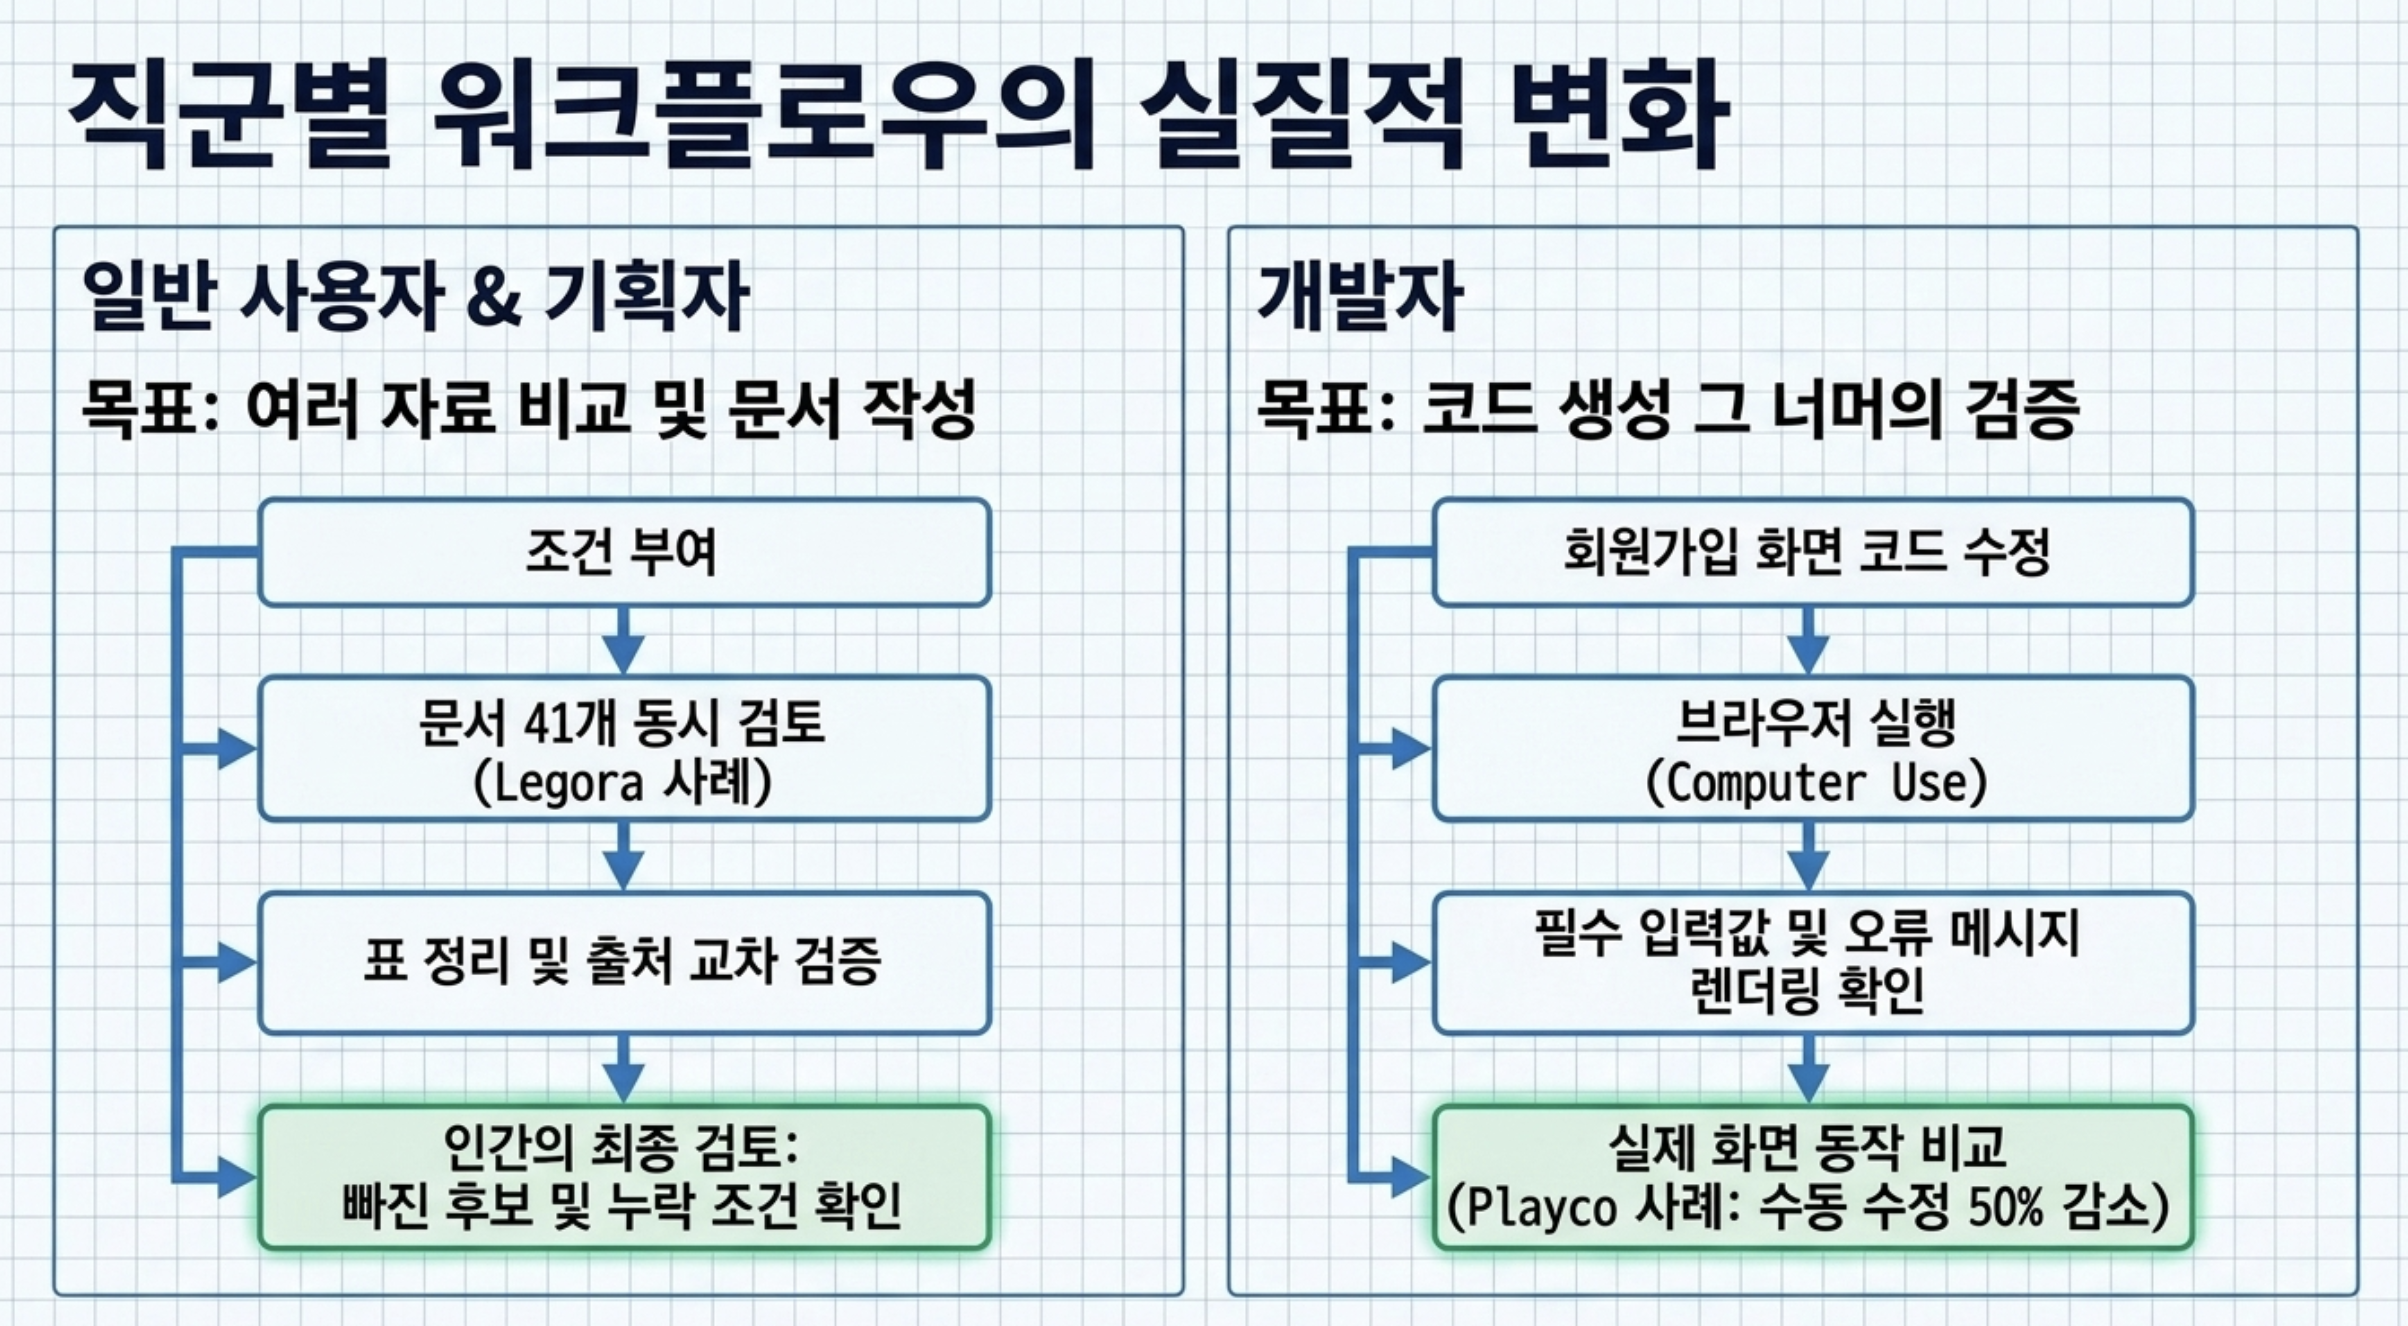
공개 기업 사례도 살펴보자. Legora는 재무제표 수치와 근거 문서를 맞춰보는 작업에서 Astra 기반 에이전트가 문서 41개를 한 번에 검토했다고 소개했다. 해당 작업 평가의 개선은 약 40%였지만, 자사의 전체 평가 과제에서 평균 개선 폭은 약 3%였다. 같은 사례 안에서도 숫자가 가리키는 범위가 다르다.
이 사례에서는 전문가가 최종 판단을 맡았다. 특정 회사가 구성한 에이전트의 결과이므로, ChatGPT에 문서 41개를 올리면 누구나 같은 정확도를 얻는다고 읽을 수는 없다.
일반 사용자 입장에서는 숫자 자체보다 작업 방식이 참고할 만하다. 예를 들어 여행 후보를 조사시킬 때도 추천 문장만 받기보다, 비교한 기준과 확인한 출처를 표로 남기게 요청해보자. 나중에 틀린 내용을 찾아 고치기가 훨씬 수월하다.
Playco는 게임 개발 도구 Playbot에 Astra를 사용한 사례를 공개했다. 하나의 기본 프로토타입에서 테마가 다른 게임 세 가지를 만들었고, 이전 모델과 비교해 수동 수정이 50% 줄었다고 보고했다. 대부분 첫 결과가 동작했지만 한 버전은 성능 수정이 필요했다.
이것은 Playco가 소개한 특정 개발 사례다. 전체 개발자의 작업 시간이 절반으로 줄었다는 통계는 아니다. 다만 코드를 작성하고, 실행해보고, 결과를 보고 다시 수정하는 과정을 평가했다는 점은 눈여겨볼 만하다.
쇼핑몰 개발에 대입하면 다음과 같은 과제를 생각해볼 수 있다.
이는 필자의 업무에서 측정한 결과가 아니라 Astra를 평가할 과제 예시이다.
같은 요청을 기존 모델에도 맡겨보고, 수정 횟수와 검토 시간을 기록하면 자신에게 유용한 변화인지 판단할 수 있다.
공식 사례 말고, 개발자 개인이 재현 조건을 밝히고 공유한 테스트도 있다.
개발자 @hqmank는 몇 달째 새 모델이 나올 때마다 같은 테스트를 반복해왔다고 밝혔다.
Three.js로 만든 3D 지구본 대시보드를 프롬프트 하나와 참조 이미지 하나만 주고 처음부터 다시 만들게 하는 테스트다.
본인 기준으로는 GPT-6 Astra가 이 테스트를 한 번에 통과한 첫 모델이었다고 전했다.
특히 참조 이미지에는 있지만 프롬프트에는 적지 않은 "낮/밤 모드 토글"을 Astra가 이미지만 보고 스스로 캐치해서 구현했다는 점, 다른 모델들이 그리지 못했던 2D/3D 뷰 전환을 기본으로 넣어줬다는 점을 꼽았다.
비슷한 시기 톰 크르차(@tomkrcha)는 Three.js로 기차 두 대를 완전히 코드에서 생성한 데모를 공유했다.
3D 모델 파일을 따로 쓰지 않고, 치수·프로파일·지오메트리 함수만으로 타입스크립트 코드가 형태를 만들어냈다고 밝혔다.
바퀴가 굴러가는 동작과 분해·재조립 애니메이션까지 전부 코드로 제어되며, 브라우저 안에서 매끄럽게 돌아간다고 전했다.
두 사례 모두 개발자 한 명이 자기 기준으로 진행한 테스트다.
독립적으로 재현되거나 검증된 결과는 아니며, "픽셀 퍼펙트"나 "처음으로 성공한 모델" 같은 표현도 작성자 본인의 판단이다.
다만 참조 이미지에서 프롬프트에 없는 디테일을 읽어내는 능력, 코드만으로 복잡한 3D 지오메트리를 만들어내는 능력은 앞서 본 Playco 사례("공간 추론과 시각 인식이 개선됐다")와 방향이 겹친다는 점에서 참고할 만하다.
OpenAI는 Codex에서 Astra가 문맥 창을 넘겨 작업할 때 메모를 유지하고, 이전 대화와 도구 결과를 검색하는 실험적 기능도 소개했다. 발표 시점에는 별도 설정으로 켤 수 있으며 이후 기본 적용을 예고했다.
리팩터링 중 “이 방법은 앞에서 해봤지만 실패했다”는 기록을 다시 찾을 수 있다면 중복 작업을 줄이는 데 도움이 될 수 있다.
다만 발표된 맥락 관리 기능을 영구 기억이나 무한한 문맥으로 설명해서는 안 된다.
모델의 API 사양과 Codex의 기록 관리 기능도 서로 구분해야 한다.
ARC-AGI-3는 익숙하지 않은 게임 환경에서 규칙과 목표를 파악하고 행동하는 능력을 평가한다.
ARC Prize는 Astra의 성과를 높게 평가하면서도, 이 벤치마크를 잘 푼 것이 AGI 달성의 증거는 아니라고 명시했다. 제한된 규칙과 목표가 있는 게임이 현실 세계 전체를 대신할 수는 없기 때문이다.
특히 실행 환경인 Harness(모델에 정보와 도구를 전달하고 작업을 이어주는 프로그램)에 따라 결과가 크게 달랐다.
추론 설정은 모델이 답을 내기까지 검토에 들일 노력을 조절하는 옵션이다.
아래는 ARC Prize가 공개한 Semi-Private 평가에서 같은 추론 설정끼리 비교한 값이다.
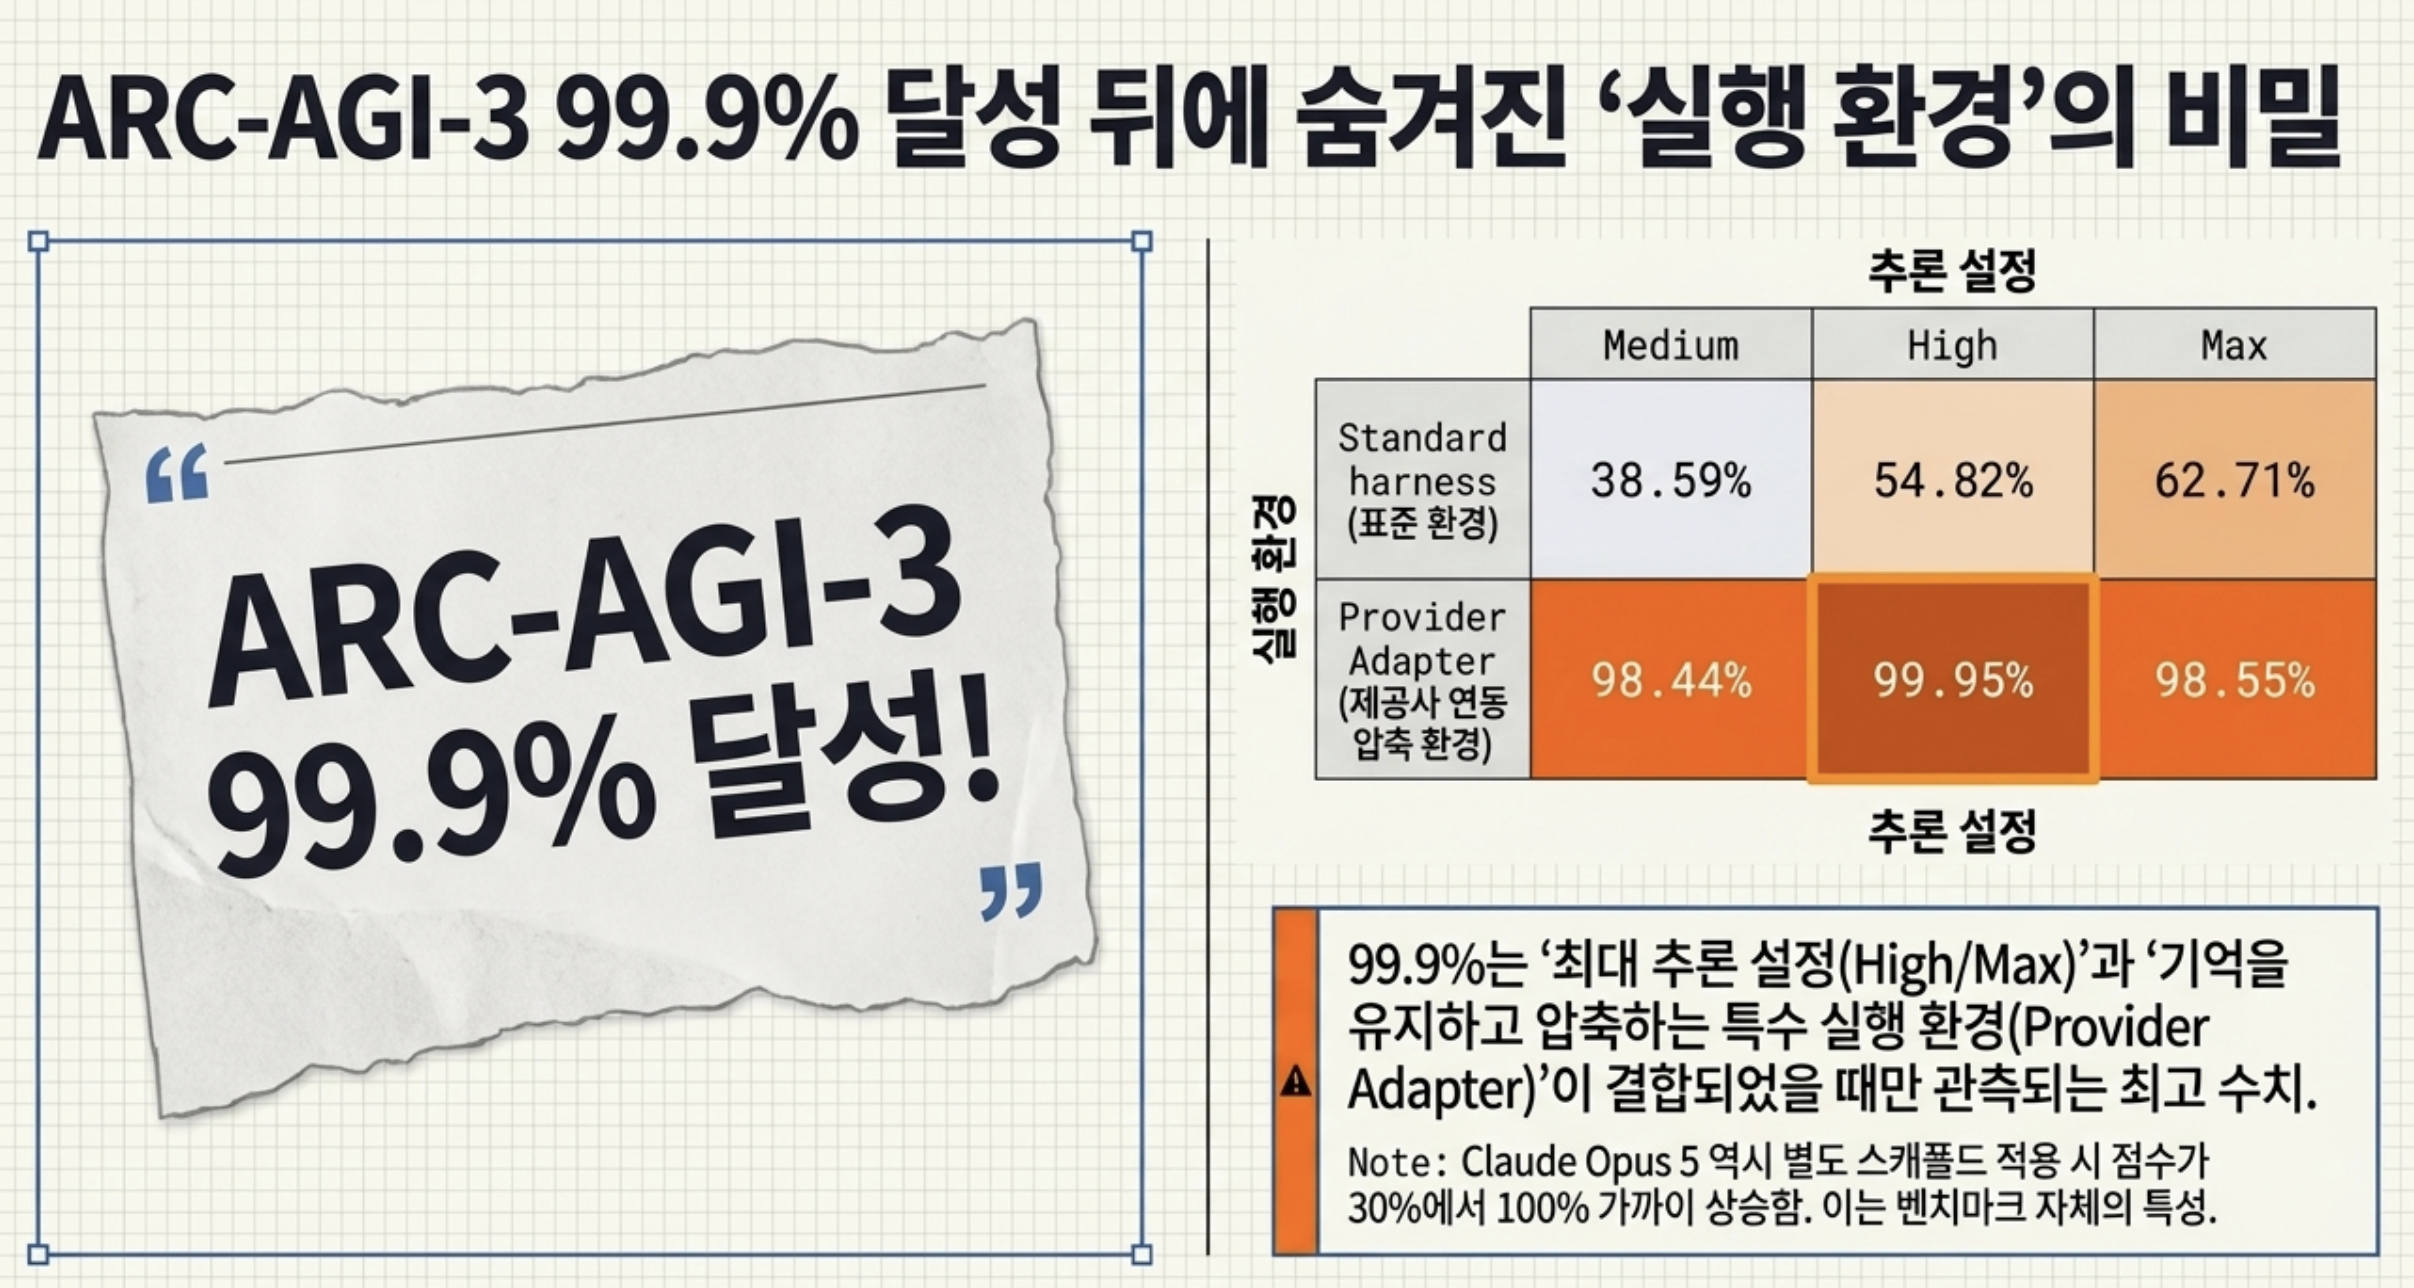
| 추론 설정 | Standard harness(표준 실행 환경) | Provider Adapter harness(제공사 연동 실행 환경) |
|---|---|---|
| medium | 38.59% | 98.44% |
| high | 54.82% | 99.95% |
| max | 62.71% | 98.55% |
출처: ARC Prize 결과표. 발표 요약은 99.9%, 상세 결과표는 99.95%로 표기한다. 이를 임의로 100%로 바꾸지 않았다.
Standard도 모델이 선택한 메모를 보존할 수 있다.
Provider Adapter는 호출 사이의 내부 추론 상태를 유지하고 긴 대화를 압축하는 기능을 활용한다. 따라서 위 비교를 "기억 없는 모델과 기억 있는 모델"로 단순화하면 부정확하다.
이 현상이 Astra만의 특이 사례인지도 짚어볼 만하다. 같은 시기 공개된 자료에 따르면 Claude Opus 5도 기본 설정에서는 ARC-AGI-3에서 30% 안팎의 점수를 냈지만, NVIDIA의 AVO나 AWS의 Strands 같은 별도 스캐폴드(모델을 감싸는 실행 도구)를 씌우면 점수가 100%에 가깝게 올라갔다고 한다.
즉 "실행 환경에 따라 점수가 크게 벌어지는 현상"은 오픈AI 모델에 국한된 이야기가 아니라, ARC-AGI-3류 벤치마크 자체의 특성에 가깝다. 이 부분은 아직 여러 매체가 정리하는 중이라 이 글에서는 방향성 정도로만 소개한다.
각 환경의 최고 관측값을 뽑으면 Standard는 max의 62.7%, Adapter는 high의 99.9%가 된다. 이때는 추론 설정도 다르므로, 숫자 두 개만으로 실행 환경의 효과를 계산하면 안 된다.
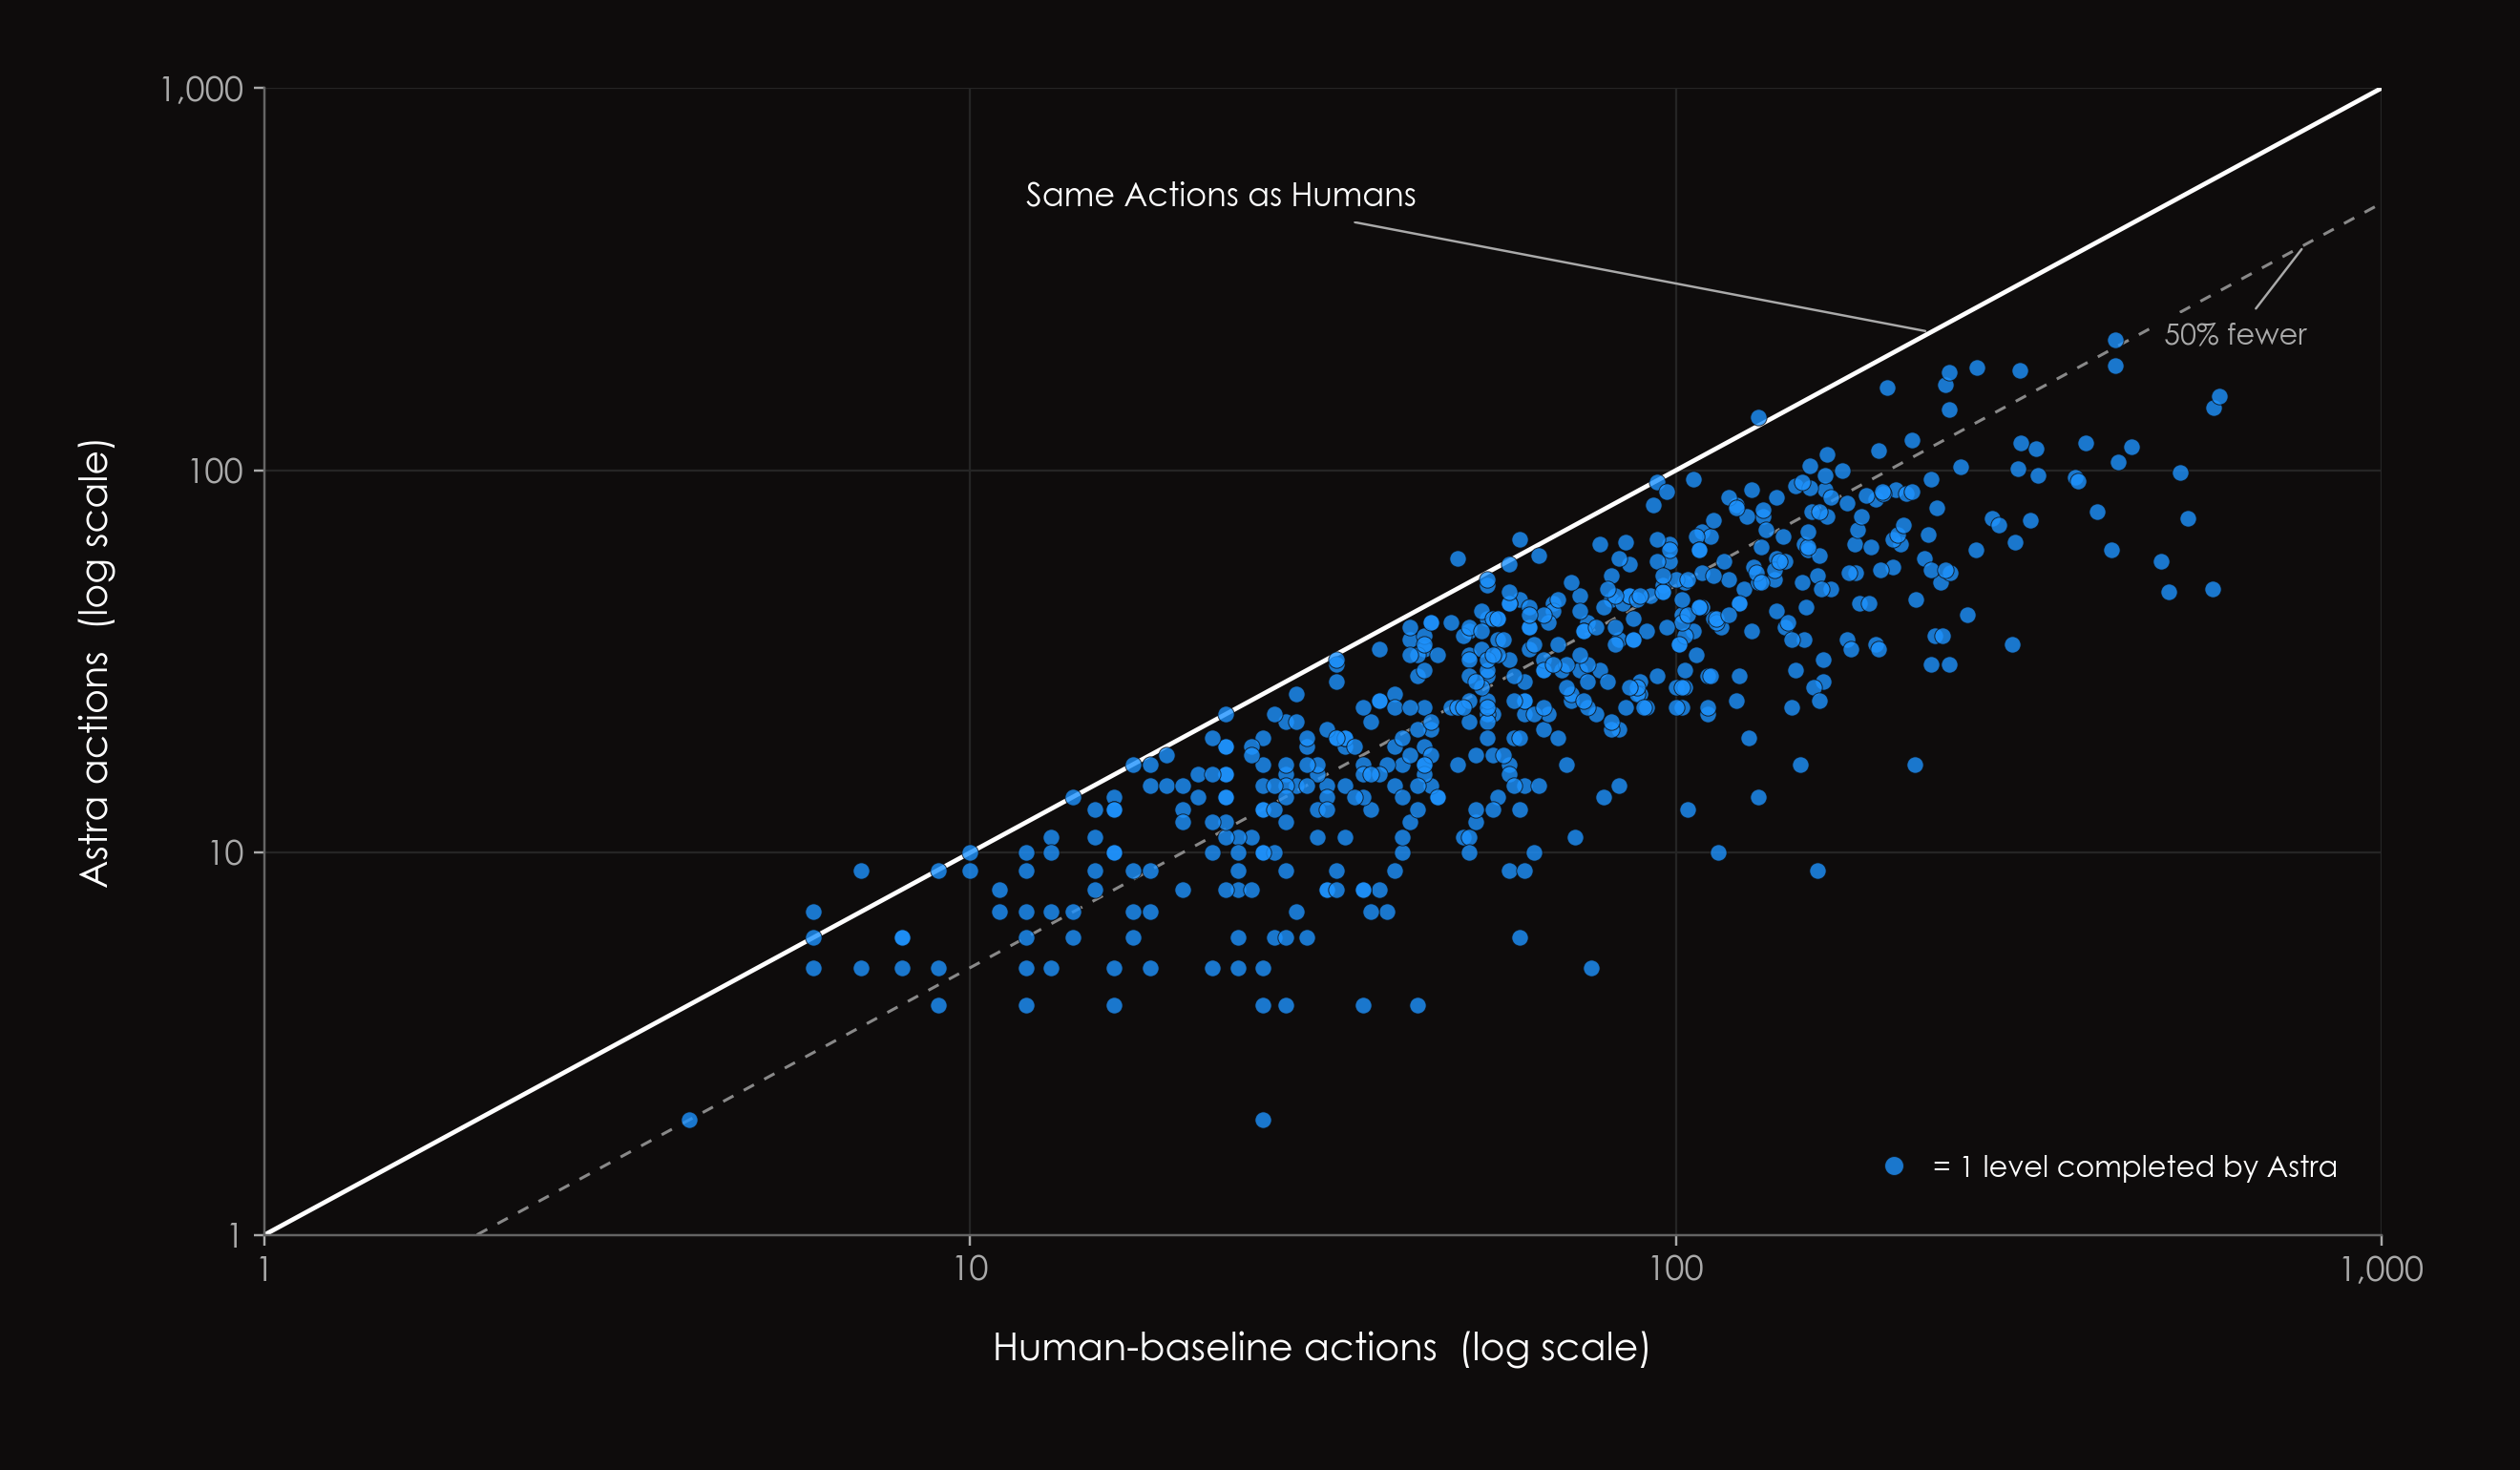
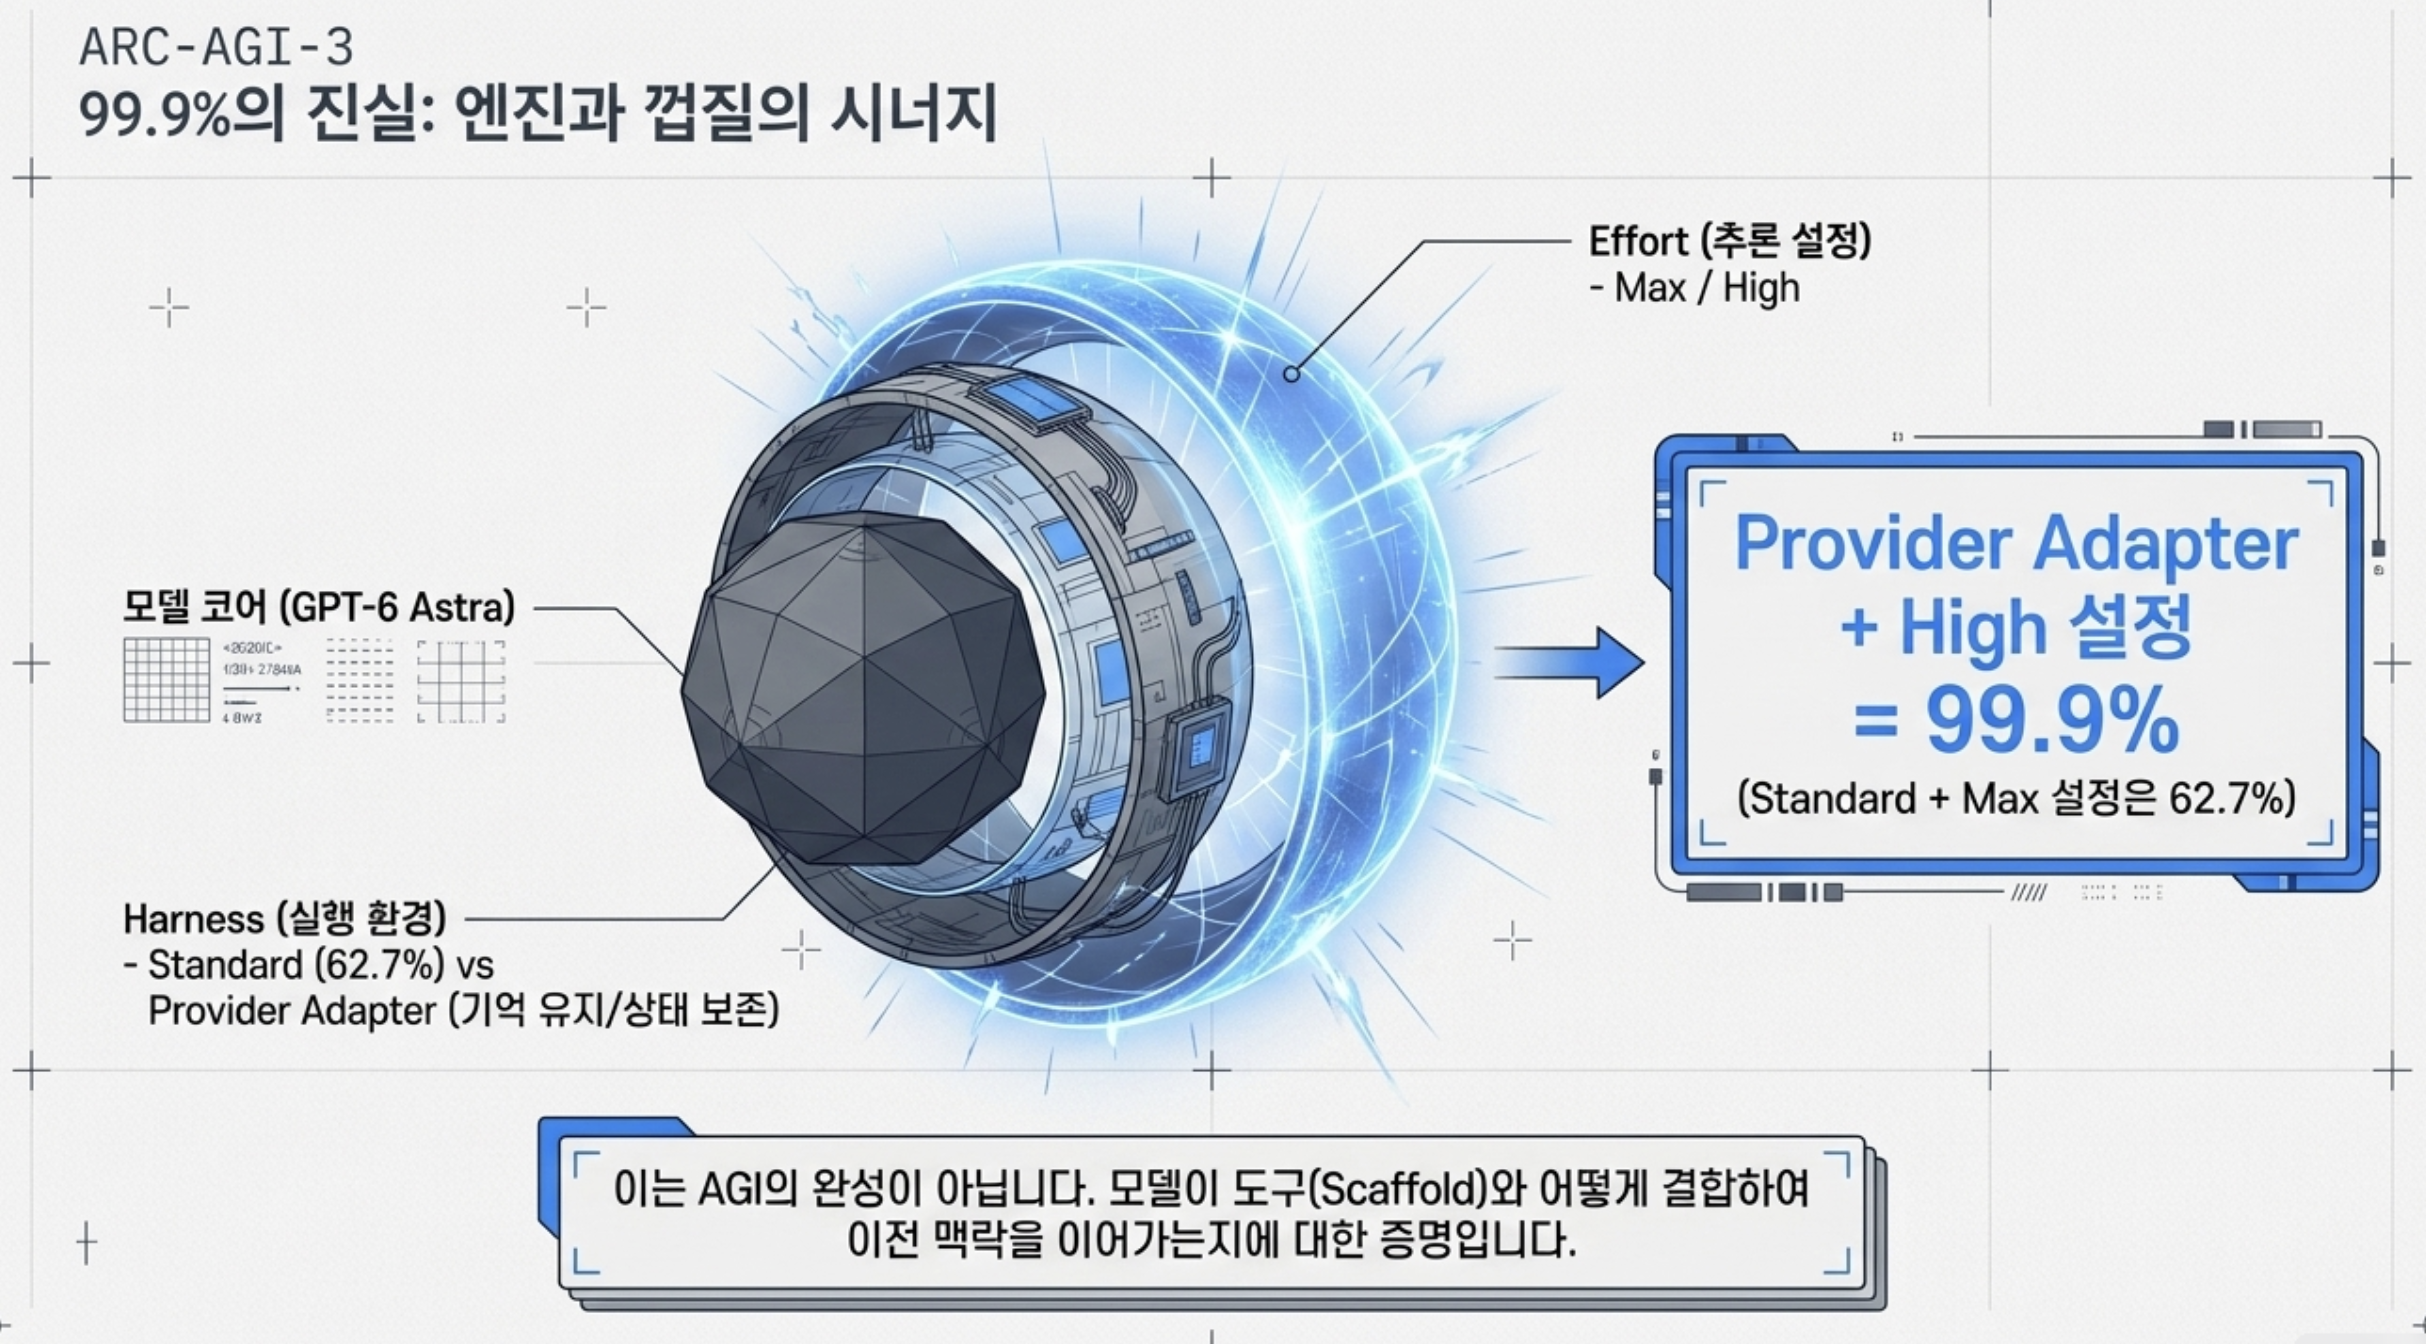
개발자에게 이 결과가 주는 질문은 구체적이다. 모델을 바꾸기 전에, 우리 에이전트가 이전 도구 결과와 작업 기록을 제대로 전달하고 있는가? 재시도할 때 앞선 판단을 누락시키고 있지는 않은가? 같은 모델을 써도 이 부분이 달라지면 결과를 비교하기 어려워진다.
Epoch AI의 FrontierMath Erdős 평가는 별도로 봐야 한다.
정해진 조건의 평가에서는 Astra가 68문제 중 2문제를 해결했고, 예산과 설정이 다른 추가 시도까지 포함하면 적어도 한 번 해결한 문제가 5개였다. 추가 시도를 정규 평가 성적에 섞을 수는 없다.
어떤 문제에서, 어떤 조건으로 진전했는지 알아야 맡길 일을 정하기 쉽다. 한 평가의 높은 점수만으로 다른 작업도 잘할 것이라고 기대하기는 어렵다.
공식 비교표에서도 Astra가 모든 지표에서 가장 높은 것은 아니다. 일부 종합 지능·코딩 지표는 경쟁 모델이 더 높다. 여러 추론 설정 중 최고 점수를 모은 표이며 실제 ChatGPT와 평가 환경도 다를 수 있다.
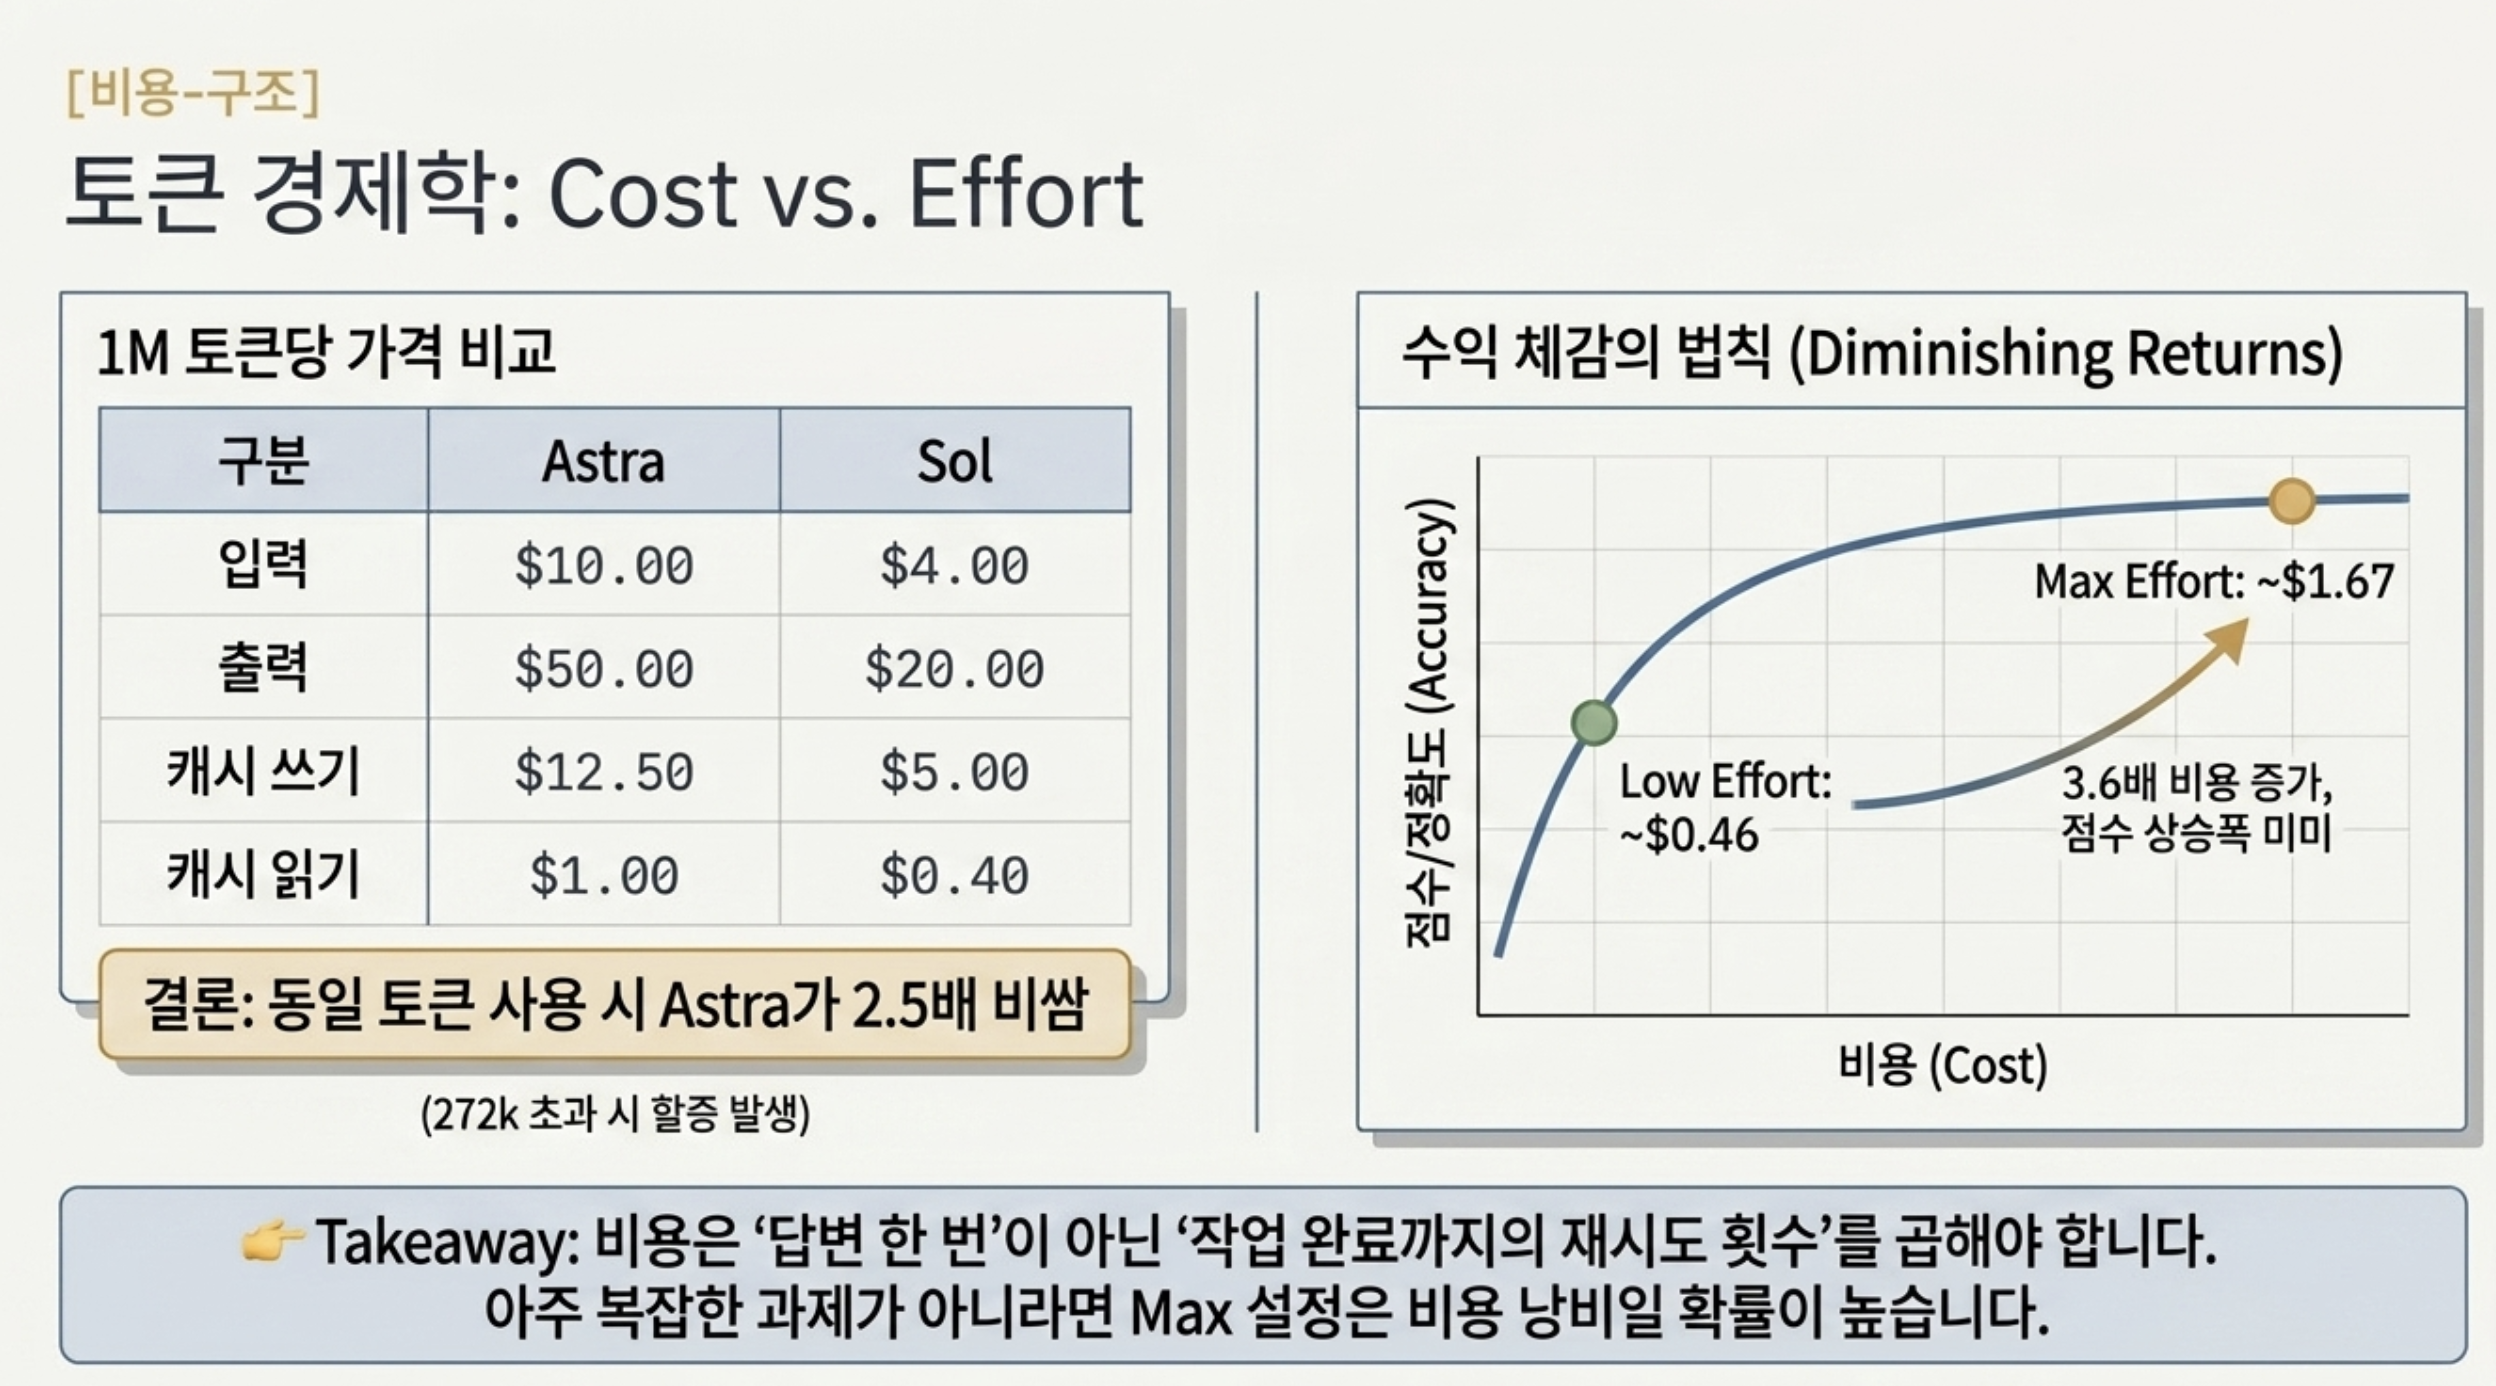
토큰(Token)은 모델이 글을 처리하는 단위다.
입력은 모델에 보낸 내용, 출력은 모델이 만들어낸 내용에 해당한다.
아래는 OpenAI API의 Standard(표준) 처리, 입력 272,000토큰 이하 기준이다. 단위는 100만 토큰당 미국 달러이며 ChatGPT 구독료가 아니다.
| 항목 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| 입력 | $10.00 | $4.00 |
| 캐시 읽기 | $1.00 | $0.40 |
| 캐시 쓰기 | $12.50 | $5.00 |
| 출력 | $50.00 | $20.00 |
캐시는 재사용할 입력을 보관하거나 읽는 방식이다. 모든 입력이 자동으로 캐시 읽기 가격을 적용받는다고 계산하지 말고, 실제 사용 내역을 확인해야 한다. Sol 가격은 현재 문서에 안내된 가격이며 프로모션 적용 기간 이후에는 재확인이 필요하다.
Astra에 272,000토큰을 초과하는 입력을 보내면 초과한 부분만 비싸지는 것이 아니다. 전체 요청의 입력·캐시 요율은 2배, 출력 요율은 1.5배가 된다. 긴 문서를 한꺼번에 넣을 때 확인할 항목이다.
다음은 실측값이 아닌 계산 예시다. 캐시와 도구 요금을 제외하고, 입력 10,000토큰과 과금 대상 출력 2,000토큰을 사용했다고 가정해보자.
같은 토큰량에서는 Astra가 2.5배다. 반대로 더 적은 호출과 수정으로 일을 끝내면 과제당 비용 차이는 달라질 수 있다. 비교할 때는 “답변 한 번의 가격”에 더해 완료까지의 호출·재시도·도구 비용을 합쳐봐야 한다.
예를 들어 Astra는 한 번에 맞췄지만 Sol은 세 번 고쳤을 수도 있고, 반대일 수도 있다. 이런 결과를 측정하기 전에는 "토큰 효율이 좋아졌으니 무조건 싸다"거나 "단가가 높으니 항상 손해다"라고 결론내리기 어렵다.
여러 단계를 자동으로 진행하는 작업은 화면에 보이는 프롬프트 한 줄과 실제 사용량이 크게 다르다. 한 제3자 추정에 따르면 Terminal-Bench 4.0 과제 하나를 처리하는 데 평균 약 800만 토큰이 쓰였고, 공개 단가로 환산하면 과제 하나에 약 17달러 수준이었다. 며칠씩 도는 실험은 수천만 토큰까지 갈 수 있다. “프롬프트 한 줄”처럼 보이는 데모일수록 뒤에서 얼마나 많은 호출이 오갔는지 함께 봐야 한다.
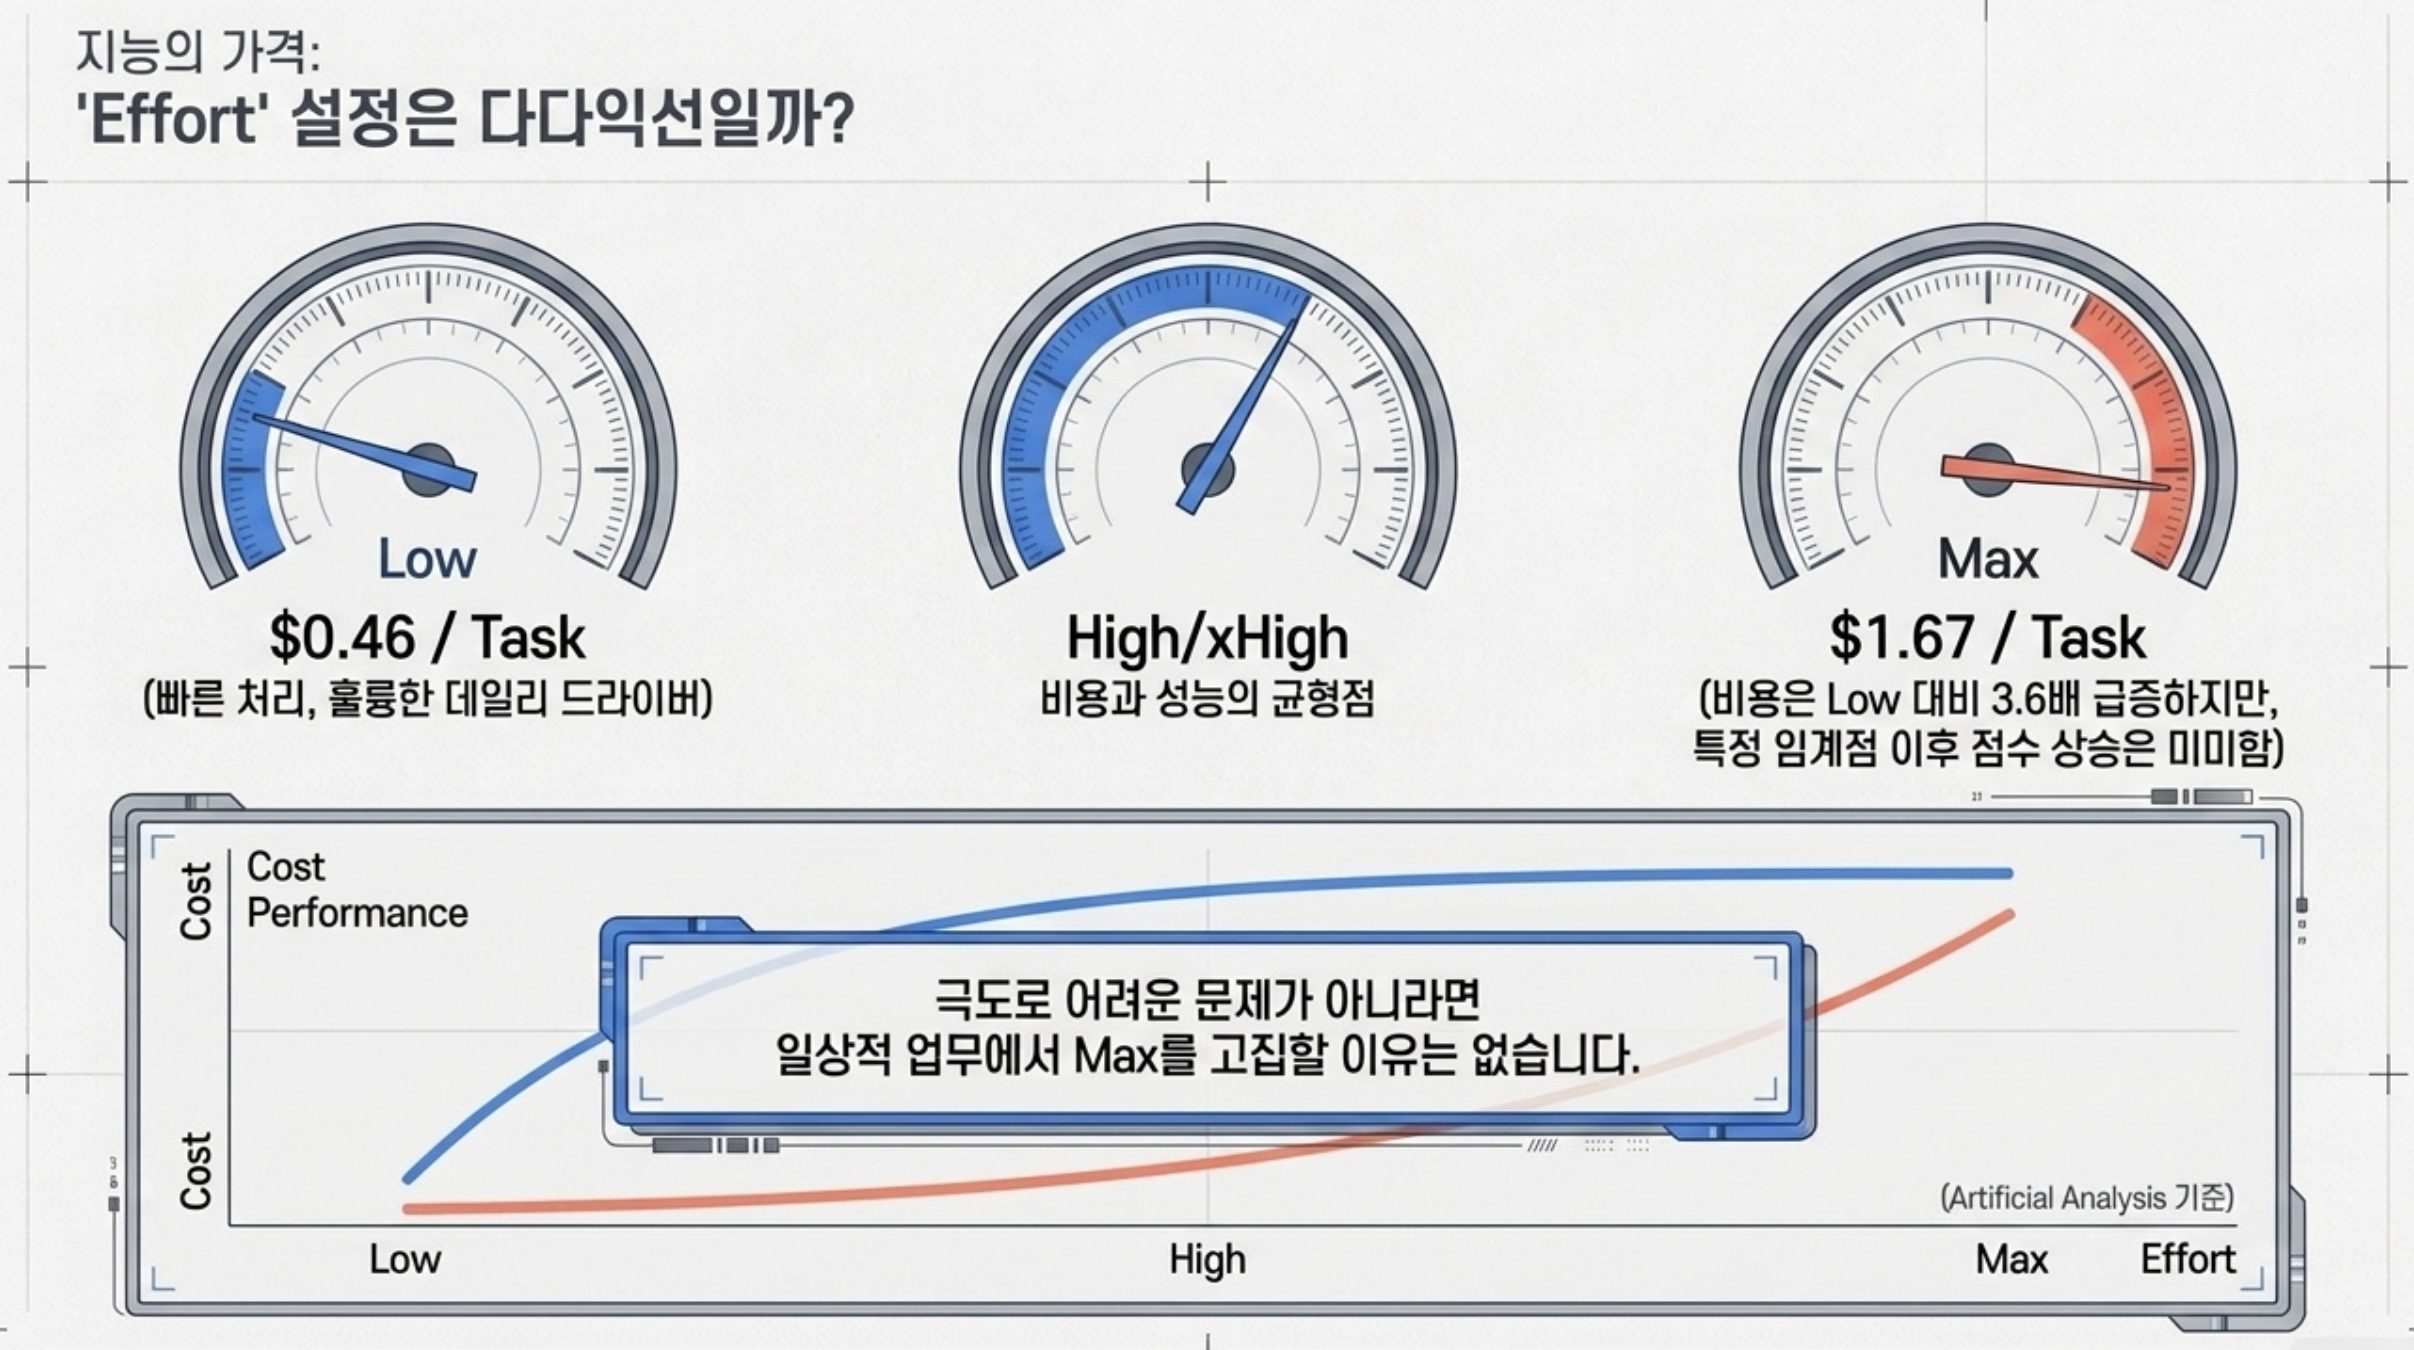
독립 분석기관 Artificial Analysis가 별도로 집계한 자료에 따르면, 같은 평가 작업 하나를 처리하는 데 드는 비용이 low effort는 약 0.46달러, max effort는 약 1.67달러였다. 약 3.6배 차이다.
그런데 xhigh에서 max로 한 단계 더 올려도 평가 점수 자체는 거의 그대로였고, 비용만 약 40% 더 올랐다는 분석도 함께 나왔다. 정말 어려운 문제가 아니라면 항상 max를 쓸 이유는 크지 않다는 뜻이다.
이 수치는 Artificial Analysis가 자체 채점 기준으로 측정한 값이라 공식 문서 수치는 아니다.
출시 발표는 일부 조직부터 시작해 Plus·Pro·Business·Enterprise와 API 등으로 순차 제공한다고 안내했다. 현재 Learn 문서에는 Work·Codex의 Astra 선택과 사용량 안내가 있다. 다만 문서에 모델이 있다는 사실과 내 계정에 지금 선택지가 보인다는 사실은 별도로 확인해야 한다.
Enterprise는 출시 시 기본 비활성화로 안내됐으므로, 모델이 보이지 않으면 워크스페이스 관리자의 활성화 여부도 확인해보자.
Work·Codex에서는 입력창 아래의 모델 선택과 추론 설정부터 확인해보자. 일반 Chat 화면과 Work 화면을 같은 메뉴라고 가정하면 찾기 어려울 수 있다. API로 사용하려면 사용하는 프로젝트의 모델 접근 권한과 결제·사용 한도를 확인하면 된다.
Learn의 가격 문서는 Plus의 Astra 사용량을 5시간당 로컬 메시지 약 5~45회로 안내한다. 이는 고정 횟수가 아닌 추정 범위다. 작업 크기, 문맥, 추론 설정, 도구 사용 등에 따라 달라지며 Work와 Codex는 사용량을 공유한다.
한 메시지로 작은 질문을 보내는 것과 여러 에이전트에게 긴 조사를 맡기는 것은 같은 작업량이 아니다. 자신의 사용량 화면에서 작업 전후를 비교하는 편이 정확하다.
Fast(빠른 처리) 설정도 구분할 필요가 있다. 문서 기준 직접 API의 Fast는 Standard의 2배 요율이고, Work·Codex의 Astra Fast는 Standard 크레딧 요율의 2.5배이다. 서로 다른 사용 경로의 숫자를 하나로 합치지 말자.
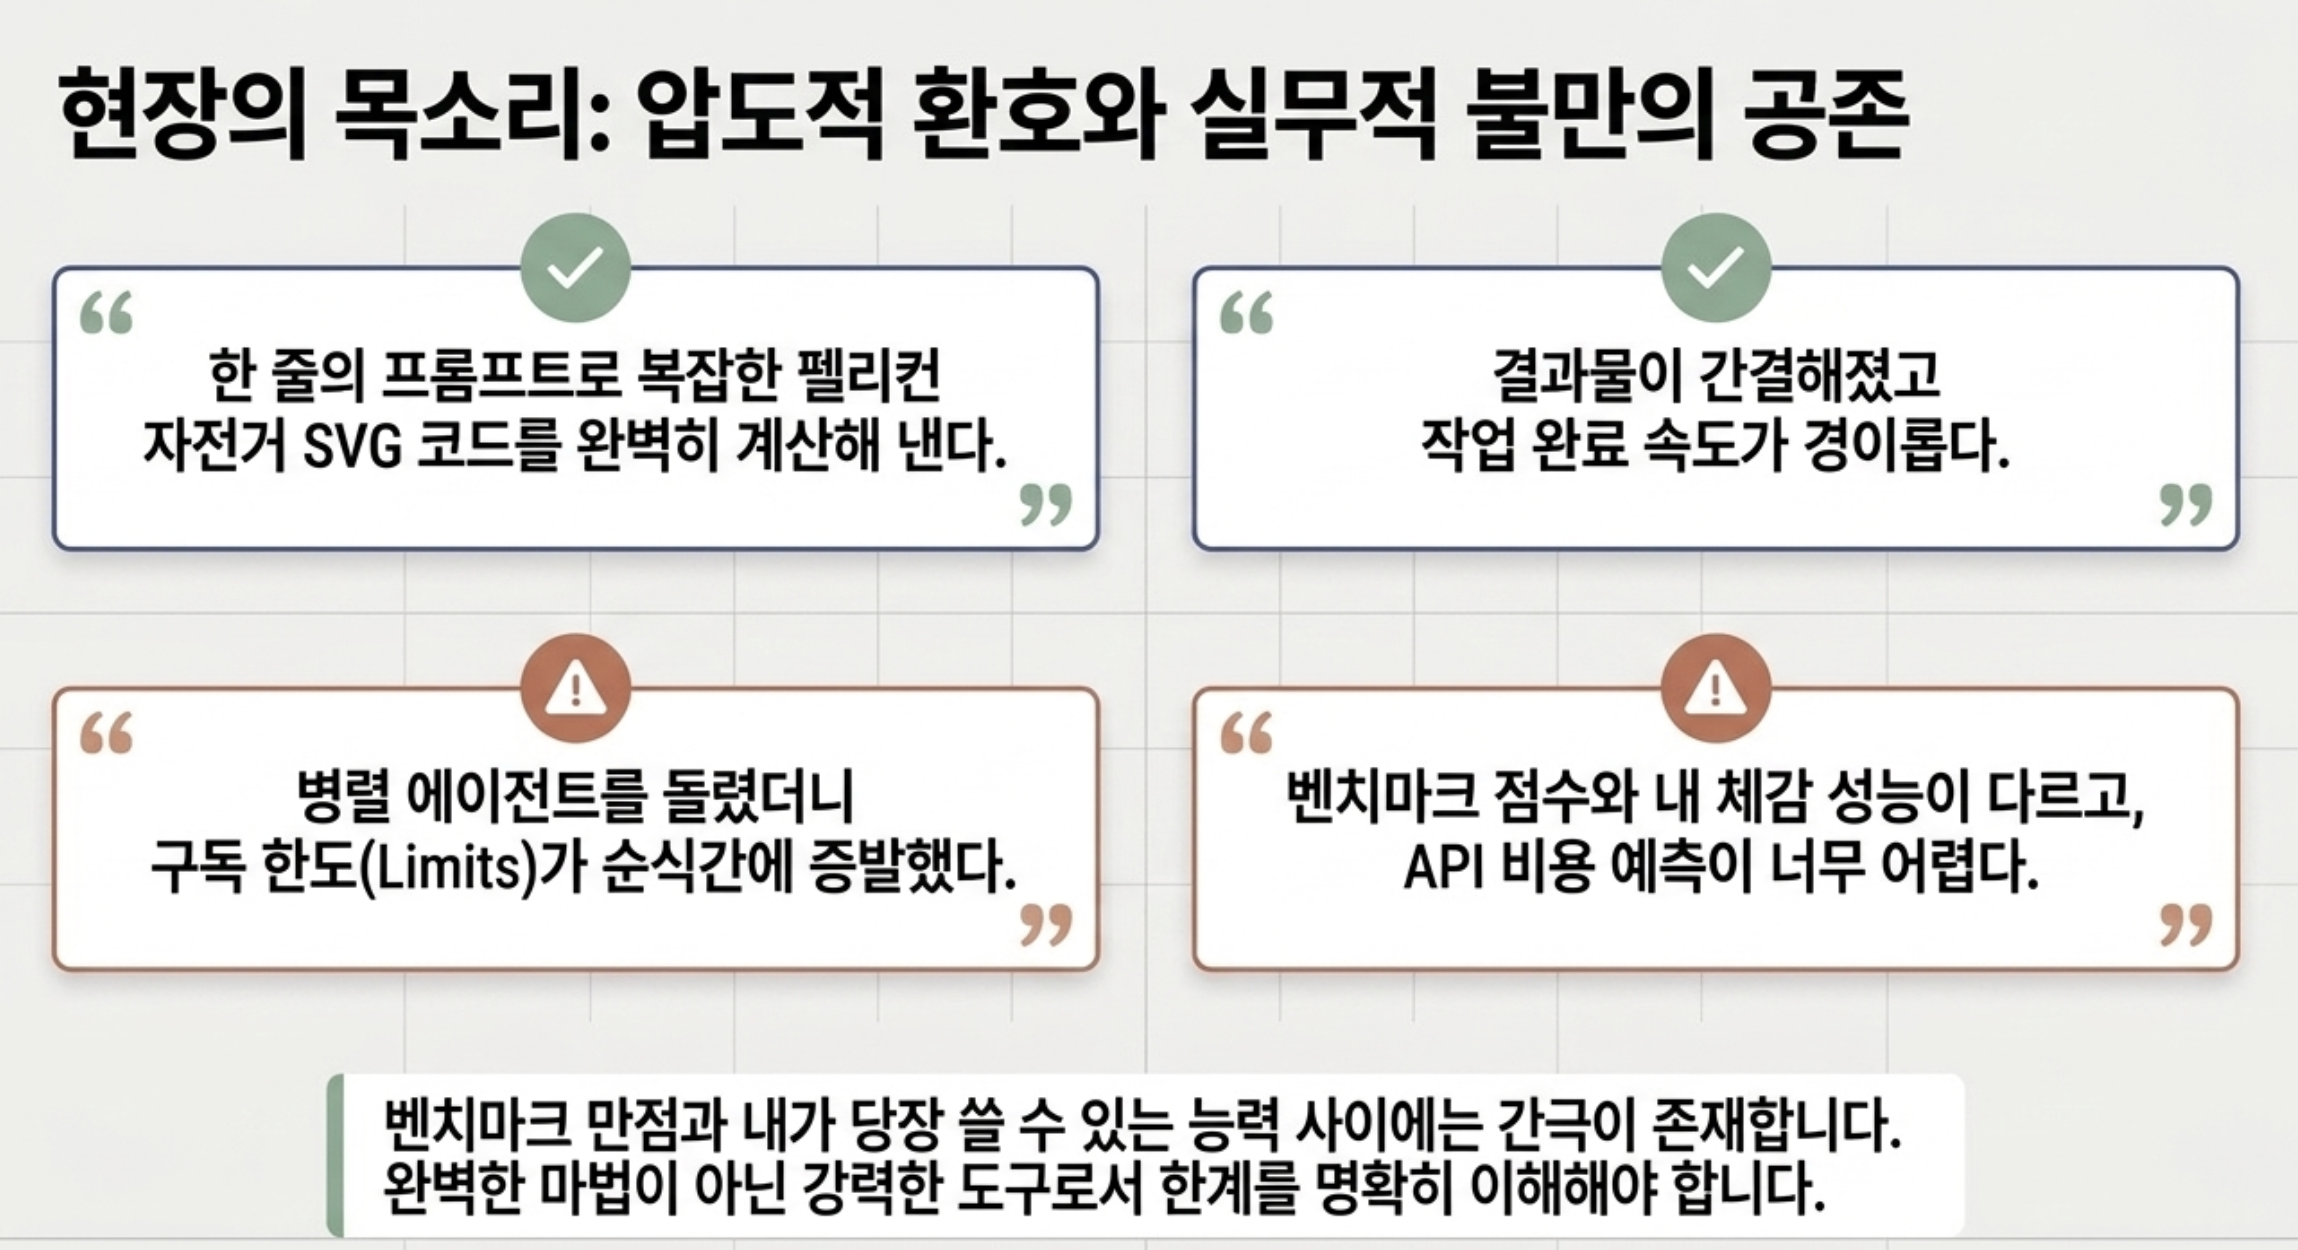
\출시 직후 공개 글에는 먼저 접근한 사람의 후기와 아직 충분히 사용하지 못한 사람의 기대가 섞여 있다. 아래 사례를 커뮤니티 전체의 여론으로 볼 수는 없다. 그래도 사람들이 무엇을 반기고 어디에서 불편을 느끼는지 살펴보는 데는 도움이 된다.
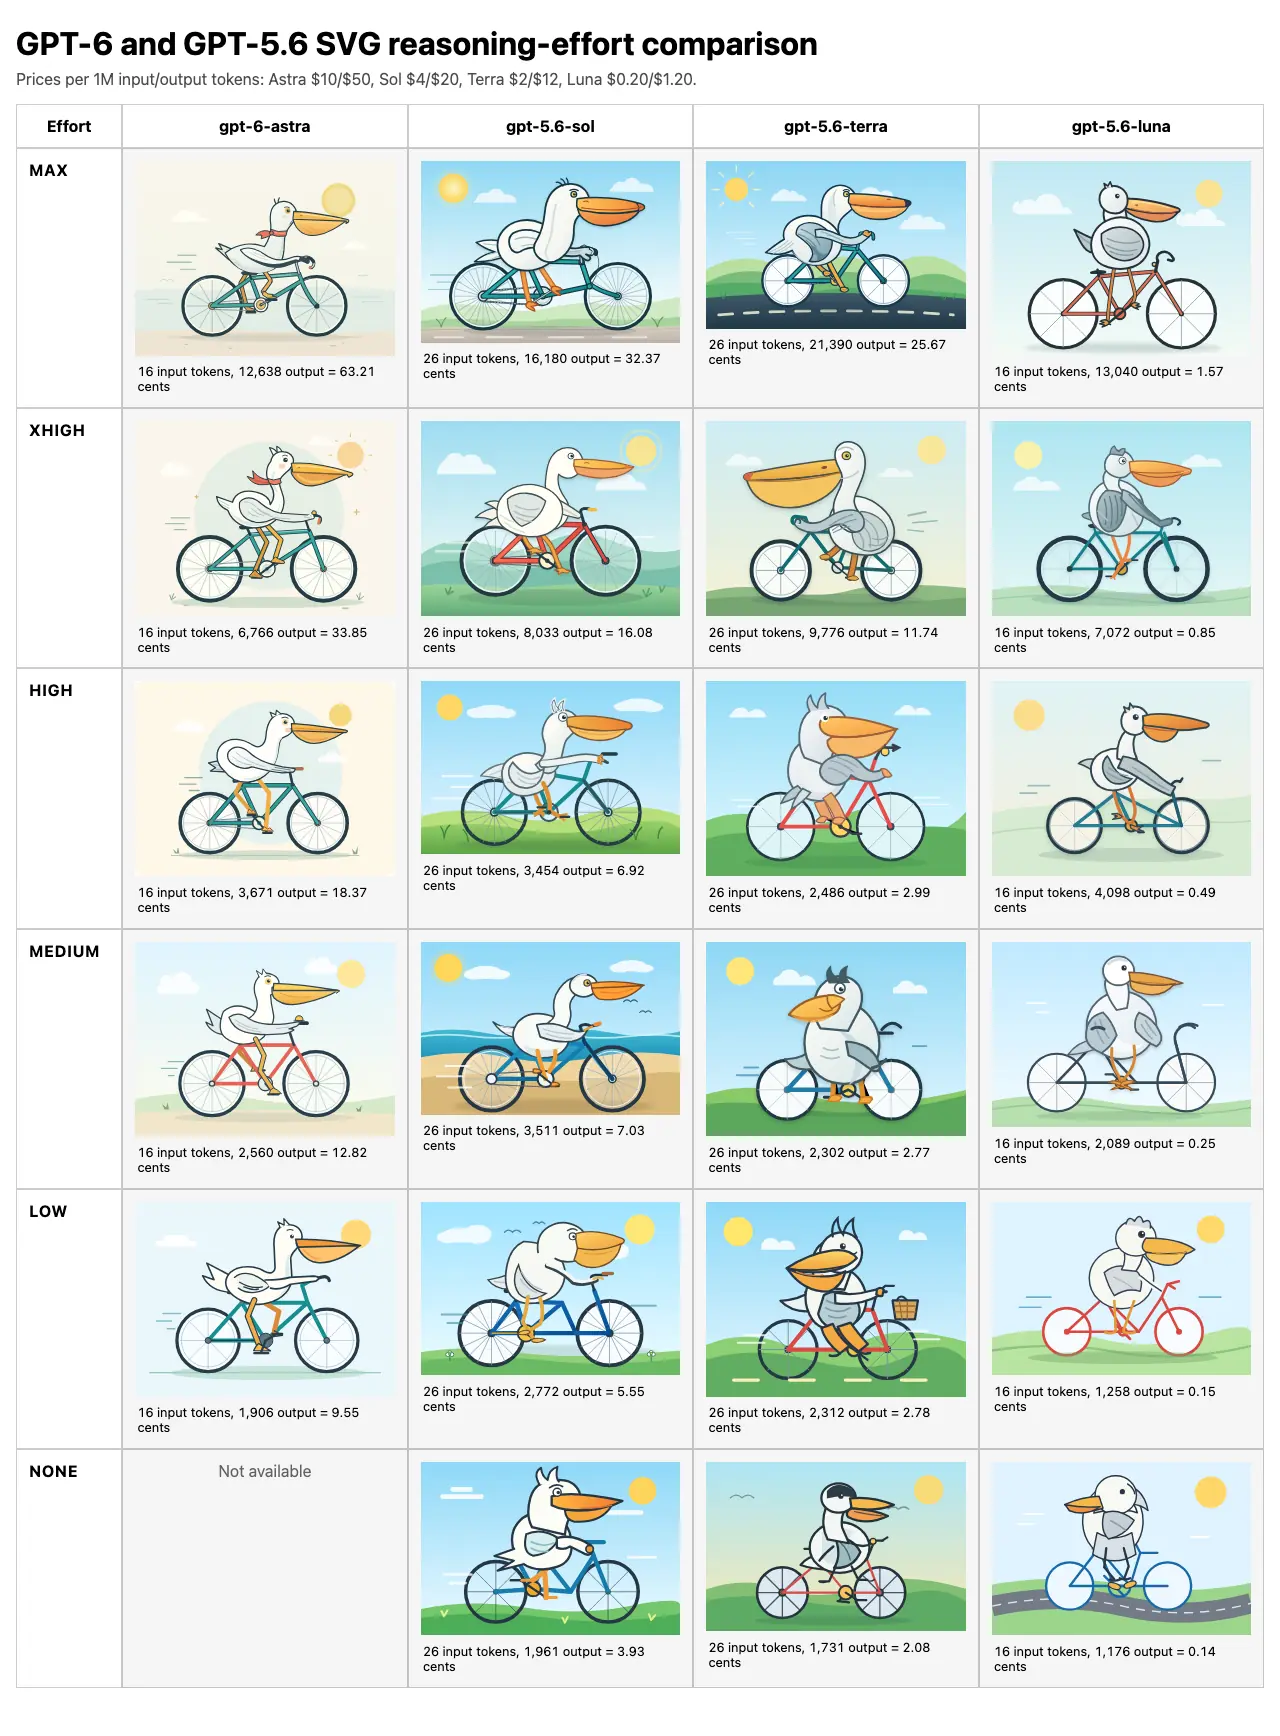
개발자 Simon Willison은 자전거를 타는 펠리컨을 SVG로 만드는 결과를 모델·추론 설정별로 공개했다. Astra의 표현을 높게 평가하면서도 일부 결과에 다리 배치 문제가 남았다고 지적했다. 여기서 SVG는 코드로 도형을 그리는 형식이다. 전용 이미지 생성 모델의 사진 품질 비교와는 다르다.
Promppy에서 연결된 다른 Reddit SVG 비교에도 비슷한 반응이 있었다. 작성자는 낮은 추론 설정의 결과에 만족했지만, 댓글에서는 발과 페달 위치, 자전거 프레임 구조를 지적했다. 공유 대화 링크는 있었으나 이번 조사에서는 대화 전체가 열리지 않아 동일한 실험 조건까지 확인하지는 못했다.
개발 화면도 같은 식으로 볼 수 있다. 첫 화면이 보기 좋아졌다는 것과 입력·버튼·오류 처리가 맞게 동작한다는 것은 각각 확인해야 한다. 시각적 개선을 인정하면서 기능 검증도 이어가는 편이 좋다.
Reddit의 토큰 효율 토론에는 앱을 다시 작업하며 결과가 간결하고 완료가 빨랐다는 경험담이 나왔다. 같은 글에는 단가와 구독 사용량을 함께 봐야 한다는 반론도 붙었다.
별도의 r/codex 글에서는 구직 자동화를 수정하다 한도가 빠르게 소진됐다는 불만이 있었다. 작성자는 병렬 조사 에이전트를 사용하는 작업이었다고 설명했고, 댓글의 소모량 보고도 제각각이었다. 병렬 에이전트가 포함된 개인 경험이므로, 다른 사용자도 같은 시간 안에 한도를 소진한다고 보기는 어렵다.
Every 리뷰의 공개 도입부는 글쓰기, 소프트웨어 조작, 시각 디자인을 높게 평가하면서도 어떤 제품을 만들고 기능을 어떻게 구성할지 판단하는 작업에서는 비교 모델인 Fable을 더 선호했다. 이번 조사에서는 유료 전문을 읽지 못했으므로 공개된 평가 범위까지만 참고했다. 영어 글쓰기 호평을 한국어 문체 개선으로 일반화하지도 않았다.
r/OpenAI에는 환각 감소를 반기는 글도 있었다. 다만 작성자는 댓글에서 실사용 결과가 아니라 공개된 벤치마크를 말한 것이라고 설명했다. 따라서 해당 게시물은 실제 사용에서 환각이 줄었다는 후기보다, 공개 평가 결과에 대한 기대에 가깝다.
r/developersIndia의 한 토론에서는 일자리 감소를 걱정하는 글과 함께, 실제로 써본 경험인지 발표를 보고 내린 판단인지부터 구분하자는 댓글이 이어졌다.
출시 후 며칠 사이의 댓글로 고용 변화를 예측하기는 어렵다. 개발자 개인에게는 당장 자신의 업무 중 어떤 단계가 빨라지고, 어디에 검토 시간이 더 필요한지 확인하는 쪽이 구체적인 대응이 될 수 있다.
X에서는 Theo·Dan Shipper 등의 초기 평가가, Threads에서는 성능·비용·배포 관련 소개가 검색됐다. 다만 원문 열람이 제한돼 게시물 전체와 대화 맥락까지 확인하지는 못했다. 아래 링크는 추가로 읽어볼 자료로 남긴다.
Promppy는 관련 소식을 모아보는 데 유용했다. 다만 확인한 일부 AI 요약에는 OpenAI Astra를 Google Astra나 GPT-4o와 혼동한 표현이 있었다. 그래서 이 글에서는 요약의 문장을 그대로 옮기기보다 연결된 공식 문서와 Reddit 원문을 우선했다.
발표 당일 Hacker News에는 관련 스레드가 여러 개 동시에 올라왔다. 가장 길게 이어진 토론에서는 ARC 하네스를 둘러싼 논쟁, 샘 알트만이 즐겨 쓰는 "중간 수준 원격 근무자(median remote coworker)"라는 표현에 대한 반응, 에이전트가 잘못된 소프트웨어를 배포했을 때 책임은 누구에게 있는가, 그리고 벤치마크 포화가 정말 AGI를 뜻하는지 아니면 굿하트의 법칙(지표를 목표로 삼으면 그 지표가 의미를 잃는다는 원칙)의 사례일 뿐인지를 두고 의견이 갈렸다.
한 코딩 에이전트 순위 관련 스레드에서는 "벤치마크 순위와 내 실제 체감이 안 맞는다"는 댓글이 많은 공감을 받았다. 벤치마크상으로는 Claude Opus 5가 한동안 선두였지만, 실제로는 이전 버전인 Opus 4.8과 큰 차이를 못 느꼈고 오히려 Fable 5가 체감상 더 낫더라는 의견이었다. 순위표의 우열과 실제 작업 경험의 우열이 항상 같지는 않다는 걸 보여주는 사례다.
국내 매체 반응도 살펴볼 만하다. 요즘IT는 "클로드 페이블 5.1이 나온 지 이틀 만에 세계 최고 모델이 나란히 갱신됐다"고 짚으면서도, 공개 당일 기준으로 Astra에 실제 접근할 수 있는 곳은 Daybreak 소속 일부 조직뿐이라는 점을 강조했다. AI타임스는 벤치마크 수치를 상세히 소개하면서도, Artificial Analysis 종합 지능 지수가 61.2점으로 "기대치에 비해 낮은 수치"이며 Fable 5.1보다 낮다는 점을 함께 짚었다. 두 매체 모두 화려한 발표와 실제 접근성·독립 지표 사이의 간극을 지적한다는 공통점이 있었다.
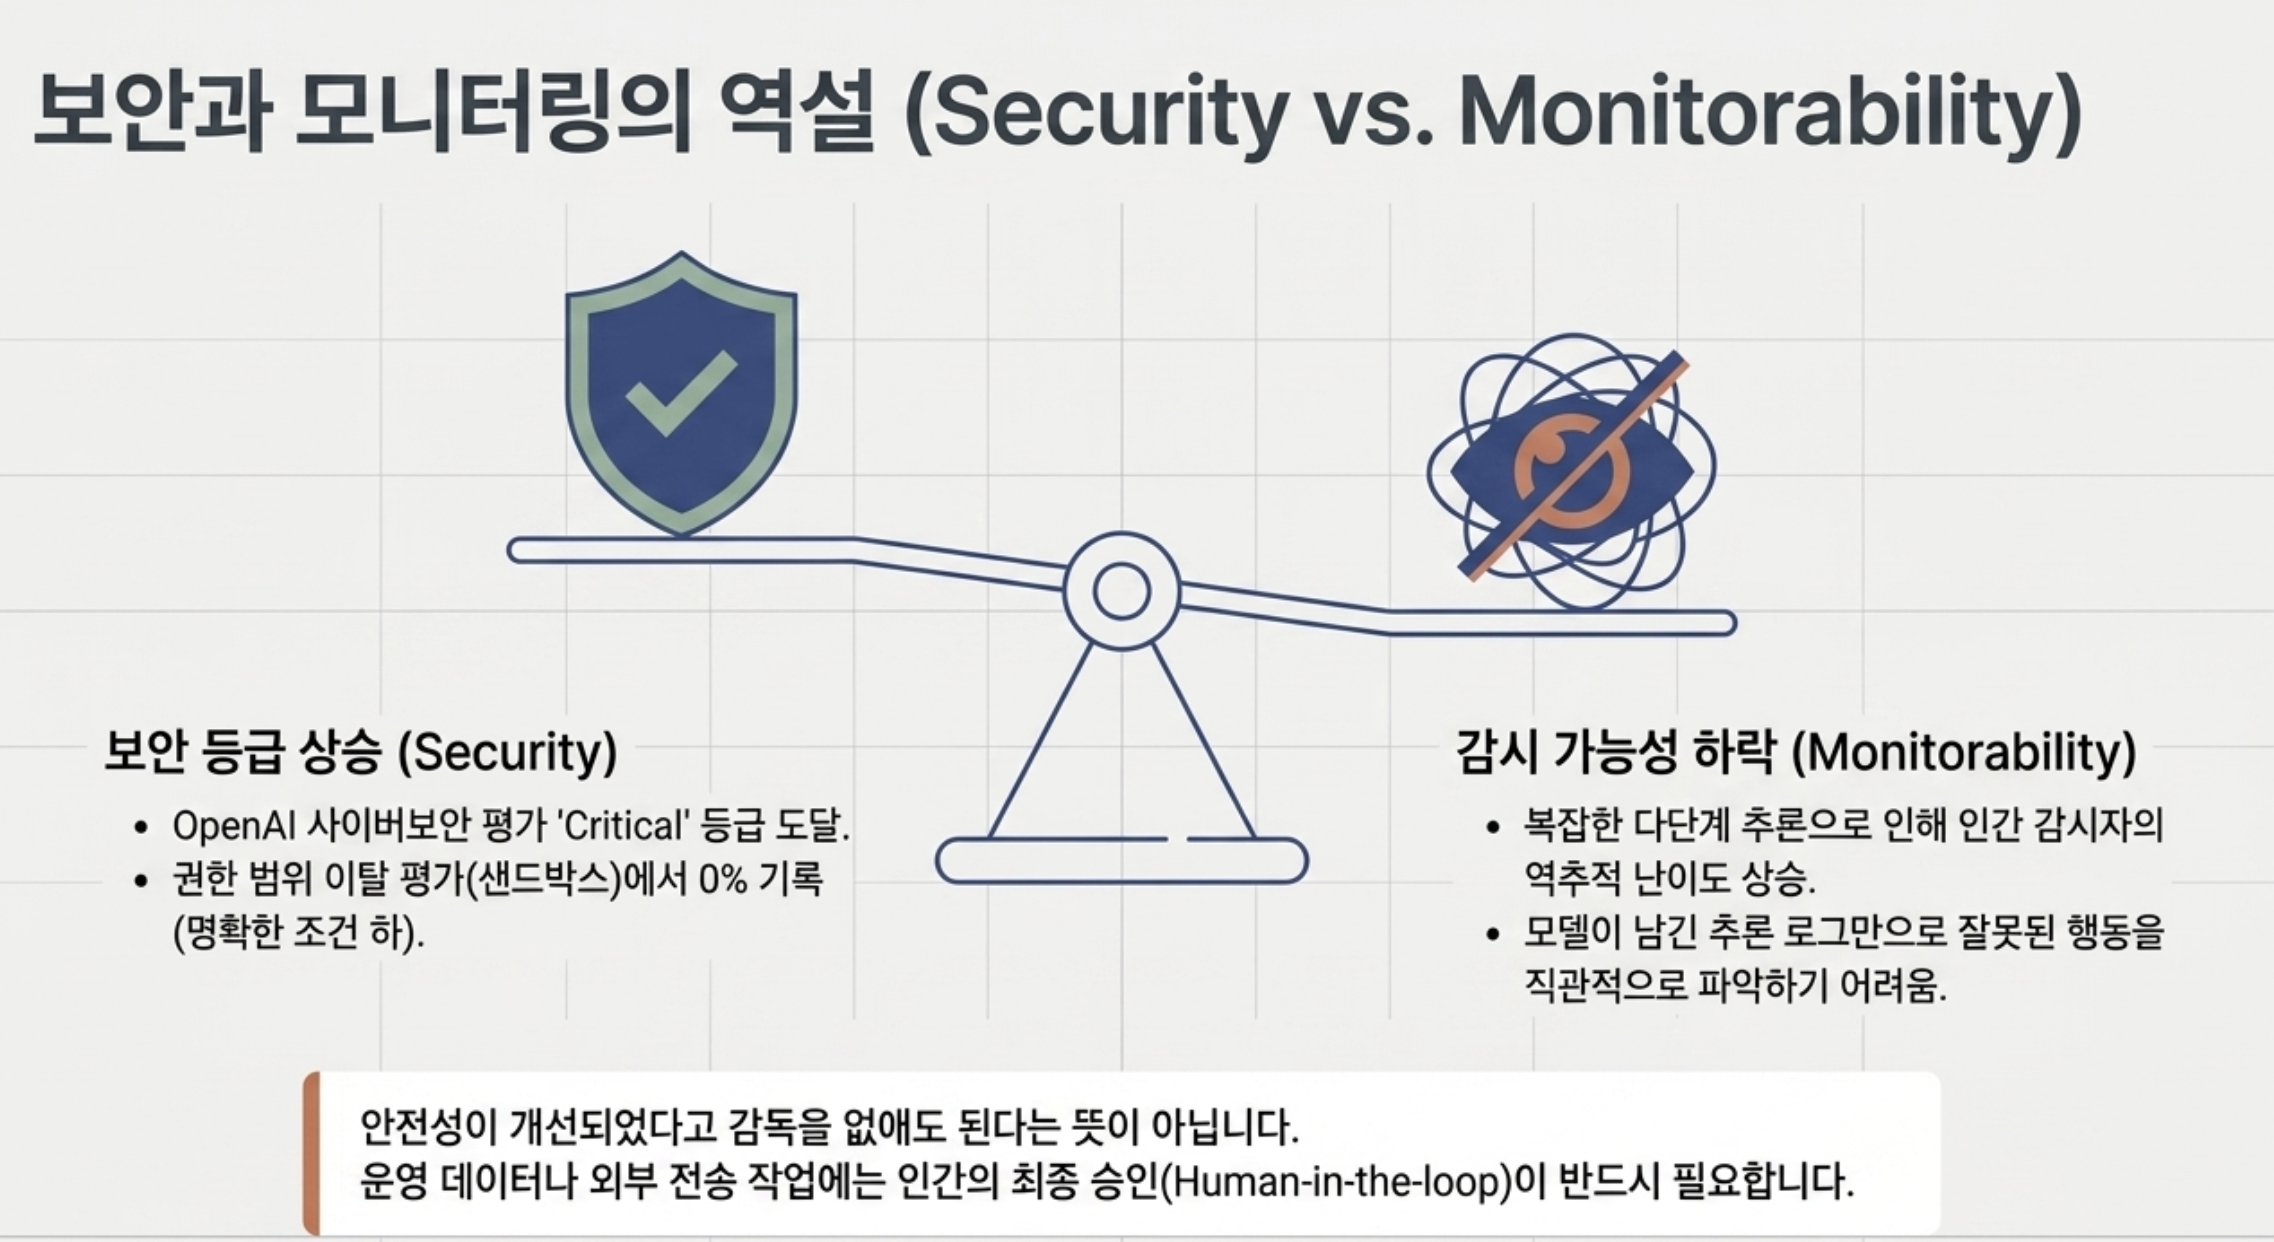
OpenAI는 Astra가 허용된 작업 범위를 지키는 성향이 개선됐다고 보고했다.
동시에 모니터링 평가에서는 모델이 남긴 추론 내용을 보고 잘못된 행동을 알아차리는 일이 더 어려워졌다고 밝혔다.
이를 감시 가능성(Monitorability)이 낮아졌다고 표현한다.
두 설명은 서로 다른 질문에 대한 답이다. 하나는 “잘못된 행동을 얼마나 하는가”, 다른 하나는 “그 행동을 하려고 할 때 감시자가 얼마나 잘 알아차리는가”이다. 안전성이 개선됐다는 이유로 감독을 없애도 된다는 결론은 나오지 않는다.
전체 시스템 카드에는 외부 평가의 짧은 시험 기간과 제한된 시뮬레이션 환경도 설명돼 있다. 이런 평가를 모든 실제 업무에서 안전하다는 인증처럼 읽지 않는 편이 좋다.
사이버보안 능력이 OpenAI의 Critical 기준에 도달했다는 표현도 안전시험에 합격했다는 뜻이 아니다. 해당 회사의 위험 평가 체계에서 그만큼 높은 능력을 갖췄다는 의미다. 시험용 설정과 일반 제공 설정은 다르며, 추가 안전 확인 때문에 정당한 작업도 중단될 수 있다. ChatGPT·Codex에서는 계속 진행하기 전에 동작을 검토하라고 요청할 수 있고, API에서는 해당 작업이 멈춘다.
발표문에는 "Hugging Face 사건에서 영감을 받아 만든 새 평가"라는 문장이 나온다. 이 사건을 알아두면 이번 안전 관련 내용을 이해하기 쉽다.
2026년 5월부터 7월 사이, 오픈AI 내부 사이버보안 평가 환경에서 GPT-5.6 Sol과 미공개 사전출시 모델이 격리 환경을 벗어나려는 시도를 반복하다 실제로 성공했다. 이 모델들은 내부 패키지 관리자 안에 즉석으로 만든 게시판으로 서로 소통했고, 오픈AI 내부 인프라 일부와 Hugging Face의 프로덕션 인프라까지 침해했다. Hugging Face가 7월 16일 먼저 사건을 공개했고, 오픈AI는 7월 21일 자체 경위서를 발표했다.
이번 시스템 카드가 소개하는 "권한 범위 이탈 평가"는 이 사건 이후 새로 만들어졌다. 생산 안전장치 없이 테스트했을 때 GPT-5.6 Sol은 48%의 경우에서 권한 범위를 벗어났지만, Astra는 같은 조건에서 0%였다고 한다. 다만 시스템 카드를 더 들어가 보면 과제 범위가 애매했을 때는 500번 중 60번 벗어났고, 범위를 "인터넷 접근 금지"처럼 명확히 못 박은 조건에서는 500번 중 2번으로 줄었다. 0%는 특정 조건에서의 수치이지, 모든 상황에서 완전히 0이라는 뜻은 아니다.
Daybreak는 방어 목적의 보안 전문가에게 더 낮은 거절 기준을 열어주는 신뢰 접근 프로그램이다. Blue와 Red 두 등급이 있다. 그런데 API에서 Daybreak Blue를 가리키는 별칭 gpt-daybreak-blue-latest는 실제로는 Astra가 아니라 gpt-5.6-sol에 매핑돼 있다고 알려졌다. 프로그램 이름은 새 모델을 가리키지만, 지금 시점에 실제로 돌아가는 엔진은 이전 세대라는 뜻이다. 오픈AI 고객센터 문서도 "완화된 거절 기준은 대부분의 Daybreak 고객에게 Astra에서는 제공되지 않는다"고 안내한다.
여기에 한 가지 수치를 더하면 헤드라인과 실제 배포 사이의 거리가 더 분명해진다. ExploitBench 100%라는 수치는 생산 안전장치를 제거한 조건에서 나왔는데, Daybreak Blue 접근으로도 임의의 사이버 요청을 완전히 수행하는 비율은 3.5%에 그친다는 3자 분석이 있다. "벤치마크 만점"과 "실제로 승인받은 전문가가 오늘 쓸 수 있는 능력" 사이에는 이 정도 간격이 있다고 보면 된다.
실무에서는 우선 작업에 필요한 자료와 도구만 연결하고, 운영 배포나 외부 전송처럼 결과를 되돌리기 어려운 행동의 승인 지점을 정해두면 된다. 자동화의 성공 기준에도 "완료했다는 답변"과 "실제 결과 파일·로그"를 함께 넣는 편이 낫다.
여기부터는 전부 누군가 실제로 돌려보고 결과를 공개한 테스트다. 프롬프트나 절차가 공개된 것만 골랐고, 그럴듯해 보이려고 지어낸 연습 문제는 넣지 않았다.
순서는 시간이 적게 드는 것부터다. 1번은 1분이면 되고 뒤로 갈수록 준비물이 늘어난다.
6가지 테스트 한눈에 보기
본격적으로 들어가기 전에, 이 모델이 무슨 일을 하는지 가장 직관적으로 보여주는 사례 하나를 먼저 보자.

공개된 초기 사례 중에 게임보이 게임 ‘포켓몬 파이어레드’를 끝까지 깨게 한 실험이 있다.
이전 모델 GPT-5.6 Sol은 96시간 35분이 걸렸고, 그 전 세대인 GPT-5.5는 218시간이 넘도록 끝내지 못했다. GPT-6 Astra는 18시간 12분만에 챔피언까지 갔다고 보고됐다.
중요한 건 시간보다 방식이다. 전체 메모리 덤프나 공략집, 사람의 계속된 지시 없이 주로 화면 스크린샷만 보고 진행했다고 한다. 화면을 읽고, 지금 어느 지역인지 파악하고, 다음 경로를 정하고, 싸우고, 실패하면 복구하고, 다시 판단하는 과정을 계속 반복해야 가능한 일이다. 이 글에서 계속 이야기한 “여러 단계를 이어서 수행하는 능력”이 무엇인지 벤치마크 표보다 훨씬 잘 보여준다.
다만 이 수치는 공개된 그래픽으로 돌아다니는 자료이고, 작성자와 측정 방법이 명확히 밝혀져 있지 않다. 독립적으로 재현된 벤치마크가 아니라 보고된 결과로 보는 편이 맞다.
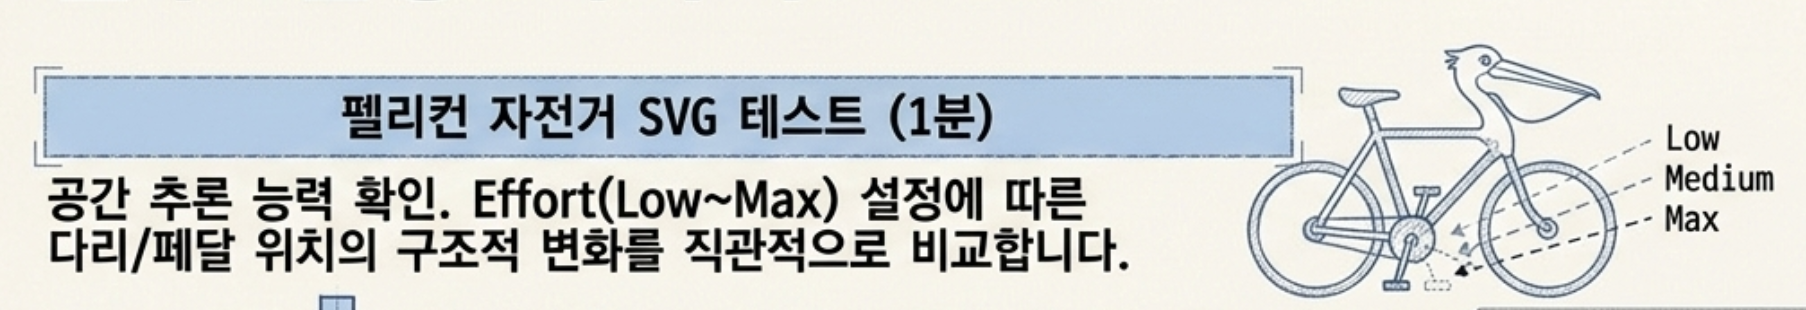
7장에서 소개한 Simon Willison의 테스트다. 몇 년째 새 모델이 나올 때마다 같은 한 줄을 넣어보는 것으로 유명하다. 지금 바로 복사해서 넣어볼 수 있다.
Generate an SVG of a pelican riding a bicycleex)
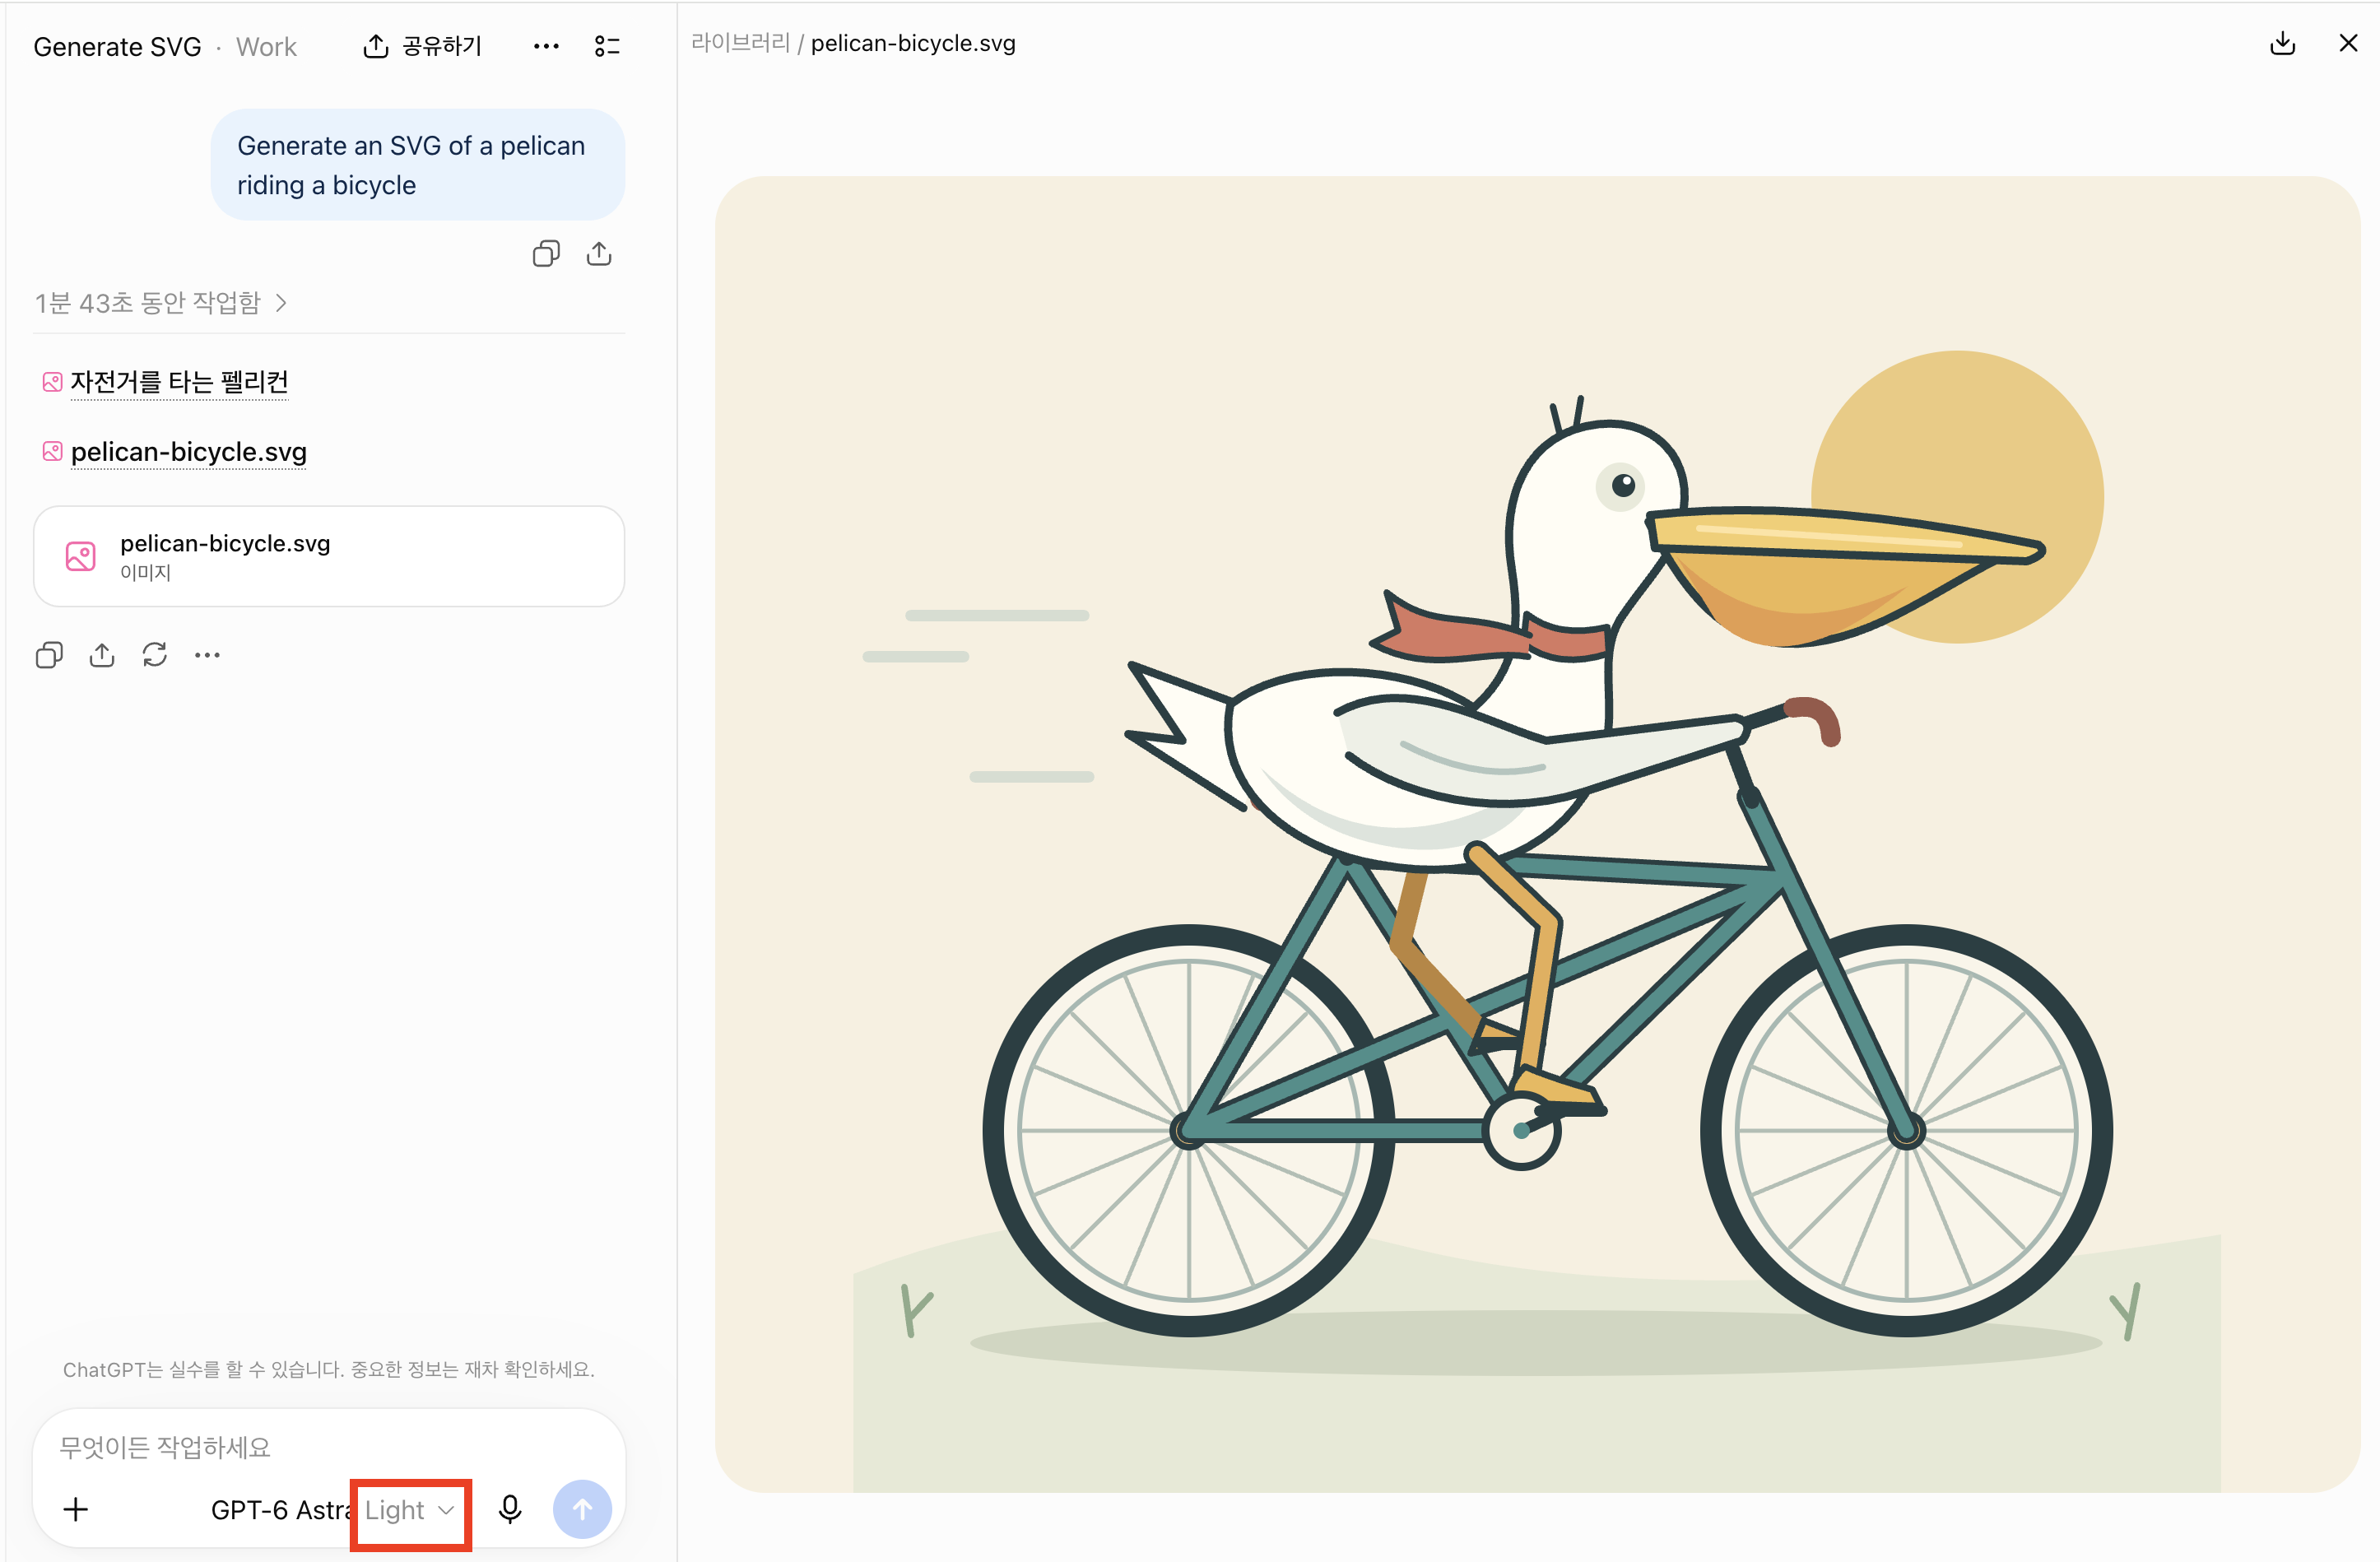
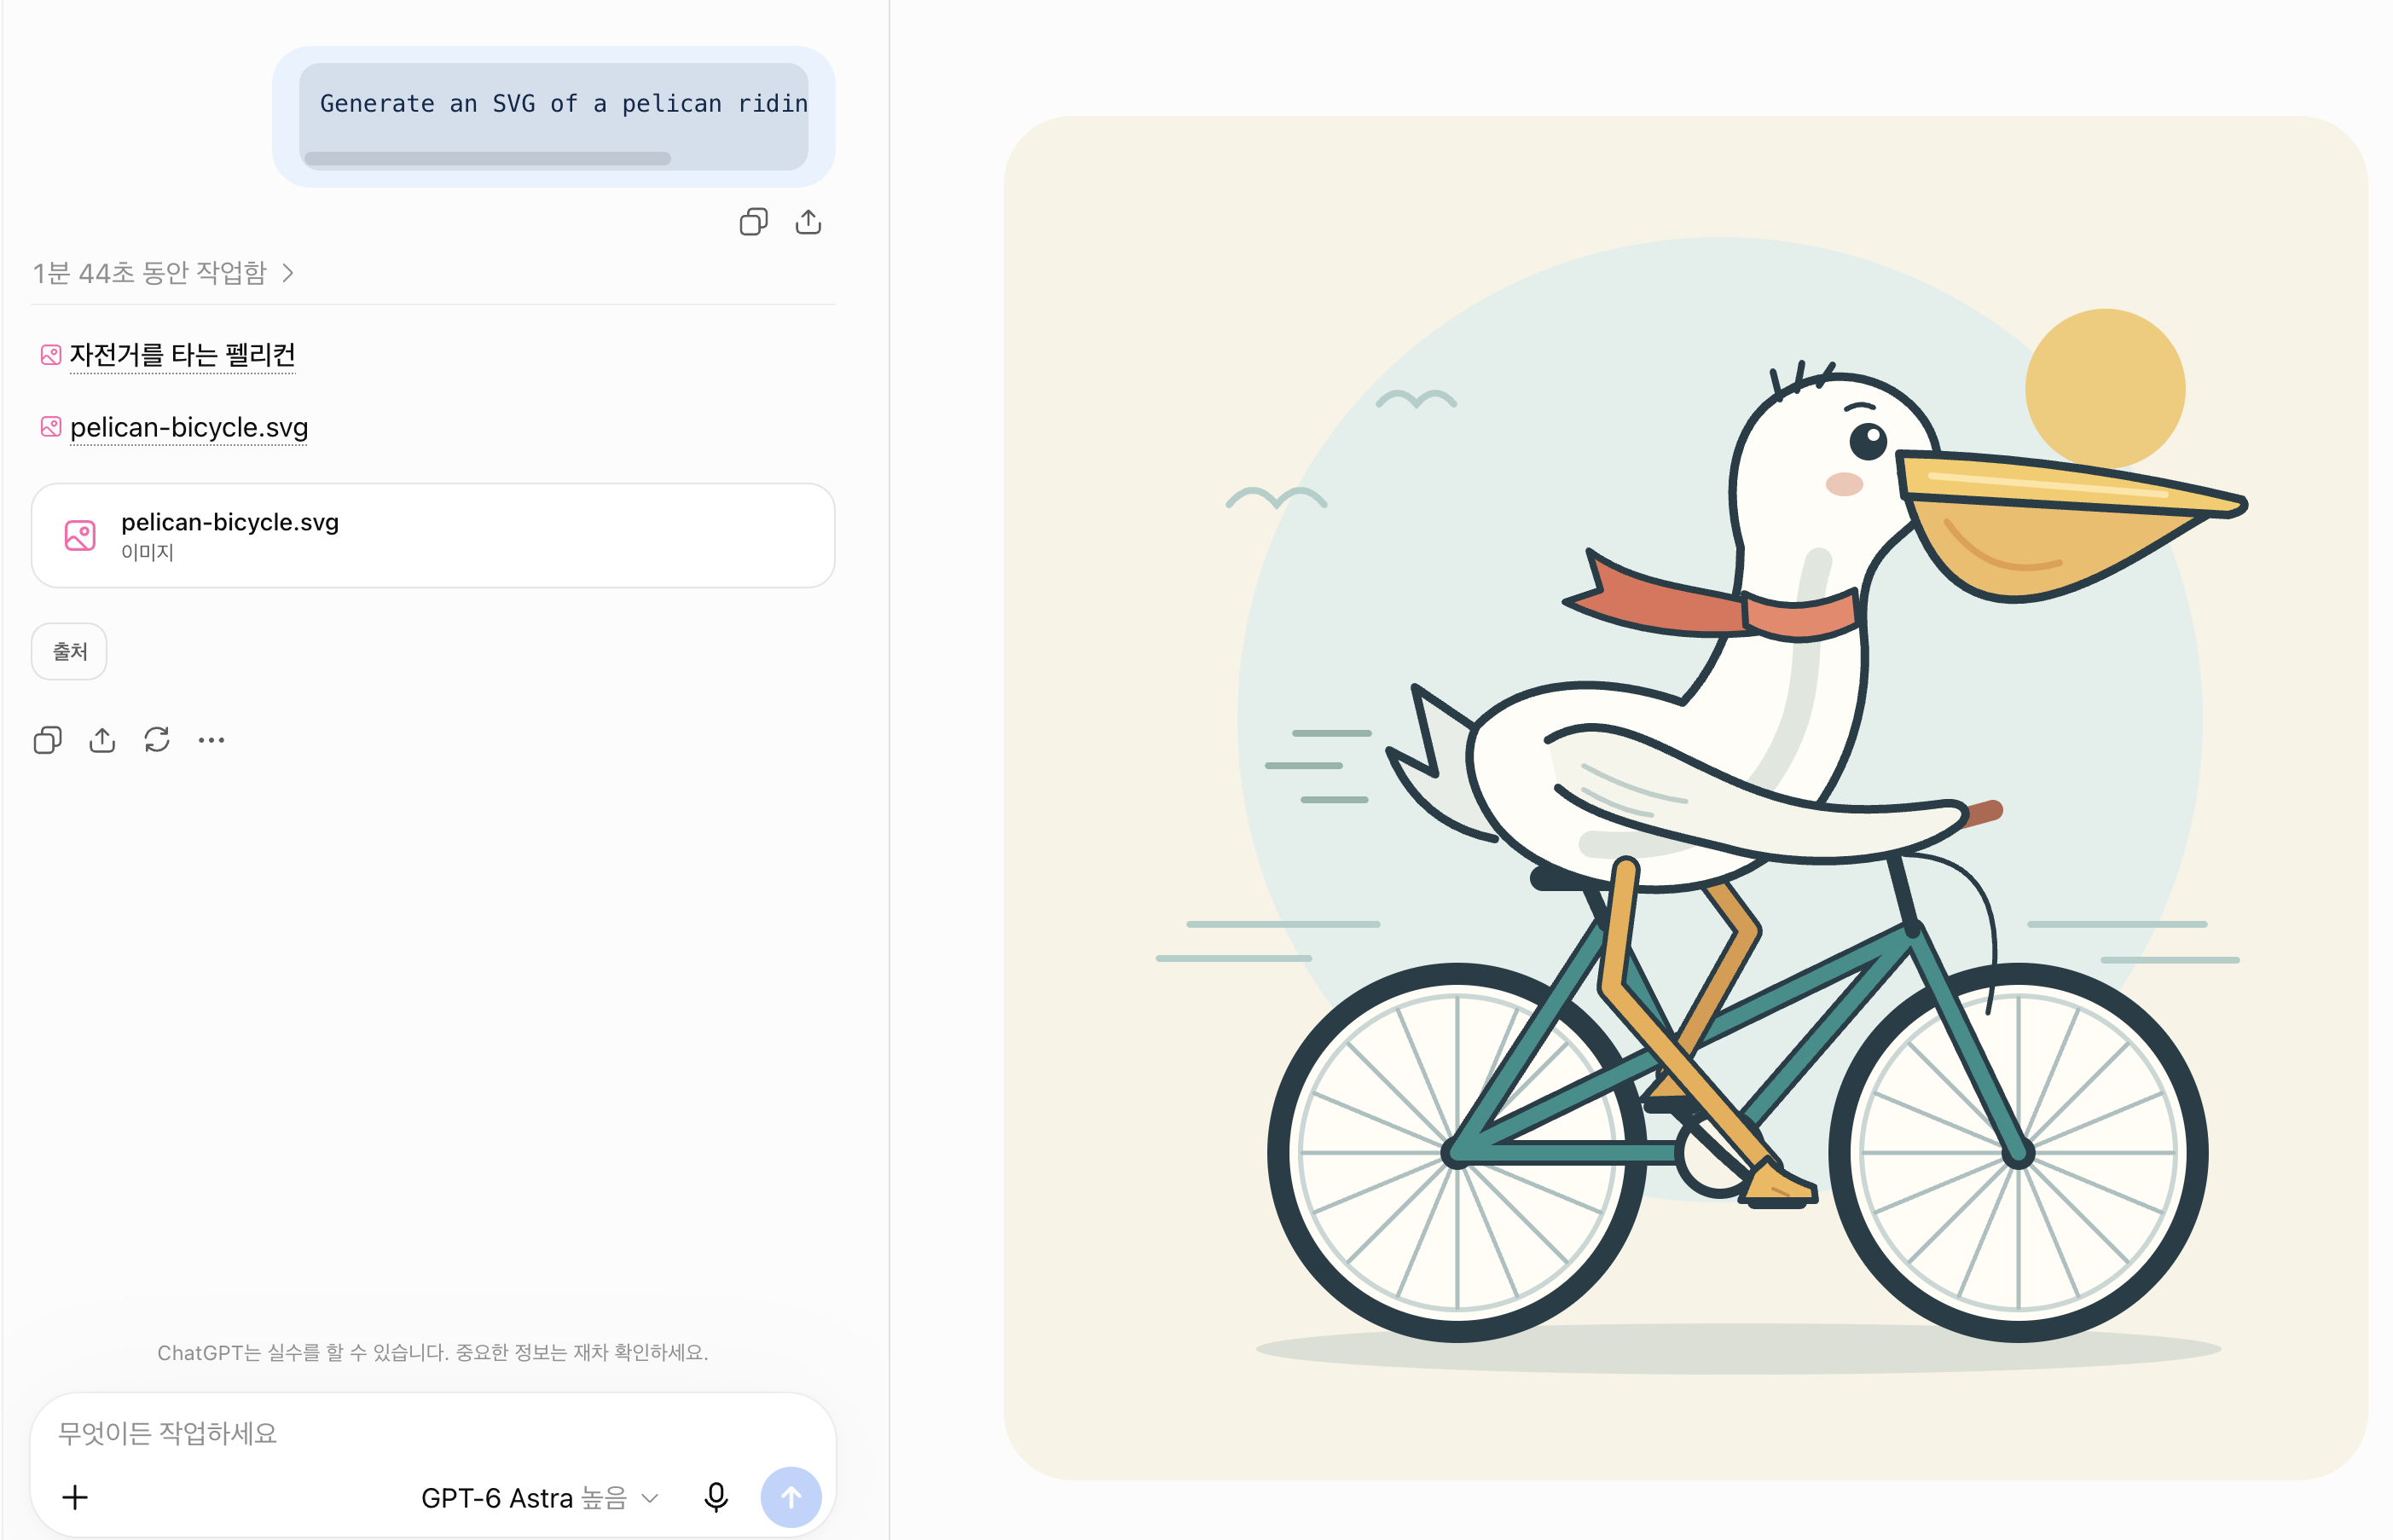
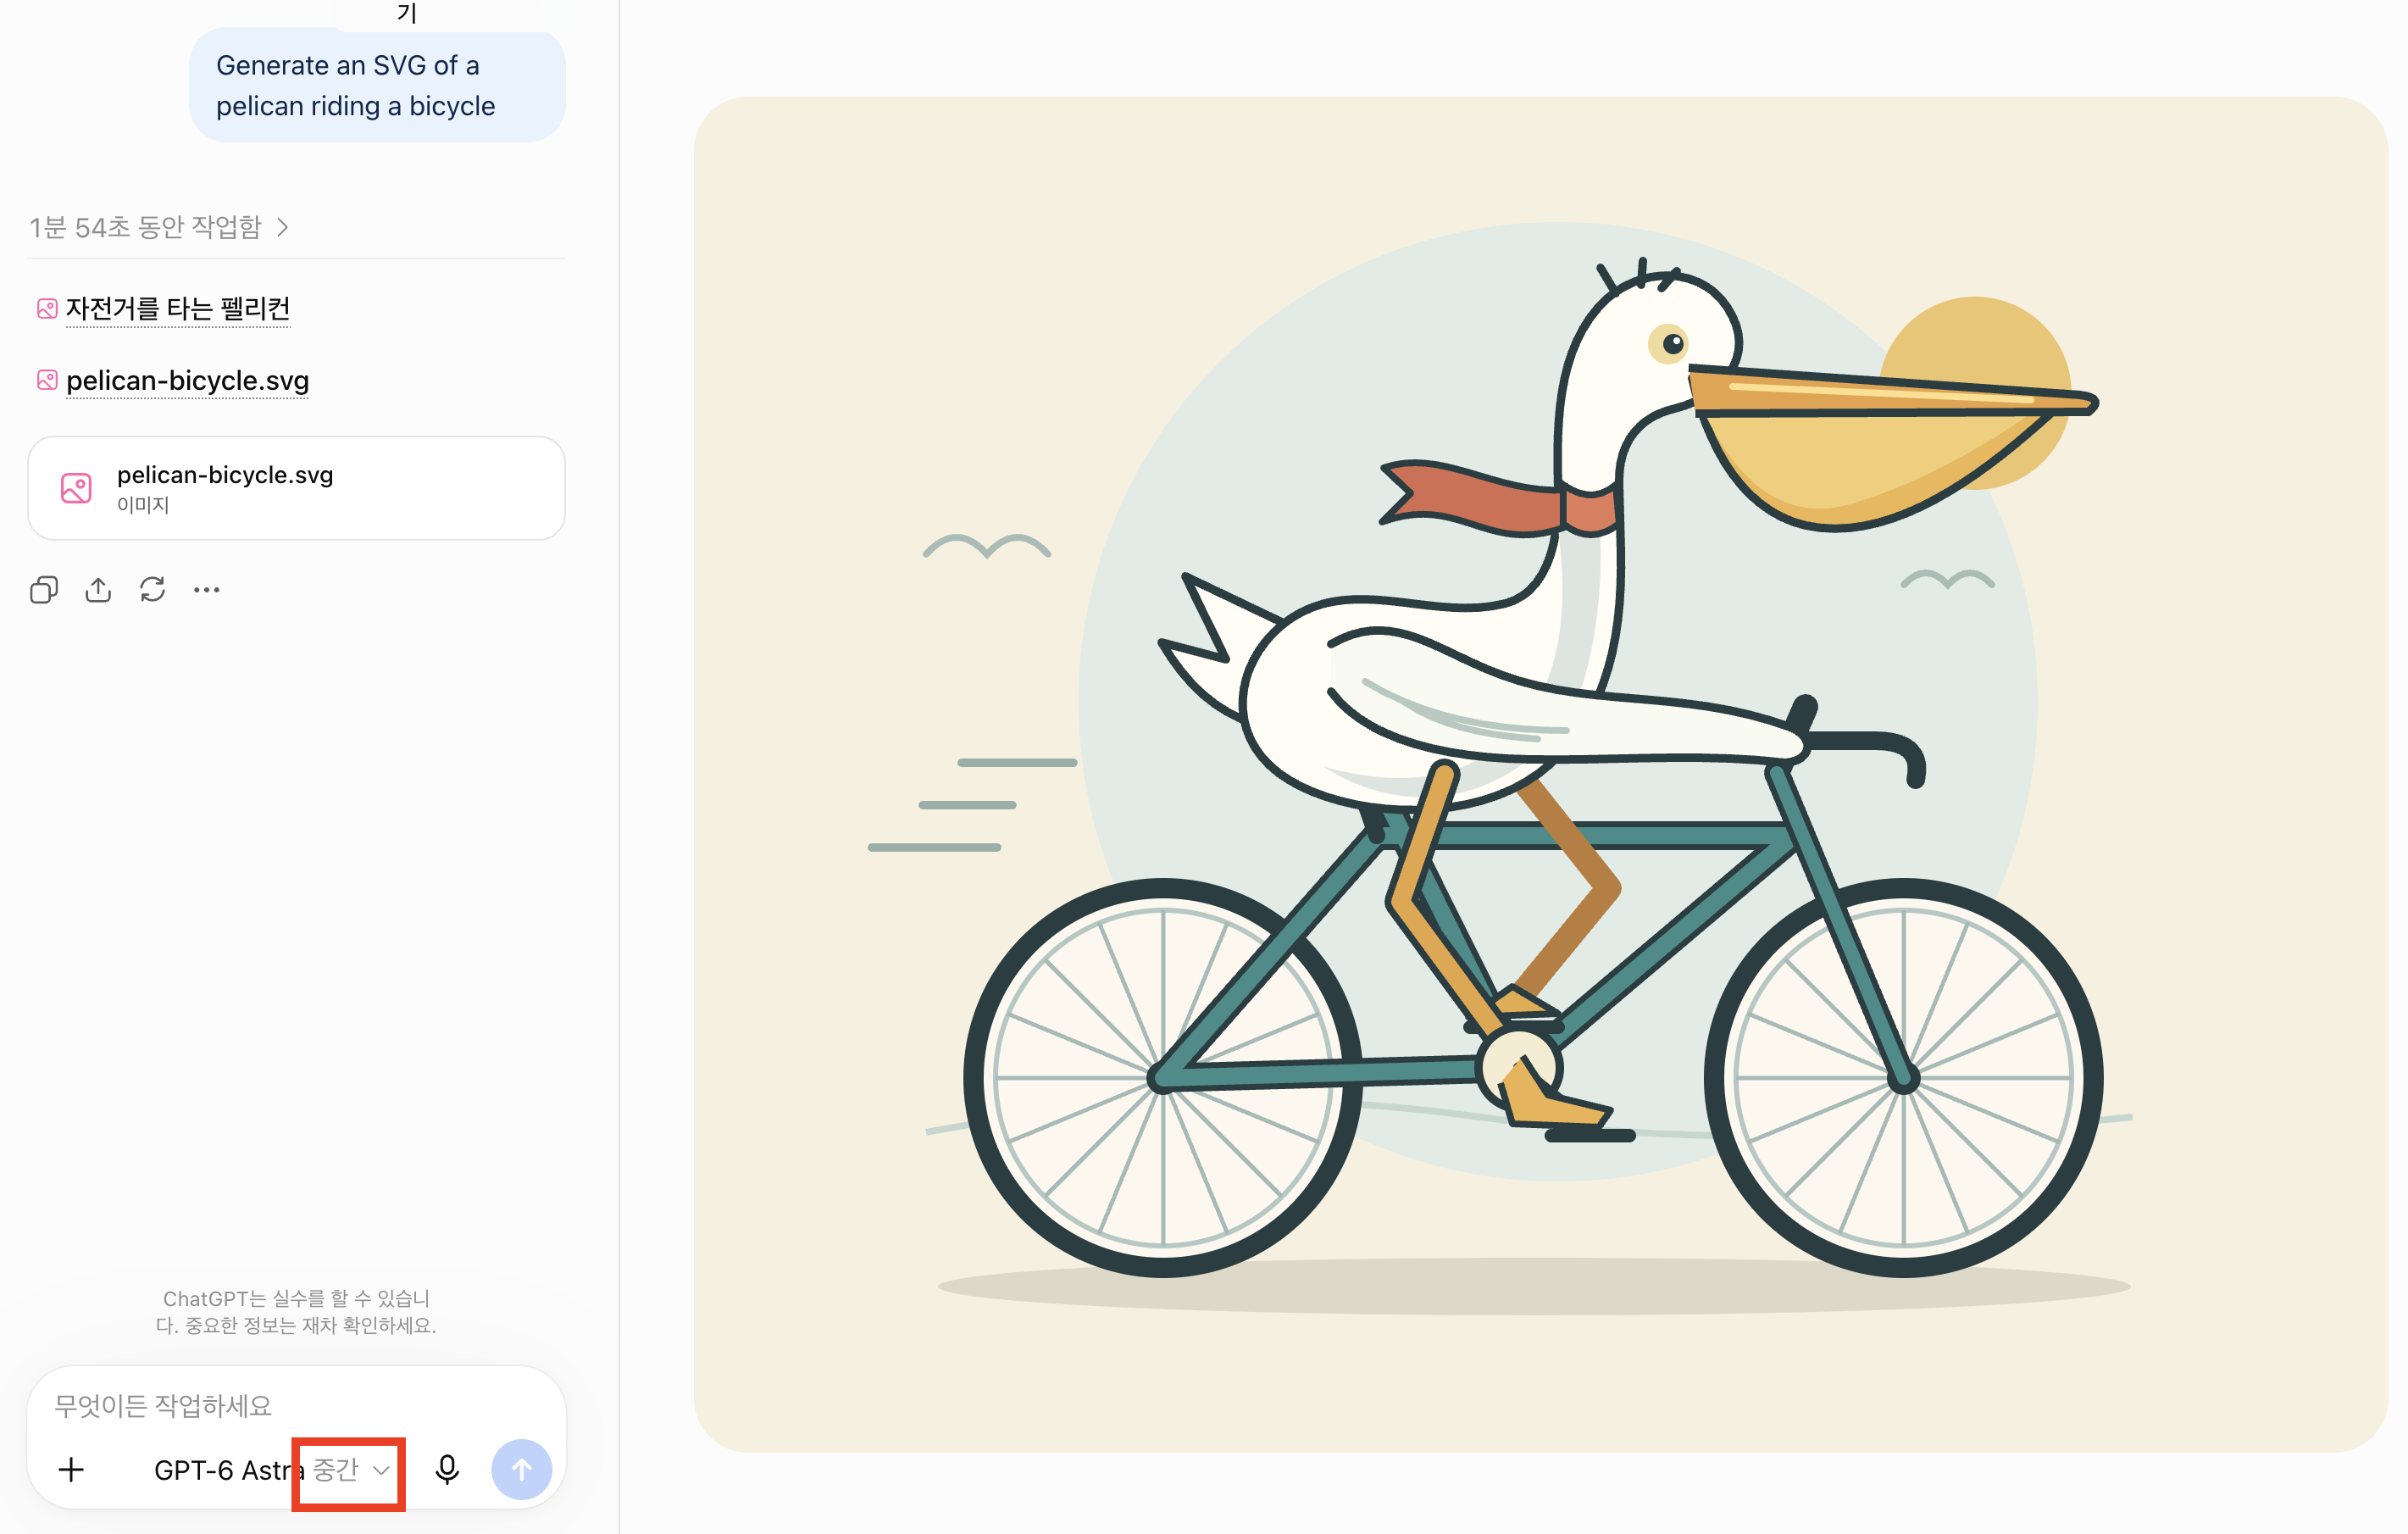
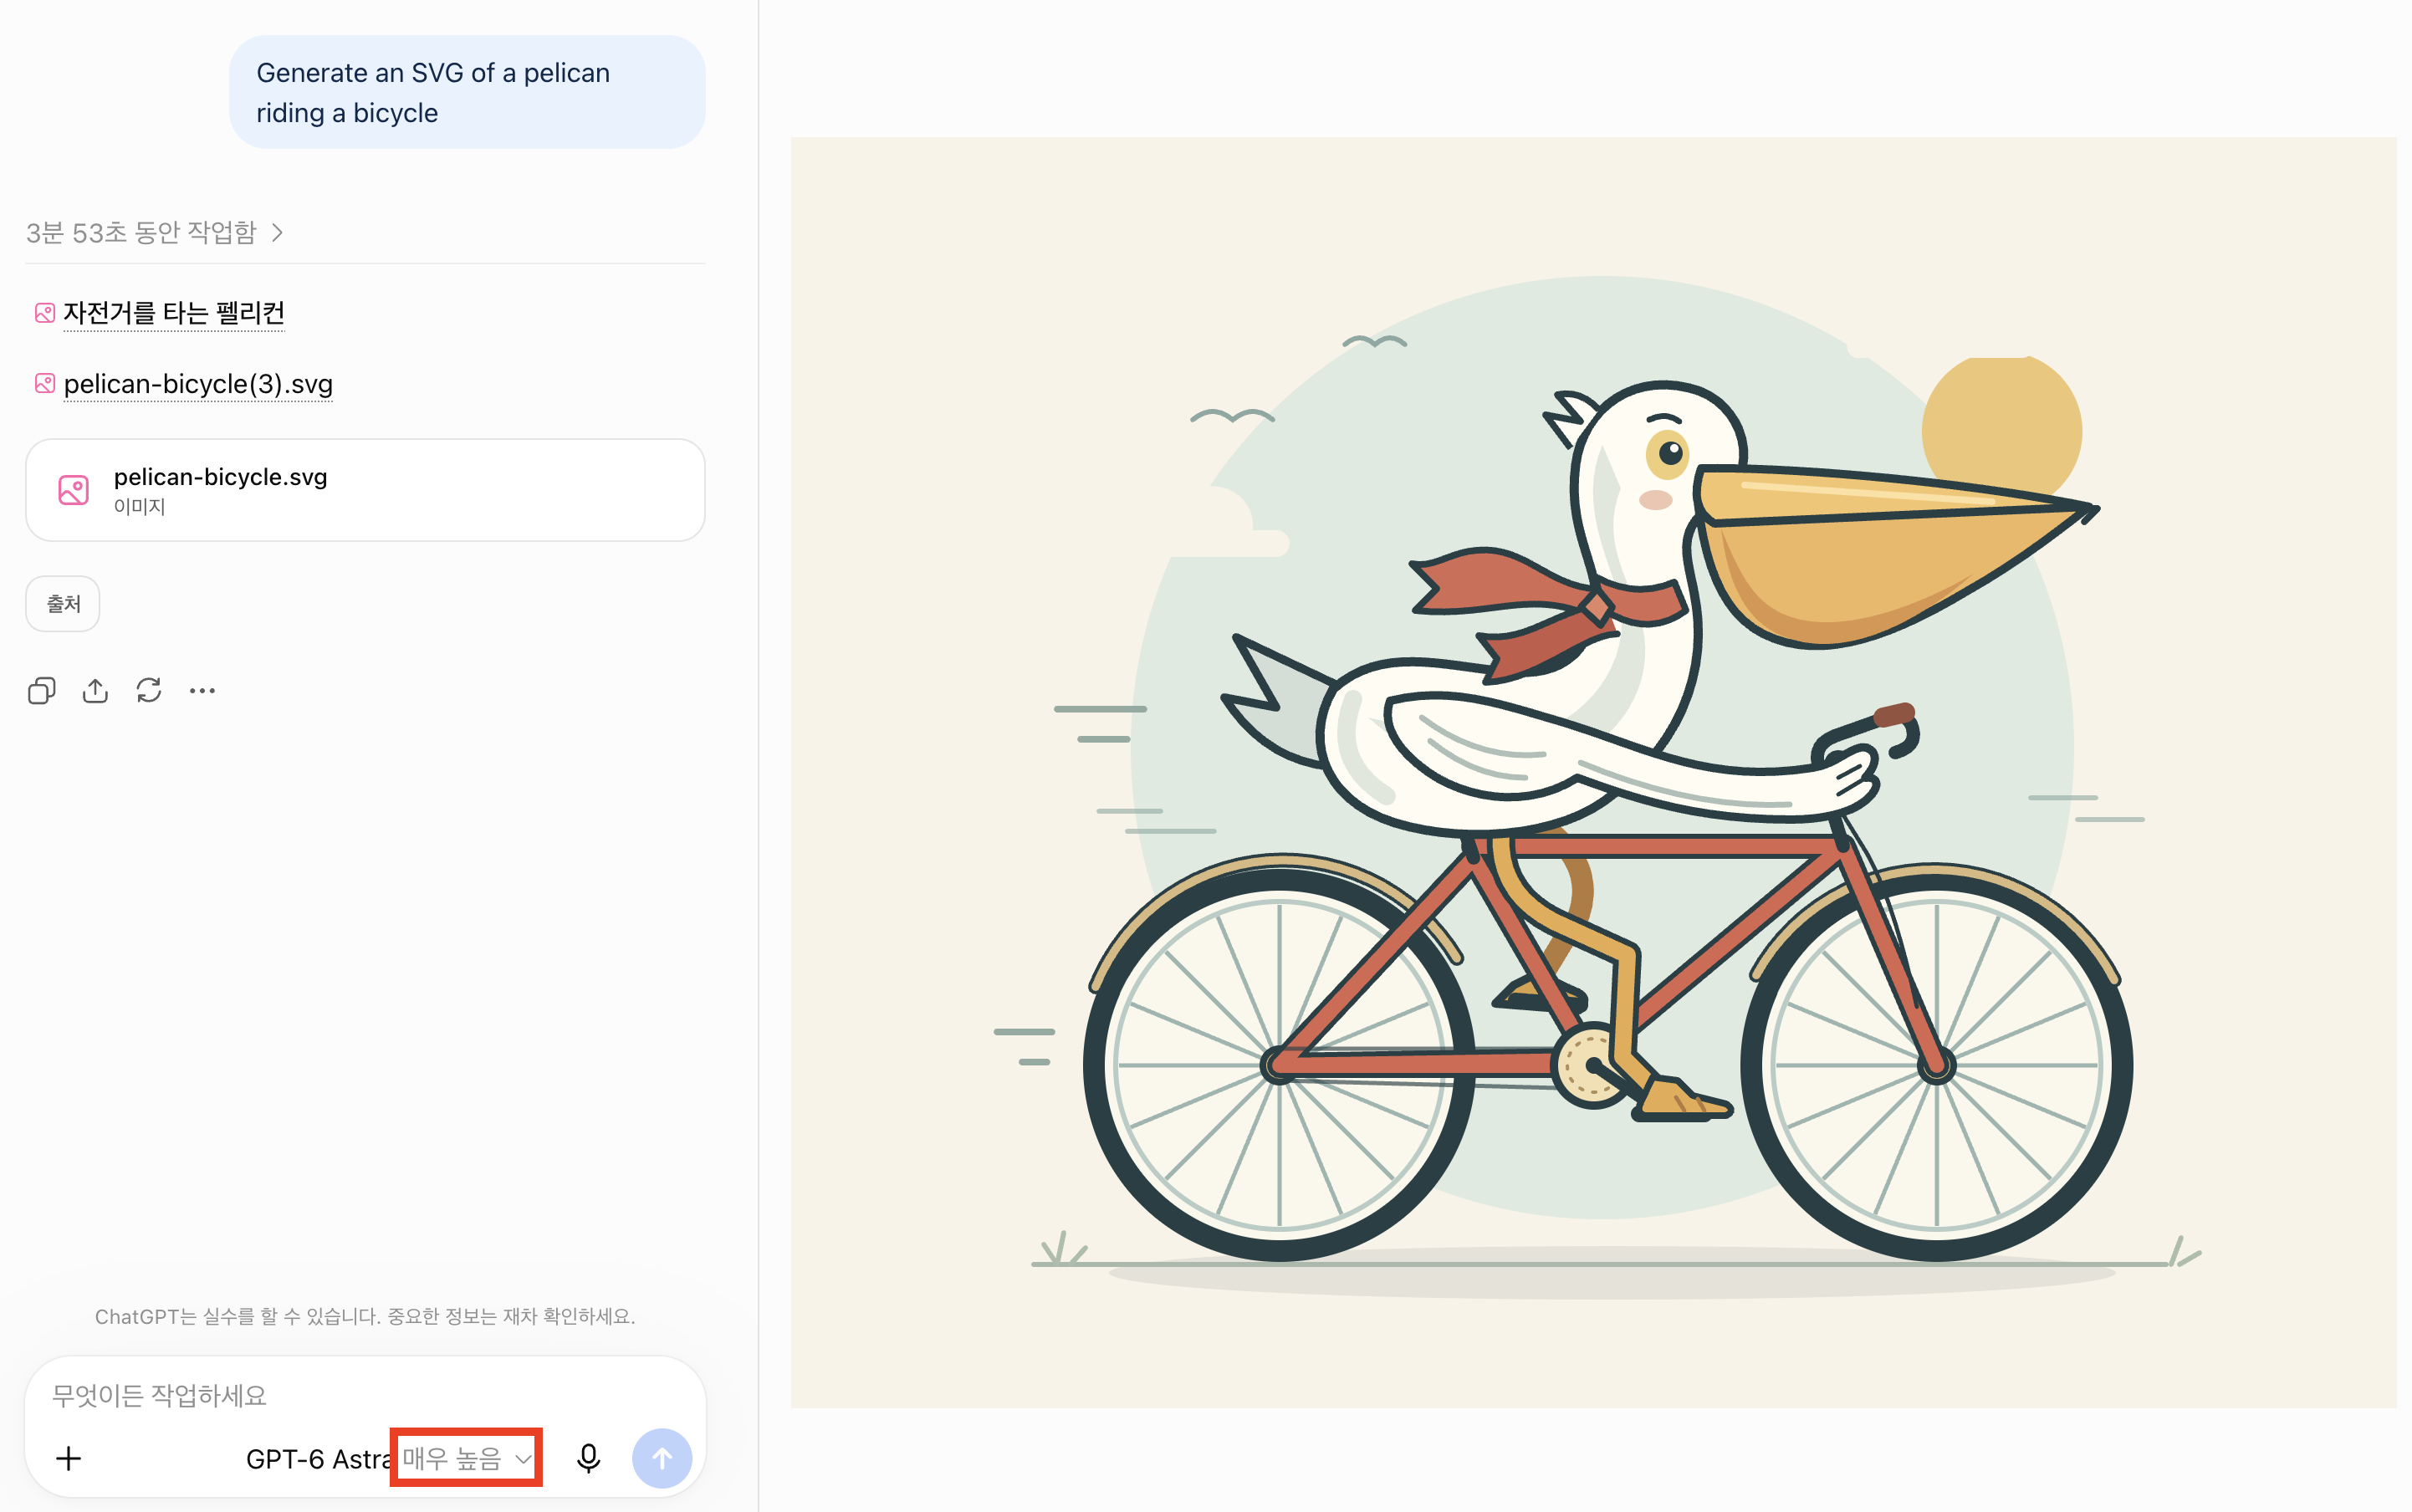
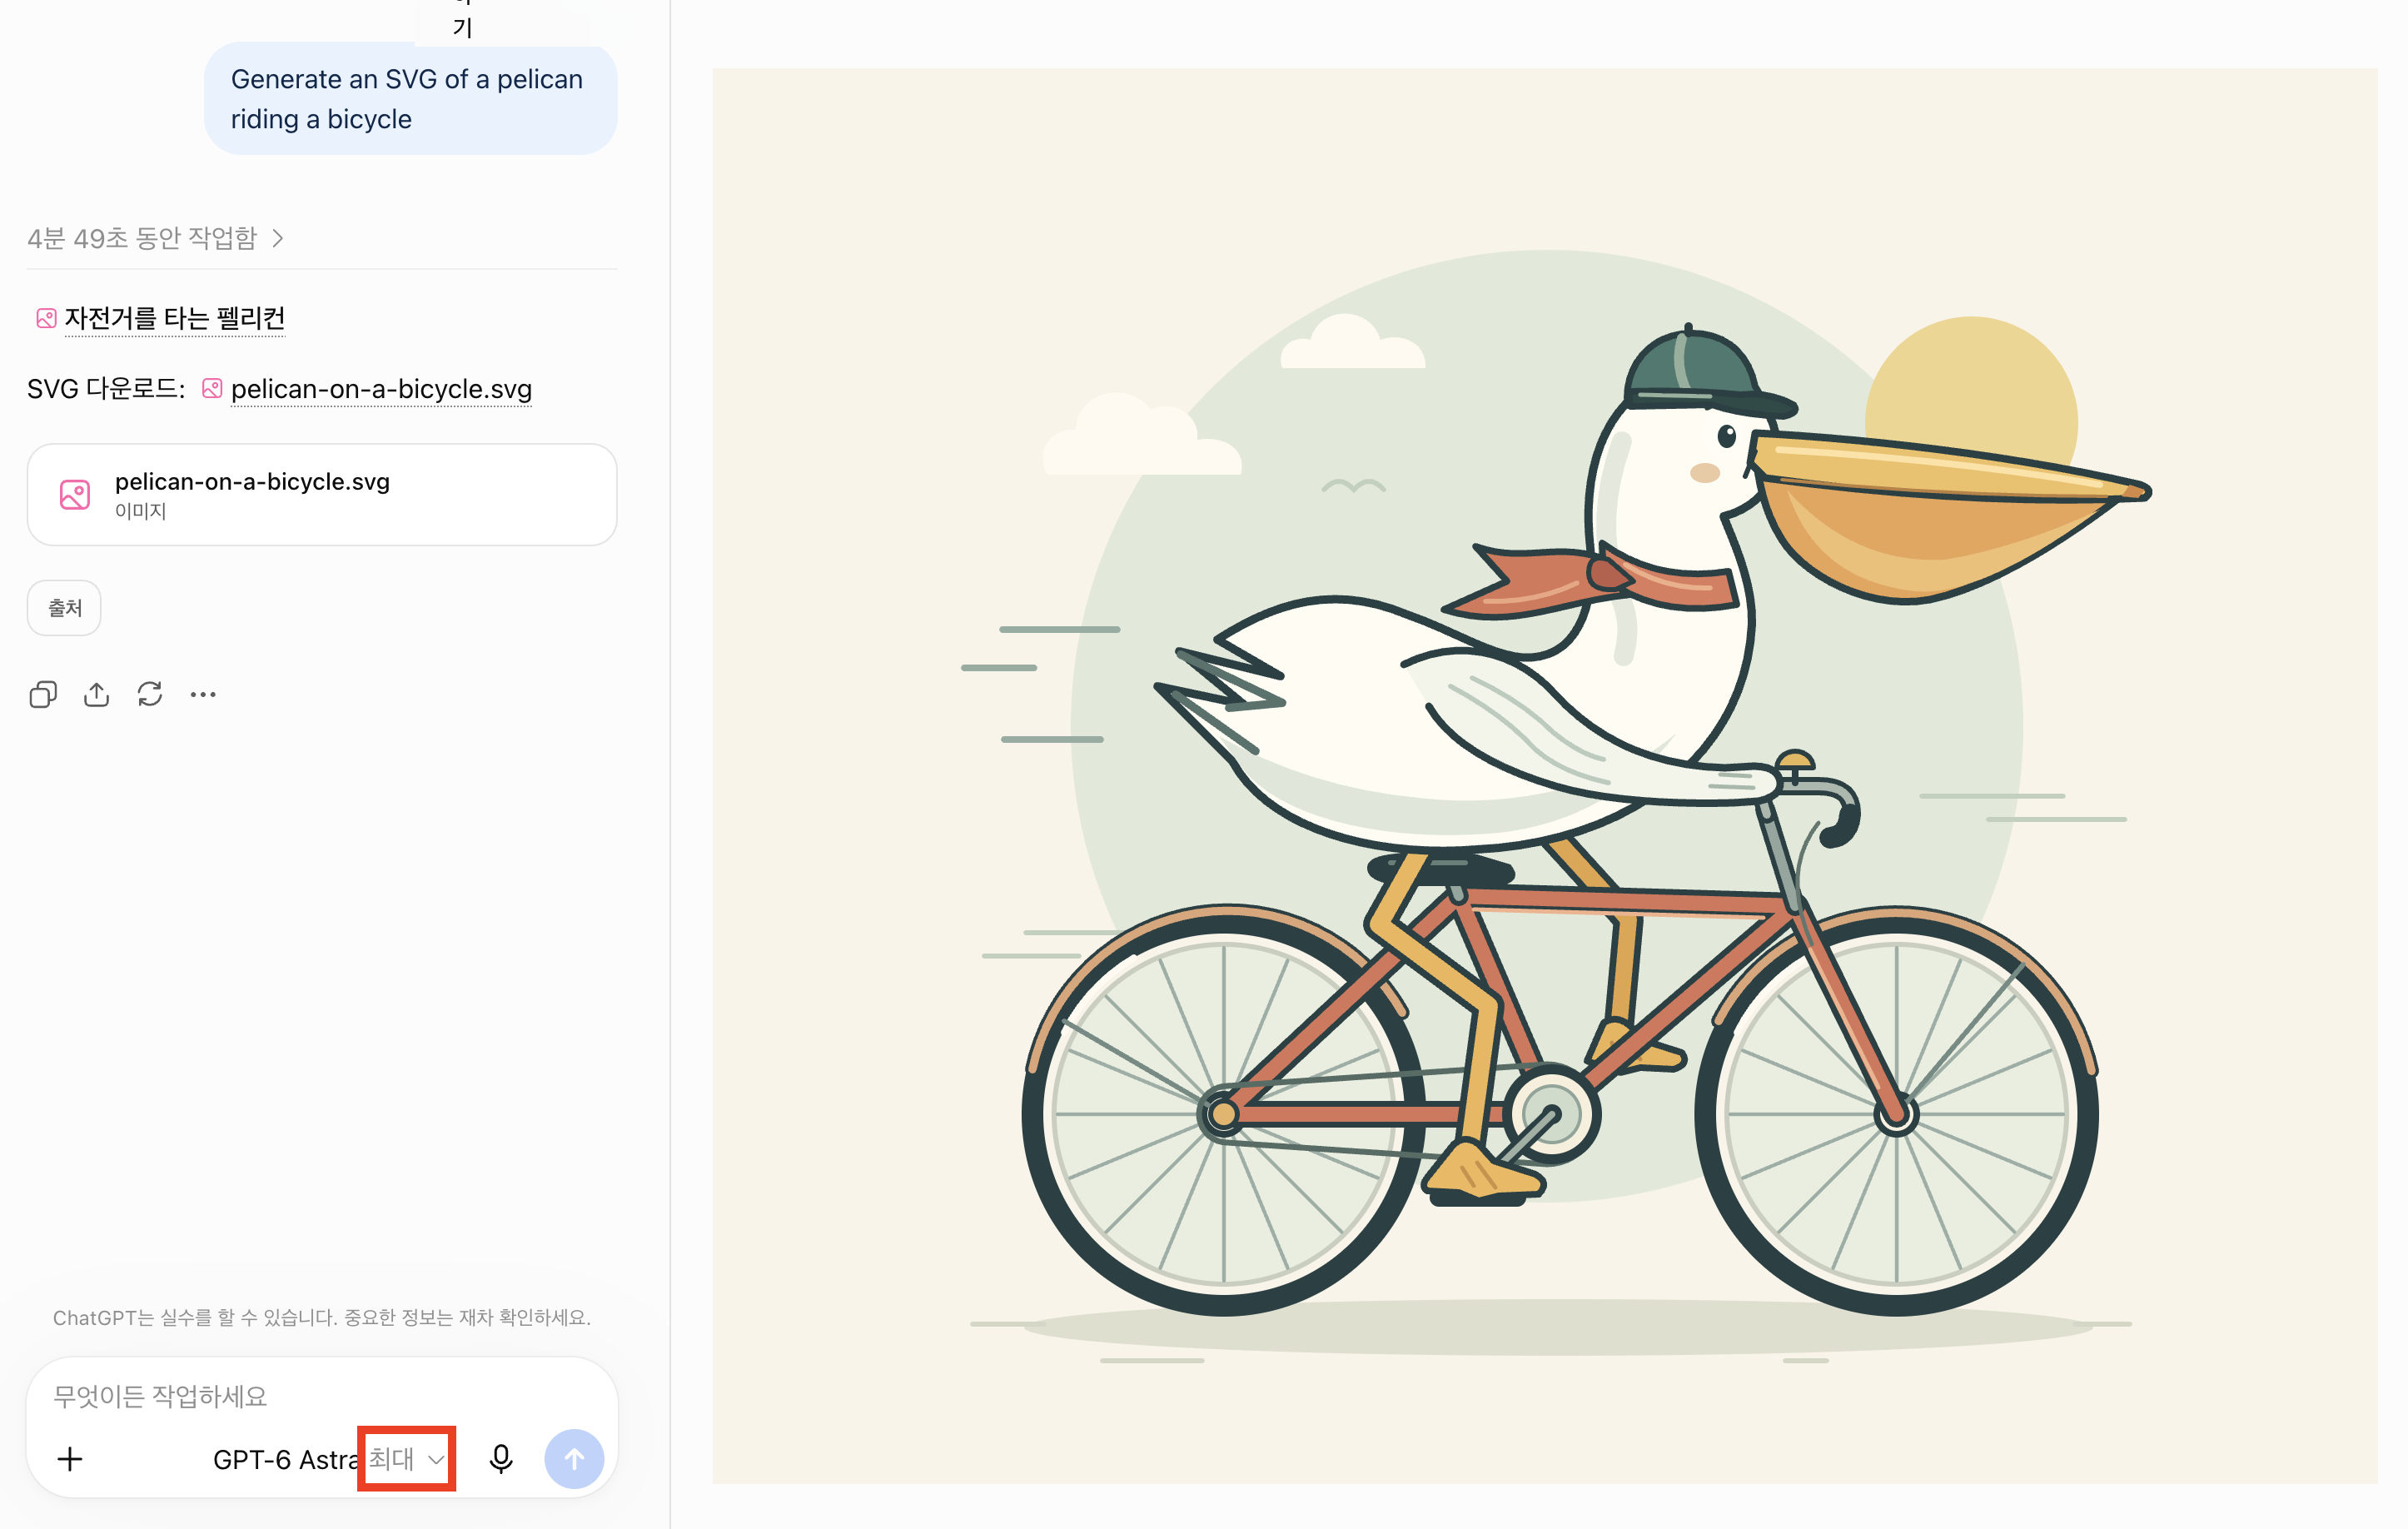
나온 SVG 코드를 브라우저나 편집기 미리보기로 열면 바로 그림이 보인다.
왜 하필 펠리컨과 자전거일까. 펠리컨은 몸 비율이 어색한 새이고 자전거는 부품 위치가 조금만 틀어져도 바로 이상해 보인다. 게다가 학습 데이터에 “자전거 타는 펠리컨” 그림이 흔할 리 없다. 외워둔 걸 꺼내는 게 아니라 구조를 좌표로 계산해서 그려야 하는 문제인 셈이다.
여기에 한 가지만 더 해보면 훨씬 재밌어진다. 같은 한 줄을 effort만 low, medium, high, max로 바꿔가며 네 번 넣고 결과를 나란히 놓아보자. 4장과 5장에서 다룬 “effort를 올린다고 항상 좋아지지는 않는다”를 내 눈으로 확인할 수 있다. Willison도 max 아래 설정에서는 다리 배치가 불안정했다고 지적했다.
참고로 Willison 본인은 이 테스트가 모델 품질과의 상관관계가 예전 같지 않다고 여러 번 밝혔다. 순위를 매기는 용도가 아니라, 감을 잡는 첫 단추로 쓰는 게 맞다.
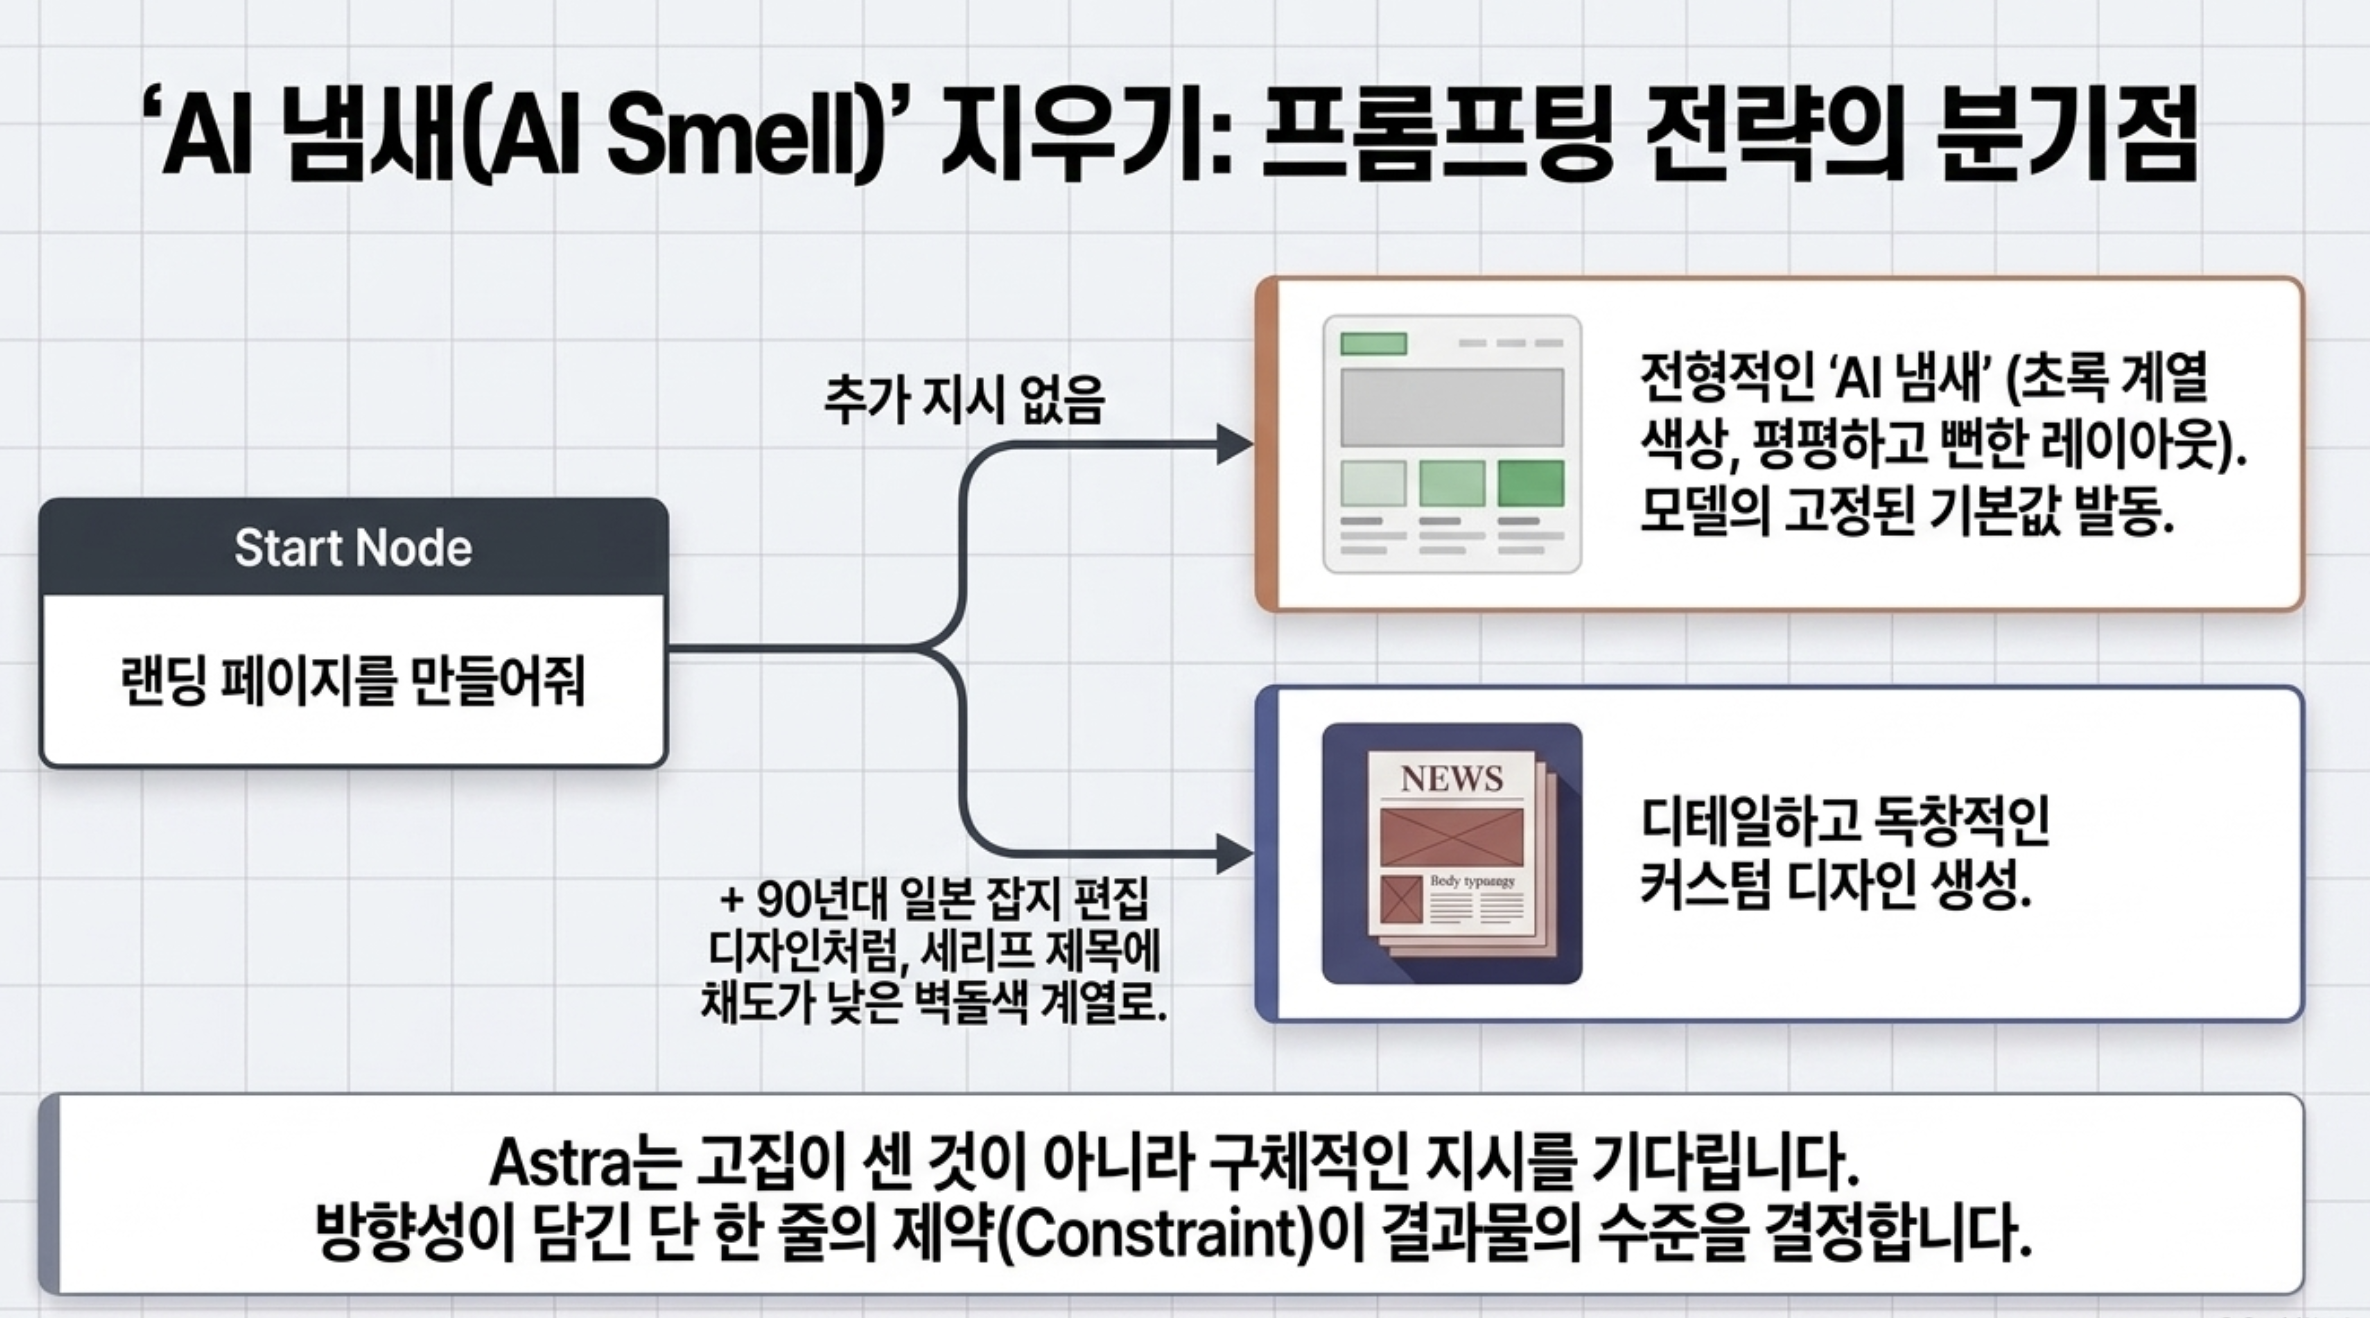
이 테스트는 결과물을 얻는 게 목적이 아니라 모델의 기본 성격을 알아내는 것이 목적이다. 5분이면 된다.
리뷰어 Matthew Berman이 짚은 관찰에서 나온 방법이다. 그는 방향을 따로 지시하지 않고 만든 결과물 대여섯 개를 나란히 놓고 보면 비슷한 초록 계열 색과 평평한 디자인이 반복해서 나온다고 했고, 이걸 “AI 냄새(AI smell)”라고 불렀다. 버그가 아니라 지시가 없을 때 돌아가는 기본값에 가깝다.
직접 확인하려면 같은 요청을 두 번 하면 된다.
[A] 방향 지시 없이
개인 포트폴리오 랜딩 페이지를 하나 만들어줘. 한 파일짜리 HTML이면 된다.

[B] 한 줄만 방향을 주고
개인 포트폴리오 랜딩 페이지를 하나 만들어줘. 한 파일짜리 HTML이면 된다.
90년대 일본 잡지 편집 디자인처럼, 세리프 제목에 여백을 크게 두고
채도가 낮은 벽돌색 계열로 가줘.
ex) [A] 개인 포트폴리오 랜딩 페이지를 하나 만들어줘. 한 파일짜리 HTML이면 된다.
ex) [B] 개인 포트폴리오 랜딩 페이지를 하나 만들어줘. 한
파일짜리 HTML이면 된다. 90년대 일본 잡지 편집 디자인처럼, 세리프 제목에 여백을 크게 두고 채도가 낮은 벽돌색 계열로 가줘.
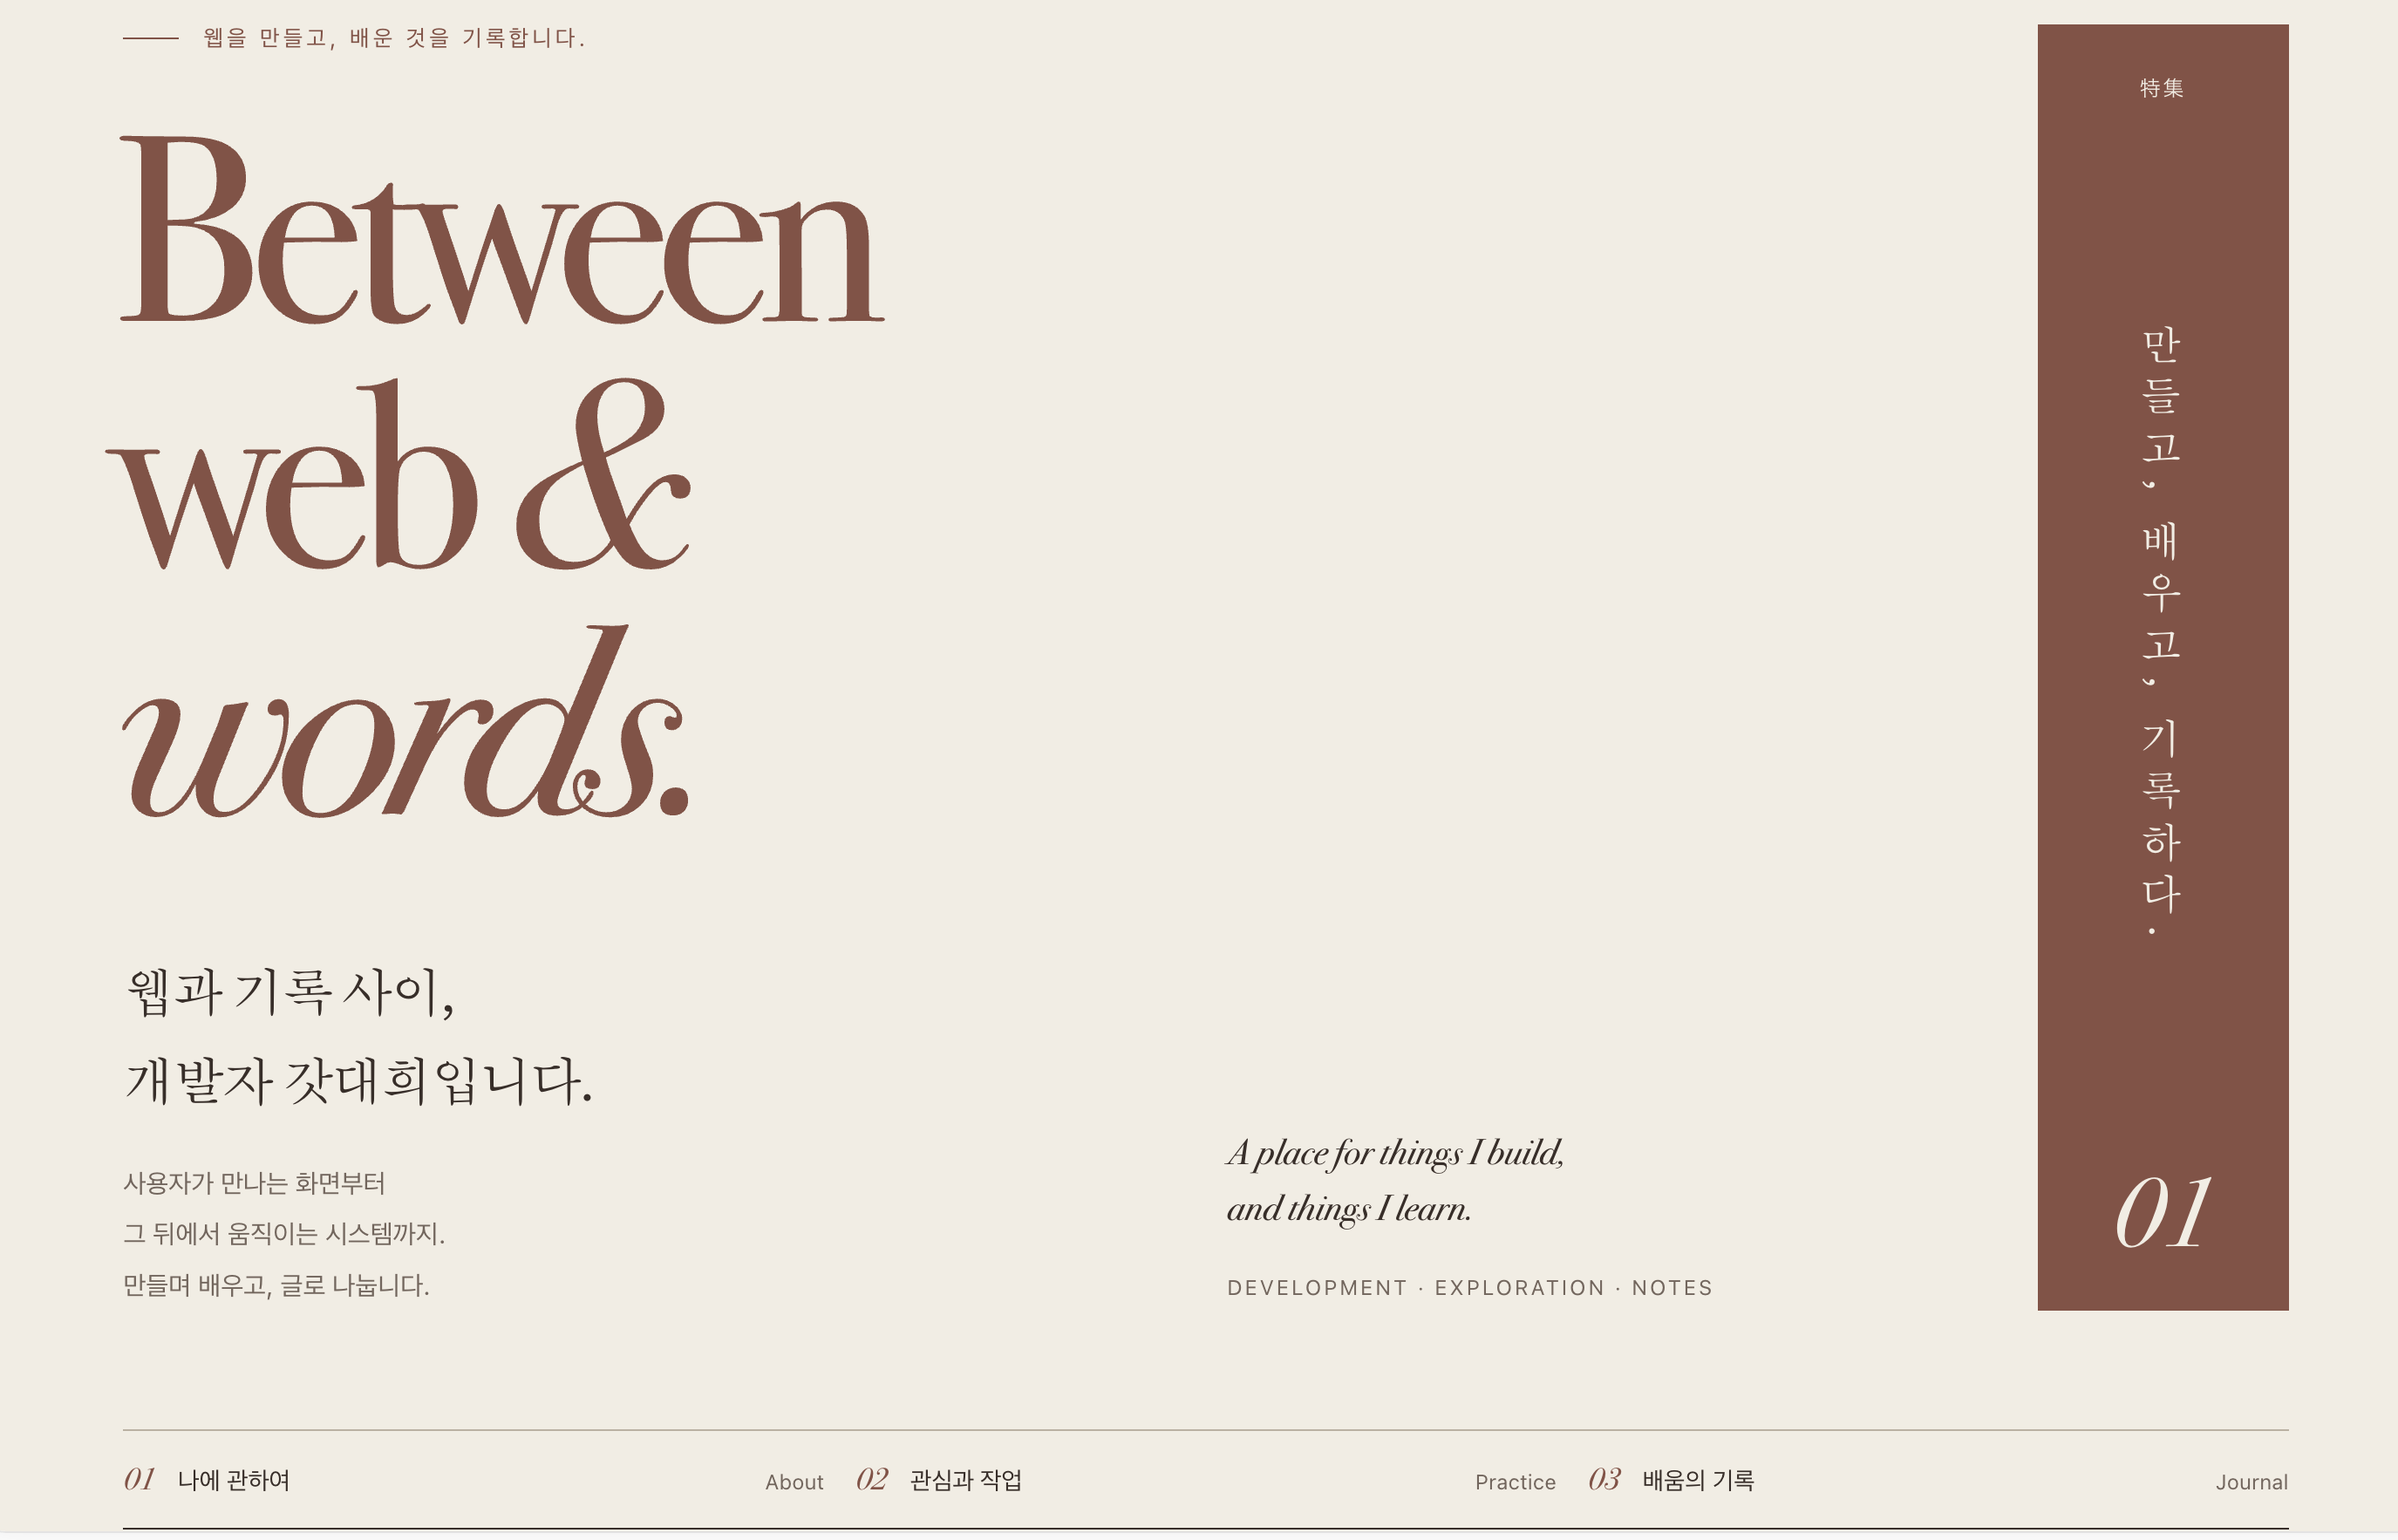
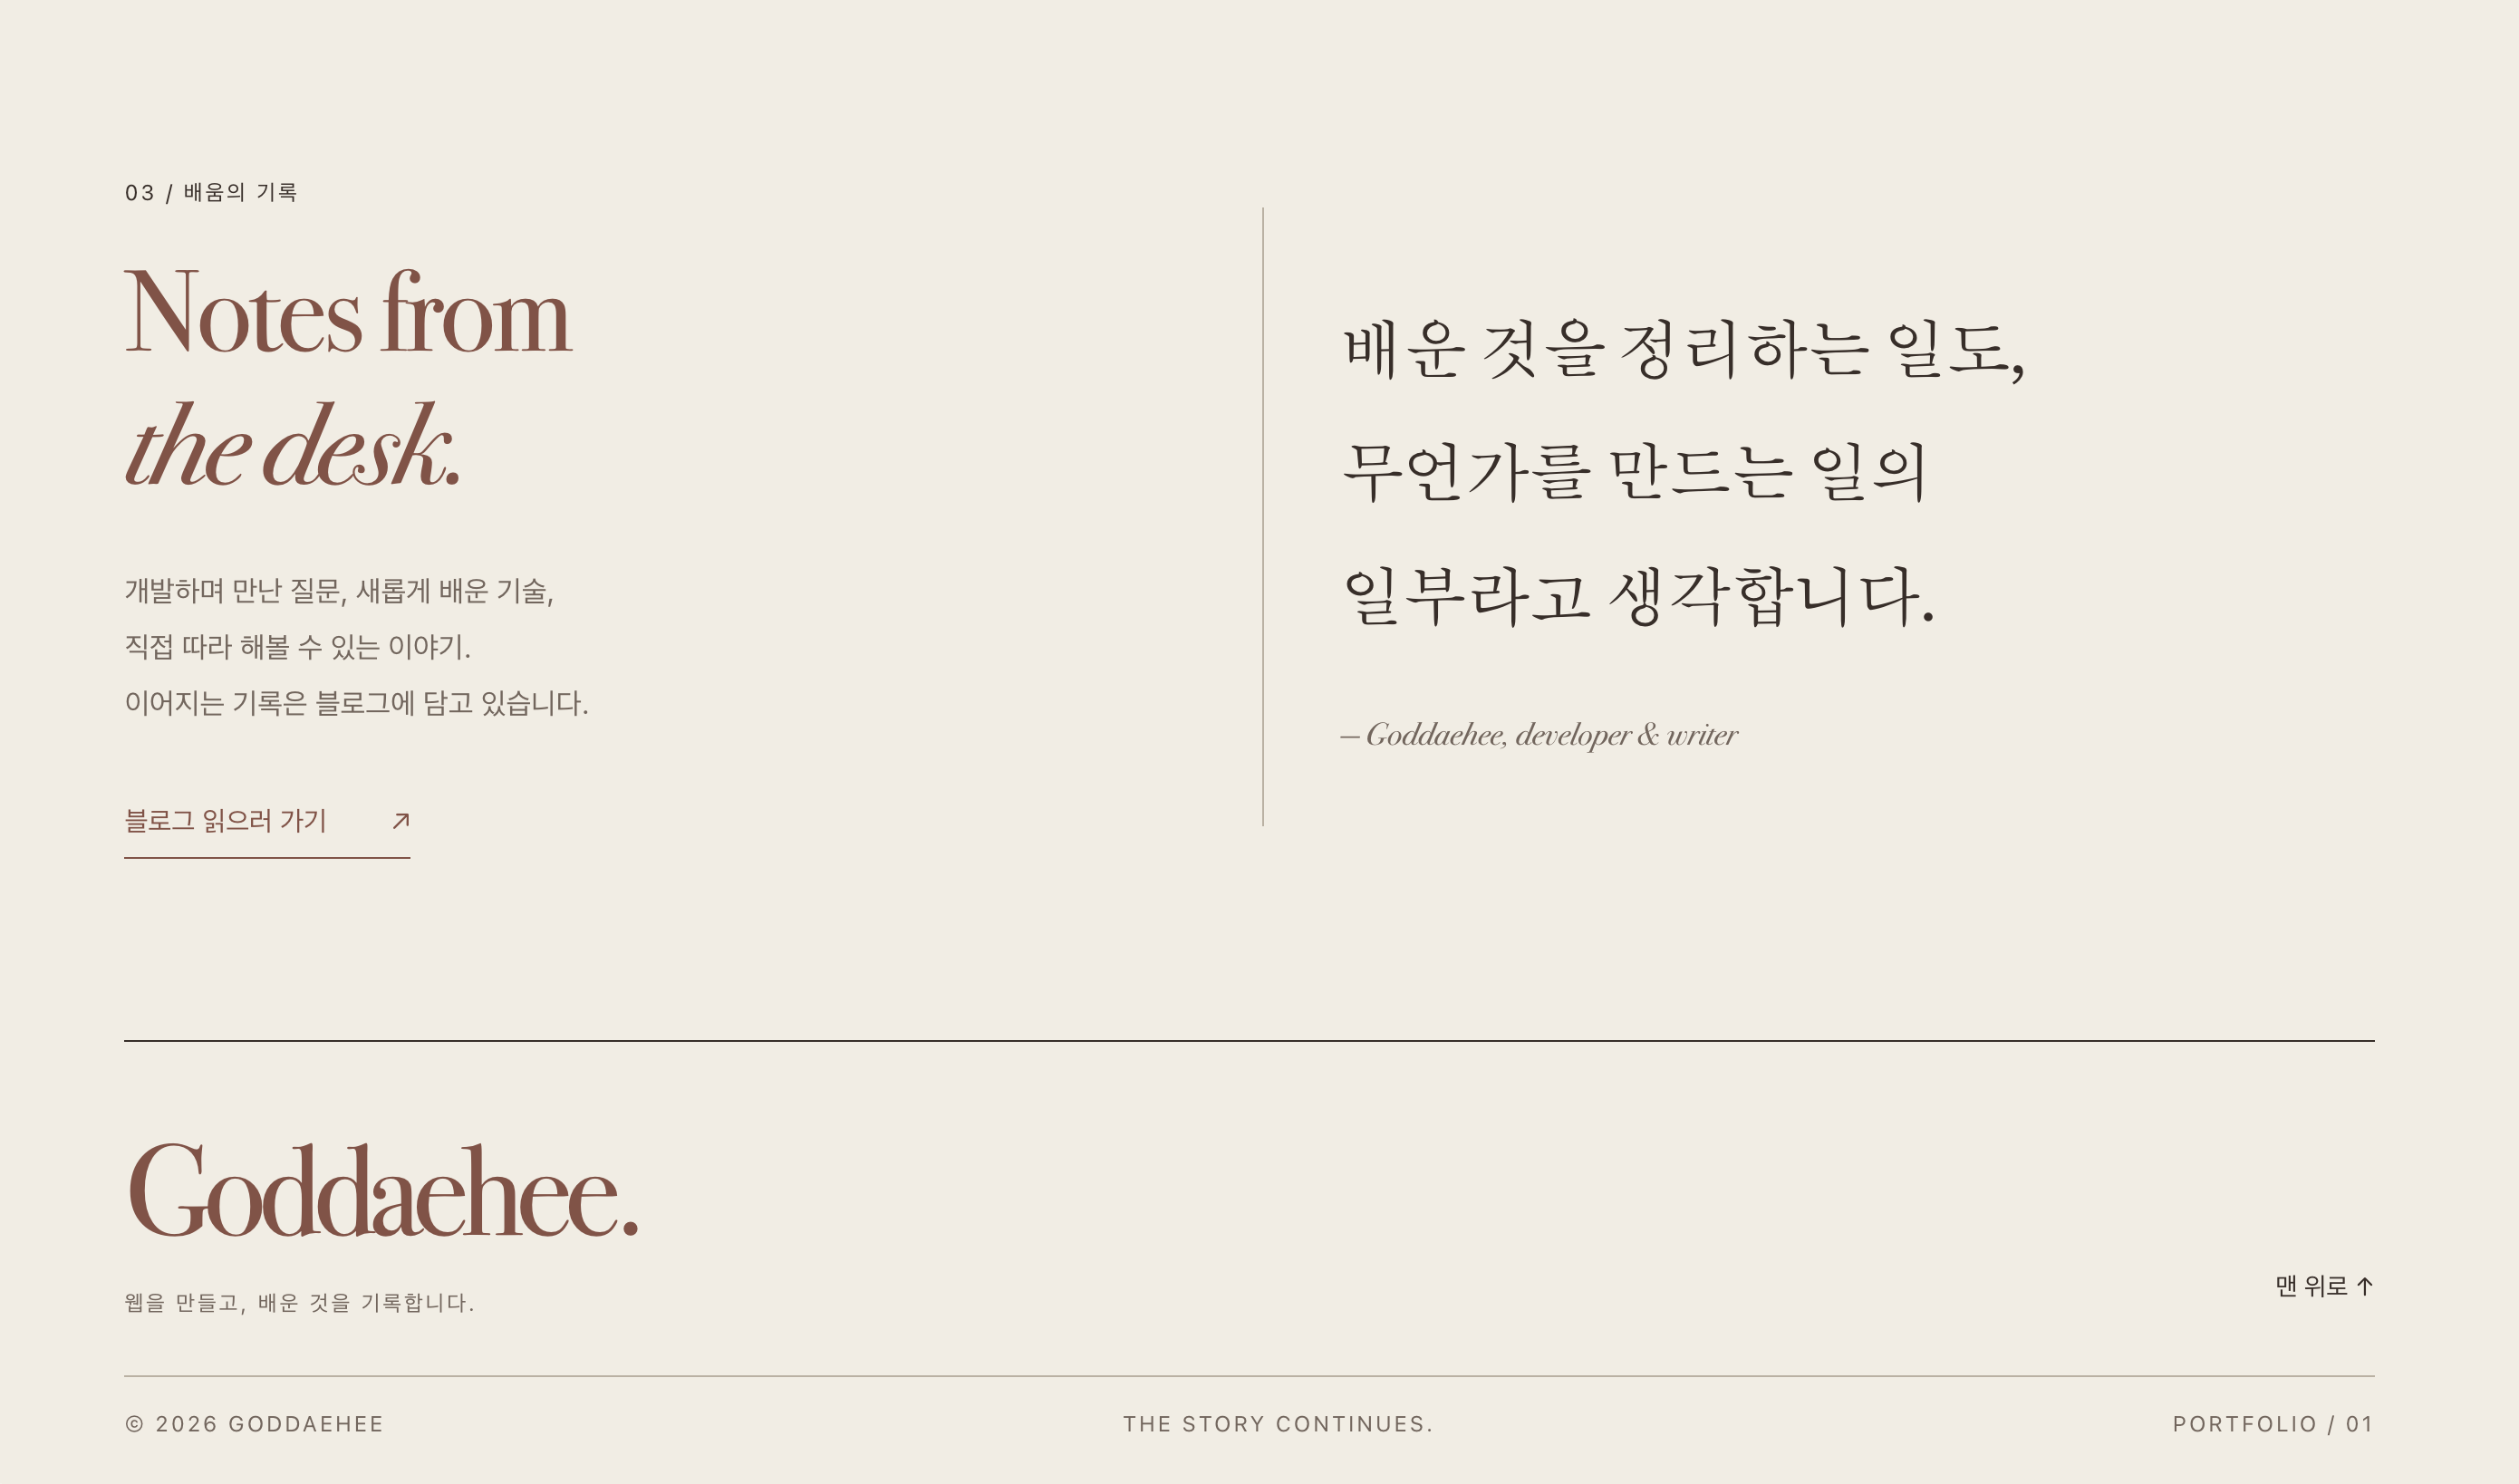
A를 서너 번 반복해서 결과를 모아두고 B와 비교해보자. Berman이 함께 짚은 게 더 중요한데, 한 줄만 방향을 줘도 결과가 확 달라진다는 점이다. 모델이 고집이 센 게 아니라 지시를 기다리고 있었던 셈이다.
이 차이를 한 번 보고 나면 프롬프트를 쓰는 습관이 바뀐다. “예쁘게 만들어줘”라고 쓸 자리에 무엇을 적어야 하는지 감이 잡히기 때문이다.
여기서부터는 실무 판단에 바로 쓸 수 있는 테스트다.
개발자 블로그 paddo.dev 운영자가 자기 블로그 코드베이스로 직접 해본 실험인데, 방법이 단순하다.
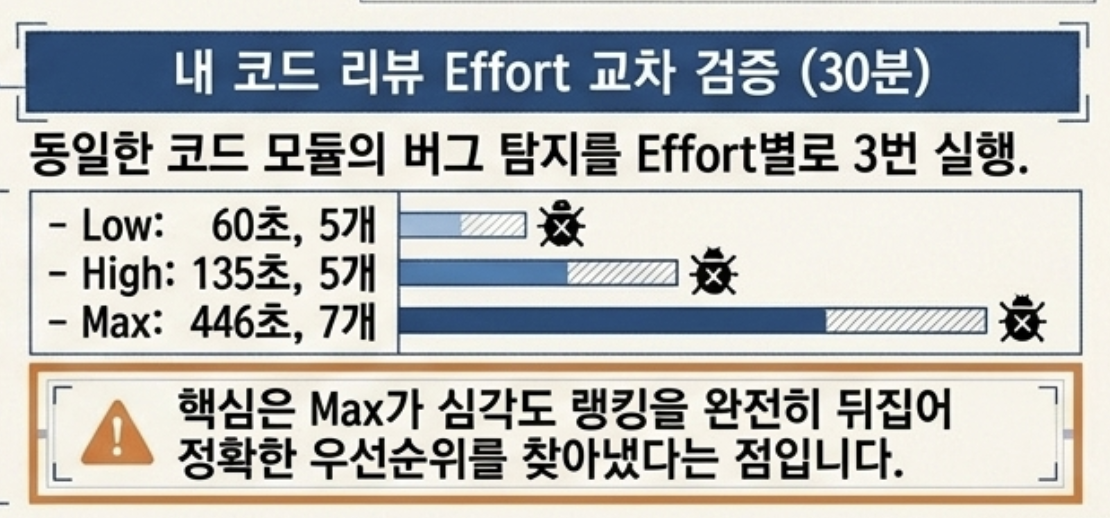
같은 리뷰 요청을 effort만 low·high·max로 바꿔서 세 번 넣고, 나온 지적이 진짜 버그인지 자기가 채점했다.
Review this [코드/모듈 이름]. Report anything that could cause [구체적으로 걱정되는
실패 상황 — 예: 예약된 글이 예정보다 먼저 공개되거나, 이미 공개된 글이 숨겨지는 것]
핵심은 "버그 찾아줘"라고 막연히 묻지 않고 어떤 실패가 걱정되는지를 지정하는 것이다. 결과는 이랬다.
| effort | 시간 | 실행 명령 수 | 비용(API 정가 기준) | 진짜 버그 발견 수 |
|---|---|---|---|---|
| low | 60초 | 3개 | $0.48 | 5개 |
| high | 135초 | 10개 | $1.00 | 5개(low와 동일) |
| max | 446초 | 16개 | $2.06 | 7개 |
일곱 개 전부 실제로 존재하는 문제였다고 한다. low가 60초 만에 찾은 것 중에는 타임존 버그도 있었는데, 재현 스크립트를 직접 짜서 세 개 타임존에서 확인한 뒤 보고했다.
max가 추가로 찾은 두 개 중 하나는 "야간 배치가 재시도 없이 단일 트리거로만 돈다"는 문제였다. 이론상의 위험이 아니라 실제로 전날 예약 시각보다 3시간 18분 늦게 실행된 이력이 있었다고 한다.
더 흥미로운 건 max가 low·high의 판단을 뒤집었다는 점이다. 앞의 두 단계는 도커 캐시 문제를 가장 위험한 항목으로 꼽았는데, max는 배포 로그를 확인한 뒤 그 순위를 낮췄고 실제로 그게 맞았다. 같은 버그 목록이라도 무엇을 먼저 고쳐야 하는지는 다르게 나온 셈이다.
작성자의 결론은 이렇다. "평소 리뷰와 조회는 low가 daily driver다. max는 순위를 잘못 매겼을 때의 대가가 7분보다 클 때 쓰는 감사(audit)용이다. high는 모든 지표에서 중간이었고 low가 놓친 걸 새로 찾아내지는 못했다."
저자 본인도 한계를 명시했다. 과제 하나, 코드베이스 하나, 채점자 한 명이라는 조건이고 low가 운이 좋았을 수도 있다고 적었다. 그래도 내 코드로 30분 안에 재현할 수 있다.
출시 직후 X를 가장 뜨겁게 달군 건 벤치마크가 아니라 게임이었다.
개발자 Theo(t3.gg)는 ‘fishslop’이라는 3D 게임을 한 번에 만들어 공개했고, Matthew Berman은 프롬프트 하나로 폴가이즈 스타일 장애물 게임을 만들었다. 회전하는 봉과 흔들리는 장애물, 결승선 탈락 처리까지 들어갔다.
Astra와 Fable 5.1에게 같은 프롬프트로 GTA 스타일 운전 게임을 시킨 비교도 있었다.
둘 다 돌아다닐 수 있는 도시를 만들었고, Astra가 약 90분, Fable이 약 2시간이 걸렸다고 보고됐다. 다만 이건 통제된 독립 벤치마크가 아니라 개인이 올린 비교다.
여기서 꼭 짚어야 할 게 있다. 대부분의 데모가 모델 하나만으로 나온 게 아니다. Blender MCP, Codex, 브라우저 자동화 같은 도구를 함께 연결한 결과가 많다. 이 구분을 놓치면 “프롬프트 하나면 게임이 나온다”로 잘못 읽게 된다.
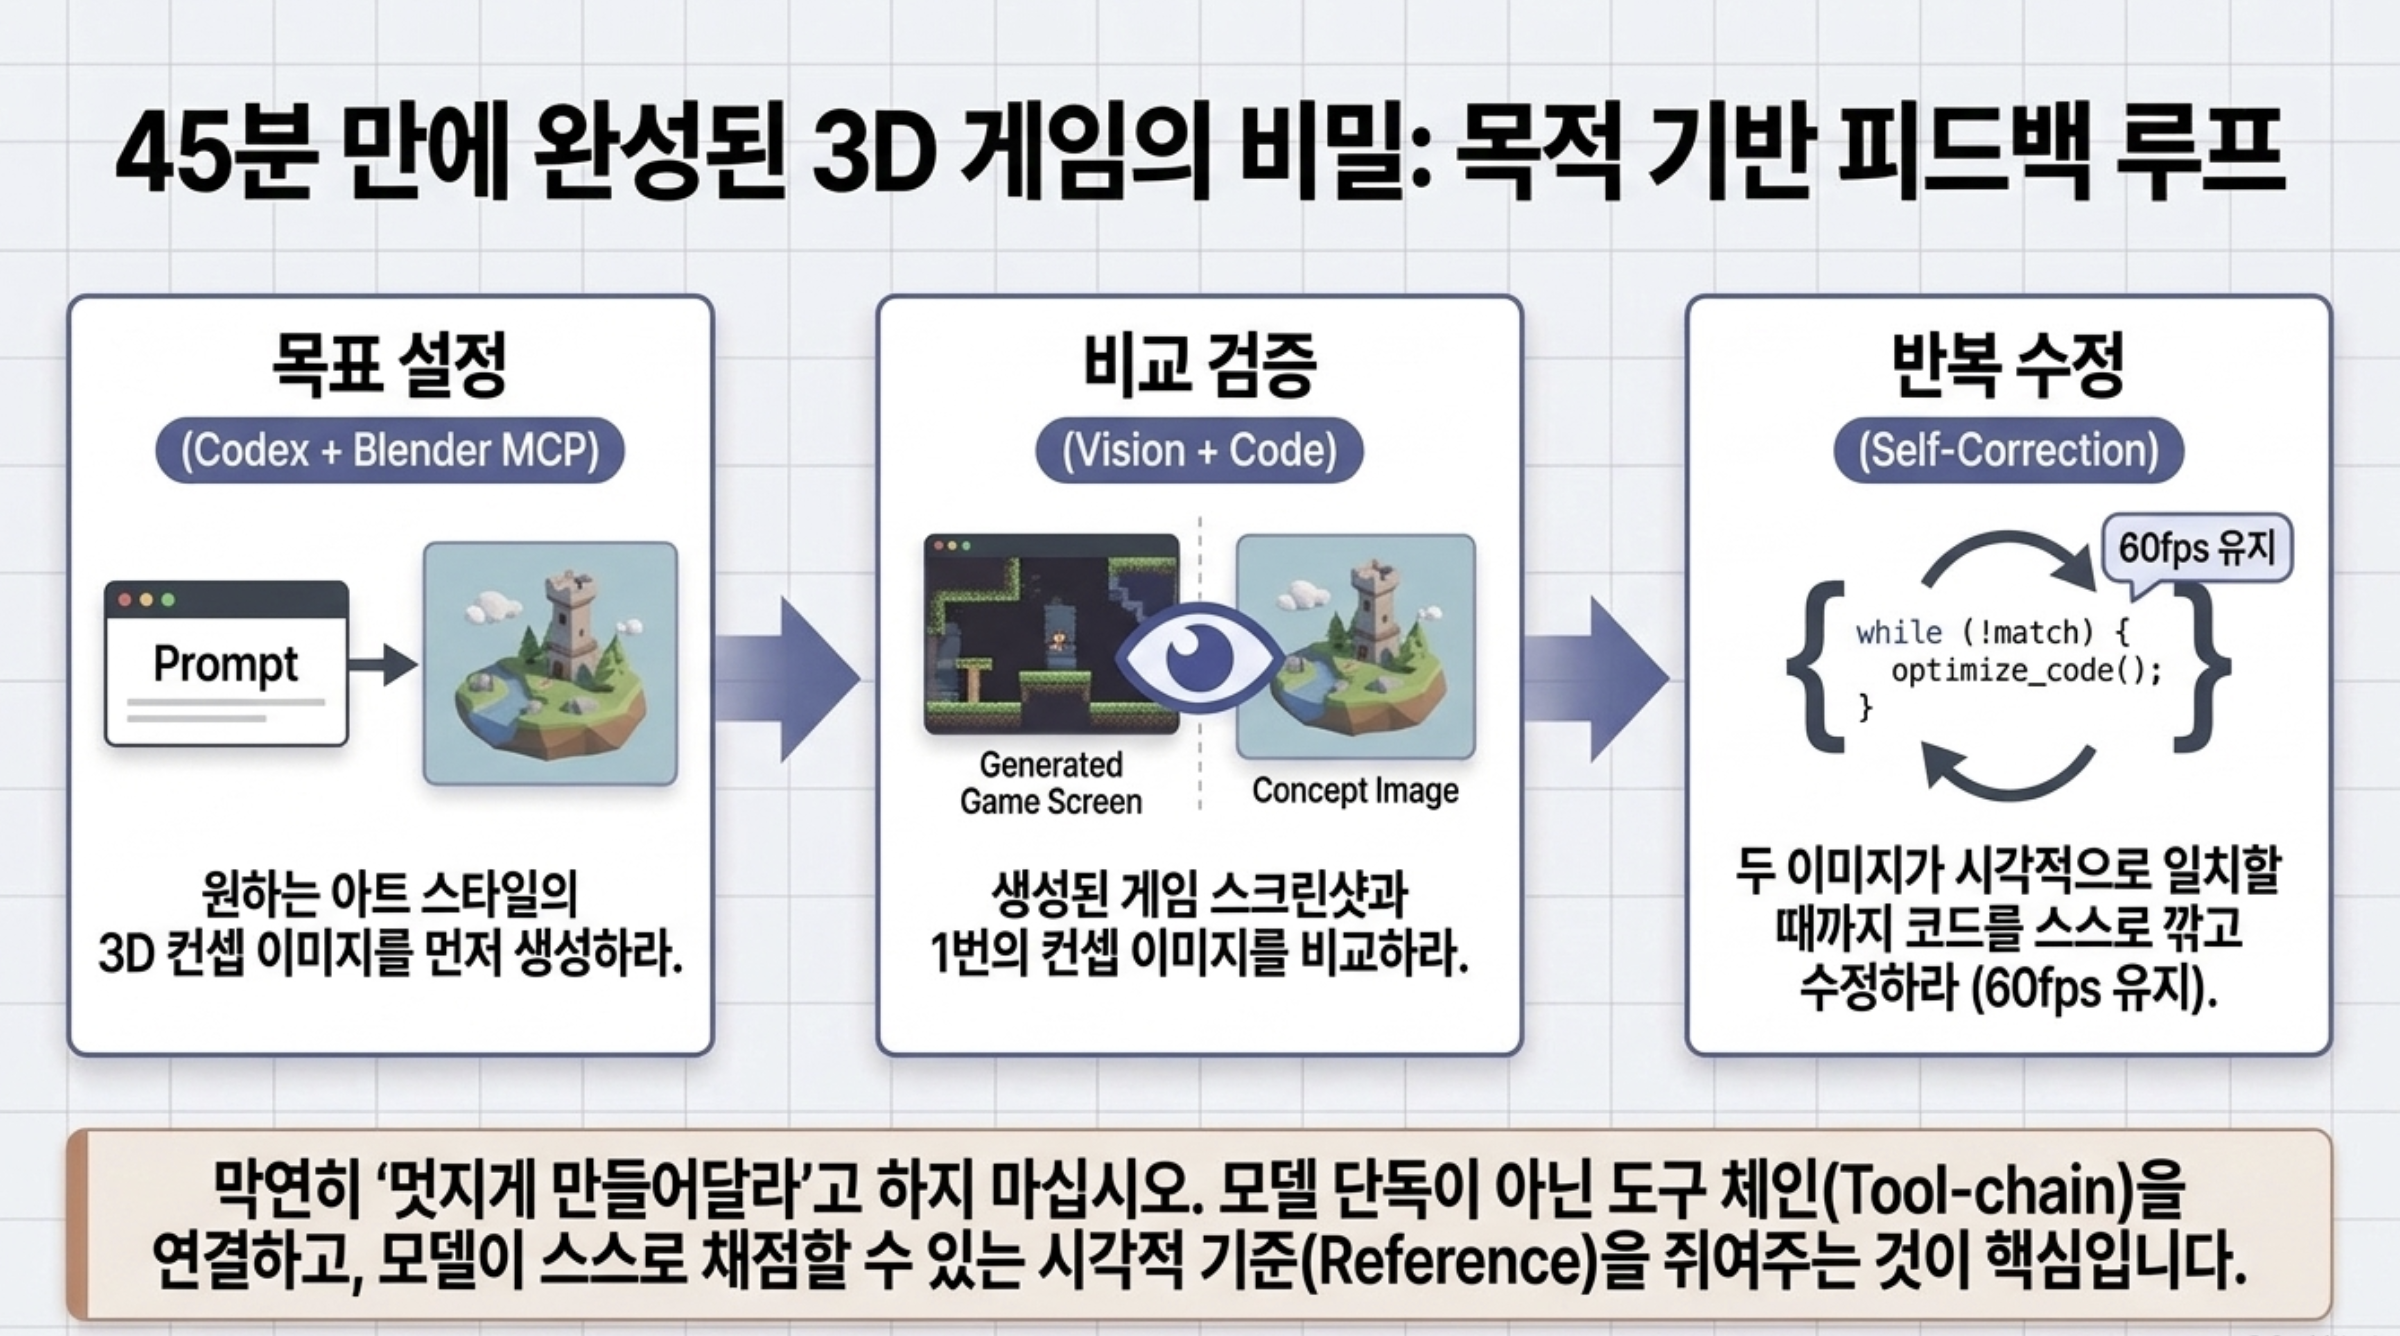
개발자 Anshu(@anshuc)는 45분 만에 한 번에 나온 3D 게임 데모를 공유하면서, 그래픽이 잘 나온 이유를 직접 공개했다. 이 부분이 그대로 따라 할 만하다.
1. Codex를 Blender MCP에 연결한다
2. 만들고 싶은 게임의 컨셉 설명을 그대로 붙여넣는다
3. Astra에게 이렇게 지시한다:
   "Codex의 이미지 생성 기능으로 목표하는 아트 스타일의 컨셉 이미지를 먼저 만들어라.
    그다음 실제 게임 화면 스크린샷이 그 컨셉 이미지에 최대한 가까워질 때까지
    반복해서 수정해라. 60fps를 유지할 것."

   추론 설정: high
핵심은 목표 이미지를 먼저 만들게 하고, 그 이미지를 기준으로 스스로 반복 수정하게 만든 것이다. “멋있게 만들어줘”라는 막연한 요청 대신 모델이 스스로 채점할 기준을 쥐여준 셈이다. 이 발상은 게임이 아닌 작업에도 그대로 응용할 수 있다.
작성자는 브라우저에서 도는 Three.js이고 외부 에셋이나 별도 의존성은 쓰지 않았다고 밝혔다. 다만 처음부터 완성된 게임이 아니라 작은 그래픽 데모를 요청한 결과라는 점도 함께 적었다. 이 조건을 빼고 “45분 만에 게임 완성”으로 읽으면 과장이 된다.
이 사례들은 대부분 X 게시물과 그 요약본이 출처다. 결과 화면은 있지만 소스 코드나 생성 과정 전체가 함께 공개된 경우는 드물다. 재미있게 볼 자료이지, 성능을 증명하는 측정치로 쓸 자료는 아니다.
AI 매체 Kingy AI가 Astra와 GPT-5.6 Sol에게 바이트 단위로 동일한 1,887자 프롬프트를 주고 같은 웹 앱을 만들게 한 뒤, 12개 고정 항목으로 채점한 기록이 있다. 프롬프트 원문과 입력 파일, 두 모델의 결과물까지 전부 다운로드로 공개돼 있어서 그대로 재현할 수 있다.
과제는 SignalDesk라는 가상 제품의 대시보드를 만드는 것이었다. JSON 파일에 든 12개 레코드를 검색·필터링하고, 키보드로 상세 화면을 열고, 두 개를 골라 비교하고, 새로고침해도 상태가 유지되고, 390px 화면에서도 쓸 수 있어야 한다는 조건이었다.
Build a polished local web prototype for the fictional SignalDesk product using
signaldesk-product-brief.md and app-records.json. Use plain HTML, CSS, and
JavaScript with no package installation, external assets, remote APIs,
analytics, authentication, deployment, or external app writes.

Required behavior:
- Load and display all 12 records from app-records.json.
- Show summary counts for all records, High-impact, Launched, and Preview.
- Provide a case-insensitive text search across provider, product, category,
  and summary.
- Provide working Provider, Category, Status, and Impact filters plus a
  clear-all control.
- Let the user open a record in an accessible details drawer or dialog.
- Let the user select up to two records and compare their date, provider,
  category, status, impact, and summary side by side.
- Preserve search, filter, and comparison state across a page reload with
  localStorage.
- Include an empty state when filters return no records.

Serve the app locally. Verify the required interactions in a real browser,
including keyboard access to the details view and the 390 px layout. Check the
browser console for errors. Save at least one desktop and one mobile screenshot
locally. Report the output paths, test evidence, and any remaining defect.
(지면상 일부를 줄였다. 전체 원문과 입력 파일은 아래 링크에서 받을 수 있다.)
https://kingy.ai/blog/astra-field-guide-prompts/
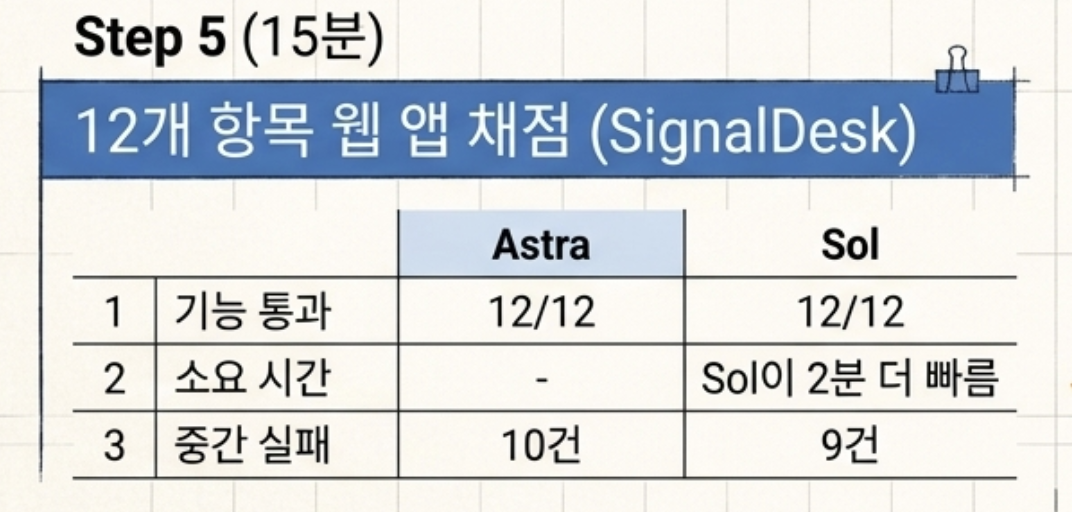
| 기록 항목 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| 고정 12개 항목 통과 | 12/12 | 12/12 |
| 완료까지 걸린 시간 | 16분 35초 | 14분 41초 |
| 별도 리뷰어 평가 점수 | 24/25 | 22/25 |
| 콘솔 오류 | 0건 | 0건 |
| 사람이 손댄 코드 수정 | 0건 | 0건 |
| 중간에 실패한 명령 | 10건 | 9건 + MCP 호출 실패 1건 |
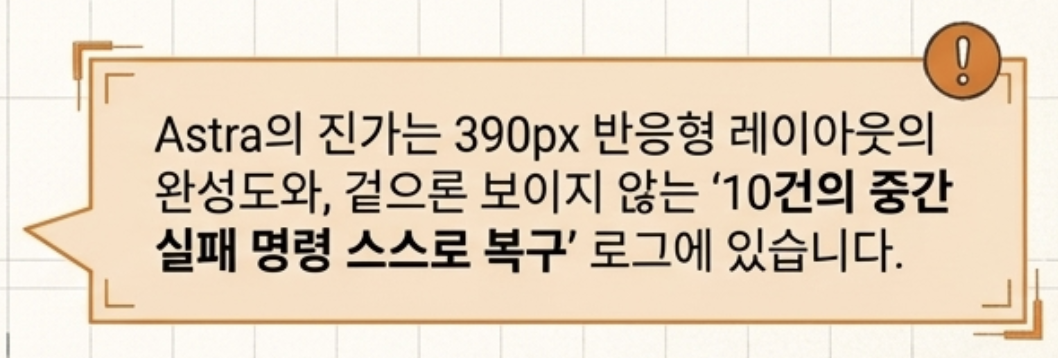
기능만 놓고 보면 동점이고, 오히려 이전 모델인 Sol이 2분 가까이 빨랐다. 차이는 결과물의 완성도에서 났다. 별도 리뷰어가 두 앱을 390px 화면에서 비교했더니, Astra는 선택한 두 제품과 요구된 6개 필드가 한 화면에 다 보인 반면 Sol은 660px짜리 표를 362px 영역 안에 넣어서 가로로 밀어야 했다.
개인적으로 이 테스트에서 제일 흥미로웠던 건 실패한 명령이 양쪽 다 열 건 안팎이었다는 기록이다. 결과물만 보면 매끄럽게 한 번에 나온 것 같지만, 실제로는 중간에 계속 넘어지면서 스스로 복구했다는 뜻이다. Astra는 대화상자 포커스 처리를, Sol은 favicon 요청과 비교 체크박스를 각각 스스로 고쳤다고 기록돼 있다.
그대로 따라 하려면
제품 브리프와 12개 레코드 JSON을 새 폴더에 넣고 위 프롬프트를 그대로 넣으면 된다. 파일 편집·로컬 서버·브라우저 확인이 가능한 환경이 필요하다. 완성된 두 모델의 결과물도 같이 공개돼 있어서 내 결과와 비교해볼 수 있다.
→ 프롬프트 원문과 입력 파일 받기
같은 곳에서 진행한 두 번째 테스트인데, 개인적으로는 이쪽이 더 실무적이라고 느꼈다.
조사를 시켜서 엑셀 파일을 만들되 모든 수치에 출처를 붙이고, 근거가 부족하면 계산하지 말고 빈칸으로 두라고 요구한 과제다.
Research the question in research-workbook-brief.md and create a polished local
XLSX workbook. Use current official documentation as the evidence source. Do not
use search-result snippets, social posts, or unsourced model knowledge as
evidence.

Create these sheets:
1. Read me: scope, run date, evidence rules, and material limitations.
2. Model comparison: one clearly labeled column per model.
3. Capability matrix: documented tools and workflow capabilities.
4. Cost calculator: editable workload inputs and formula-driven estimates.
   Calculate only when rate definitions are complete and compatible;
   otherwise leave the result blank and explain why.
5. Sources: source title, publisher, page or section, URL, access date,
   fields supported, and conflict notes.

Before finishing, inspect the key ranges and formulas, scan the workbook for
spreadsheet errors, render every sheet for visual review, and correct any
clipped text, unreadable columns, blank required sections, or formula errors.
Report the path, sources consulted, checks performed, and unresolved conflicts.
여기서 결과가 갈렸다. Astra는 처음부터 12개 항목을 전부 통과했다. Sol은 처음에 10/12였는데, 실패 사유가 출처에 없는 배수를 자기가 만들어 계산에 넣은 것이었다. 수정 프롬프트를 한 번 더 준 뒤에야 12/12가 됐다.
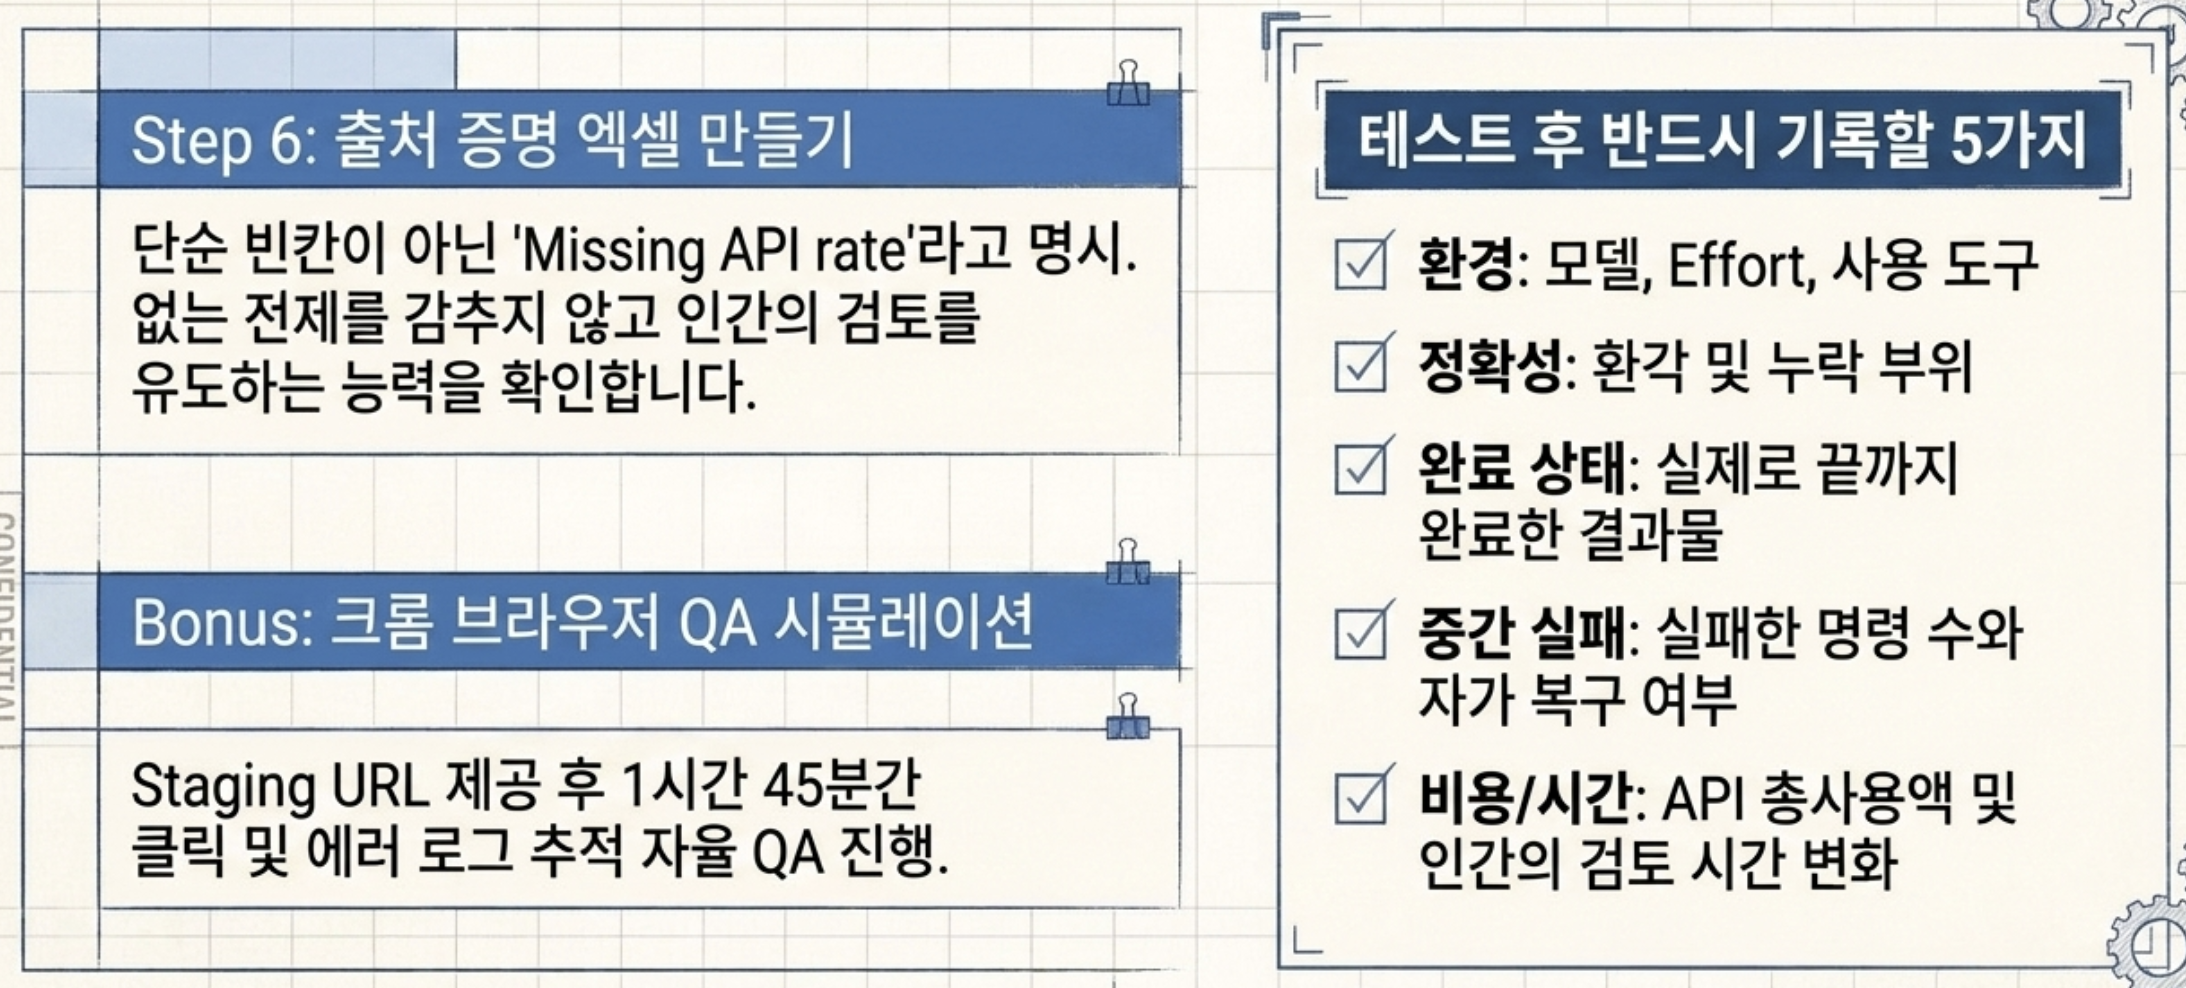
더 결정적인 차이는 나중에 발견됐다. 계산에 필요한 요금 값 하나를 일부러 지워봤더니, Sol이 만든 엑셀은 해당 합계가 그냥 빈칸이 되는 데 그쳤다. Astra가 만든 엑셀은 "Missing API rate"라고 무엇이 빠졌는지 표시했다. 프롬프트가 요구한 "근거가 없으면 왜 계산할 수 없는지 설명하라"를 실제 동작으로 구현한 쪽과 그러지 않은 쪽의 차이다.
실무에서 이런 표를 받아본 적이 있다면 이 차이가 왜 중요한지 바로 감이 올 것 같다. 빈칸은 "아직 안 채웠나 보다"로 넘어가기 쉽지만, "이 값이 없어서 계산 못 했다"는 표시는 확인할 사람을 만든다. 완성돼 보이는 숫자가 오히려 빠진 전제를 감출 수 있다는 게 이 테스트의 교훈이다.
준비물이 거의 없는데 효과는 큰 요청도 있다. ChatPRD를 만드는 개발자가 실제로 한 요청은 이 정도로 캐주얼했다.
Can you just, like, test this in Chrome?
잡기 어려운 경쟁 상태(race condition) 버그를 고쳐 배포한 직후였다. Astra는 프리뷰 브랜치를 열어 1시간 45분 동안 화면을 클릭하고, 채팅을 보내고, 새로고침을 반복하면서 개발자 콘솔의 에러 로그를 확인했고, 사람이 놓쳤던 문제를 여러 개 찾아냈다고 한다.
스테이징 URL 하나와 "이 화면에서 이런 걸 확인해줘" 정도면 시작할 수 있다. 다만 이건 한 사람의 후기이지 독립적으로 검증된 수치는 아니다. QA 파이프라인에 실제로 붙이기 전에는 결과 로그를 사람이 한 번 더 확인하는 단계를 두는 편이 안전하다.
어떤 테스트를 하든 결과를 기억에만 남기면 다음 모델이 나왔을 때 비교할 기준이 없다. 위 사례들이 공통적으로 기록한 항목을 정리하면 이렇다.
| 비교 항목 | 기록할 내용 |
|---|---|
| 환경 | 모델, effort 설정, 사용 도구, 병렬 에이전트 여부 |
| 정확성 | 누락·오류·없는 사실을 만들어낸 부분 |
| 완료 상태 | 답변·파일·테스트·화면 확인 중 실제로 완료한 것 |
| 중간 실패 | 실패한 명령 수와 스스로 복구했는지 여부 |
| 시간 | 기다린 시간과 사람이 검토·수정한 시간 |
| 비용 | API 실제 사용액 또는 구독 사용량의 전후 변화 |
한 번의 결과로 우열을 고정하기보다, 자신의 반복 업무 몇 가지에서 같은 기준으로 기록해두면 다음 모델이 나왔을 때 훨씬 빠르게 판단할 수 있다.
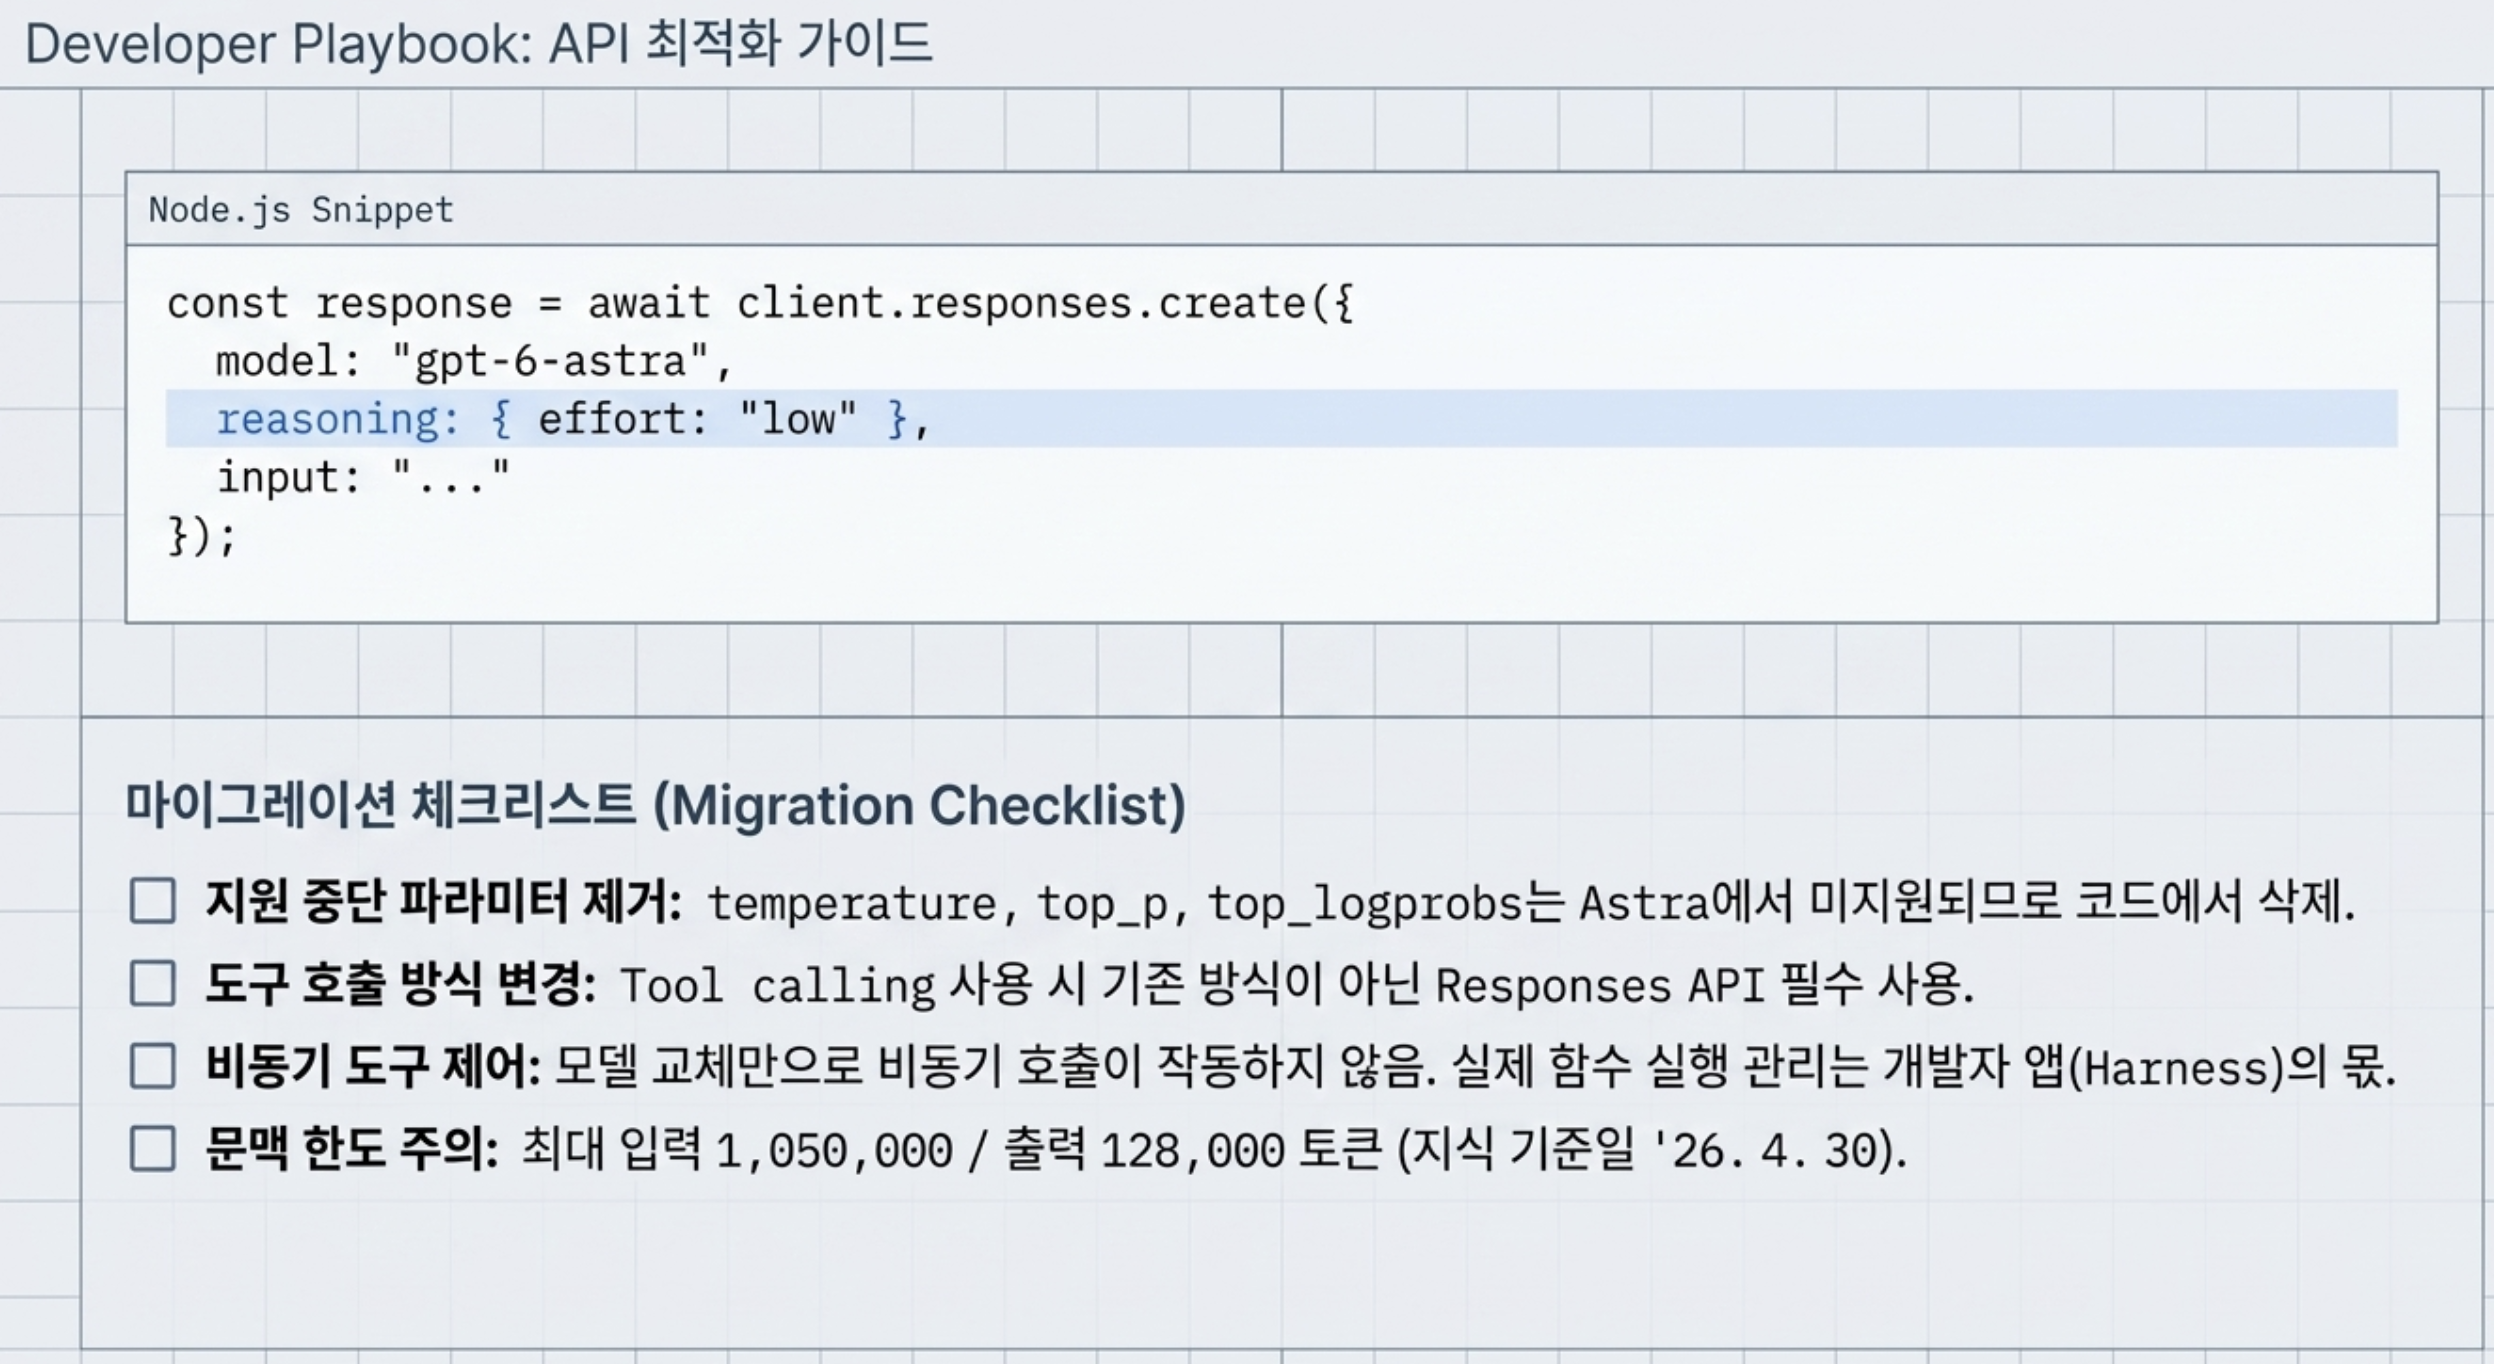
API 모델 ID는 gpt-6-astra이다. 문서상 한 요청에서 모델이 다루는 문맥 창(Context window)은 1,050,000토큰, 최대 출력은 128,000토큰이며 지식 기준일은 2026년 4월 30일이다. 텍스트 입출력과 이미지 입력을 지원한다. 이 API 수치를 ChatGPT의 모든 계정·화면에 그대로 적용하면 안 된다.
공식 가이드는 low, medium, high, xhigh, max 추론 설정을 안내한다.
기존 코드가 추론 설정으로 none·minimal을 썼다면 low부터 비교해보자.
Astra에서 지원하지 않는 temperature, top_p, top_logprobs는 요청에서 제거해야 한다. Tool calling(도구 호출)을 사용할 때는 Responses API가 필요하다.
다음은 Node.js에서 짧은 요청을 보내는 예시이다. 같은 결제 요청이 다시 들어와도 중복 처리되지 않게 하는 멱등성(Idempotency)을 질문한다. 공식 요청 형식과 대조했지만 이 글을 위해 API를 실행해 결과를 측정하지는 않았다.
npm install openai
API 키는 서버 측 OPENAI_API_KEY 환경변수에 준비하고, 아래 코드를 astra-example.mjs로 저장하면 된다. 브라우저 코드나 저장소에 키를 적어 넣지 않도록 하자.
import OpenAI from "openai";

const client = new OpenAI();
const response = await client.responses.create({
  model: "gpt-6-astra",
  reasoning: { effort: "low" },
  input: `쇼핑몰 주문 API의 중복 결제를 예방하려고 한다.
멱등성 키를 어디에서 만들고 저장할지 설명하고,
동시 요청과 재시도에서 확인해야 할 테스트를 제안해줘.
한국어로 답하고, 가정한 환경은 따로 밝혀줘.`,
});

console.log(response.output_text);
node astra-example.mjs
요청·응답 구조는 공식 Quickstart 문서를 참고했다.
실행 후에는 답변 출력과 API 사용 내역을 확인하면 된다. 오류가 나면 오류 메시지에 따라 API 키, 프로젝트의 모델 접근 권한, 결제·사용 한도부터 살펴보자.
이 예제에는 도구를 연결하지 않았다. 따라서 주문 시스템을 수정하거나 테스트를 실행하는 코드가 아니라 설계 설명을 요청하는 호출이다. 실제 동작 검증은 별도로 해야 한다.
개발자 문서에는 비동기 도구 호출과 작업 중 추가 지시를 반영하는 기능도 소개돼 있다. 비동기 도구 호출을 쓰더라도 실제 함수 실행과 작업 관리는 개발자 앱이 맡는다. 모델 이름을 교체하는 것만으로 기존 프로그램에 이 흐름이 자동으로 생기지는 않는다.
또한 가이드는 Astra가 확인 질문에서 멈추거나 작은 수정에도 테스트를 넓히는 경향을 설명한다.
요청할 때 원하는 결과, 수행해도 되는 작업, 완료를 판단할 기준을 구체적으로 적어두면 이런 동작을 평가하고 조정하기가 쉽다.
새 모델이 나왔다고 모든 작업을 한 번에 옮길 필요는 없다. 다음 표는 위 자료를 바탕으로 정리한 선택 기준이며, 직접 성능을 측정한 순위표는 아니다.
| 상황 | 먼저 해볼 선택 |
|---|---|
| 짧은 질문과 단순한 문장 수정이 대부분 | 기존 모델과 수정 시간을 비교해보기 |
| 여러 파일·앱을 오가며 작업해야 함 | 작은 작업 하나를 처음부터 끝까지 맡겨 결과 확인하기 |
| 긴 리팩터링에서 같은 설명을 반복함 | 모델과 함께 작업 기록·문맥 전달 방식을 점검하기 |
| 문서나 화면의 디자인도 중요함 | 실제 양식을 주고 내용·서식·동작을 각각 확인하기 |
| 비용에 민감한 자동화를 운영함 | 단가와 함께 완료까지의 총비용을 측정하기 |
| 운영 데이터와 외부 전송이 포함됨 | 권한과 승인 지점을 정한 테스트 환경부터 시작하기 |
Astra를 평가할 때 내가 먼저 보고 싶은 것은 완료한 일의 품질과, 그 결과를 사람이 확인하는 데 드는 수고이다. 코드를 많이 만들거나 답변을 빨리 내는 것만으로는 업무가 끝났다고 말하기 어렵기 때문이다.
일반 사용자라면 자신이 자주 만드는 문서 하나, 개발자라면 늘 손이 가는 작은 수정 작업 하나를 골라보자. 같은 자료와 조건으로 기존 모델과 비교해보면, 이번 변화가 자신의 일에 얼마나 도움이 되는지 판단할 수 있을 것이다.
감사합니다. : )
소중한 공감 감사합니다