새소식
300x250
안녕하세요! 갓대희 입니다.
이번 포스팅은 [ Claude Fable 5.1 출시 분석 ] 입니다. : )
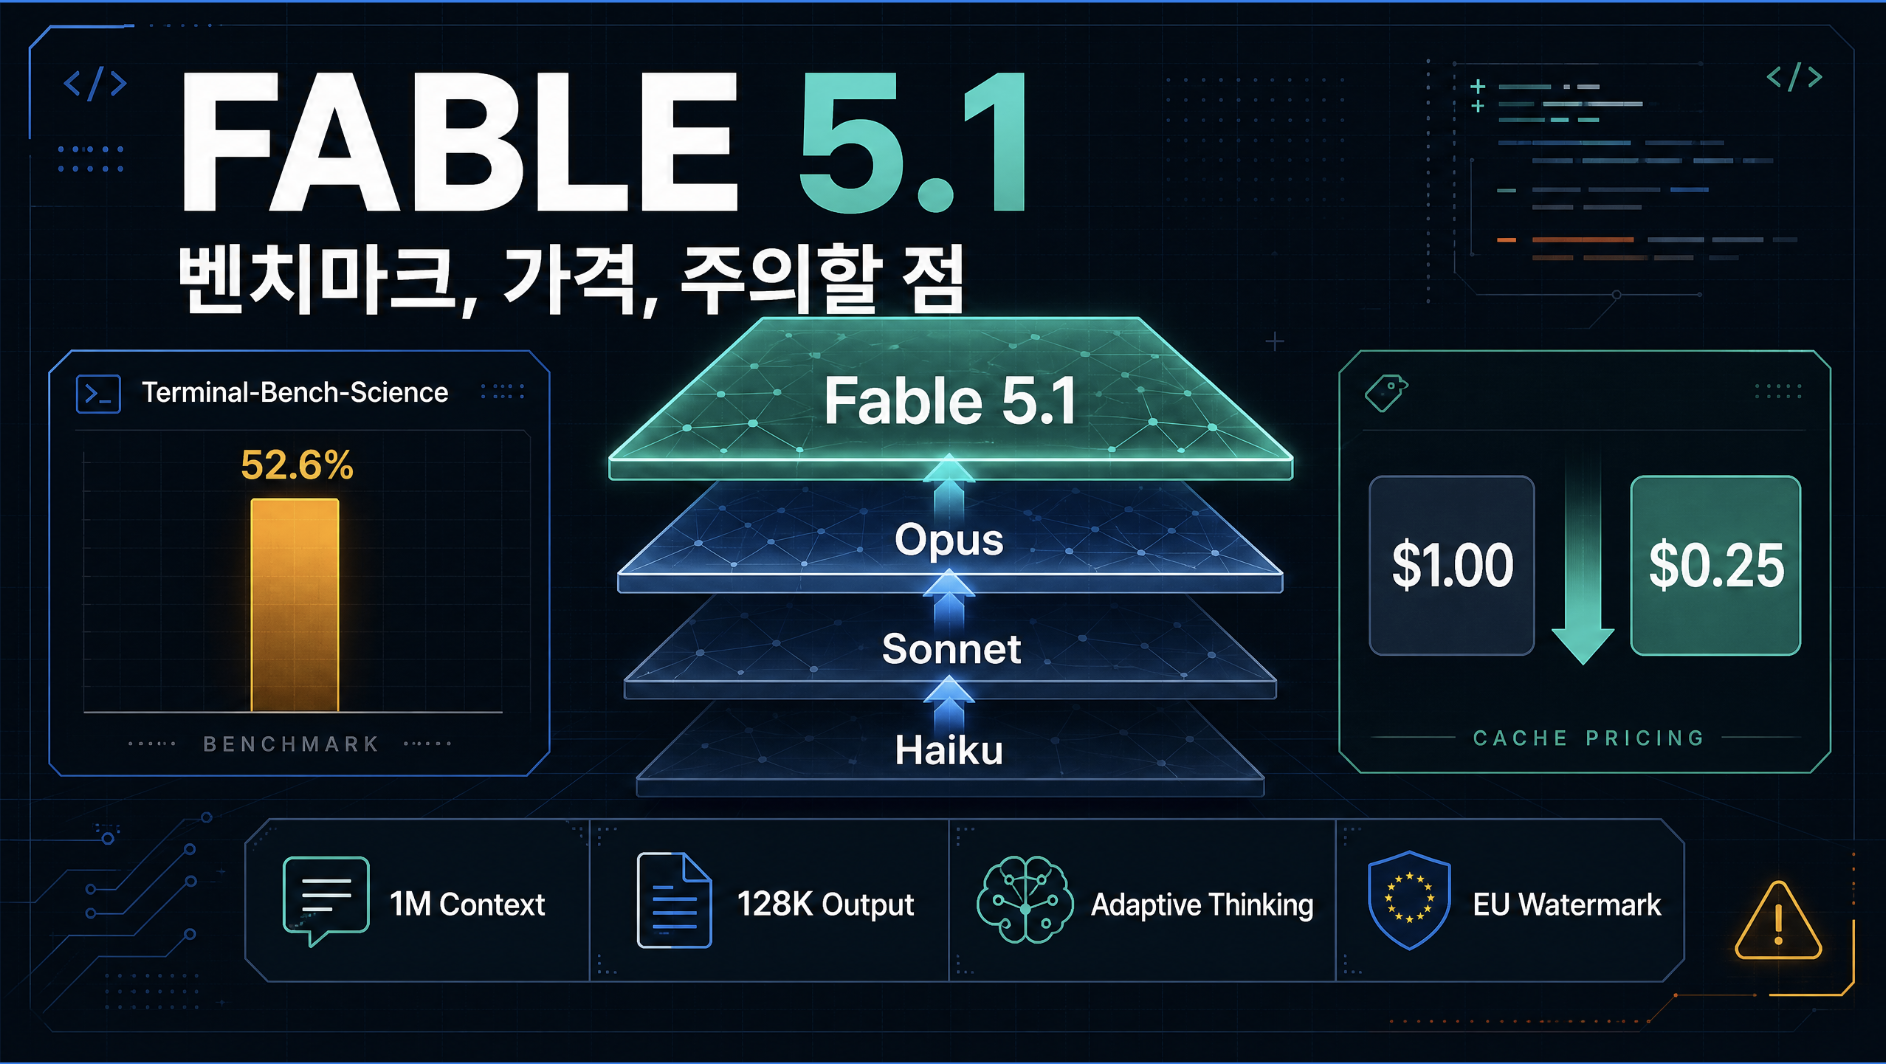
앤스로픽(Anthropic)이 2026년 9월 1일 클로드 페이블 5.1(Claude Fable 5.1)과 클로드 미토스 5.1(Claude Mythos 5.1)을 공개했다. 공식 발표만 보면 높은 벤치마크 점수와 최대 약 45%라는 비용 절감 숫자가 먼저 눈에 들어온다. 그런데 실무에 바로 붙여 쓰려고 하면 따져봐야 할 디테일이 생각보다 많다.
프롬프트 캐시(Prompt Cache) 읽기 단가는 크게 내려갔지만, 출력 토큰이 늘어나면 과제당 총비용은 오히려 커질 수 있다. 기존 Fable 5 코드에서 모델 ID만 바꿨다가 실패하는 API 요청도 있고, API에서 연산 강도(Effort)를 바꾸는 방식과 클로드 코드(Claude Code)의 /effort 명령이 캐시에 미치는 영향도 완전히 다르다.
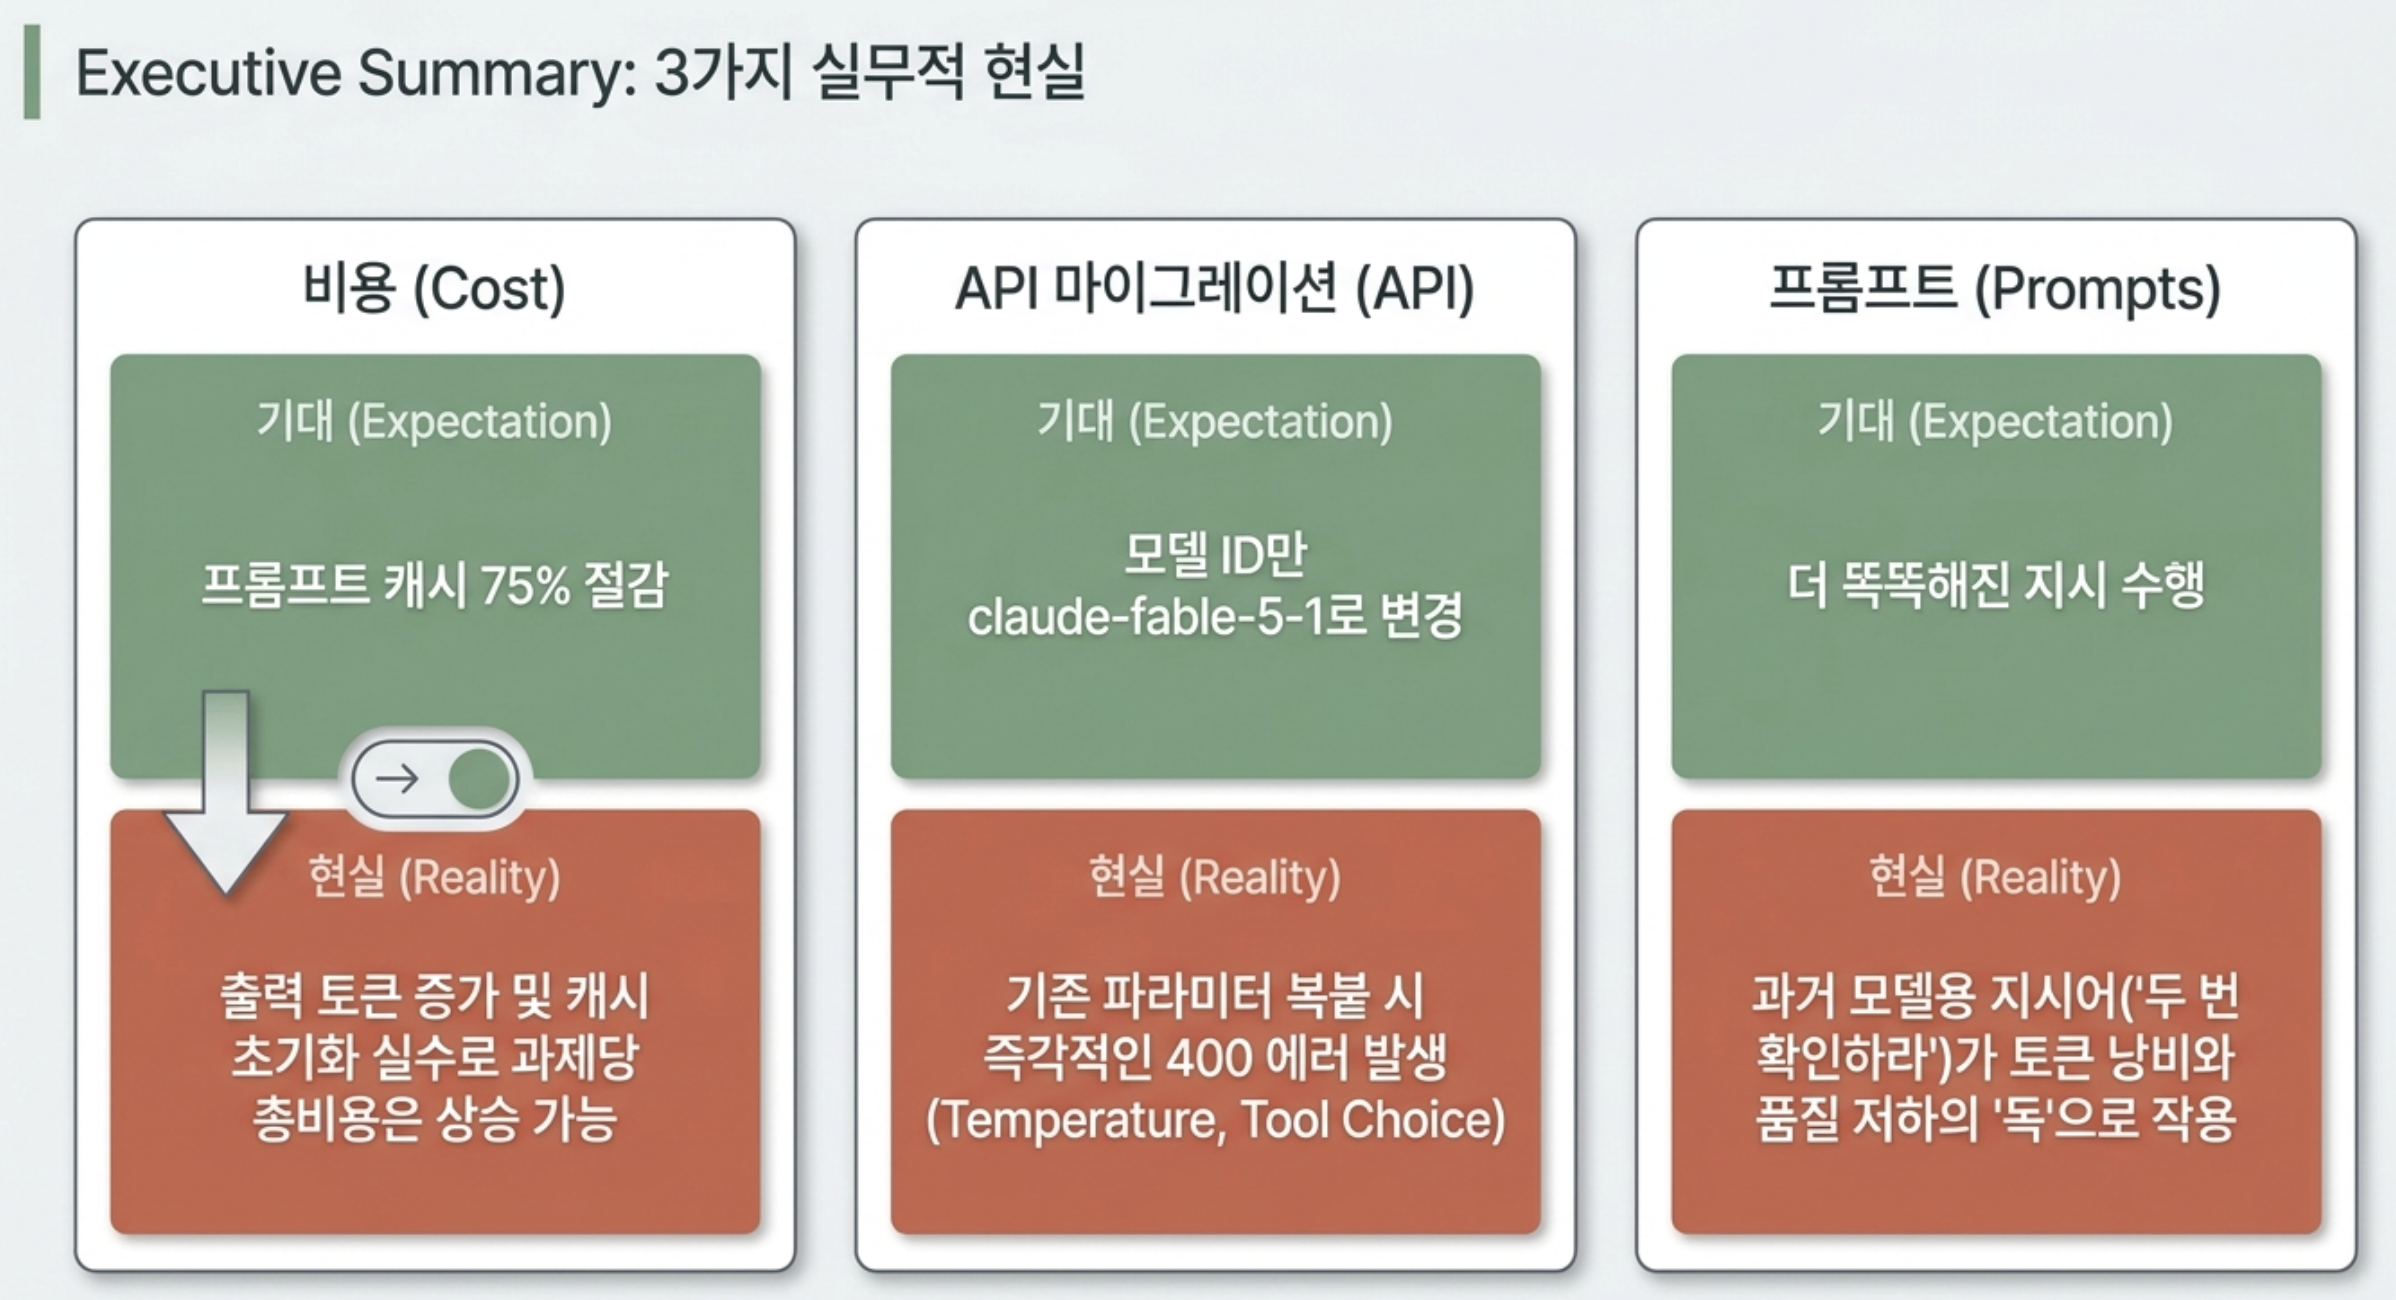
이번 글에서는 앤스로픽 공식 발표와 개발자 문서를 기준으로 제품 사양과 마이그레이션(이전) 조건을 먼저 짚어본다. 여기에 독립 평가 기관의 지표와 출시 직후 커뮤니티 반응을 더해서, 공식 스펙과 실제 사용자 경험이 어디서 갈리는지 나눠서 정리해봤다.
temperature, top_p 파라미터를 건드리면 400 에러가 난다(Fable 5부터 동일). 강제 도구 선택(Forced Tool Choice)과 추론 블록 호환성도 먼저 점검해야 한다.• 토큰(Token): AI가 글을 읽고 쓰는 단위. 요금은 대부분 “토큰 몇 개에 얼마”로 매긴다. 보낸 글은 입력 토큰, 받은 답은 출력 토큰이고 단가가 서로 다르다.
• 컨텍스트 창(Context Window): AI가 한 번에 기억할 수 있는 분량. Fable 5.1은 100만 토큰이라 책 여러 권 분량이 들어간다. 이걸 넘기면 앞부분을 잊는다.
• 프롬프트 캐시(Prompt Cache): AI에게 넘긴 긴 문서나 이전 대화 내용을 잠시 ‘기억’해 두는 기능. 다시 질문할 때 이 기억을 꺼내 쓰면 비용과 시간이 크게 줄어든다.
• 캐시 읽기 / 캐시 쓰기: 이 글에서 가장 자주 나오는 구분이다. 읽기는 이미 저장된 걸 꺼내 쓰는 것(싸다), 쓰기는 새로 저장하는 것(비싸다). 이번에 값이 내려간 건 읽기 쪽만이다.
• 연산 강도(Effort): AI가 답을 찾는 데 시간과 자원을 얼마나 쓸지 정하는 옵션. 높다고 좋기만 한 게 아니라, 간단한 작업에 강도를 높이면 비용만 늘고 답변이 장황해질 수 있다.
• 에이전트 작업: 한 번 시키면 AI가 스스로 여러 단계를 밟아 끝까지 가는 방식. 코드를 쓰고, 돌려보고, 깨지면 고치고, 다시 돌리는 식이다. 이 글에서 “오래 맡겨두는 작업”이라 하면 대개 이쪽이다.
• 추론 블록(Thinking Block): AI가 답하기 전에 속으로 생각한 내용이 담기는 자리. 이전 대화에 붙어 다니는데, 모델을 바꾸면 못 읽는 경우가 있어서 5장에서 따로 다룬다.
• 대체 모델 전환(Fallback): 요청한 모델이 에러를 내거나 안전상 이유로 거부했을 때, 미리 정해둔 다른 모델로 자동으로 다시 보내는 안전망.
공식 문서가 정리한 순서는 Haiku 4.5 → Sonnet 5 → Opus 5 → Fable 5.1이다. 오른쪽으로 갈수록 비싸고 강하다.
• Claude Fable 5.1 — 이번 글의 주인공. 라인업 최상위(프론티어)이고 100만 토큰당 입력 10달러, 출력 50달러다.
• Claude Mythos 5.1 — Fable 5.1과 같은 모델인데 안전장치를 덜 씌운 버전. 승인받은 조직만 쓴다. 상위 요금제가 아니다.
• Claude Opus 5 — 한 단계 아래. 입력 5달러, 출력 25달러다. 공식 문서는 대부분의 작업을 여기서 시작하라고 권한다.
• Claude Sonnet 5 / Haiku 4.5 — 중간 티어와 가장 저렴한 티어. 짧은 요청을 많이 던질 때 쓴다.
• Claude Fable 5 — 직전 세대. 이 글의 비교 기준이 대부분 이 모델이다.
• GPT-6 Astra — 이틀 뒤 나온 오픈AI 쪽 모델. 9장에서 따로 비교한다.
Fable 5.1은 몇 시간씩 이어지는 코딩, 다단계 리서치, 문서와 스프레드시트를 오가는 장기 에이전트(Agentic) 작업을 겨냥한 모델이다.
| 항목 | 공식 확인값 | 개발자가 알아둘 점 |
|---|---|---|
| Claude API 모델 ID | claude-fable-5-1 |
Amazon Bedrock에서는 anthropic.claude-fable-5-1, Google Cloud와 Microsoft Foundry에서는 같은 ID를 쓴다. |
| 컨텍스트 창(Context Window) | 100만 토큰(1M tokens) | 전 구간이 같은 토큰 단가다. 긴 코드베이스를 넣어도 추가 요금은 없다. |
| 최대 출력 | 128K tokens | 출력이 길어질수록 effort와 함께 시간과 비용이 빠르게 늘어난다. |
| 추론 방식 | 적응형 추론(Adaptive Thinking) 항상 켜짐 | 수동으로 끄거나 켤 수 없다. effort 파라미터로 깊이만 조절한다. |
| 지식 기준일(Knowledge Cutoff) | 2026년 6월 | 그 이후 정보는 검색 도구(Retrieval)를 붙여서 확인해야 한다. |
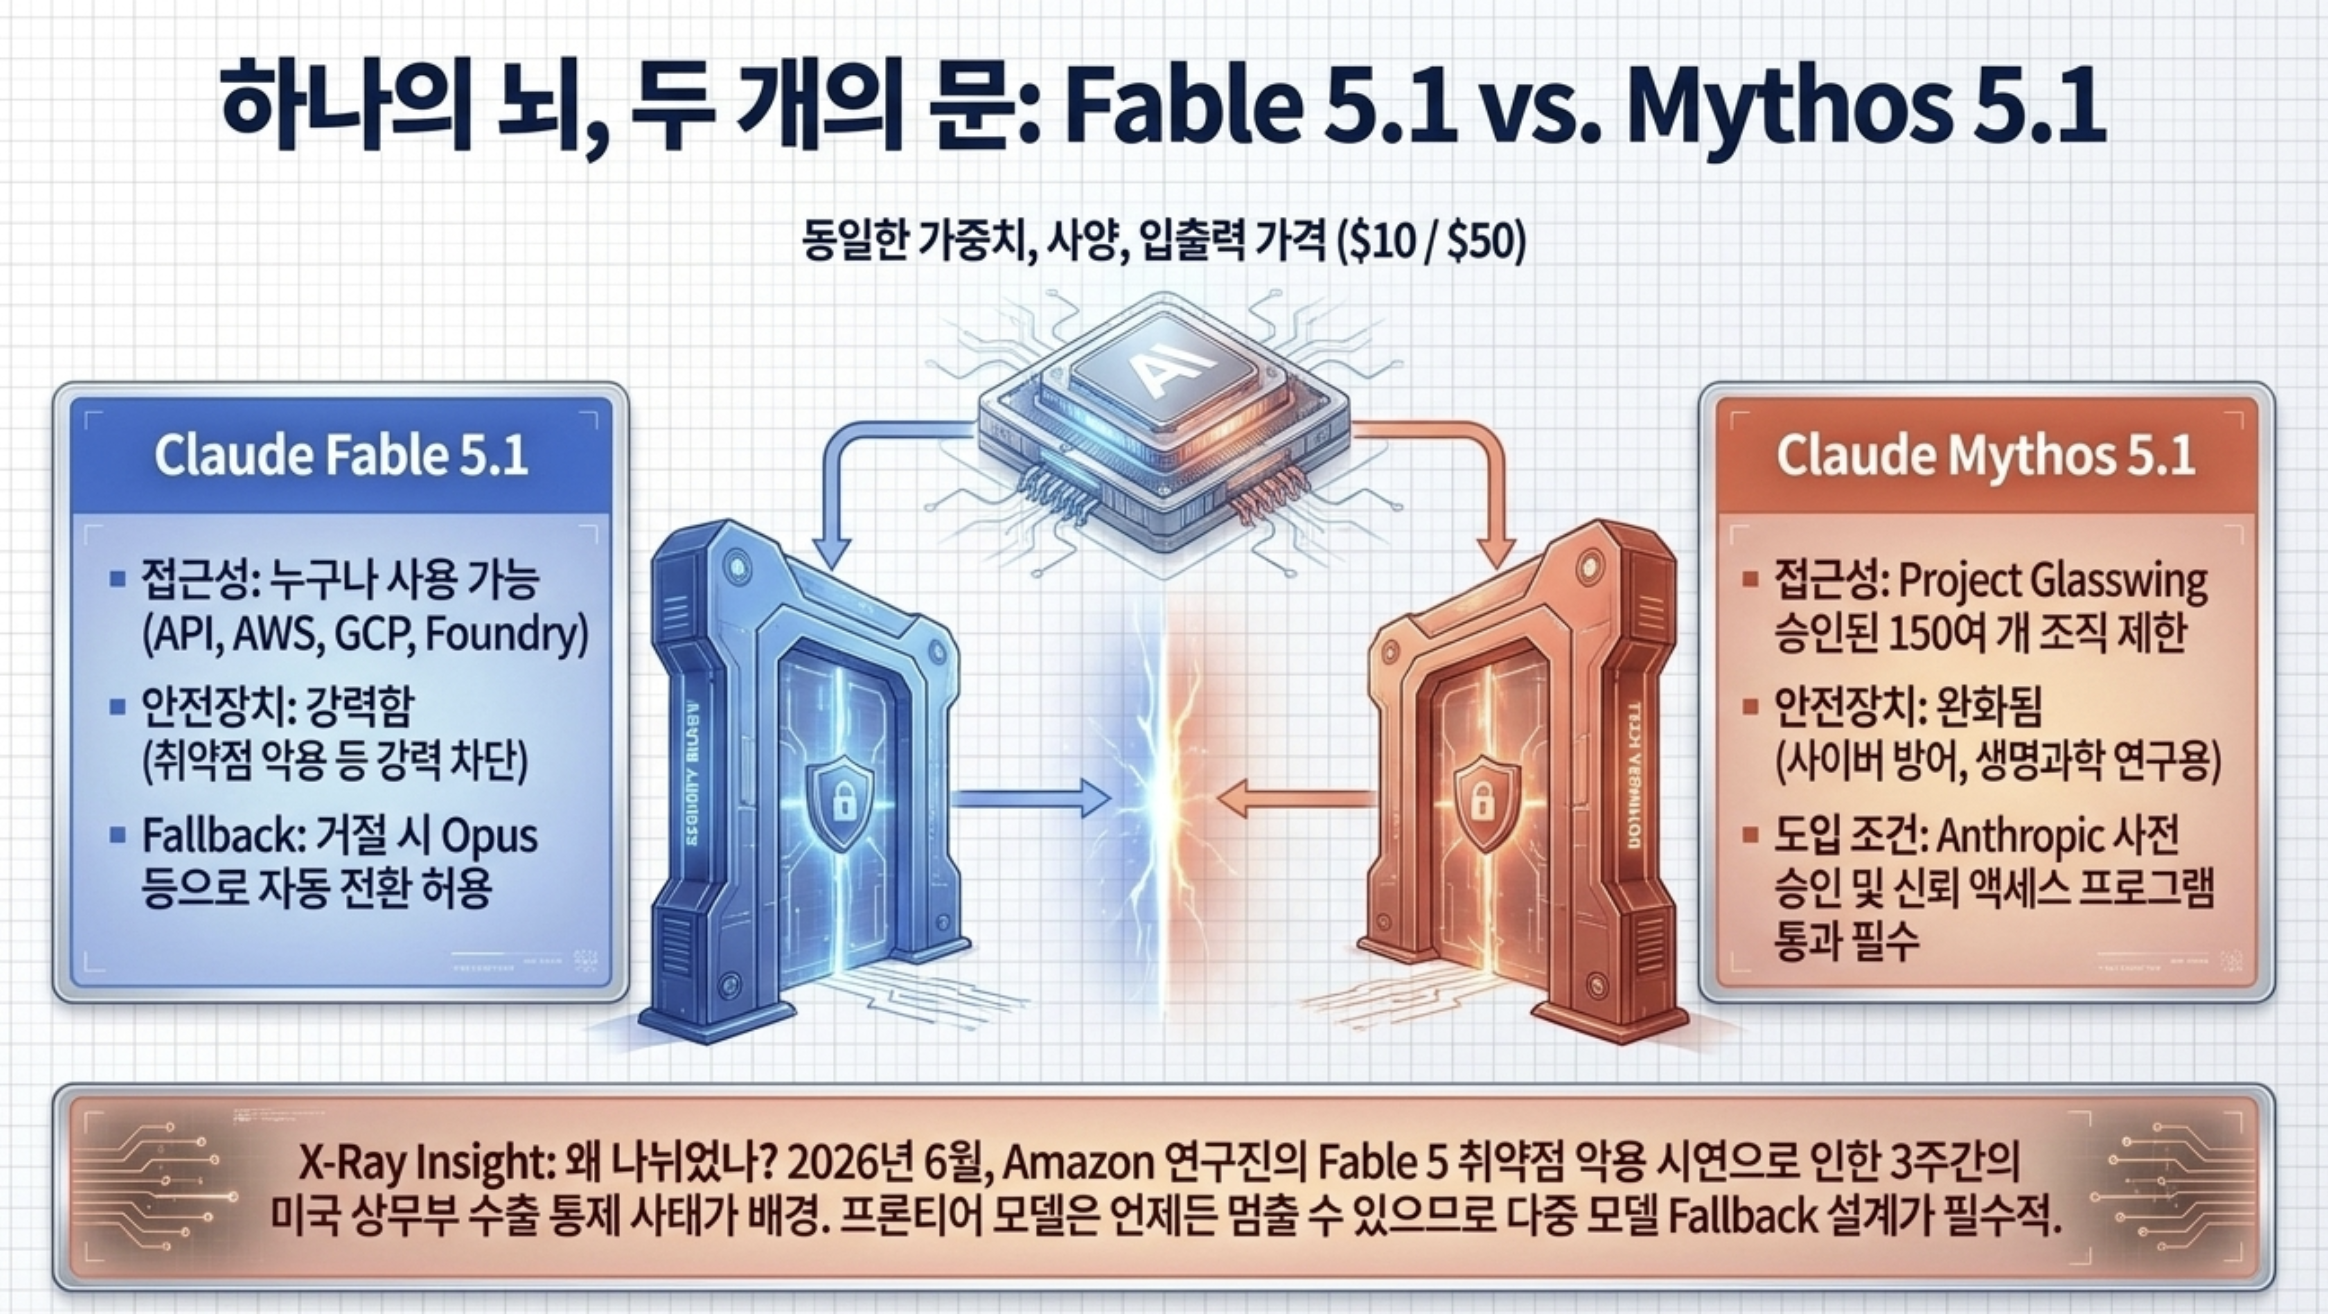
아니다. 두 모델은 기능과 사양이 완전히 같은, 뿌리가 하나인 모델이다. 차이는 사이버 보안과 생명과학 영역에 적용되는 '안전장치'와 '접근 권한'뿐이다.
Fable 5.1은 누구나 쓸 수 있지만, Mythos 5.1은 '프로젝트 글래스윙(Project Glasswing)' 승인 고객과 사이버 검증 프로그램(CVP)·생명과학 검증 프로그램(LSVP) 같은 신뢰 액세스 프로그램을 통과한 전문가만 제한적으로 쓸 수 있다.
그러니 Mythos를 Fable의 상위 요금제쯤으로 이해하면 안 된다.
글래스윙은 처음에 마이크로소프트, 애플, 구글, AWS, 시스코, 엔비디아, 크라우드스트라이크, JP모건체이스, 리눅스 재단 같은 40여 개 조직으로 시작해서 지금은 15개국 150개 안팎까지 늘었다고 알려져 있다. 방어 목적의 보안 연구에 쓰라고 열어준 통로라, 돈을 낸다고 들어갈 수 있는 구조가 아니다.
이 구조를 이해하려면 석 달 전 일을 알아야 한다. 이전 세대인 Fable 5와 Mythos 5는 2026년 6월 9일에 나왔는데, 사흘 만인 6월 12일 미국 상무부의 수출통제 지시로 두 모델 모두 서비스가 중단됐다.
계기는 아마존 연구진이 찾아낸 우회 방법이었다. 특정한 방식으로 프롬프트를 넣으면 Fable 5가 소프트웨어 취약점을 여러 개 찾아냈고, 한 사례에서는 그 취약점을 실제로 악용하는 코드까지 만들어냈다. 이 보고가 정부에 알려지면서 통제 조치로 이어졌다.
약 3주 뒤인 6월 30일에 통제가 풀렸고 7월 1일부터 다시 쓸 수 있게 됐다. Mythos 5도 6월 26일 정부 승인을 받아 미국 내 일부 조직부터 순차적으로 복구됐다.
이 사건에서 개발자가 챙길 교훈은 벤치마크와 무관하다. 프론티어 모델은 회사 사정이 아니라 규제 판단으로도 하루아침에 내려갈 수 있다는 점이다. 당시 한 리서치 기관은 "모델은 언제든 출시될 수도, 예고 없이 내려갈 수도 있다"며 기업이 이를 감안해 계획을 세워야 한다고 지적하기도 했다. 서비스 핵심 경로를 특정 모델 하나에만 묶어두지 말고, 대체 모델 전환 경로를 미리 만들어두는 편이 낫다는 이야기다. 7장의 fallback 설정이 단순한 편의 기능이 아닌 이유이기도 하다.
하나의 모델, 두 개의 문
▼
Claude Fable 5.1
안전장치 강함
누구나 사용 가능
API·AWS·Google Cloud·Foundry
거절 시 Opus로 대체 전환
Claude Mythos 5.1
안전장치 완화
초대받은 조직만
Project Glasswing 승인 필요
사이버 방어·생명과학 용도
Mythos는 Fable의 상위 요금제가 아니다. 성능이 아니라 접근 권한과 안전장치가 다를 뿐이다.
Fable 5.1의 공식 벤치마크(성능 평가) 점수는 전반적으로 Fable 5보다 높다. 다만 표에 적힌 점수를 우리 프로젝트의 속도나 성공률로 바로 바꿔 읽으면 안 된다. 평가에 쓴 연산 강도, 도구, 안전장치가 전부 다르기 때문이다. 표를 보기 전에 오른쪽 열의 조건부터 같이 보자.
| 평가 기준 | Fable 5.1 | Fable 5 | Opus 5 | 읽을 때 주의할 점 |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 최대 연산 강도(max effort) 기준 값이다. |
| Terminal-Bench 4.0 | 55.8% (Mythos 5.1은 60.9%) |
42.0% | 52.3% | 60.9%는 같은 모델에 다른 안전장치를 적용한 Mythos 5.1의 값이다. |
| AutomationBench | 31.4% | 17.1% | 26.9% | 안전장치가 개입한 과제는 0점 처리돼 점수에 일부 영향을 줬다. |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | Anthropic이 아니라 Cursor가 만든 평가이고, 역시 max effort 기준이다. |
공식 원문
위 표는 앤스로픽 공식 발표의 벤치마크 표에서 핵심 네 줄만 옮긴 것이다. OSWorld, Humanity’s Last Exam, GDPval처럼 여기 넣지 않은 항목과 각 수치의 표준오차(모델당 ±3.5~4.5포인트)는 원문에서 확인할 수 있다.
→ 공식 벤치마크 표 원문 보기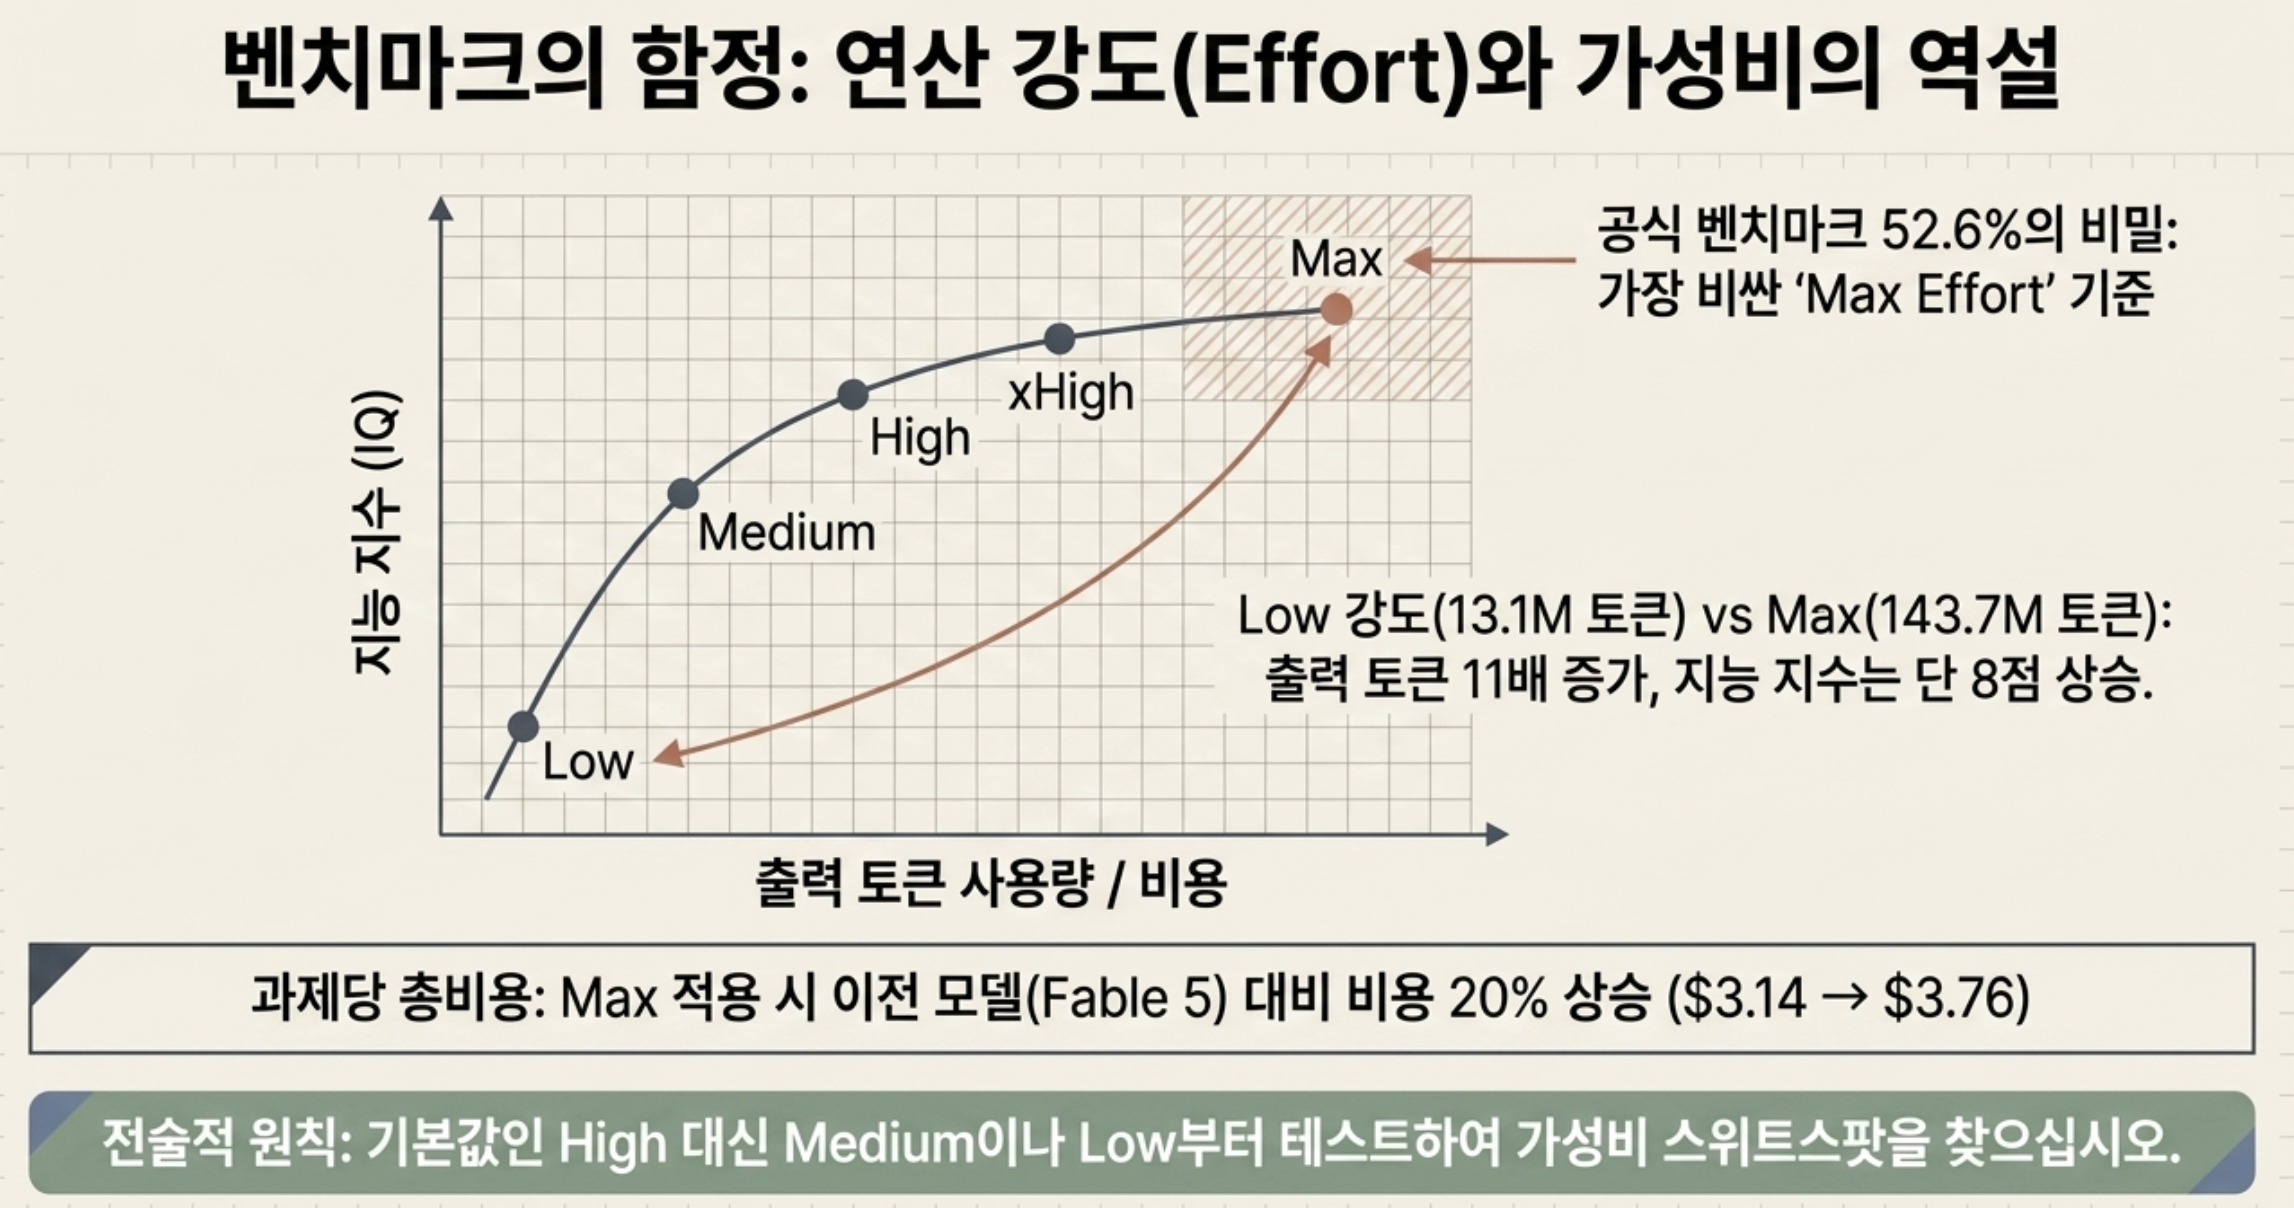
앤스로픽이 같이 공개한 effort별 차트를 보면, 위 표의 52.6%는 최대 연산 강도(max)에서 나온 값이다.
기본값인 high에서는 40% 근처다.
같은 차트에서 더 눈여겨볼 것은 Fable 5.1의 low가 Fable 5의 max와 비슷한 점수를 훨씬 싼 비용으로 낸다는 부분이다. 표의 숫자를 자기 설정에 그대로 대입하기 전에 어떤 effort에서 잰 값인지부터 확인하는 편이 좋다.
앤스로픽은 위 차트처럼 '낮은 연산 강도(Effort)'에서도 Fable 5와 비슷하거나 더 나은 결과를 싸게 낼 수 있다고 설명한다. 반면 독립 평가 기관인 'Artificial Analysis'의 결과는 조금 다르게 읽힌다.
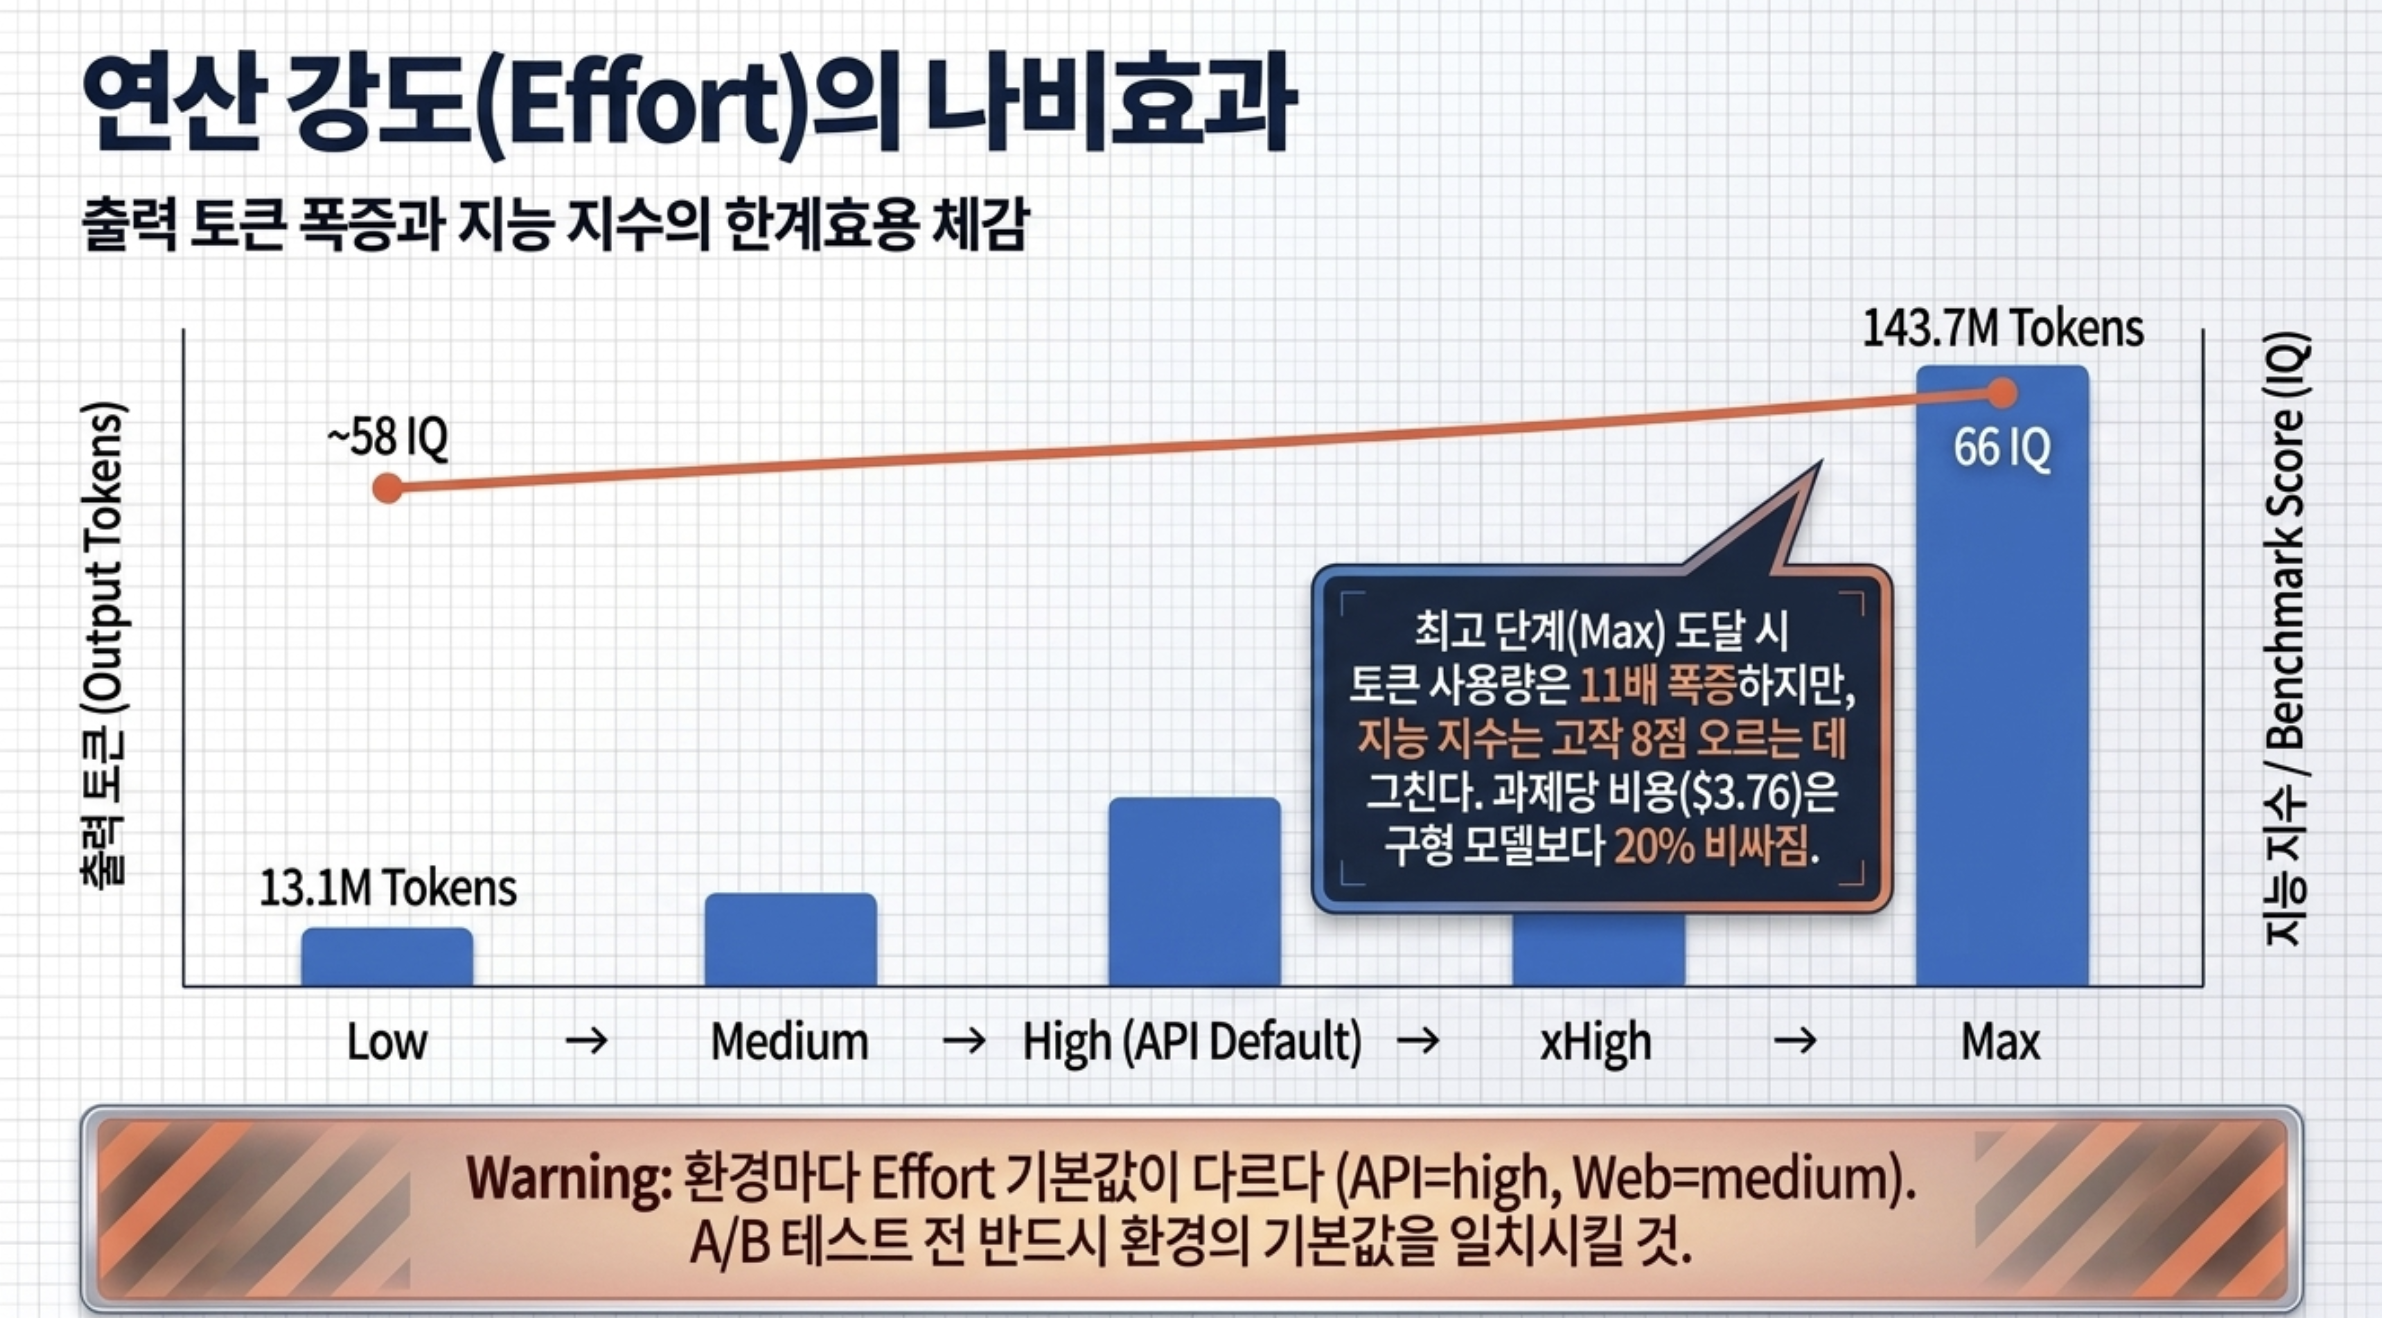
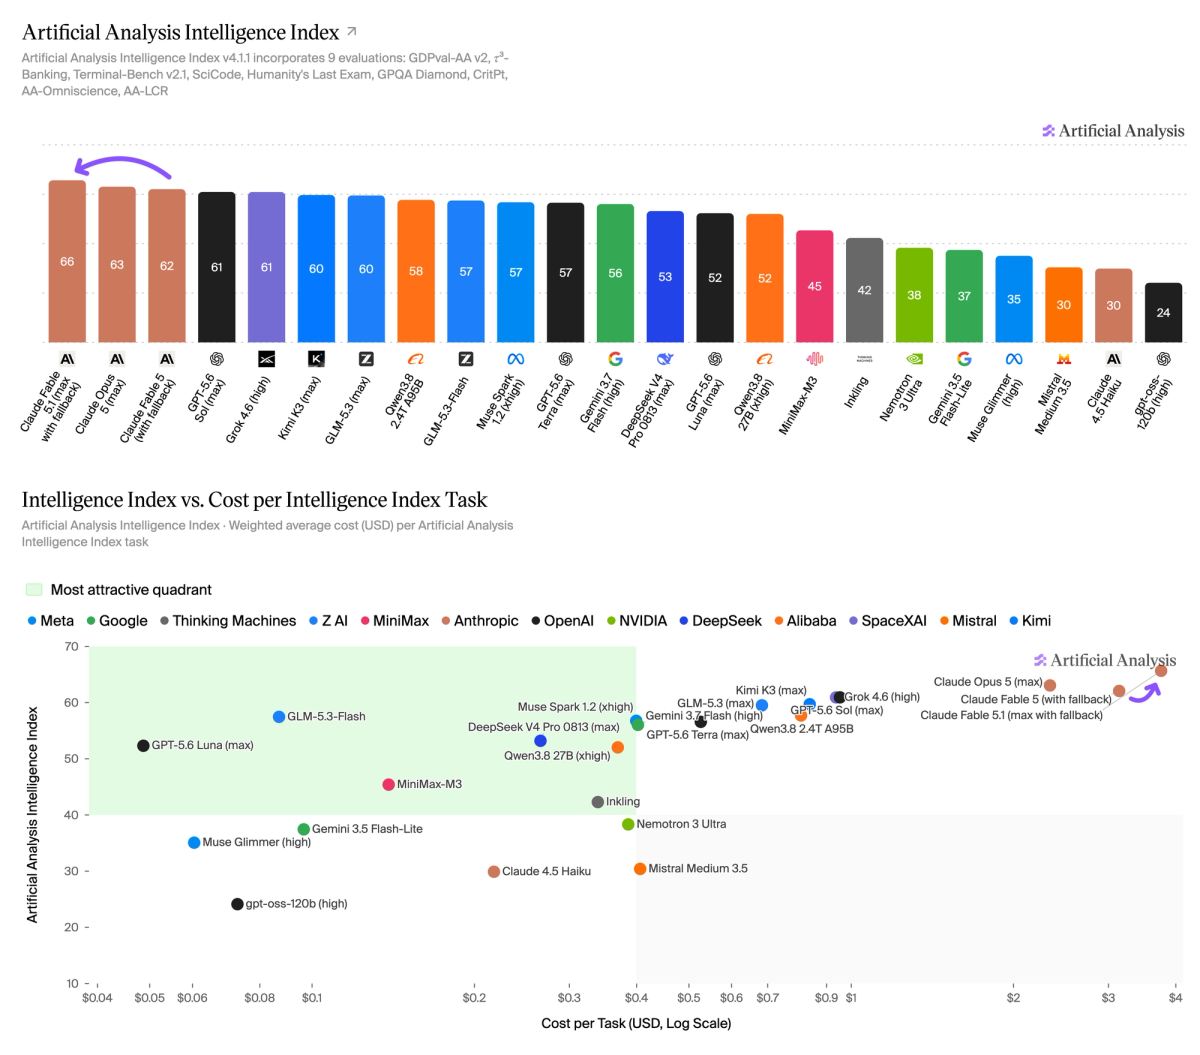
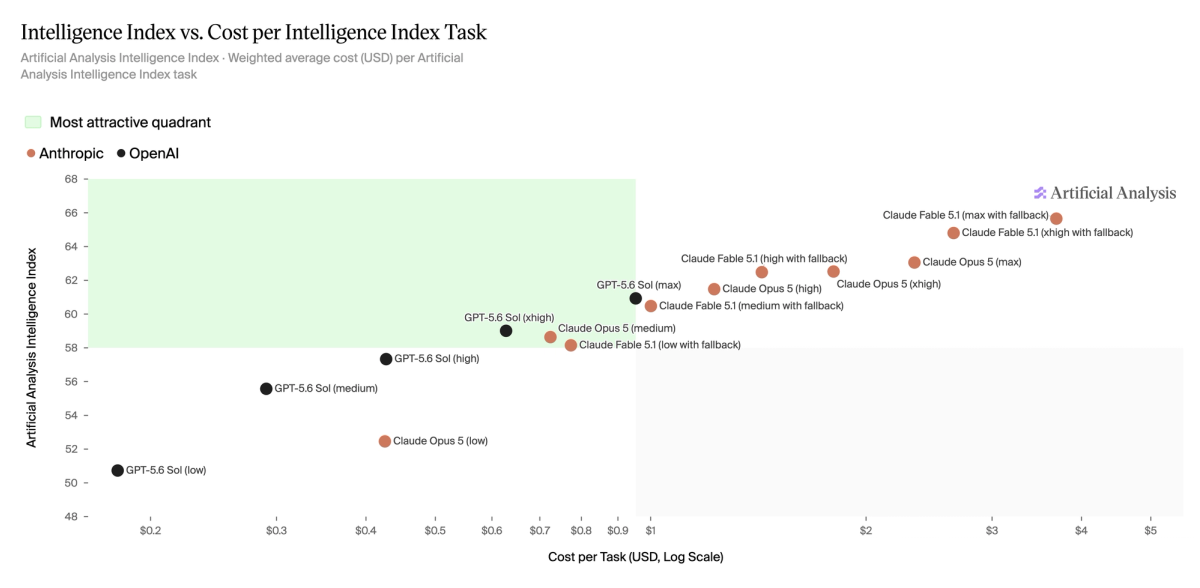
독립 기관 분석에 따르면, 둘 다 최대 연산 강도(max)로 돌렸을 때 Fable 5.1이 Fable 5보다 약 1.7배 많은 출력 토큰을 썼고, 캐시 할인을 감안해도 과제당 비용이 3.14달러에서 3.76달러로 20% 더 높게 나왔다. 재미있는 건 강도를 끝까지 올렸을 때의 가성비다. xhigh에서 65점(2.72달러)이던 점수가 최고 단계인 max에서는 66점(3.76달러)에 그쳤다. 마지막 1점을 올리려고 1달러 넘게 더 태운 셈이다. 다만 같은 차트에서 Fable 5.1을 high로 낮추면 Fable 5의 max와 비슷한 점수를 절반 이하 비용으로 내고 있어서, "effort를 낮출수록 가성비가 좋다"는 결론만큼은 공식 자료와 독립 평가가 같은 방향이다.
이번 가격표에서 실제로 바뀐 항목은 '캐시 읽기(Cache Read)' 하나다. 기본 입력, 출력, 캐시 쓰기(Write), Batch 가격은 Fable 5와 똑같다.
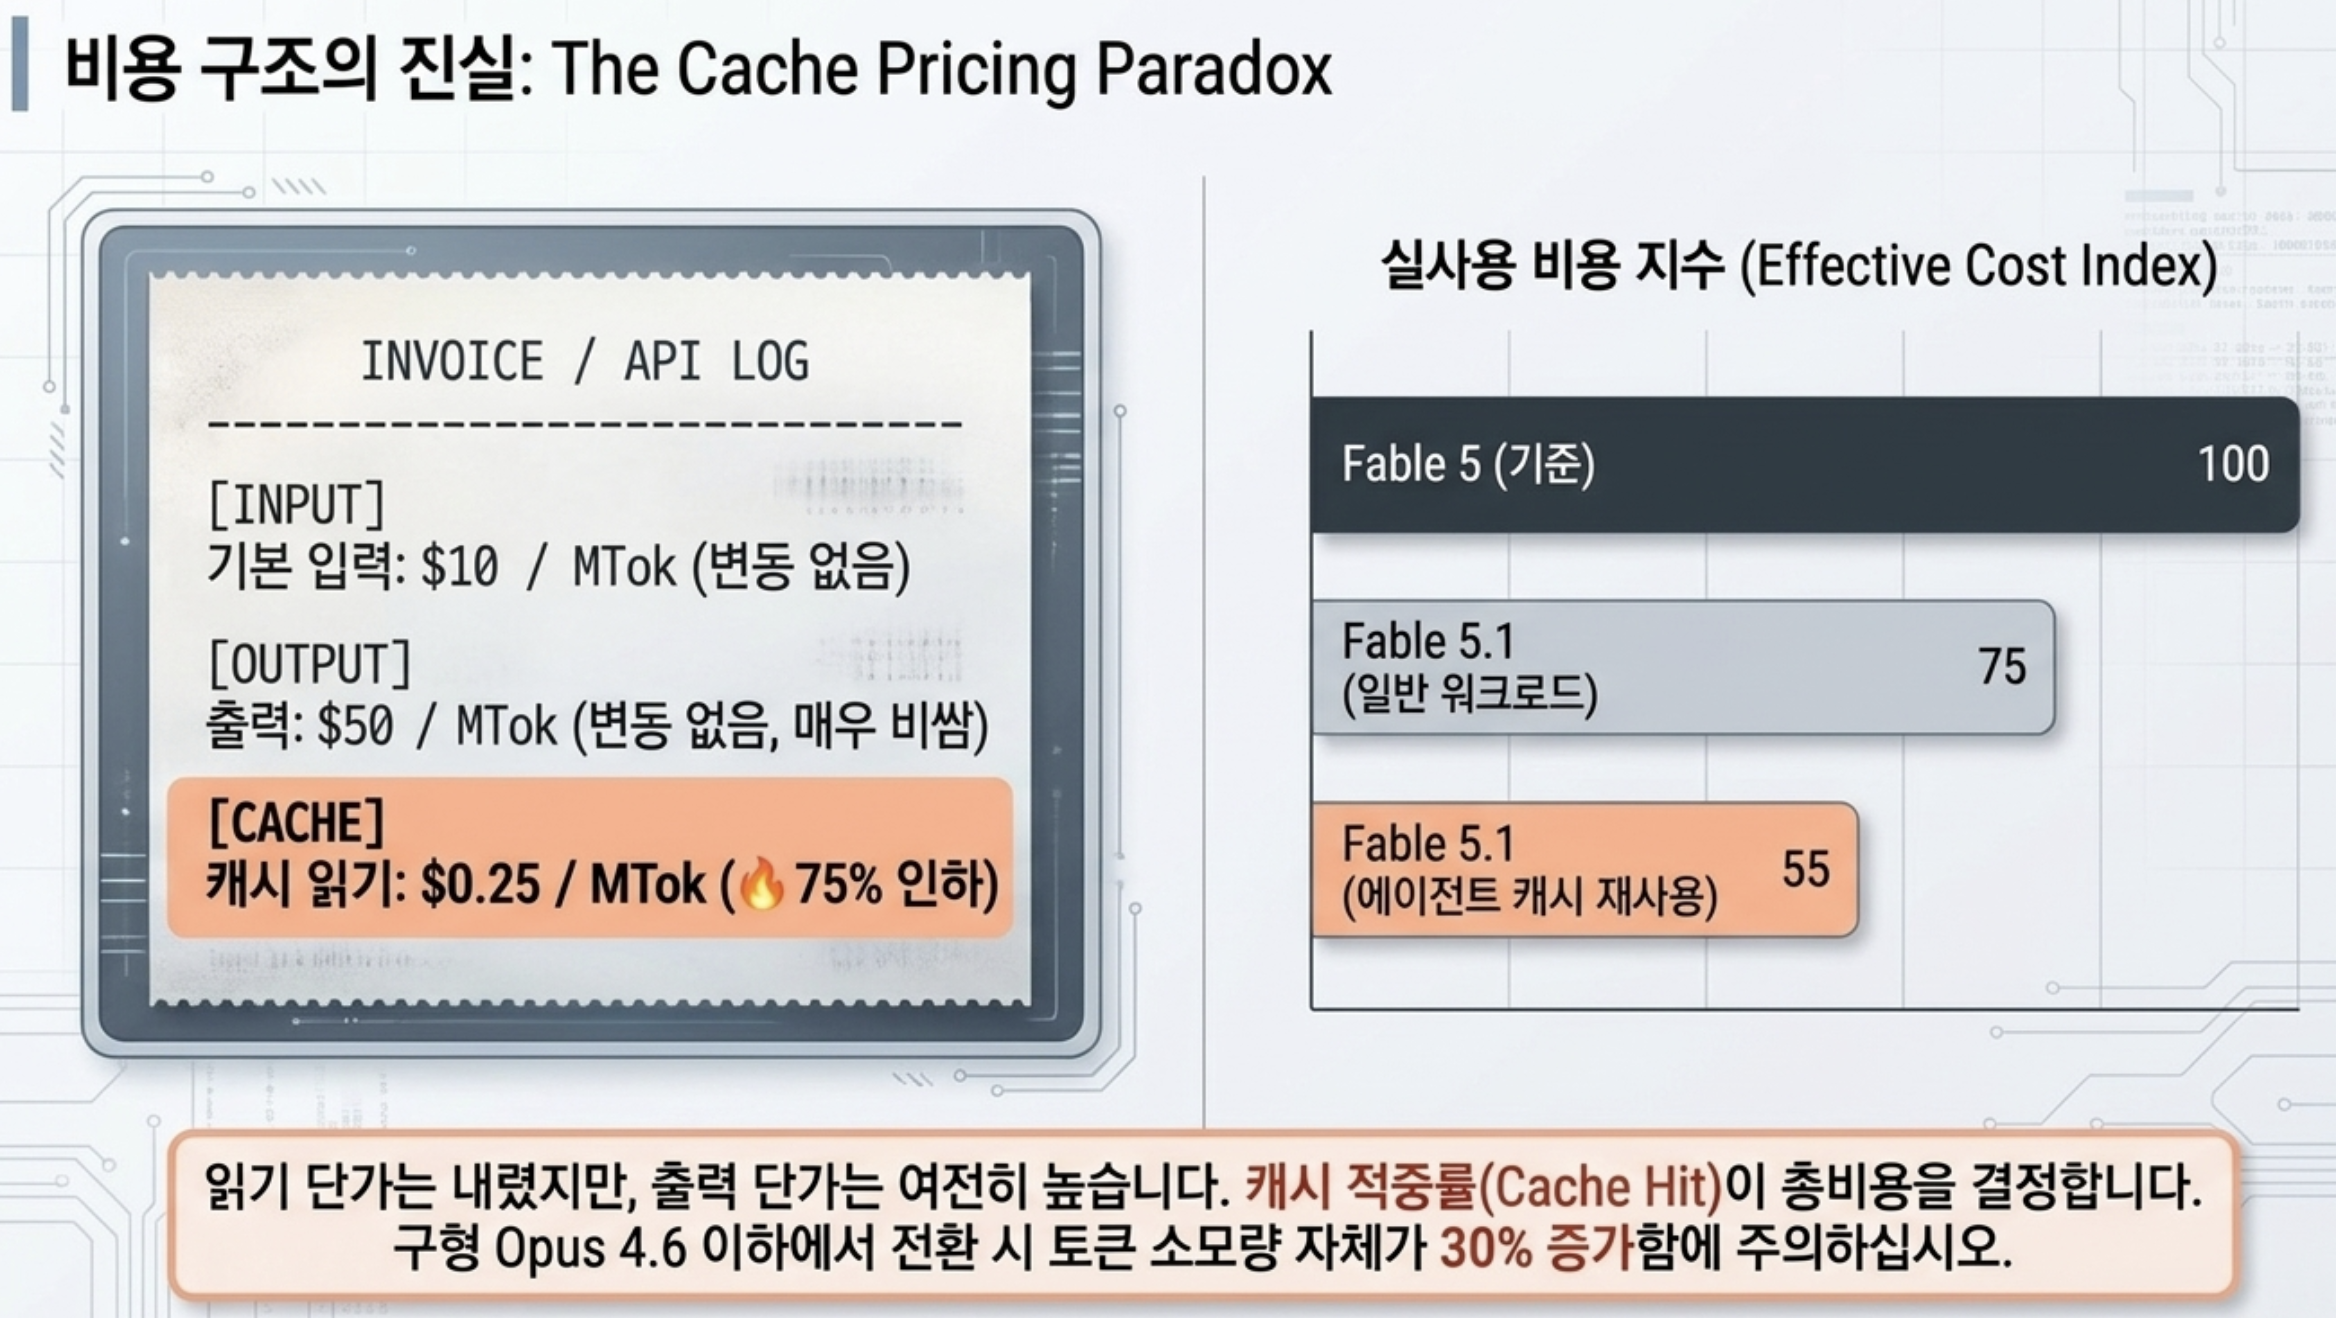
Fable 5.1의 토크나이저는 Fable 5와 같지만, Opus 4.7보다 오래된 모델과 비교하면 같은 글이 약 30% 더 많은 토큰으로 계산된다. 100만 토큰당 단가만 놓고 예전 청구서와 비교하면 계산이 어긋난다. Opus 4.6 이하에서 바로 넘어오는 경우라면 단가가 아니라 실제 토큰 수부터 다시 재보는 편이 정확하다.
| 항목 | Fable 5.1 | Fable 5 |
|---|---|---|
| 기본 입력 | $10 / MTok | $10 / MTok |
| 캐시 쓰기(5분 / 1시간) | $12.50 / $20 | $12.50 / $20 |
| 캐시 읽기 | $0.25 / MTok | $1 / MTok |
| 출력 | $50 / MTok | $50 / MTok |
| Batch 입력 / 출력 | $5 / $25 | $5 / $25 |
앤스로픽은 에이전트 작업에서 최대 45%까지 비용이 줄어든다고 밝혔지만, 이건 캐시 적중률(Cache Hit)이 높은 작업을 전제로 한 추정치다. 답변(출력 토큰)이 길어지거나 새 문맥을 자주 끼워 넣어 캐시가 깨지면 절감 효과는 금방 상쇄된다. 출력 토큰은 여전히 100만 토큰당 50달러로 비싸기 때문이다.

Fable 5를 100으로 뒀을 때의 실사용 비용 지수
Fable 5 (기준)
Fable 5.1 — 일반 워크로드
Fable 5.1 — 캐시 읽기 비중이 큰 에이전트 워크로드
2026년 8월 4주간의 실제 사용량을 기본 effort에서 측정한 값이다. 같은 인하인데 워크로드에 따라 체감이 갈린다. 캐시를 많이 재사용할수록 이득이 커진다. (출처: 앤스로픽 공식 발표)
Fable 5.1은 적응형 추론을 끌 수 없는 대신 low부터 max까지 5단계의 연산 강도(Effort)를 고를 수 있다.
문제는 어떤 환경에서 쓰느냐에 따라 기본값이 전부 다르다는 점이다.
| 사용 환경 | 기본 Effort | 중간 변경 시 캐시 유지 여부 |
|---|---|---|
| Claude API | high | 메시지별 방식(beta)을 쓰면 캐시를 유지한 채 바꿀 수 있다. |
| Claude Code | high | /effort 명령으로 바꾸면 캐시가 날아가고 다시 생성(Cache Miss)된다. |
| Claude.ai (웹) | medium | 제품 내부 로직을 따른다. |
| Claude Cowork | medium | 비교 테스트를 하려면 환경 간 기본값 차이부터 맞춰야 한다. |
클로드 코드(Claude Code)에서 가벼운 질문을 던질 때 비용을 아끼려고 순간적으로 /effort low로 낮추는 경우가 많다.
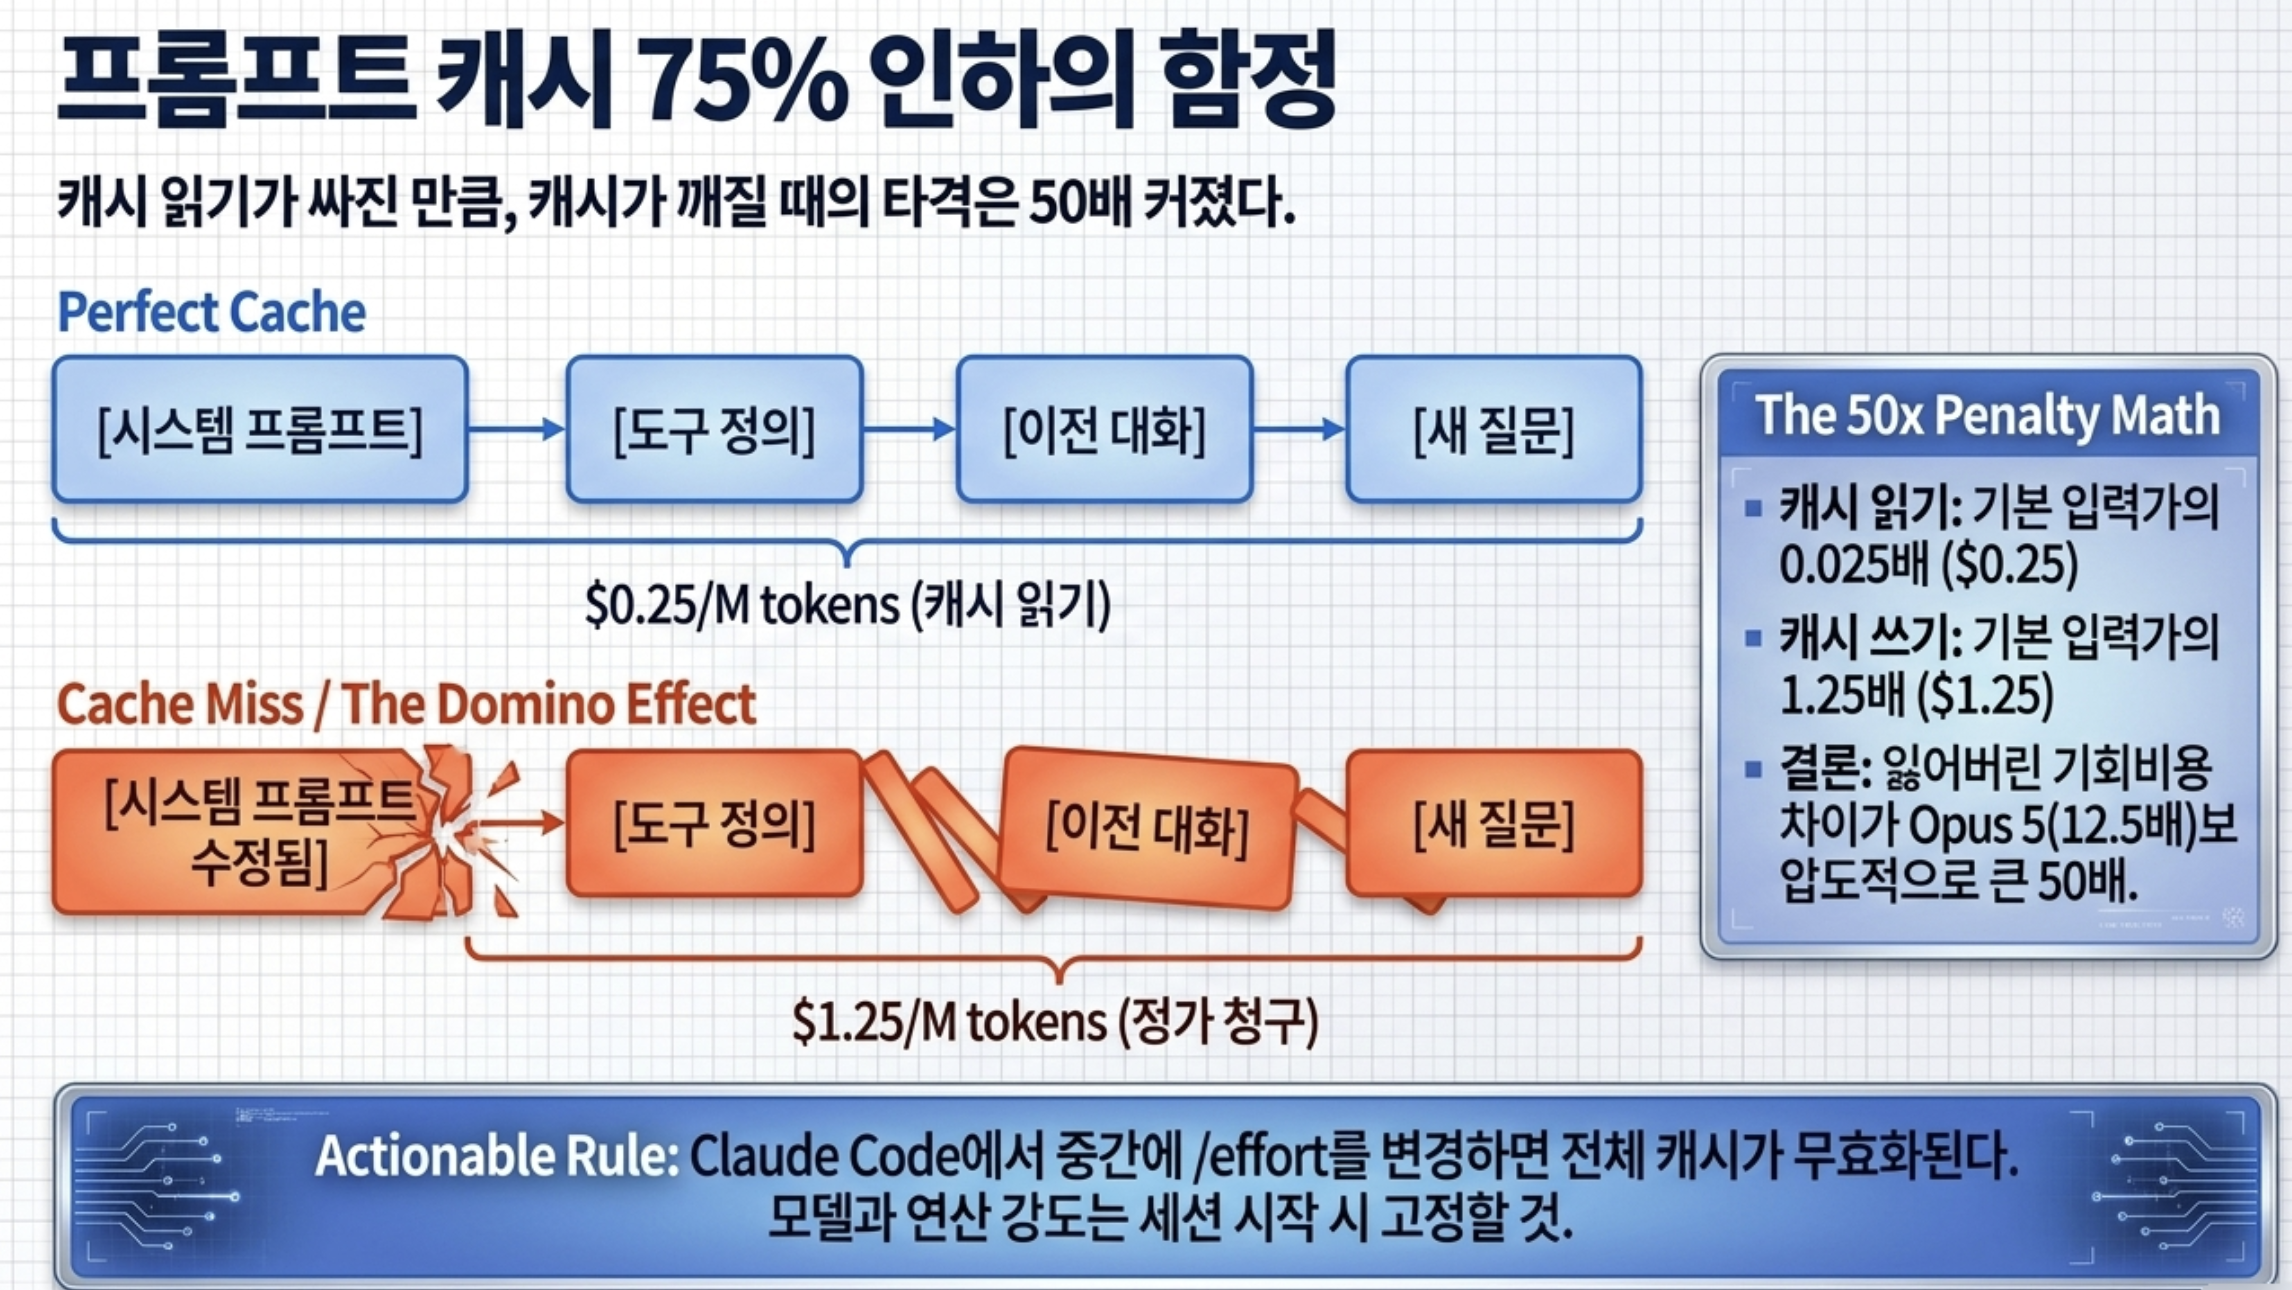
그런데 effort 값이 캐시 키(Cache Key)에 들어가 있어서 이렇게 하면 쌓아둔 캐시가 통째로 무효화(Cache Miss)된다.
수십만 토큰짜리 문맥을 새로 읽어야 하니 배보다 배꼽이 더 커질 수 있다. 공식 문서도 모델과 effort는 세션 시작할 때 정해 두고, /compact는 작업 사이 쉬어가는 시점에만 쓰라고 권한다. 이미 적용 중인 단계와 같은 값으로 다시 설정할 때는 캐시가 유지된다.
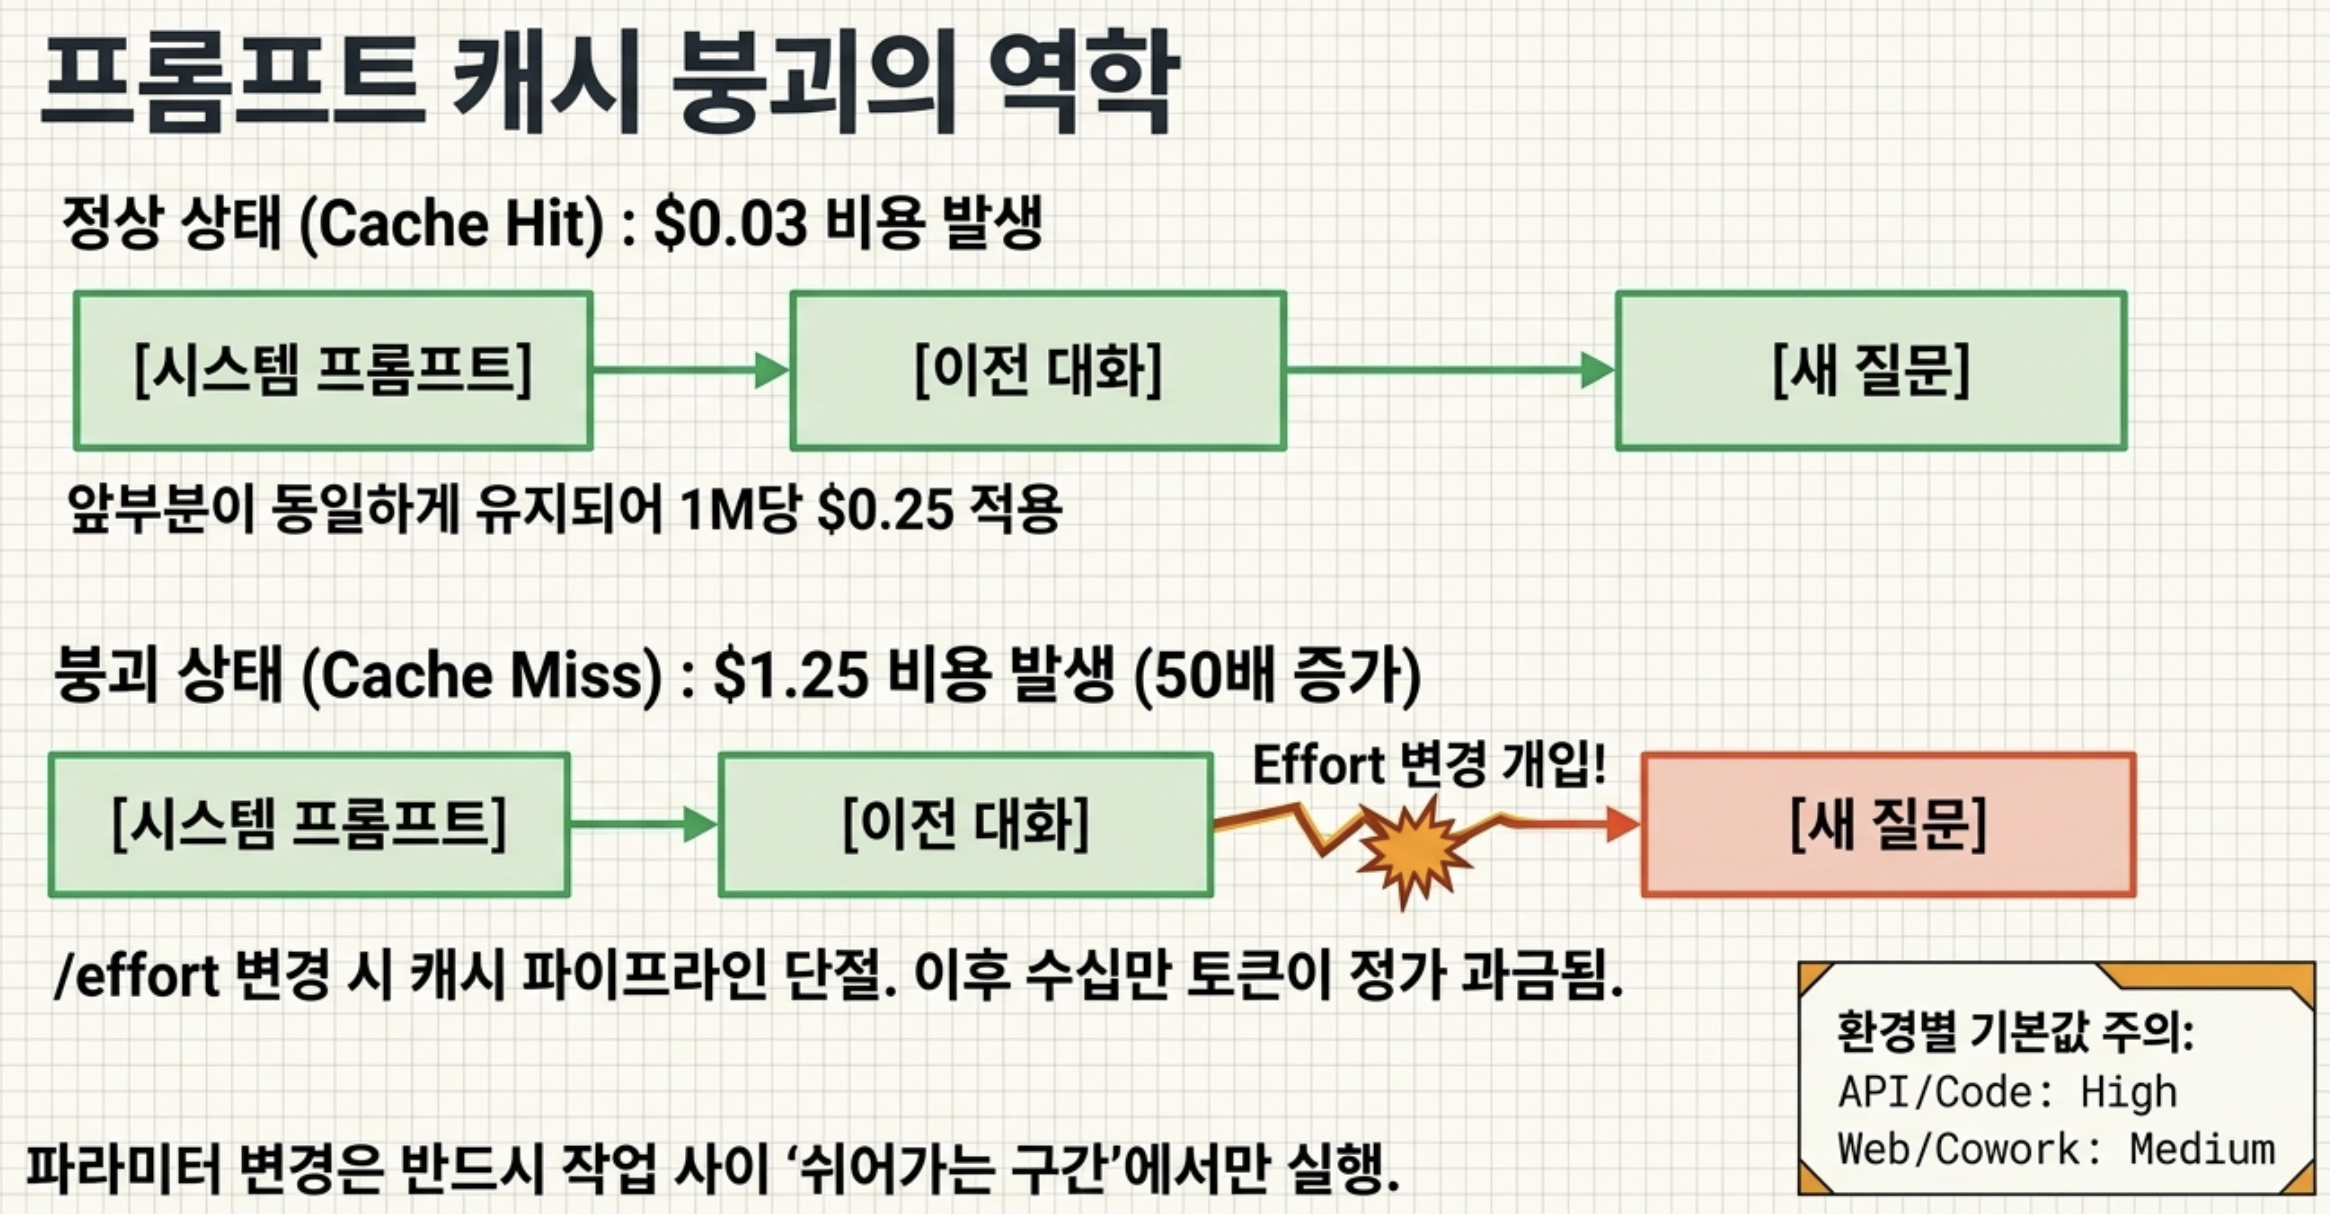
캐시는 ‘앞에서부터 같은 만큼’만 적용된다
정상 — 앞부분이 그대로일 때
→ 초록 구간은 캐시에서 읽는다. 100만 토큰당 0.25달러.
문제 — 앞부분이 한 글자라도 바뀌면
→ 바뀐 지점부터 뒤쪽 전체가 다시 계산된다. 수십만 토큰이 정가로 나간다.
모델과 effort는 이 앞부분과 별개로 캐시 키에 들어가 있다. 그래서 /effort로 단계를 바꾸는 순간 위 그림의 아래쪽 상황이 된다. (출처: Claude Code 공식 문서)
이게 Fable 5.1에서 특히 중요한 이유가 있다. 읽기가 입력가의 0.025배까지 내려간 대신, 캐시가 깨져 다시 쓸 때는 여전히 1.25배가 붙는다. 두 배수의 차이가 50배로 벌어진 셈이다.
10만 토큰짜리 앞부분으로 계산해보면 감이 온다. 캐시를 읽으면 0.03달러인데, 한 번 깨져서 다시 쓰면 1.25달러가 나간다. 같은 조건에서 Opus 5는 0.05달러 대 0.63달러로 12.5배다. 캐시 인하 혜택이 큰 모델일수록 캐시를 깨뜨렸을 때의 대가도 크다.
그래서 “모델과 effort는 세션 시작할 때 정해두라”는 권고가 Fable 5.1에서는 다른 모델보다 무겁게 들린다. 캐시를 깨는 변경은 작업 사이 자연스러운 구간에 몰아서 하는 편이 낫다.
한 가지 더. 사람이 중간에 끼어드는 워크플로라면 Fable 5.1은 다른 모델과 반대되는 선택이 유리하다. 보통은 대기가 길어질 때 1시간짜리 캐시를 사는 게 정석인데, Fable 5.1은 읽기가 워낙 싸서 5분 캐시를 계속 데워두는 쪽이 더 저렴하다. 앤스로픽 측정으로는 몇 분 단위 대기에서 1시간 캐시보다 13~20% 쌌고, 45분에 가까운 긴 대기에서만 1시간 캐시가 앞섰다.
채팅으로만 쓴다면 이 장은 넘어가도 된다.
여기부터는 API로 직접 호출하는 코드를 고치는 이야기다.
클로드 웹이나 앱에서 대화만 한다면 모델 목록에서 Fable 5.1을 고르는 것으로 끝이고, 6장(구독 플랜 주의사항)부터 읽으면 된다. 다만 프롬프트에 낡은 지시가 쌓였는지 보는 뒷부분은 채팅 사용자에게도 쓸모가 있다.
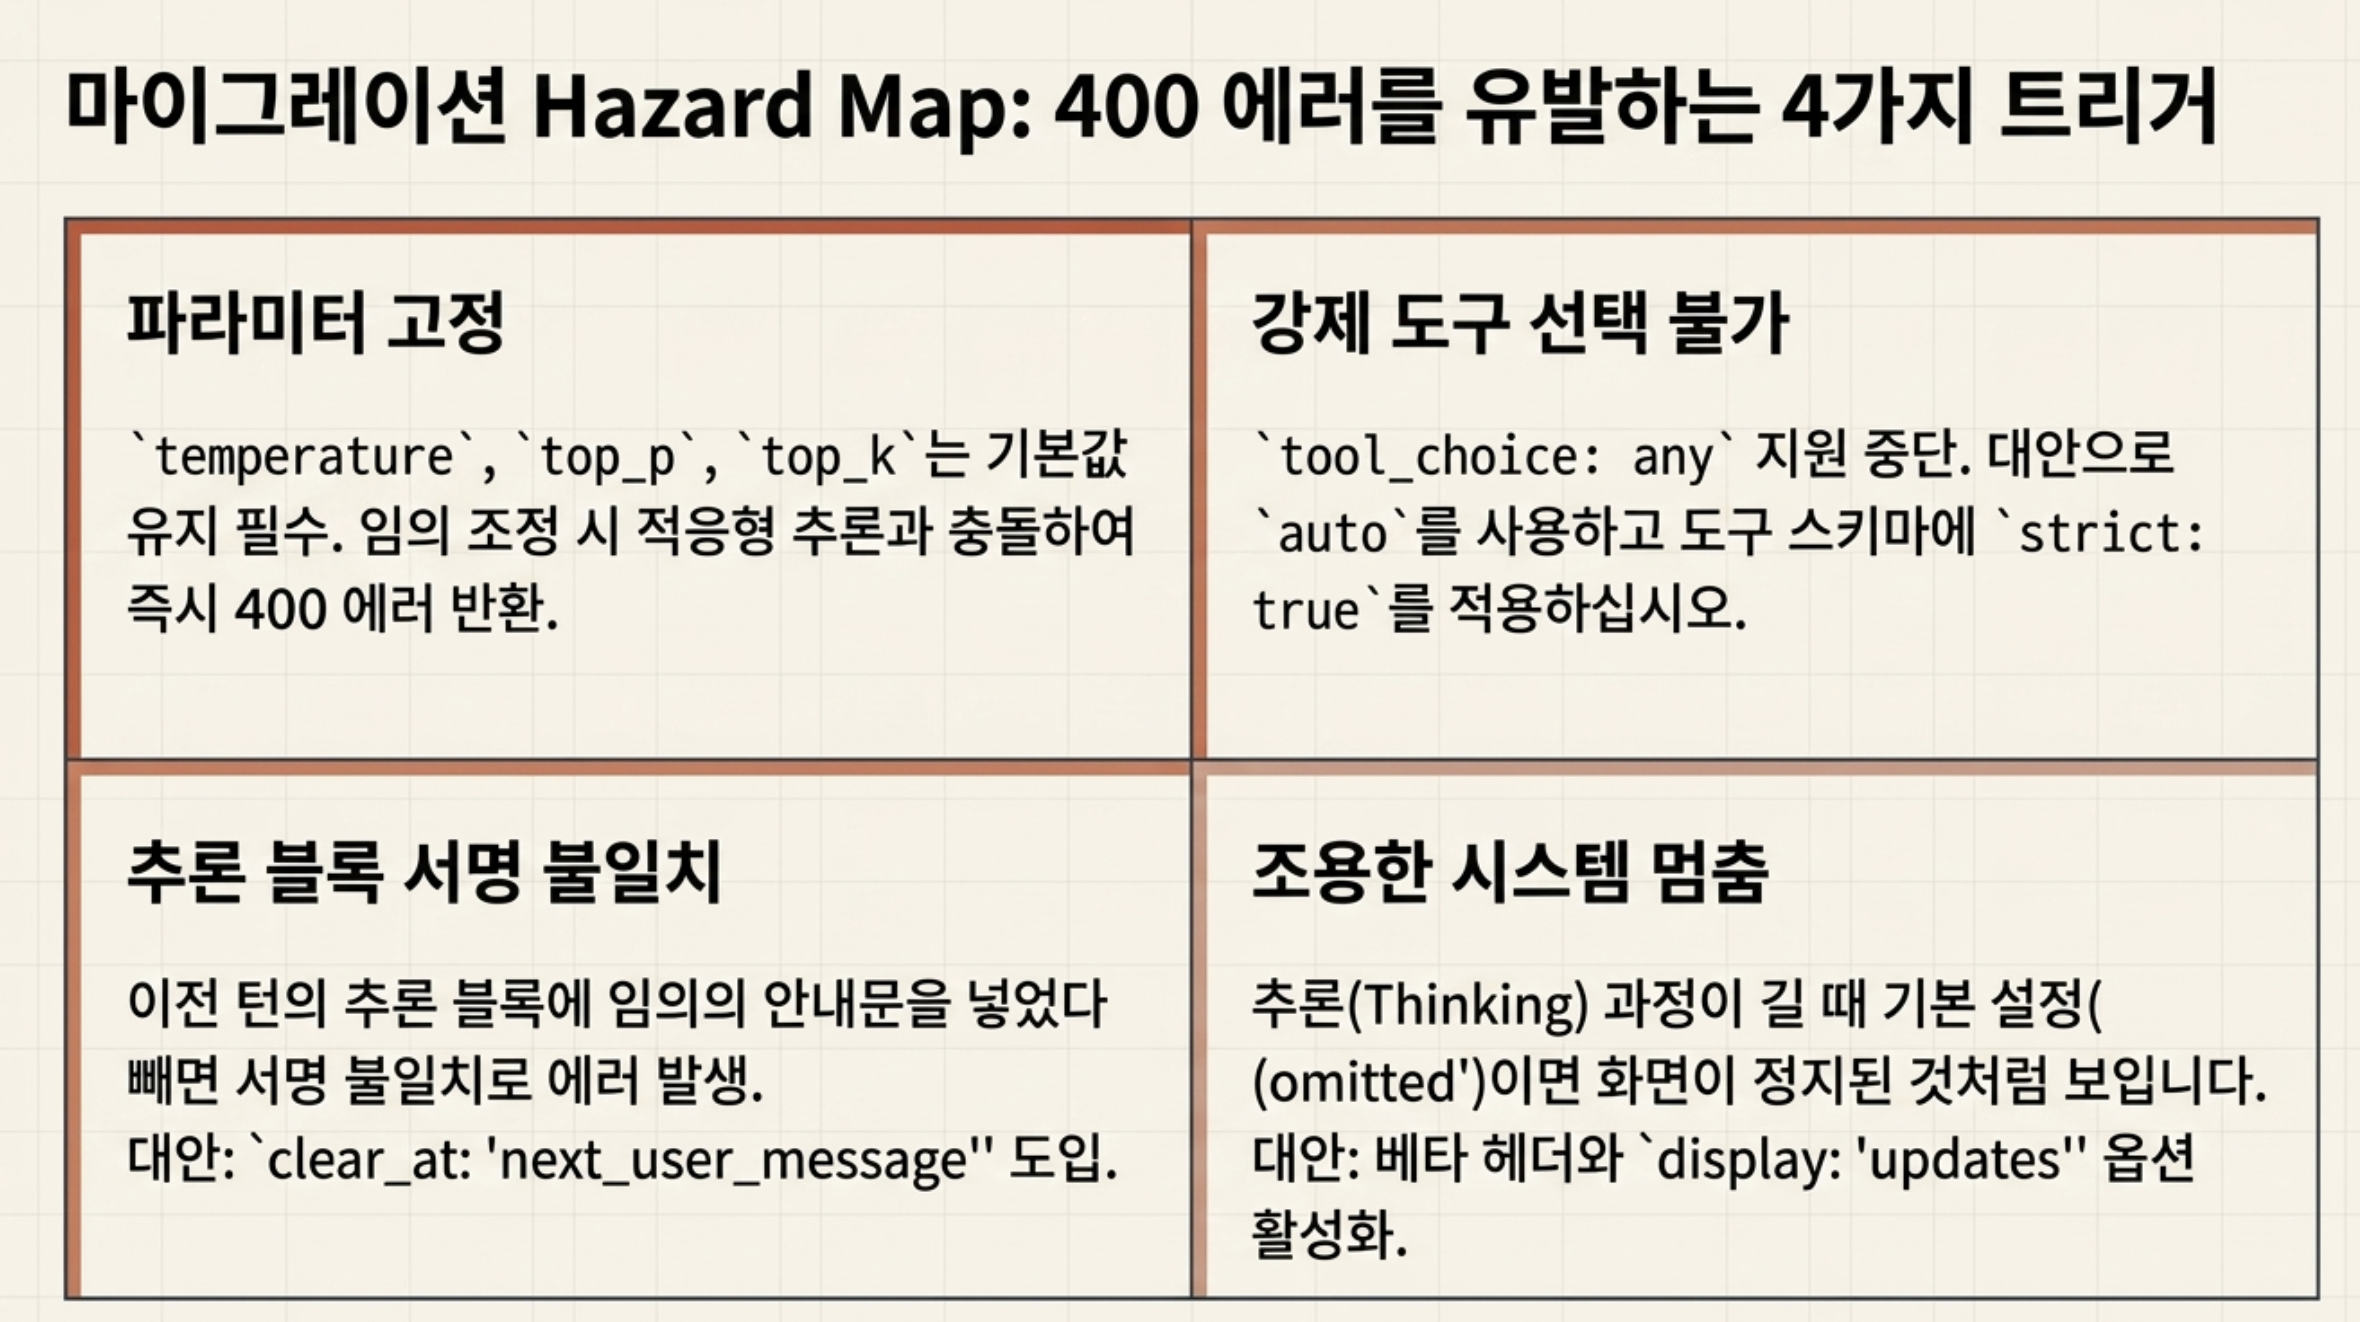
새 버전이 나왔다고 모델 ID만 바꾸면 낭패를 볼 수 있다. 요청을 보내자마자 400 에러가 나는 변경 사항부터 짚고 넘어가자.
기존 API 보일러플레이트 코드를 복사해서 쓸 때 가장 흔하게 걸리는 문제다.
Fable 5.1에서 temperature, top_p, top_k를 기본값이 아닌 값으로 넣으면 그대로 400 잘못된 요청 오류(invalid_request_error)가 돌아온다.
모델이 스스로 최적값을 찾도록(적응형) 설계됐기 때문이다.
공식 문서에는 "Fable 5에서 바뀌지 않은 것" 항목으로 적혀 있으니, Fable 5를 건너뛰고 Opus 계열에서 바로 넘어오는 경우에 특히 주의하면 된다.
tool_choice: any로 특정 도구를 무조건 쓰게 강제하던 방식도 400 에러가 난다.
auto와 none은 그대로 된다.
특정 도구를 꼭 써야 한다면 프롬프트에서 명시적으로 지시하고 도구 정의에 strict: true를 주면 된다.
애초에 스키마에 맞는 JSON만 필요했던 거라면 공식 문서는 output_config.format의 JSON 출력을 대신 쓰라고 안내한다.
# Fable 5.1 마이그레이션 예시: tool_choice는 auto로 두고, 도구 정의에 strict를 준다.
tool = {
    "name": "record_summary",
    "description": "문서 요약을 저장합니다.",
    "strict": True,
    "input_schema": {
        "type": "object",
        "properties": {"summary": {"type": "string"}},
        "required": ["summary"],
        "additionalProperties": False,
    },
}

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=16000,
    tools=[tool],
    tool_choice={"type": "auto"},
    messages=[{
        "role": "user",
        "content": "문서를 요약한 뒤 반드시 record_summary tool을 호출해줘."
    }],
)
Fable 5.1은 이전 모델이 남긴 추론 블록(과거 대화 내역)을 읽을 수 있지만, 반대로 Fable 5.1이 만든 추론 블록을 이전 모델에게 넘기면 읽지 못한다.
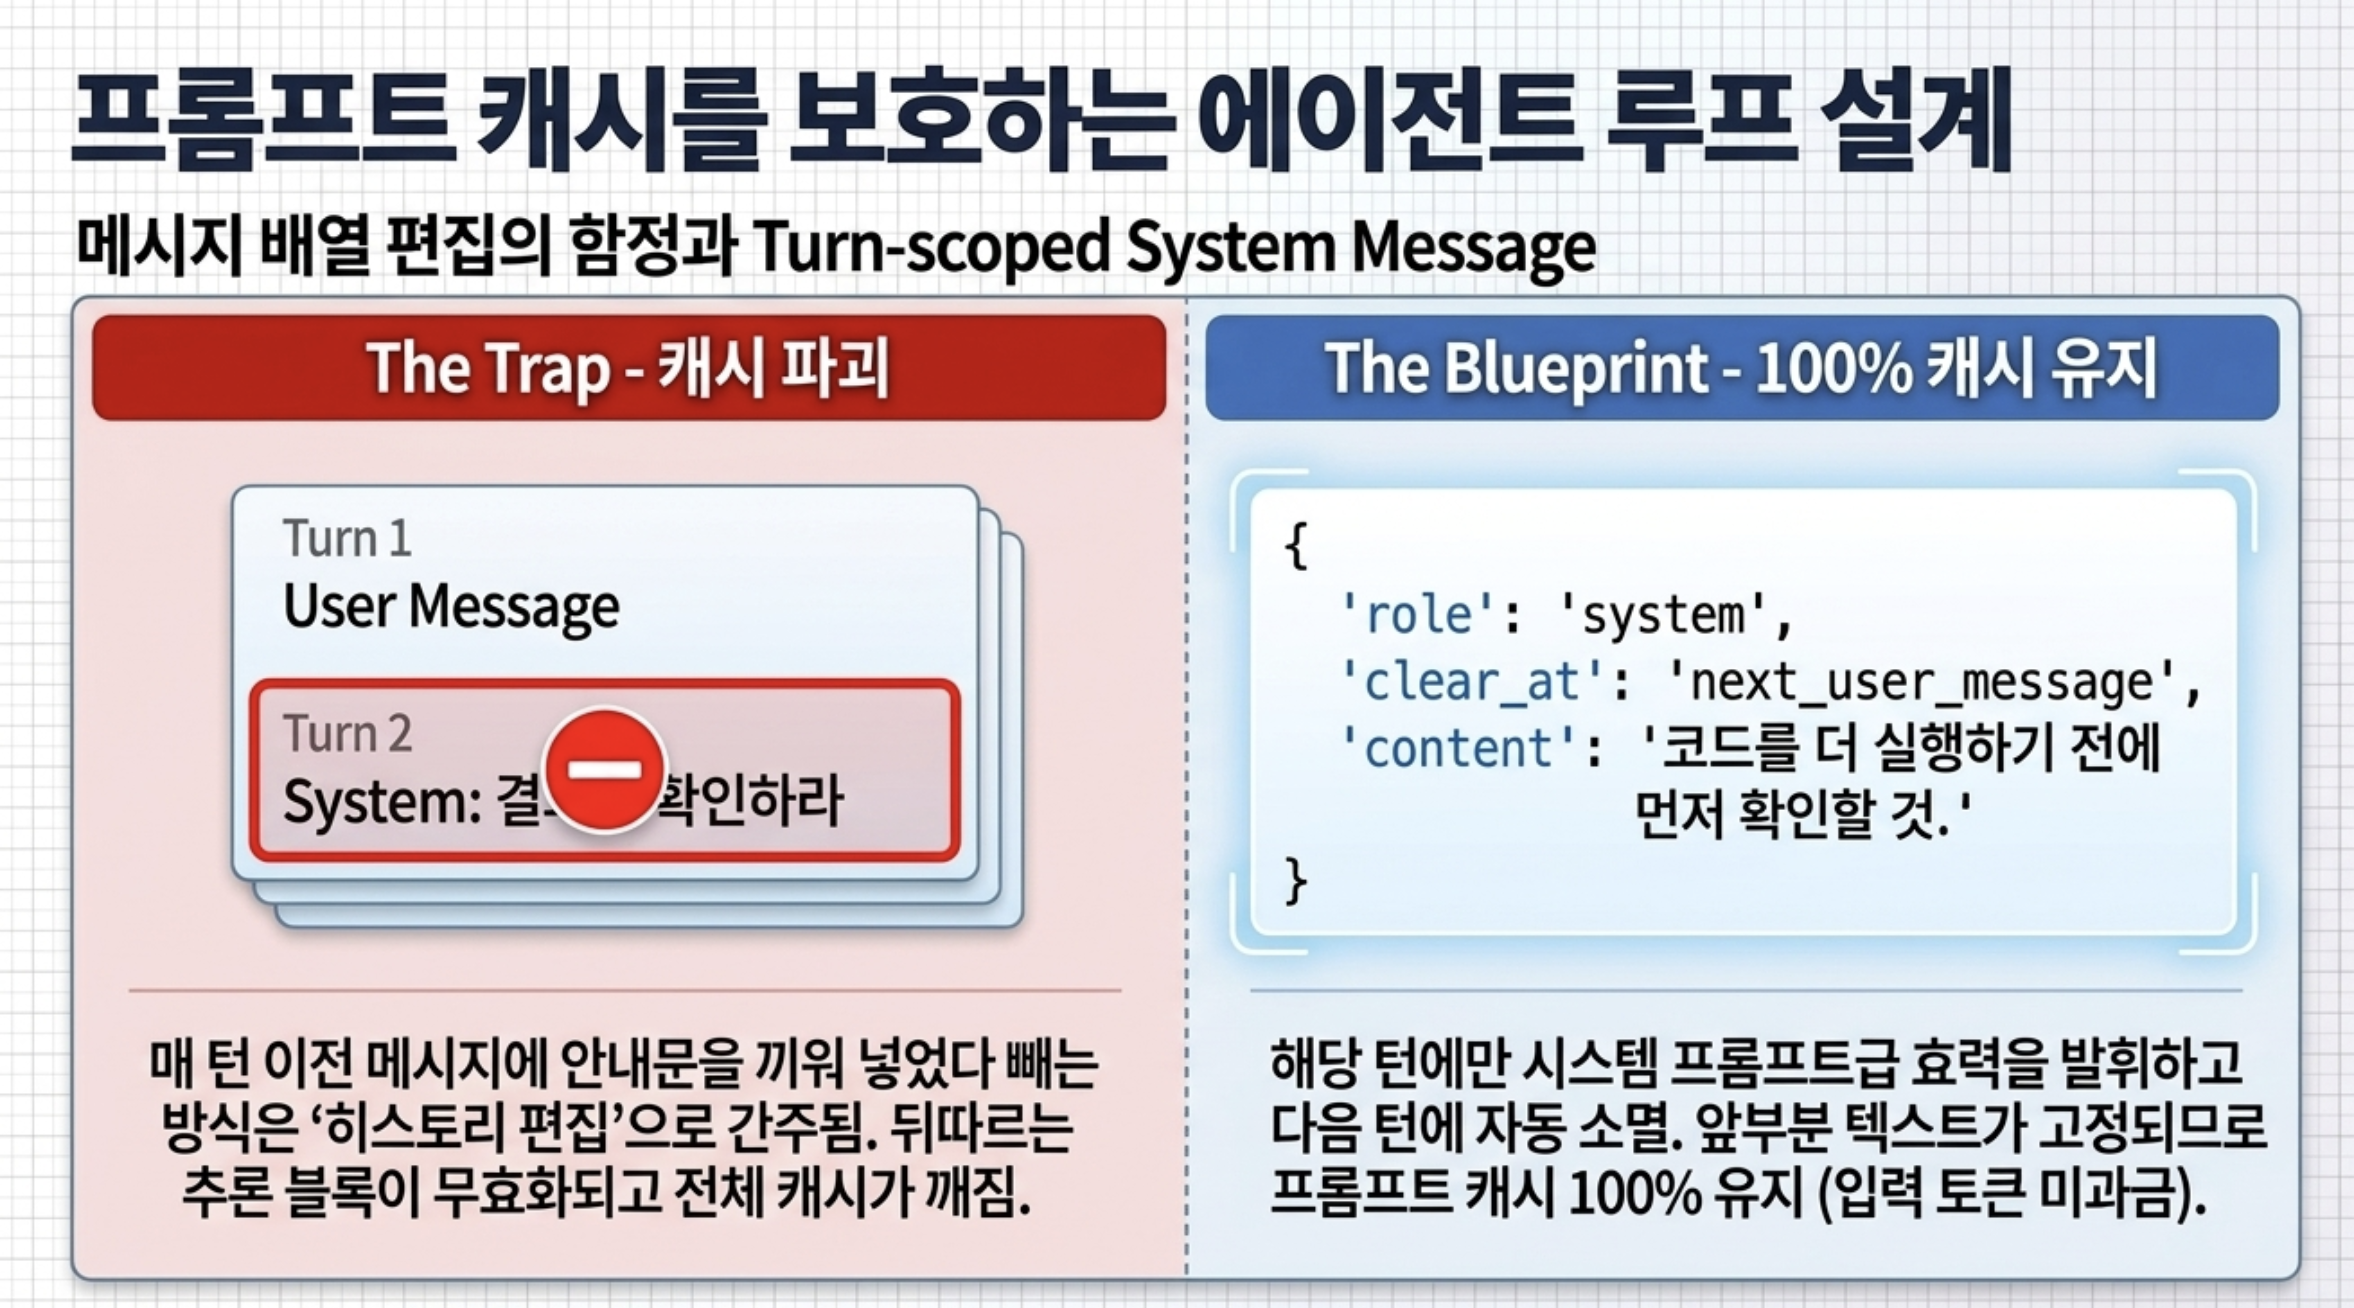
모델 간 전환 라우터(Router)를 만들 때 이 한 방향 호환성을 염두에 둬야 한다.
이전 턴 내용을 편집해서 다시 보내는 경우에도 추론 블록 서명이 안 맞아 400 에러가 나므로, 이런 파이프라인이 있다면 문서가 안내하는 thinking.block_binding.prefix_mismatch_behavior: "drop_block" 옵션을 먼저 살펴보자.
여기서 실제로 많이 걸리는 패턴이 하나 있다.
에이전트 루프를 돌릴 때 매 턴 "도구 결과는 사용자에게 안 보인다" 같은 안내문을 이전 메시지에 끼워 넣었다가 다음 요청에서 빼는 방식이다. 이게 바로 히스토리 편집으로 잡혀서 뒤따르는 추론 블록을 전부 무효로 만든다.
Fable 5.1에는 이걸 대체하라고 만든 기능이 새로 들어갔다.
턴 단위 시스템 메시지(Turn-scoped system message)인데, role: "system" 메시지에 clear_at: "next_user_message"를 달아두면 그 턴에만 시스템 프롬프트급 효력을 갖고, 다음 사용자 메시지가 들어오는 순간 자동으로 효력이 사라진다.
{
  "role": "system",
  "clear_at": "next_user_message",
  "content": "결과가 받은 편지함에 도착했다. 코드를 더 실행하기 전에 먼저 확인할 것."
}
메시지 자체는 배열에 그대로 남겨두고 계속 같이 보내면 된다.
그래서 앞부분이 바뀌지 않아 프롬프트 캐시도 유지되고 추론 블록도 살아 있다.
효력이 끝난 메시지는 입력 토큰으로 과금되지도 않는다. 베타 헤더 mid-conversation-system-clear-at-2026-08-21이 필요하다.
에러는 아니지만 사용자 화면에서 바로 티가 나는 변화다.
Fable 5.1은 도구를 연달아 호출하는 동안 중간 경과를 Fable 5보다 덜 쓴다. 연산 강도가 높을수록 더 그렇다.
문제는 이 경과 메시지가 thinking 블록으로 나온다는 점이다.
기본 설정(display: "omitted")에서는 추론 내용처럼 빈 값으로 돌아오기 때문에, 몇 분씩 걸리는 작업이 화면에서는 아무 반응 없이 멈춘 것처럼 보인다.
이걸 위해 display: "updates" 옵션이 새로 생겼다.
베타 헤더 thinking-display-updates-2026-08-18을 붙이면 추론 내용은 계속 감춘 채 경과 메시지만 텍스트로 받아볼 수 있다. 내용이 들어 있는 thinking 블록은 그대로 진행 상황 표시줄에 띄우면 된다.
진행 상황을 UI에 보여주는 서비스라면 여기에 하나 더 챙길 게 있다.
기존 프롬프트에 "중간 설명 말고 마지막에 한 번에 정리해줘" 같은 지시가 남아 있으면 빼는 편이 낫다. 그래도 부족하면 시작 문장, 중간 경과, 마무리 요약을 각각 요청하면 된다.
모델 ID를 바꾸기 전에 볼 네 가지
1. 파라미터
temperature, top_p, top_k가 기본값인가
2. 도구 호출
tool_choice에 any나 tool이 남아 있는가
3. 대화 이력
이전 턴을 편집하거나 안내문을 넣었다 빼는 코드가 있는가
4. 오류 처리
HTTP 200인데 refusal로 오는 응답을 잡고 있는가
1번과 2번은 모델 ID만 바꿔도 바로 400이 난다. 3번과 4번은 조용히 깨지는 쪽이라 오히려 찾기 어렵다.
여기까지가 바로 에러가 나는 변경점이었다. 그런데 실무에서 더 골치 아픈 쪽은 따로 있다. 에러 없이 잘 돌아가는데 토큰만 더 먹고 결과는 더 장황해지는 경우다.
원인이 좀 역설적이다. 새 모델이 지시를 더 잘 따라서 생기는 문제이기 때문이다. 예전 모델이 자꾸 검증을 건너뛰길래 넣어둔 “반드시 두 번 확인하라” 같은 문장을, 요즘 모델은 곧이곧대로 실행한다. 이미 스스로 검증하는 모델에게 검증을 한 번 더 시키는 셈이다.
앤스로픽 소속 개발자가 정리한 여섯 가지 패턴이다. 이 중 검증 의식, 강조 부스터, 고정 절차, 스크래치패드 네 가지는 공식 비용 최적화 문서에도 같은 예시로 실려 있다.
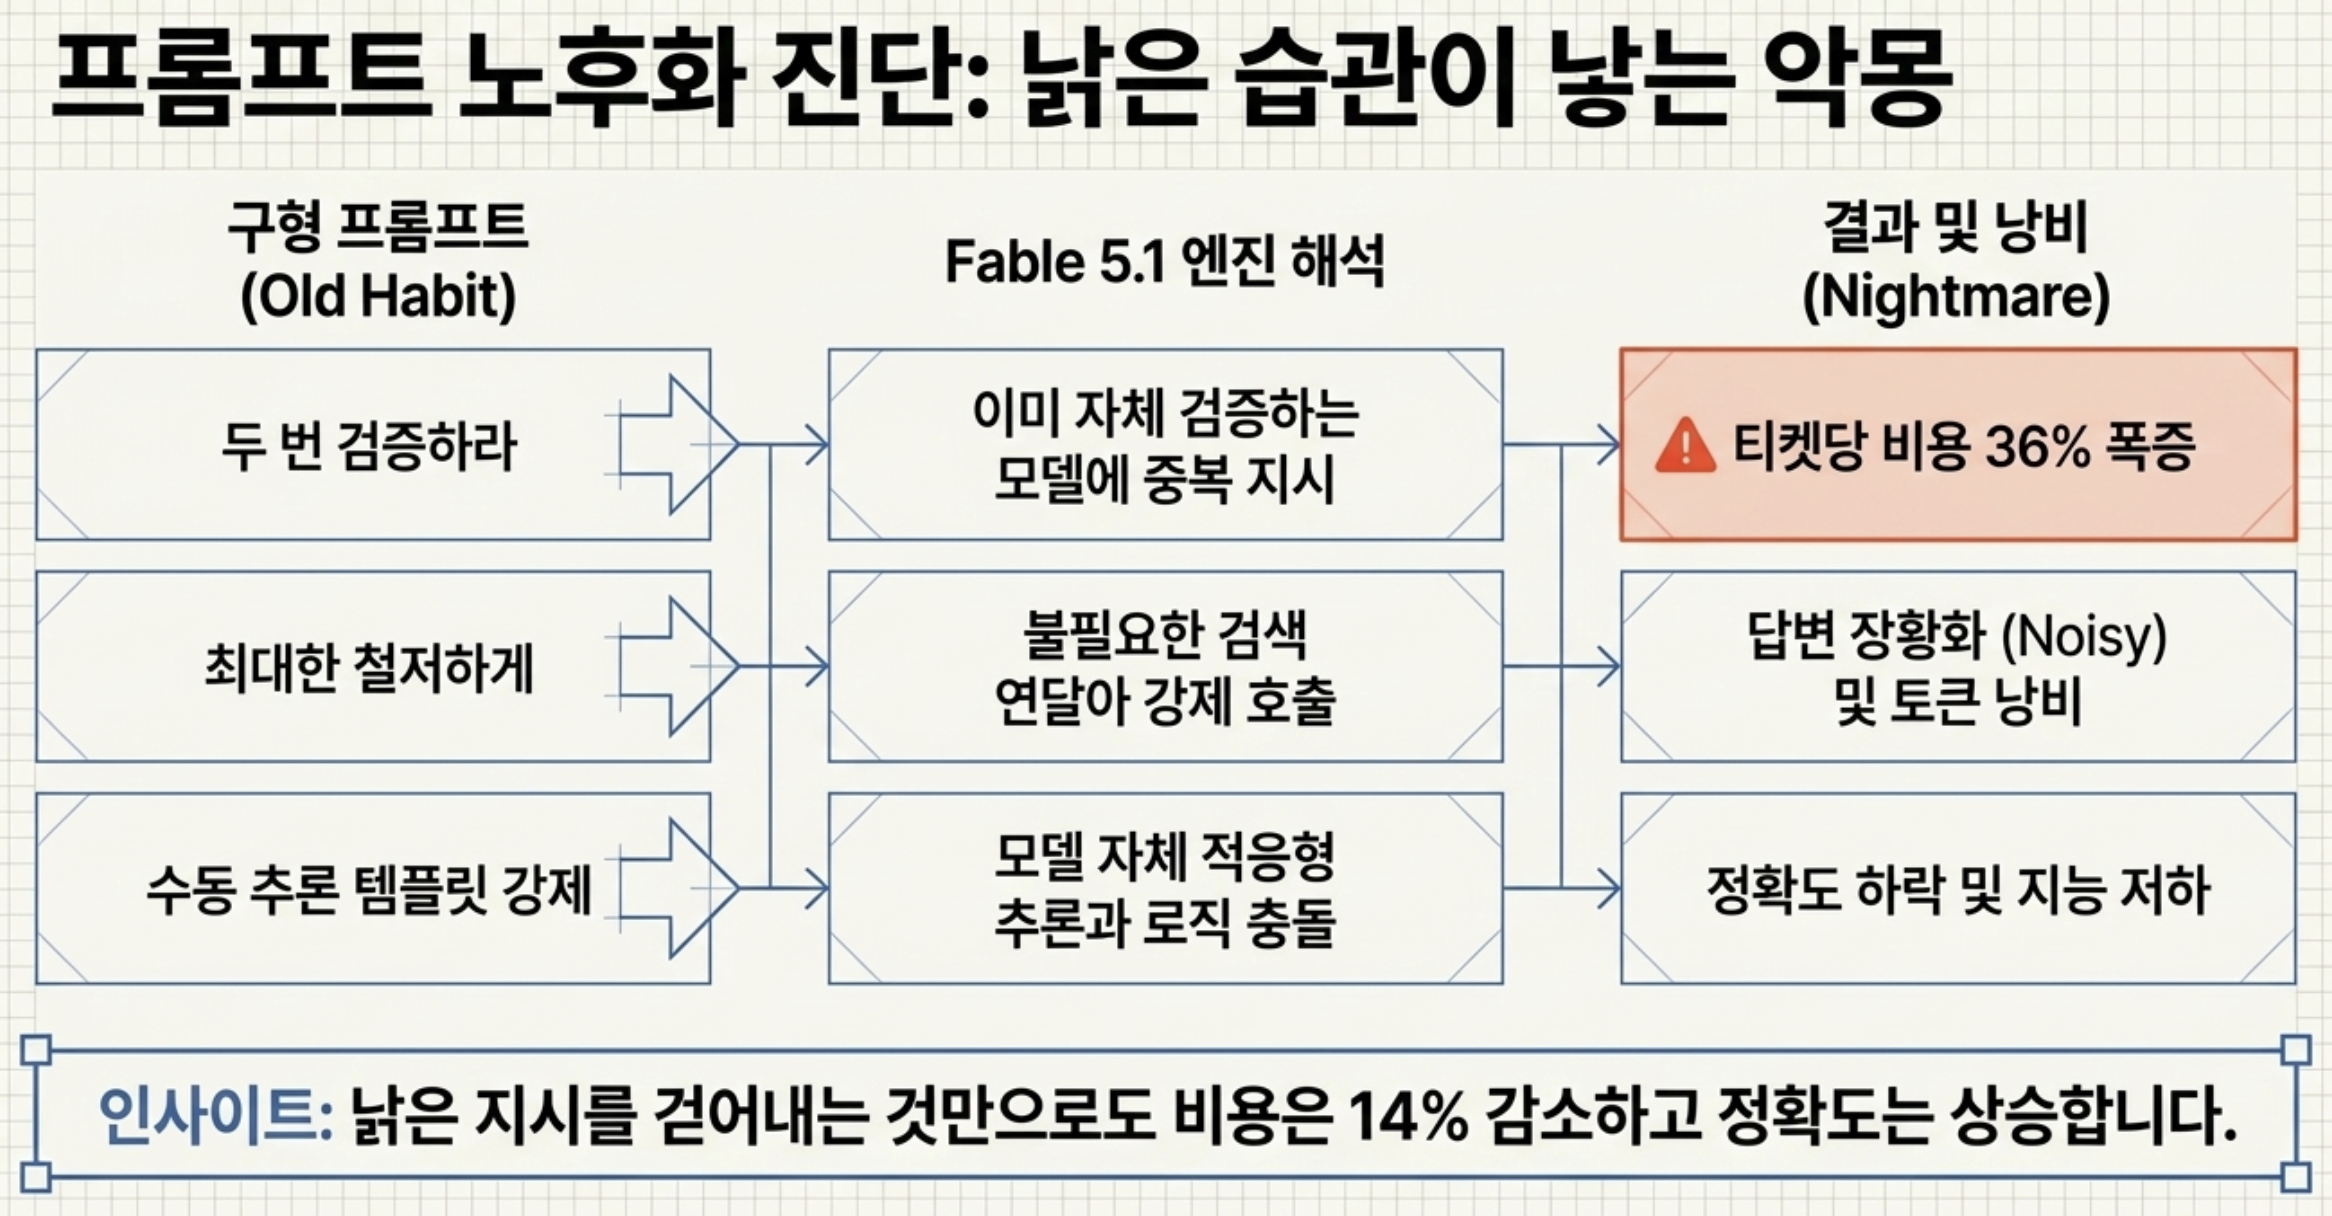
| 패턴 | 프롬프트에 흔히 이렇게 적혀 있다 | 새 모델에서 생기는 일 |
|---|---|---|
| 검증 의식 | “작업을 다시 확인하라”, “답하기 전에 두 번 검증하라” | 이미 하는 검증을 한 번 더 한다. 토큰 중복 |
| 강조 부스터 | “최대한 철저하게”, “중요: 반드시 항상…” | 답이 장황해지고 도구 호출이 불필요하게 늘어난다 |
| 고정 절차·스크래치패드 | “스크래치패드에 단계별로 생각하라”, 정해진 추론 템플릿 | 모델 자체 추론 위에 절차가 한 겹 더 쌓인다 |
| 낡은 예시 | 예전 모델 실패에 맞춰 만든 few-shot 예시 | 쉬운 요청에도 긴 추론을 흉내 내도록 학습된다 |
| 모순되는 규칙 | “정책 내 환불은 즉시” + “승인 없이 환불 금지” | 예전엔 알아서 넘어가던 모순을 그대로 따르려 한다 |
| 낡은 설정 | 수동 thinking budget 같은 구세대 파라미터 | 이건 조용히가 아니라 400으로 튄다 |
공개된 사례가 하나 있다. 사내 고객지원 벤치마크로 Opus 4.8에서 Opus 5로 옮겨보니, “두 번 검증하라”는 지시가 작업을 중복시켰고 “최대한 철저하게”라는 문구 하나가 불필요한 검색을 수십 번 만들어냈다고 한다. 이 패턴들을 걷어내자 성능이 오르고 비용은 내려갔다.
막연한 권고가 아니다.
앤스로픽이 44개 티켓짜리 고객지원 평가셋으로 재본 결과가 공개돼 있다.
| 상황 | 티켓당 비용 | 정확도 |
|---|---|---|
| Opus 4.8용 프롬프트를 그대로 Opus 5에 | 36% 증가 | 92% (변화 없음) |
| 같은 프롬프트를 감사한 뒤 Opus 5에 | 14% 감소 (바로 윗줄, 감사 전 Opus 5 대비) |
97% (95% 신뢰구간 3~8포인트 개선) |
| Sonnet 4.6 → Sonnet 5 마이그레이션 | 14% 감소 | 동일 (차이가 노이즈 범위 안) |
숫자를 그대로 옮기기 전에 조건은 알아두는 편이 좋다.
이 평가는 깨끗한 프롬프트 하나에 문제 패턴을 하나씩만 넣은 시스템 프롬프트 여섯 개를 만들어, 44개 티켓에 각각 돌린 뒤 평균을 낸 값이다. 실무 프롬프트처럼 여러 패턴이 겹쳐 있는 경우를 잰 게 아니다.
여기서 더 흥미로운 건 패턴마다 손해 보는 항목이 다르다는 점이다.
모델이 너무 곧이곧대로 따르는 지시는 돈을 깎아먹는다.
“두 번 검증하라” 한 줄을 지웠더니 Opus 5의 티켓당 비용이 3분의 1 줄었다. “최대한 철저하게”도 비슷했다.
반면 모델에 더 이상 안 맞는 텍스트는 정확도를 깎는다.
예전 버전에 설정 해둔..... 은퇴한 thinking 설정, 서로 모순되는 규칙, 손으로 만든 스크래치패드를 각각 제거했더니 Opus 5에서 7~11점씩 회복됐다.
결국 이젠 모델이 변경될때마다 각자의 하네스, 설정, 전역 지침 등등을 점검해봐야할 것 같다.
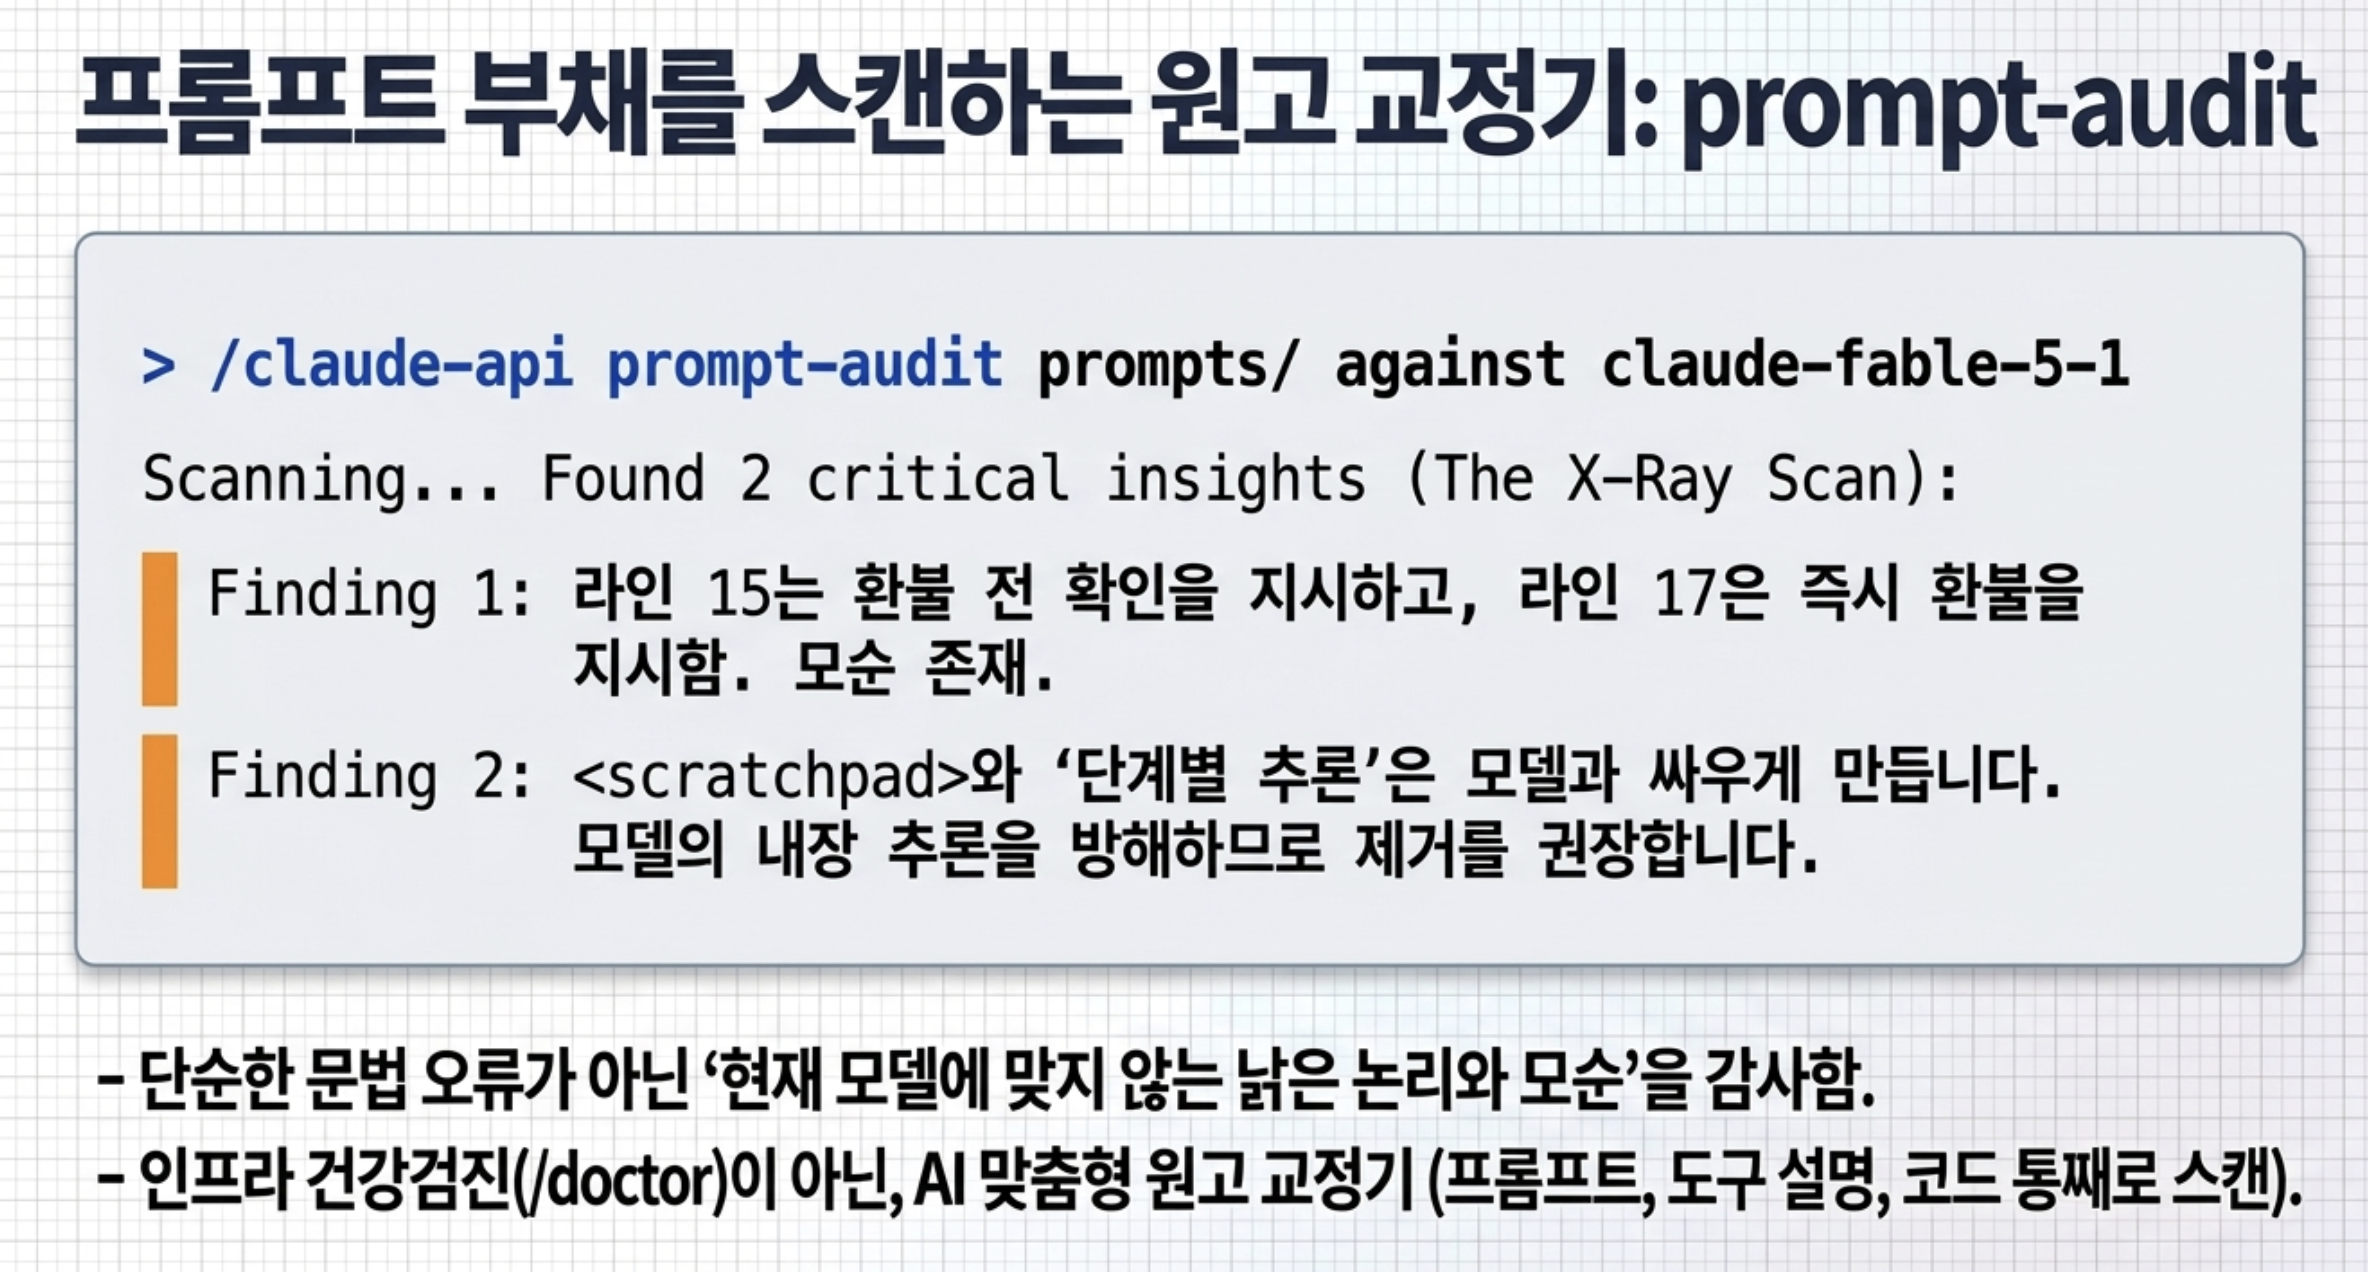
클로드 코드에 claude-api 스킬이 기본 포함돼 있어서 따로 설치할 게 없다.
먼저 버전부터 확인하고 최신으로 올려두자.
claude --version
claude update
ex) claude --version
2.1.263 (Claude Code)
그다음 감사받을 프로젝트 폴더로 이동해서 세션을 연다. 프롬프트 파일이 있는 위치에서 실행해야 훑을 대상이 잡힌다.
cd ~/projects/my-agent
claude
세션이 열리면 이렇게 입력한다.
> /claude-api prompt-auditex) 진행전 model을 fable 5.1 로 변경했는지 확인
범위나 타깃 모델을 미리 정해주고 싶으면 뒤에 말로 붙이면 된다. 공식 문서가 안내하는 방식이 이렇다.
> /claude-api prompt-audit prompts/ against claude-fable-5-1
공식 문서에 실린 실행 결과를 보면 출력이 이런 형태다. 지원 데스크용 프롬프트를 대상으로 돌린 예시다.
10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.
발견이 0건으로 나올 수도 있다.
프롬프트가 짧거나 이미 최신 모델 기준으로 쓰여 있으면 지적할 게 없는 게 정상이다.
그럴 때는 도구 설명이나 스킬 파일까지 범위를 넓혀 다시 돌려보면 된다.
읽는 순서가 정해져 있다. 발견 건수 → 가장 중요한 세 개 → 수정 diff → 일부러 안 건드린 것 목록 순이다. 마지막 항목이 특히 마음에 드는데, 위 예시에서는 환불 기한, 말투 요건, 품질 기준을 손대지 않았다고 따로 밝힌다. 통째로 새로 쓴 원고가 아니라 검토할 패치를 받는 셈이다.
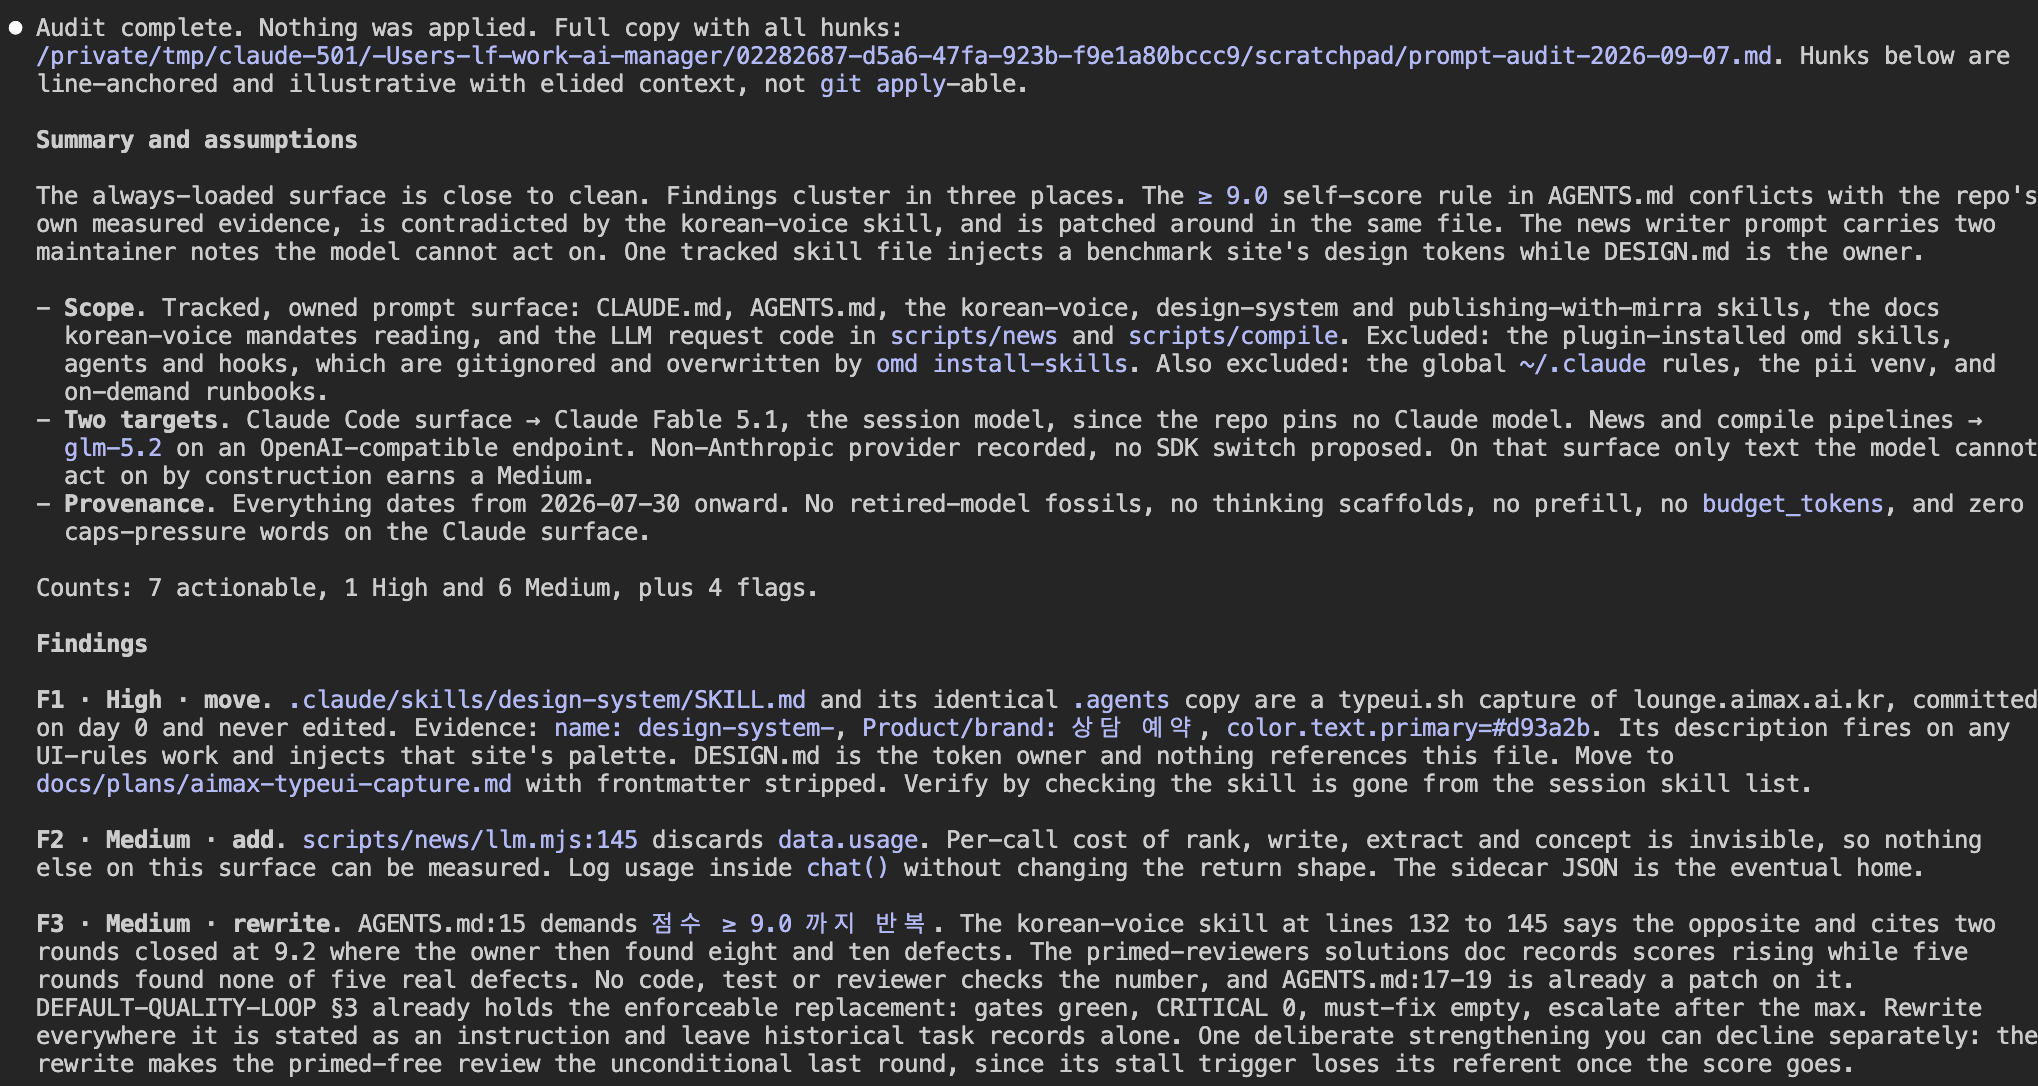
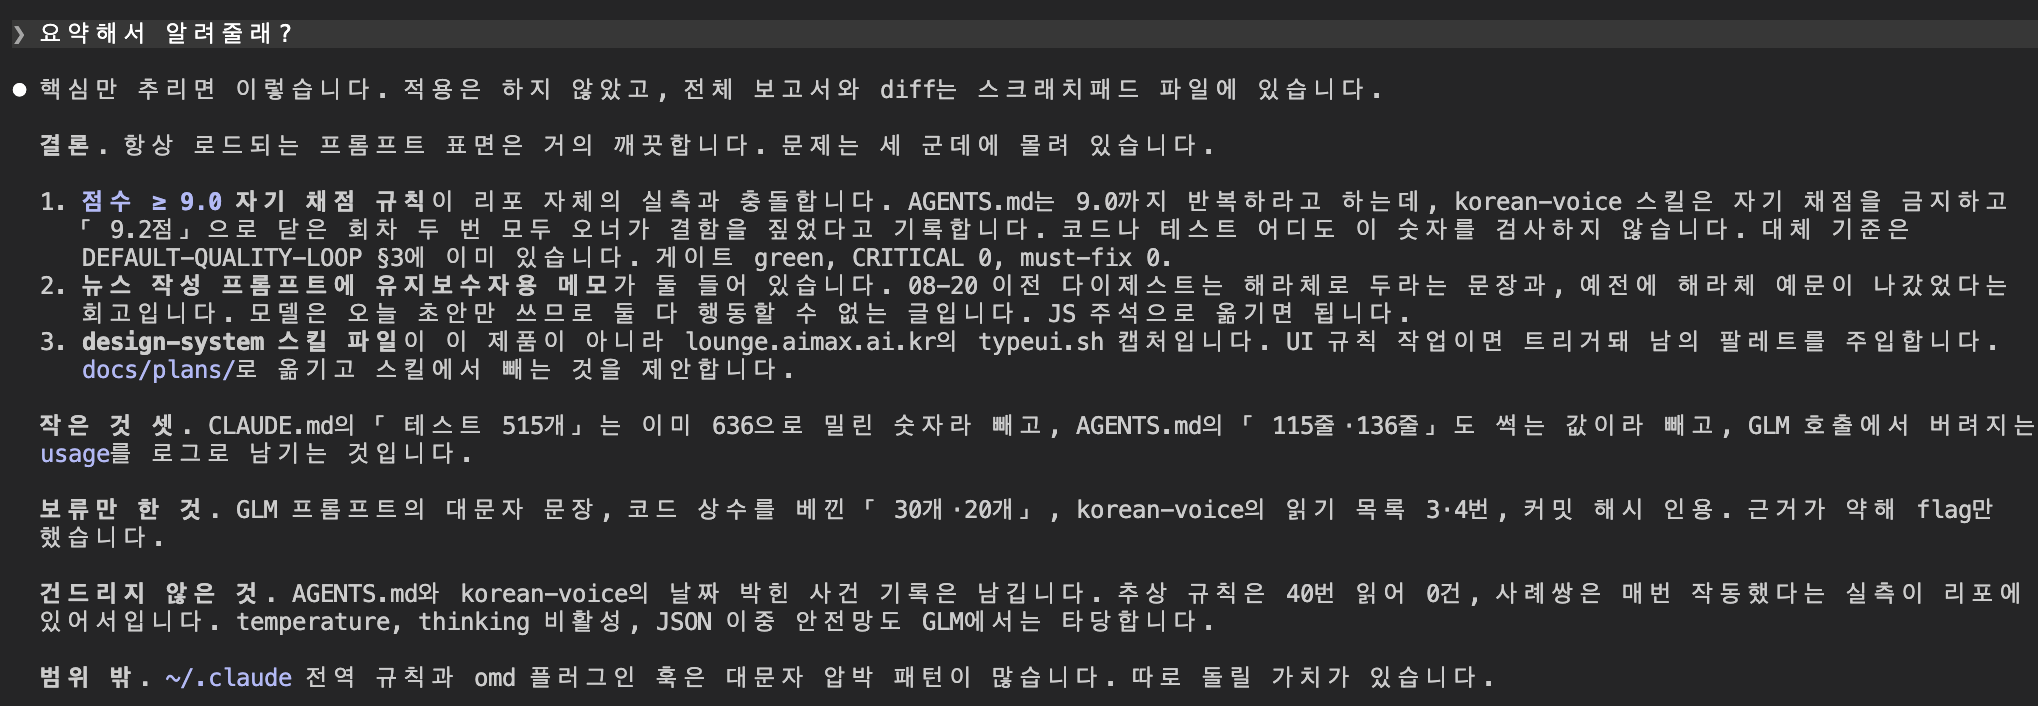
ex) 한참 검사 한 후 다음과 같이 결과를 알려주기 시작하는데 결과 작성된 파일을 한글로 요약해보겠다.
돌려보기 전에 알아둘 것
claude-api라 API 전용처럼 보이지만, API를 안 써도 쓸 이유가 있다. 감사 대상에 프롬프트 텍스트와 스킬 파일이 들어가기 때문이다. 다만 CLAUDE.md 같은 특정 파일까지 자동으로 훑는지는 공식 문서에 명시돼 있지 않으니, 확실히 보게 하려면 범위를 직접 적어주는 편이 낫다.migrate와 managed-agents-onboard만 실려 있다. prompt-audit은 비용 최적화 가이드와 스킬 소스에 나온다. 목록에 없다고 안 되는 건 아니다.모델을 옮기는 중이라면 감사만 따로 돌리는 대신 마이그레이션 명령을 쓰는 방법도 있다. 범위를 미리 적어주면 되묻는 단계를 건너뛴다.
> /claude-api migrate this project to claude-fable-5-1
> /claude-api migrate everything under src/ to claude-fable-5-1
이쪽은 모델 ID 교체부터 temperature 제거, 베타 헤더 정리, effort 시작값 추천, 거절 처리와 fallback 설정까지 한 번에 손본다. 앞서 5장에서 본 항목들이 대부분 여기 들어 있다. 작업이 끝나면 사람이 직접 확인해야 할 항목을 체크리스트로 남긴다.
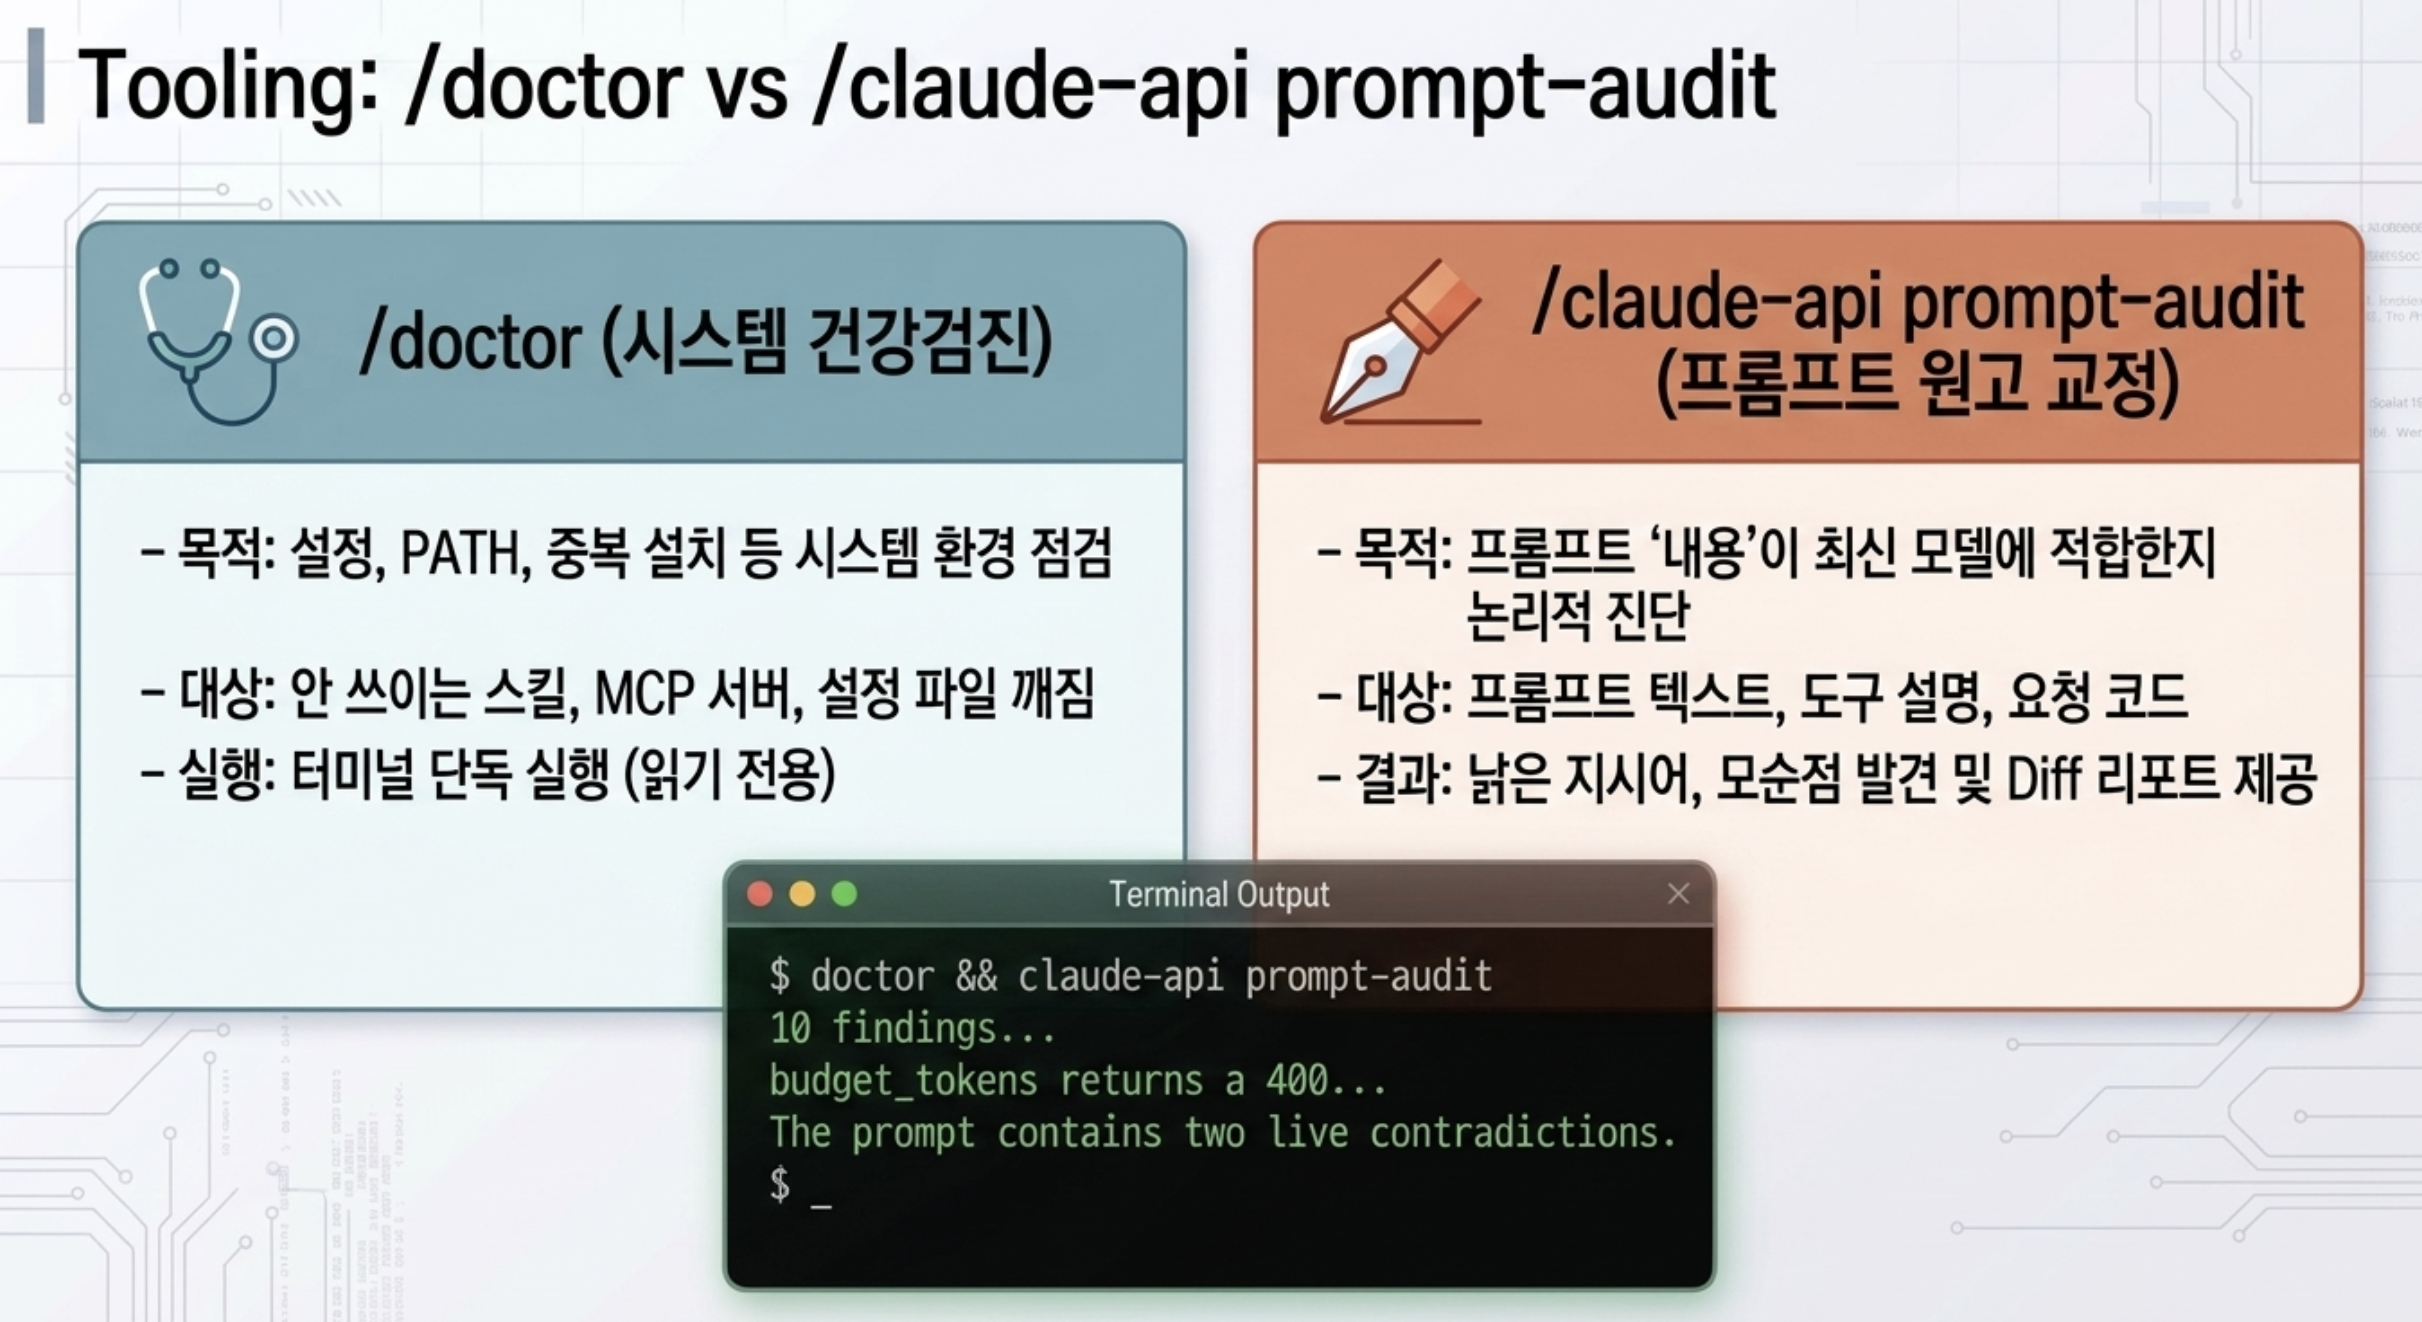
이미 /doctor(별칭 /checkup)를 돌리고 있다면 겹친다고 느낄 수 있다. 실제로 일부 겹친다. /doctor도 CLAUDE.md에서 굳이 안 적어도 되는 설명을 지우자고 제안하기 때문이다.
다만 보는 각도가 다르다. /doctor는 “설정이 깨졌거나 안 쓰이는가”를 본다. 중복 설치, PATH, 파싱 안 되는 설정 파일, 안 쓰는 스킬과 MCP 서버, 중복된 메모리 파일 쪽이다. 반면 prompt-audit은 “내용이 지금 모델에 맞는가”를 본다. 문장도 설정도 멀쩡한데 그 지시가 낡았다는 걸 짚는 쪽이다.
쉽게 갈라 보면 /doctor는 건강검진, prompt-audit은 원고 교정에 가깝다. 실행 위치도 다르다. 터미널에서 그냥 claude doctor를 치면 읽기 전용 점검만 하고, 세션 안에서 /doctor를 부르면 수정까지 제안한다. 모델을 갈아탈 때는 둘 다 한 번씩 돌려보는 편이 낫다.
"API 가격이 내려갔으니 웹이나 클로드 코드 구독 한도도 넉넉해지겠지?"라고 생각하기 쉬운데, 실상은 조금 다르다.
구독 플랜은 토큰 청구서 대신 '사용 한도(Allowance)'로 계산되는데, Fable은 다른 모델보다 이 한도를 훨씬 빨리 깎아 먹는다.
공식 도움말 기준으로 Max·Premium Team·Premium Enterprise 플랜은 Fable 5/5.1이 포함되지만 주간 한도의 50%까지만 추가 비용 없이 쓸 수 있고, Pro와 Standard Team은 usage credits로만, Free 플랜에서는 아예 쓸 수 없다.
클로드 코드를 터미널에서 업데이트한 뒤 모델부터 확인해보자.
claude --version
claude update
claude --model fable
클로드 코드에서 체감이 가장 빠른 변화는 벤치마크가 아니라 거절 빈도다.
앤스로픽 발표문은 사이버보안 안전장치가 멀쩡한 요청을 잘못 차단하는 비율(false positive)을 이전보다 60% 줄였다고 적는다. 개입 횟수 자체가 60% 줄었다는 말이 아니라, 막지 않아도 될 것을 막던 경우가 그만큼 줄었다는 뜻이다. 배경에는 이제 모델이 소프트웨어 취약점을 찾는 작업 자체는 허용된다는 변화가 있다.
생물학·의학 쪽 기본 질문에서도 대체 모델로 넘기는 비율을 최근 85%가량 줄였다고 밝혔다.
다만 익스플로잇 개발은 여전히 거절 대상이다.
보안 코드를 자주 만지다 자꾸 막혔던 경우라면 이 항목이 성능 지표보다 먼저 와닿을 수 있다.
참고로 거절돼서 다른 모델로 재라우팅된 요청은 Fable 요금으로 청구되지 않는다.
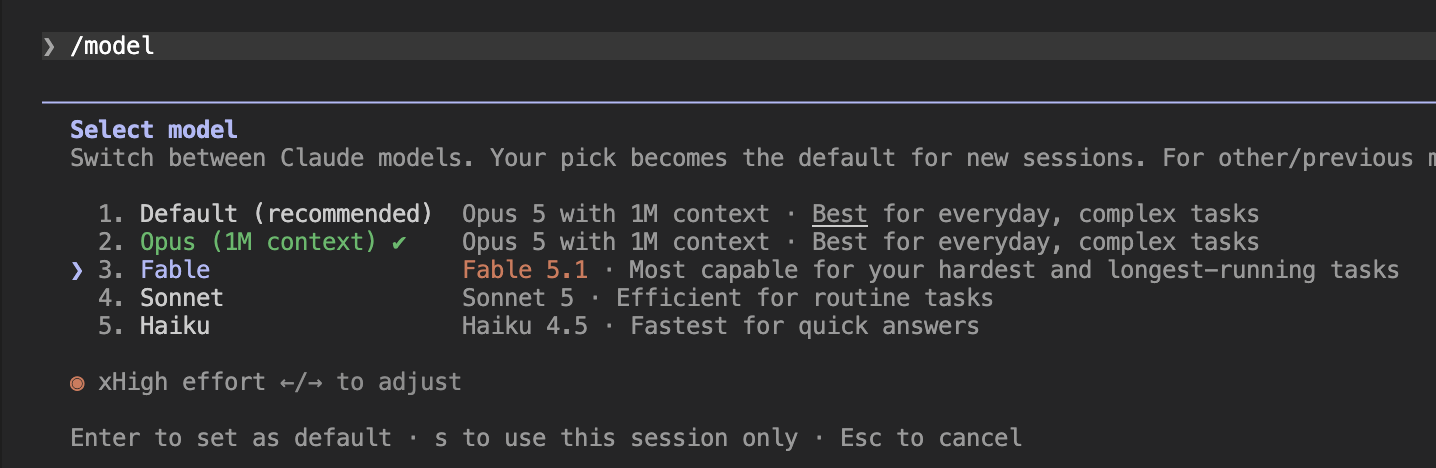
버전은 2.1.250부터 Fable 5.1을 고를 수 있고, 2.1.257 이상이면 기본 Fable 모델이라 fable 별칭이 5.1로 연결된다.
다만 사내 gateway를 거치는 세션은 당분간 Fable 5로 남아 있어서 /model에서 직접 골라야 한다.
업데이트 후 /usage를 치면 캐시가 얼마나 잘 먹고 있는지(Hit/Miss)를 터미널에서 바로 볼 수 있다(2.1.251 이상에서 Session 블록에 Prompt cache (main) 줄이 붙는다).
먼저 데이터 보존 조건이다.
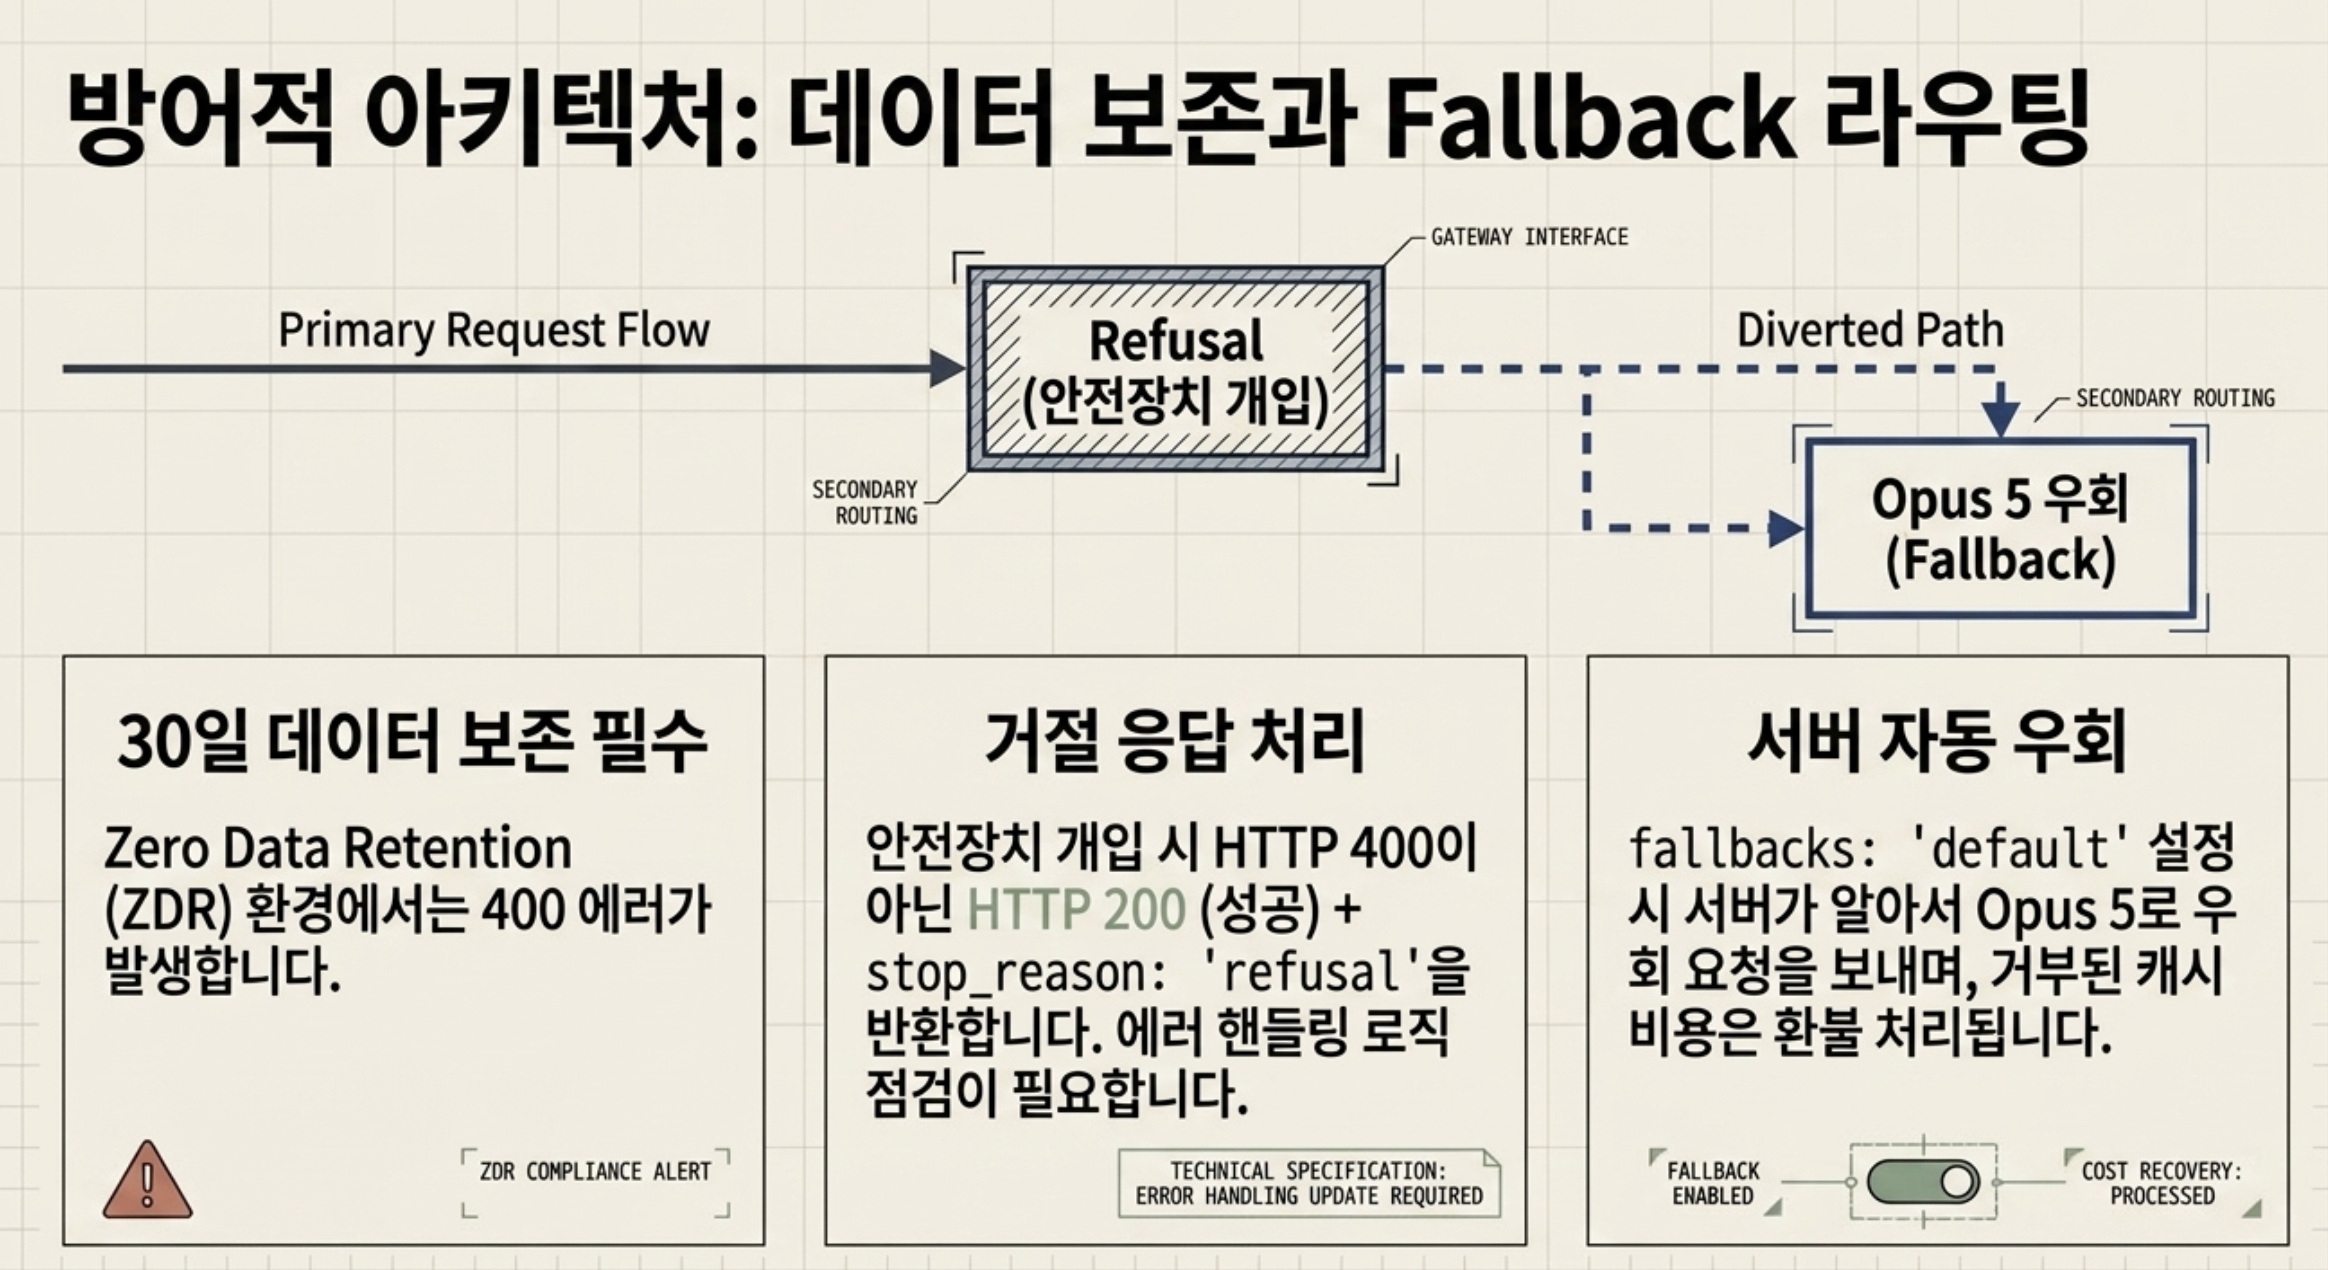
공식 마이그레이션 문서는 Fable 5.1과 Mythos 5.1 모두 30일 데이터 보존이 필요하고, Anthropic이 따로 승인하지 않는 한 zero data retention(ZDR) 환경에서는 쓸 수 없다고 못 박는다.
30일 보존이 설정되지 않은 조직이나 워크스페이스에서 요청하면 400 에러가 돌아온다.
고객 소유 클라우드에 데이터를 두는 Enterprise Frontier Safeguards(EFS)는 올가을부터 단계적으로 열릴 예정이다.
회사 계정이 어디에 해당하는지는 문서보다 계정 담당자에게 물어보는 게 빠르다.
안전장치가 작동해서 답변을 거부하면 API는 HTTP 에러가 아니라 HTTP 200(성공)을 돌려주면서 본문에 stop_reason: "refusal"을 넣는다. 상태 코드(Status Code)만 보는 기존 코드는 이 거부 응답을 놓치고 로직이 꼬일 수 있다.
거부된 요청은 보통 다른 Claude 모델로 다시 보내면 처리되는데, 베타 헤더 server-side-fallback-2026-07-01과 fallbacks: "default"를 쓰면 서버가 알아서 대체 모델로 넘긴다. Fable 5.1의 허용 대체 모델은 Opus 4.8과 Opus 5다.
비용도 챙겨두면 좋다. 출력이 시작되기 전에 거부된 요청은 아예 과금되지 않고, Fable 5.1은 fallback credit으로 모델을 바꾸느라 다시 치른 프롬프트 캐시 비용을 돌려준다. 대체 전환을 걸어두는 것이 비용 면에서도 손해가 아니라는 뜻이다.
하나 더. Fable 5.1과 Mythos 5.1이 생성한 텍스트에는 모든 플랫폼에서 앤스로픽의 통계적 워터마크(Statistical Watermark)가 들어가고, 코드 실행 도구 등으로 만든 이미지·영상 파일은 Files API로 받을 때 C2PA 콘텐츠 출처 증명이 서명된다. 워터마크는 토큰이나 숨은 문자를 추가하지 않고 출력의 의미나 품질도 바꾸지 않는다는 게 공식 설명이다.
공식 문서는 Fable 5.1을 무작정 메인으로 쓰지 말라고 꽤 보수적으로 안내한다.
짧은 코드 작성이나 간단한 설명은 Opus 5부터 시작하고, 높은 연산 강도에서도 결과가 부족하거나 여러 파일을 오가는 장시간 고난도 작업(리팩터링 등)일 때만 Fable 5.1을 비교하라는 쪽이다.
A/B 테스트 권장 순서
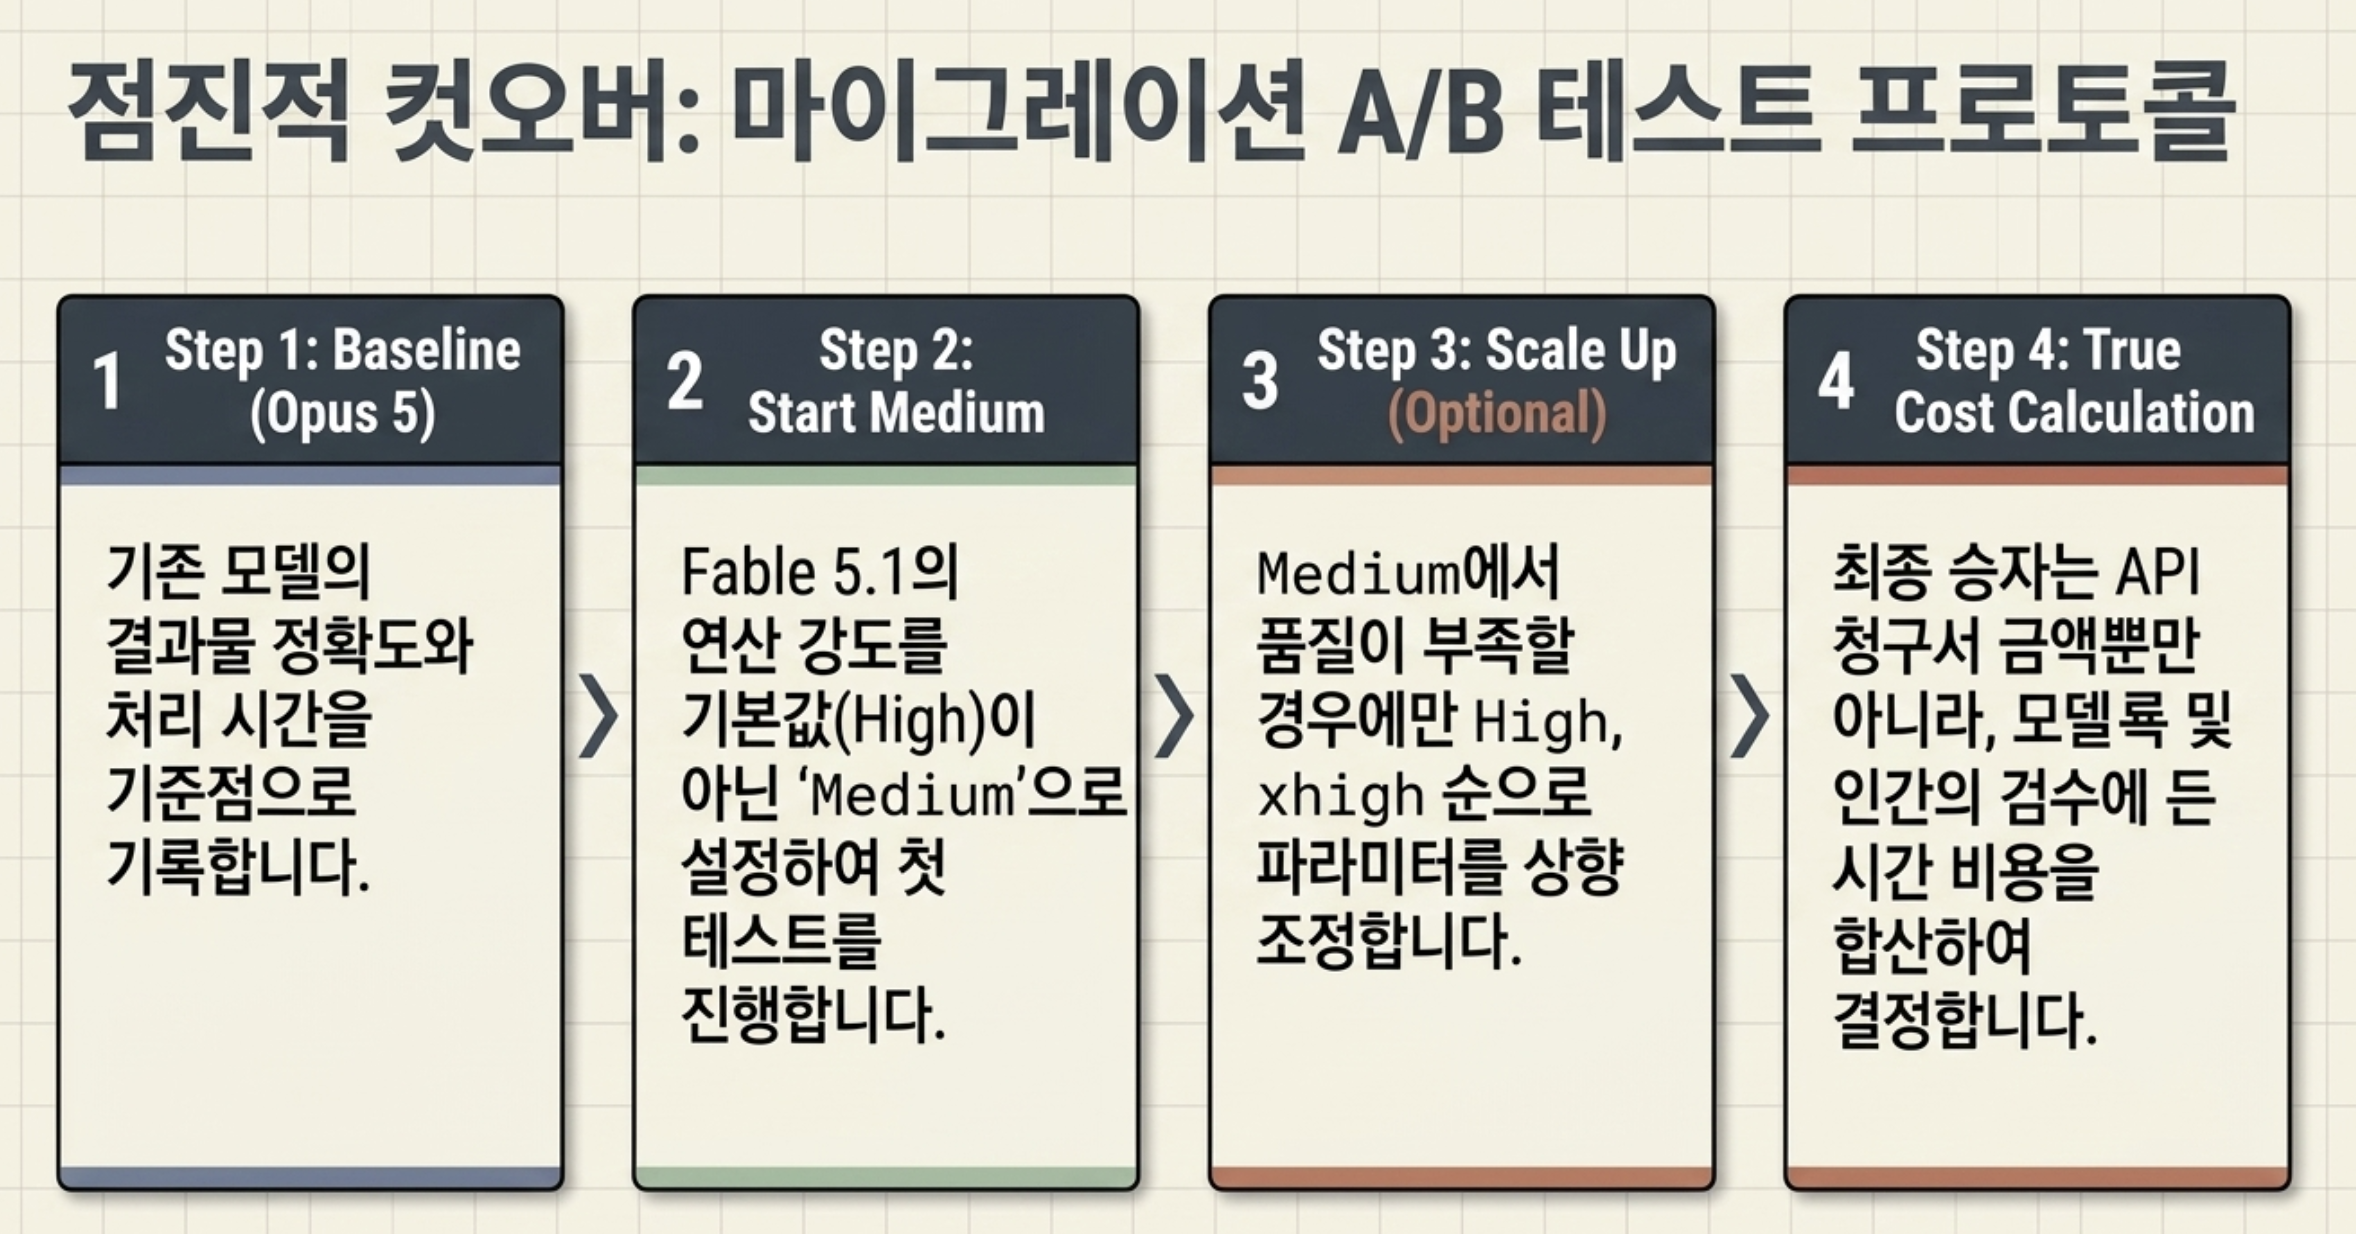
고르는 순서
1단계. 짧은 코드 작성이나 설명인가? → Opus 5부터 돌려본다
▼
2단계. Opus 5를 높은 effort로 올려도 결과가 부족한가?
▼
3단계. 여러 파일을 오가는 장시간 작업인가? → Fable 5.1을 medium부터 비교한다
▼
4단계. API 요금뿐 아니라 롤백과 검수에 든 사람 시간까지 합쳐 비교한다
이 글을 쓰는 사이에 상황이 하나 바뀌었다.
Fable 5.1이 9월 1일에 나왔는데, 이틀 뒤인 9월 3일에 OpenAI가 GPT-6 Astra를 냈다.
그래서 지금 모델을 고르는 사람은 자연스럽게 둘을 같이 놓고 보게 된다.
먼저 짚어둘 것이 있다. 두 회사 모두 상대 모델을 자사 발표 자료에서 비교 대상으로 삼지 않았다.
그래서 아래 비교는 각자 공개한 숫자를 제3자가 나란히 놓은 것이고, 같은 조건에서 잰 값이 아니다.
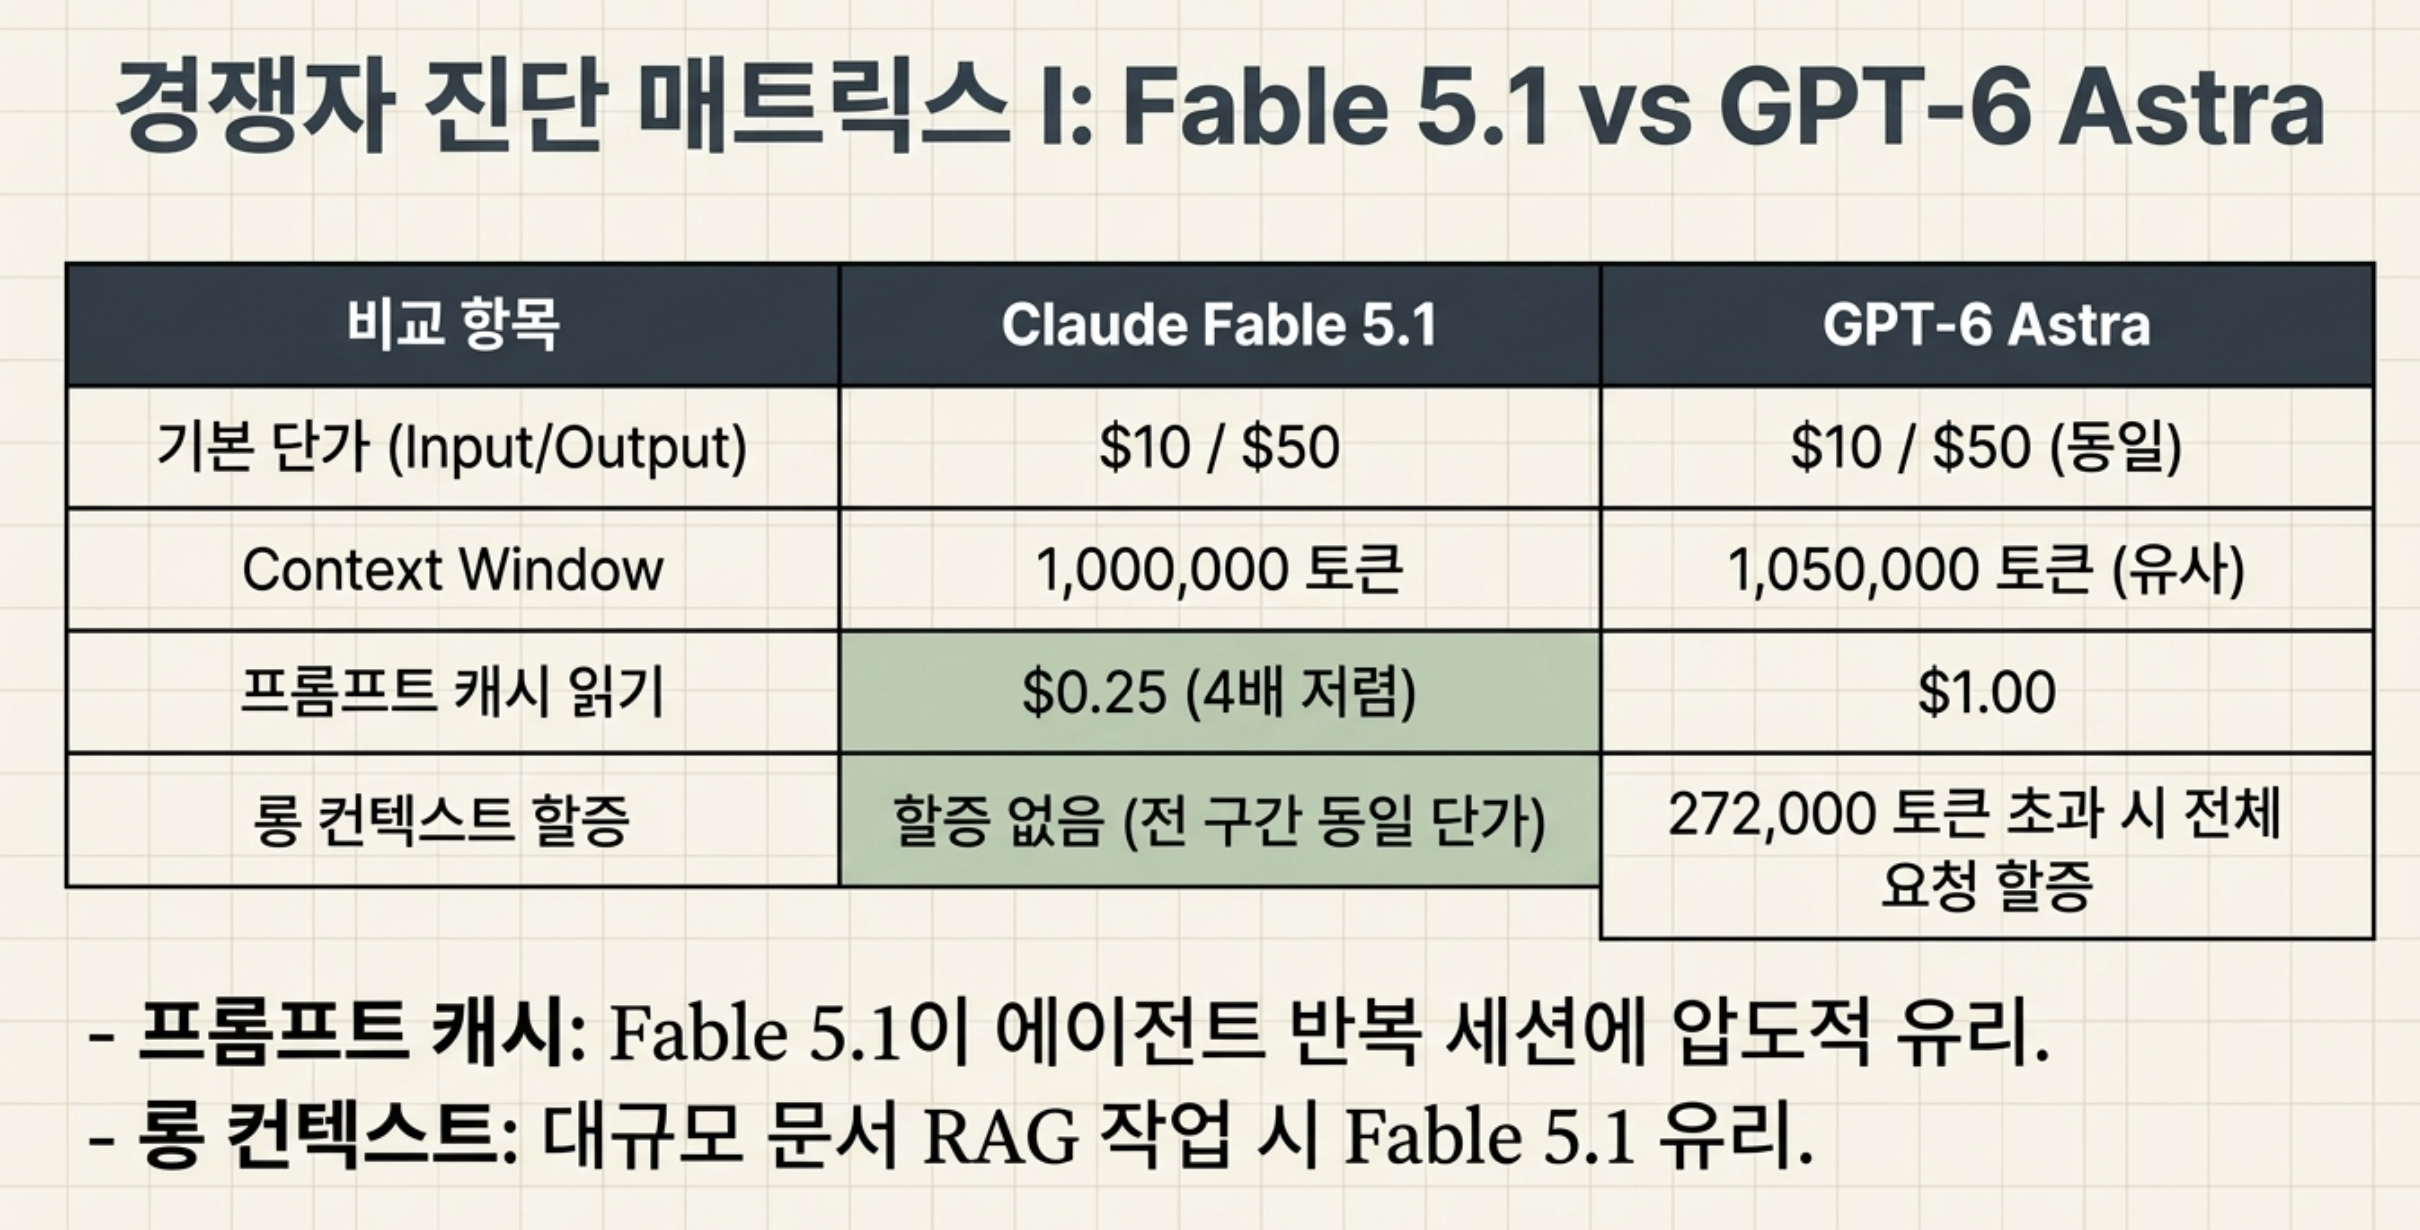
가격표를 나란히 놓으면 재미있는 그림이 나온다.
| 항목 | Claude Fable 5.1 | GPT-6 Astra |
|---|---|---|
| 기본 입력 / 출력 | $10 / $50 | $10 / $50 (동일) |
| 캐시 읽기 | $0.25 | $1.00 (4배) |
| 긴 입력 할증 | 없음 (1M 전 구간 동일 단가) | 272,000 토큰 초과 시 전체 요청에 할증 |
| 컨텍스트 창 | 1,000,000 토큰 | 1,050,000 토큰 |
토큰 단가가 같으니 "비슷하겠네" 싶은데, 캐시 읽기에서 4배가 벌어진다. 3장에서 본 것처럼 에이전트를 오래 돌리면 같은 앞부분을 계속 다시 읽는다. 그 구간의 단가가 4배 차이라면 긴 세션일수록 총액이 크게 갈린다.
반대로 긴 문서를 통째로 넣는 작업이라면 할증 유무가 갈림길이다. Astra는 27만 토큰을 넘기면 초과분만이 아니라 요청 전체에 할증이 붙는다. Fable 5.1은 100만 토큰 전 구간이 같은 단가다.
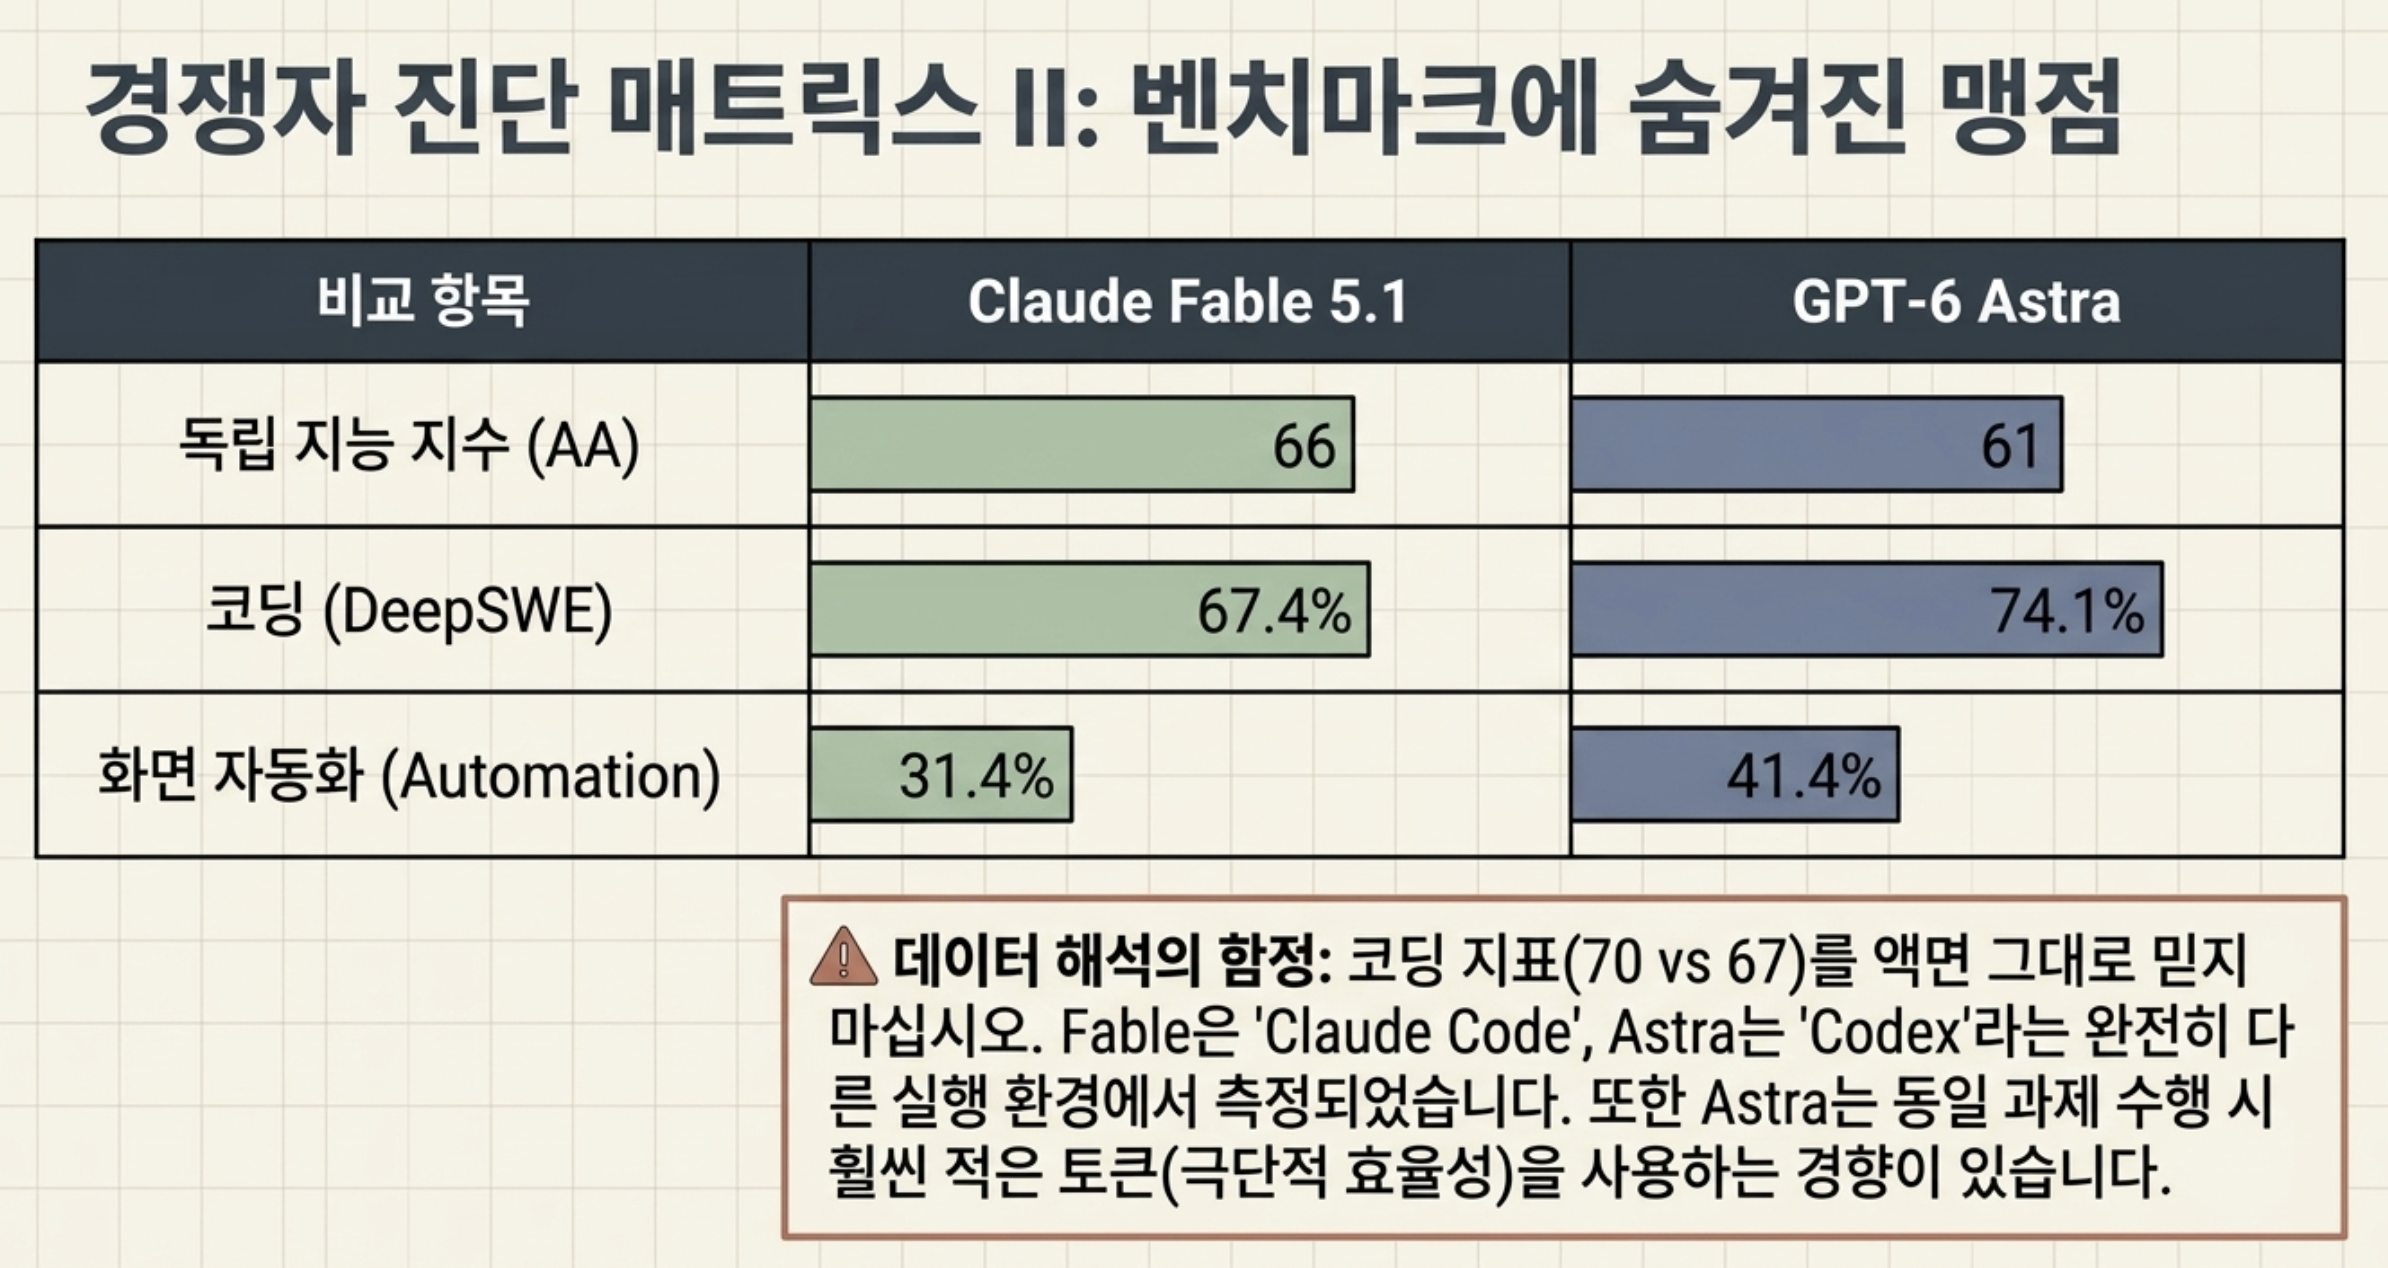
"누가 이겼나"에 한 줄로 답하기 어려운 상황이다. 공개된 숫자를 정리하면 이렇다.
| 평가 | Fable 5.1 | Astra | 누가 잰 값인가 |
|---|---|---|---|
| AA 종합 지능 지수(max) | 66 | 61 | 독립 기관(Artificial Analysis) |
| AA 코딩 에이전트 지수 | 70 (Claude Code) | 67 (Codex) | 독립 기관 — 단, 실행 환경이 다름 |
| Terminal-Bench 4.0 | 55.8% | 57.7% | 각 사 공식 발표 |
| DeepSWE v1.1 | 67.4% | 74.1% | 각 사 공식 발표 |
| AutomationBench | 31.4% | 41.4% | 각 사 공식 발표 |
표를 보면 방향이 보인다.
독립 기관 종합 지표에서는 Fable 5.1이 앞서고, 각 사가 공개한 개별 코딩·자동화 벤치에서는 Astra가 앞선 줄이 많다.
위 66과 61은 두 모델이 출시되던 시점의 Artificial Analysis 지능 지수다. 그런데 이 기관이 9월 4일 지수를 v4.2로 갱신했다. 더 복잡한 과제와 비공개 테스트셋을 넣어 점수 체계 자체가 바뀌었고, 같은 두 모델이 새 기준에서는 57과 55로 표시된다.
둘 다 맞는 값이고 앞뒤 순서도 그대로지만 절대 수치는 다르다. 지금 사이트에 들어갔을 때 66이 안 보인다고 당황할 필요는 없다. 지능 지수를 인용할 때는 어느 버전에서 잰 값인지 같이 적어두는 편이 안전하다.
이 3점 차이는 모델만의 차이가 아니다. Fable 5.1은 Claude Code에서, Astra는 Codex에서 측정됐다. 서로 다른 실행 환경(하네스)을 쓴 결과라서, 점수 차의 일부는 모델이 아니라 그 도구가 만든 것이다. 2장에서 벤치마크 표를 볼 때 "평가에 쓴 도구와 조건부터 같이 보라"고 한 것과 같은 이야기다. 이번에는 그 조건이 아예 다른 회사의 도구다.
한 가지 더 짚을 것이 있다.
Astra는 같은 작업을 훨씬 적은 토큰으로 끝냈다는 측정이 있다.
독립 기관 기준으로 GPT-5.6 Sol의 3분의 1, Claude Opus 5(xhigh)의 5분의 1 수준이었다.
토큰을 덜 쓰는 쪽과 캐시가 싼 쪽이 서로 다른 셈이라, 어느 쪽이 유리한지는 내 작업이 출력을 많이 뽑는 쪽인지, 같은 문맥을 반복해서 읽는 쪽인지에 달려 있다.
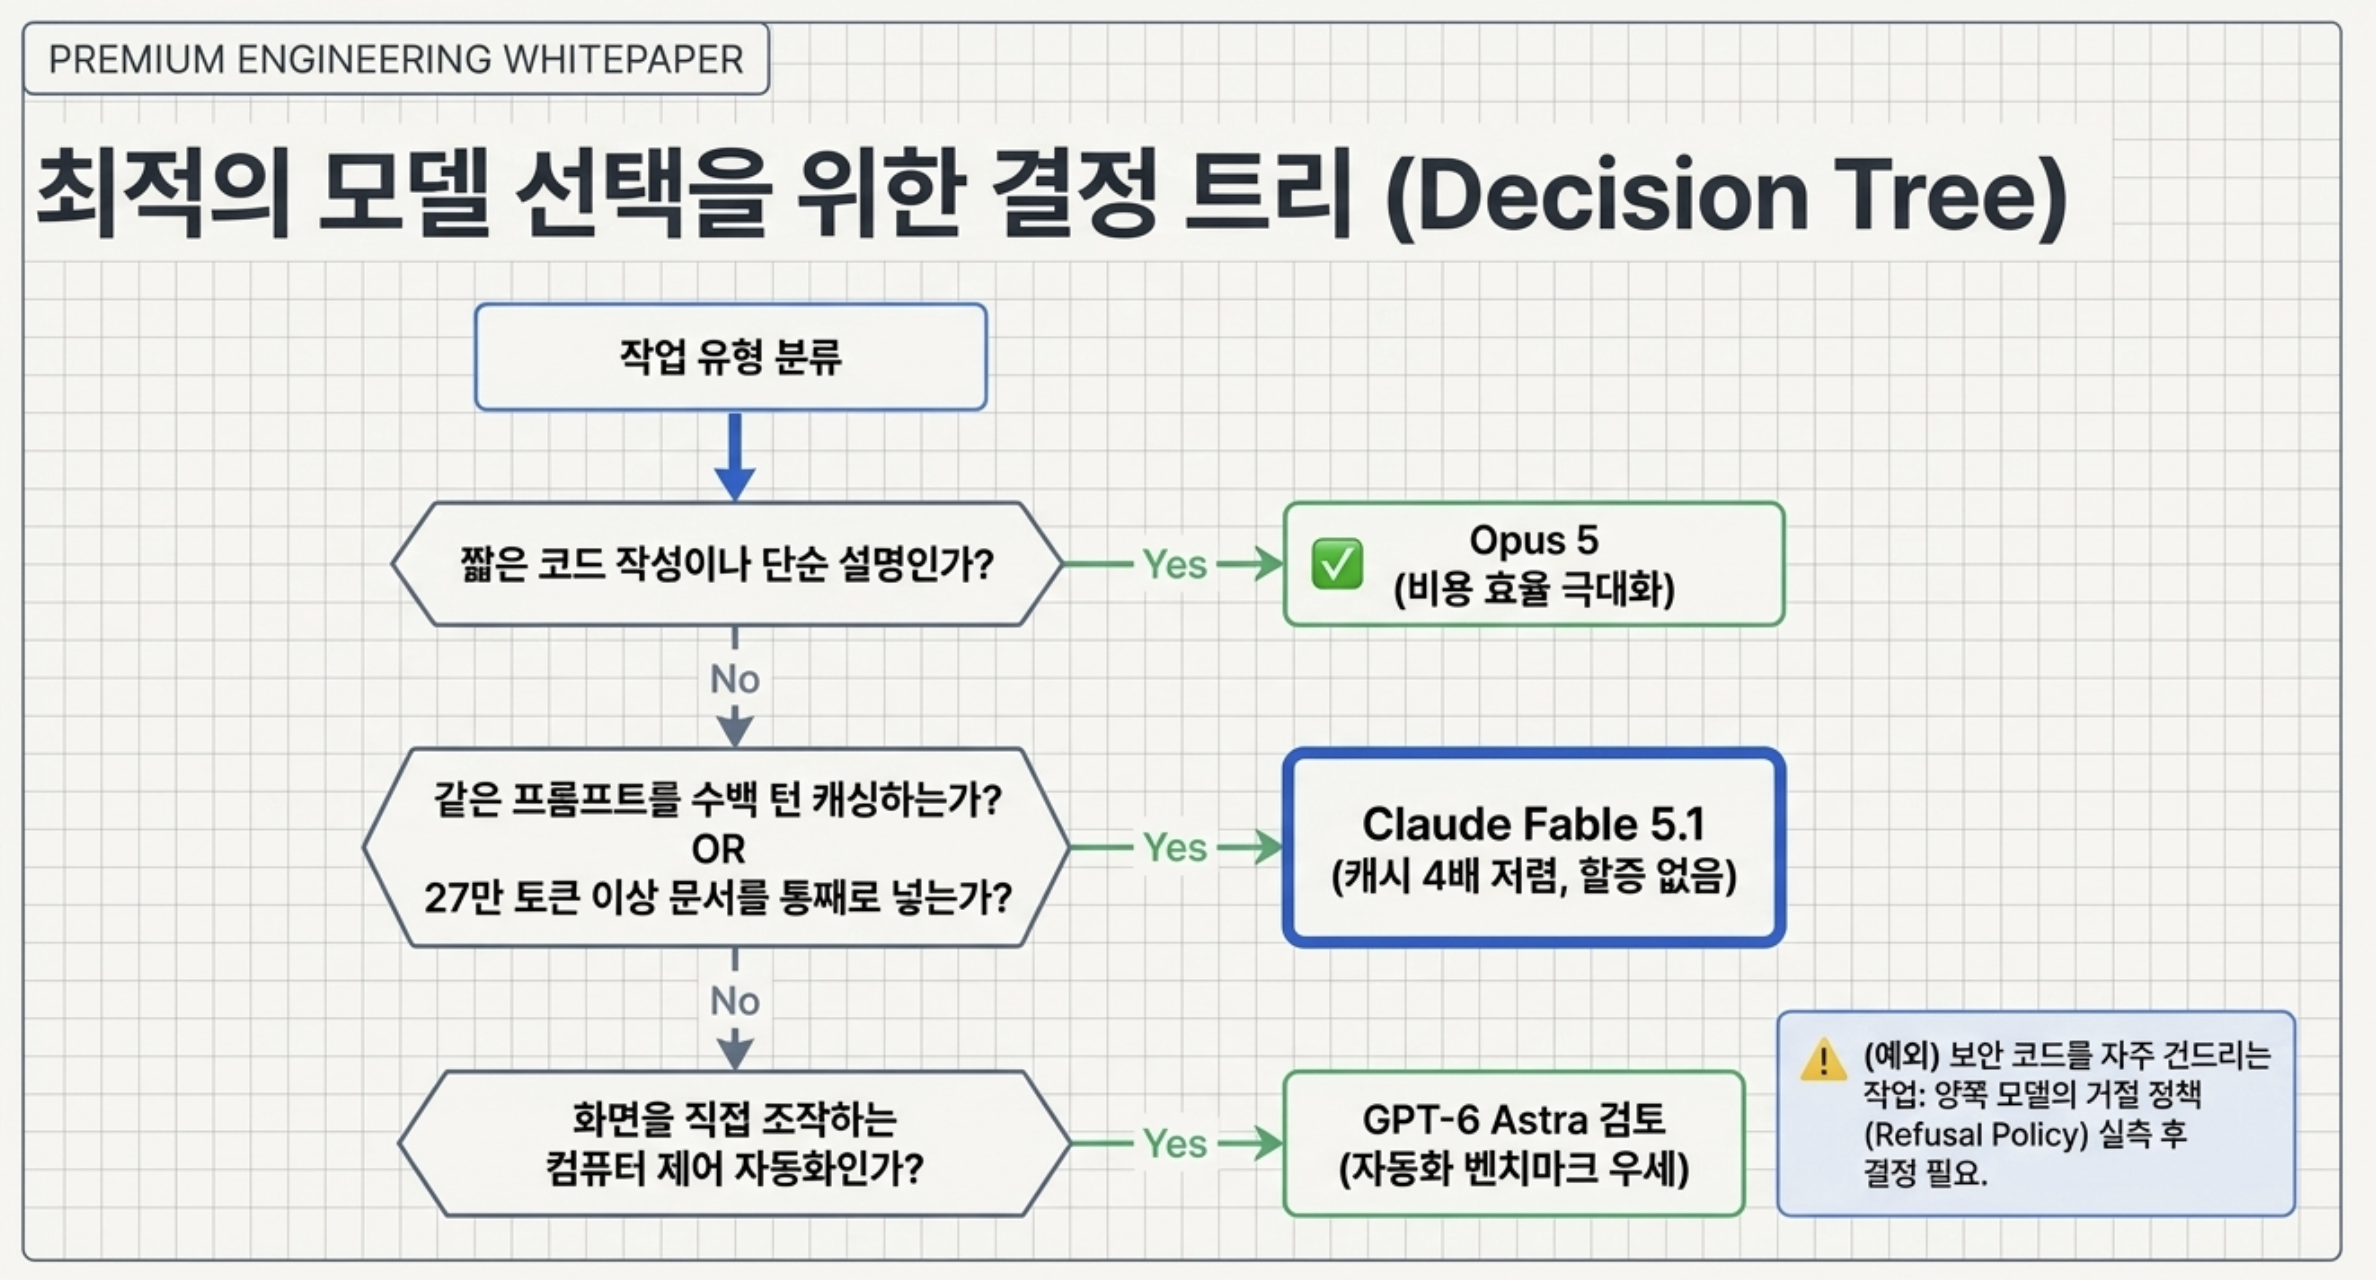
지금까지 나온 자료를 작업 형태 기준으로 정리하면 이렇게 갈린다.
| 작업 형태 | 먼저 볼 모델 | 이유 |
|---|---|---|
| 같은 코드베이스를 수백 턴 돌리는 코딩 에이전트 | Fable 5.1 | 캐시 읽기 4배 차이가 턴마다 누적된다 |
| 27만 토큰 넘는 긴 문서를 통째로 넣는 작업 | Fable 5.1 | Astra는 요청 전체에 할증이 붙는다 |
| RAG처럼 같은 시스템 프롬프트를 계속 재사용 | Fable 5.1 | 캐시 재사용 비중이 큰 구조 |
| 화면을 직접 조작하는 자동화 | Astra 검토 | 컴퓨터 조작·자동화 벤치에서 앞선 줄이 많다 |
| 보안 코드를 자주 건드리는 작업 | 양쪽 다 실측 필요 | 거절 정책이 서로 달라 체감 차가 크다 |
| 일반 대화·문서 작업 | 차이 작음 | 다른 조건(구독·사내 정책)으로 정하는 편이 낫다 |
이 표는 공개된 자료로 만든 출발점이지 순위표가 아니다. 8장에서 말한 A/B 테스트를 여기에도 그대로 적용하면 된다. 대표 작업 하나를 골라 양쪽에서 돌리고 총비용과 사람이 손댄 시간을 기록하는 쪽이, 이 표를 열 번 읽는 것보다 정확하다.
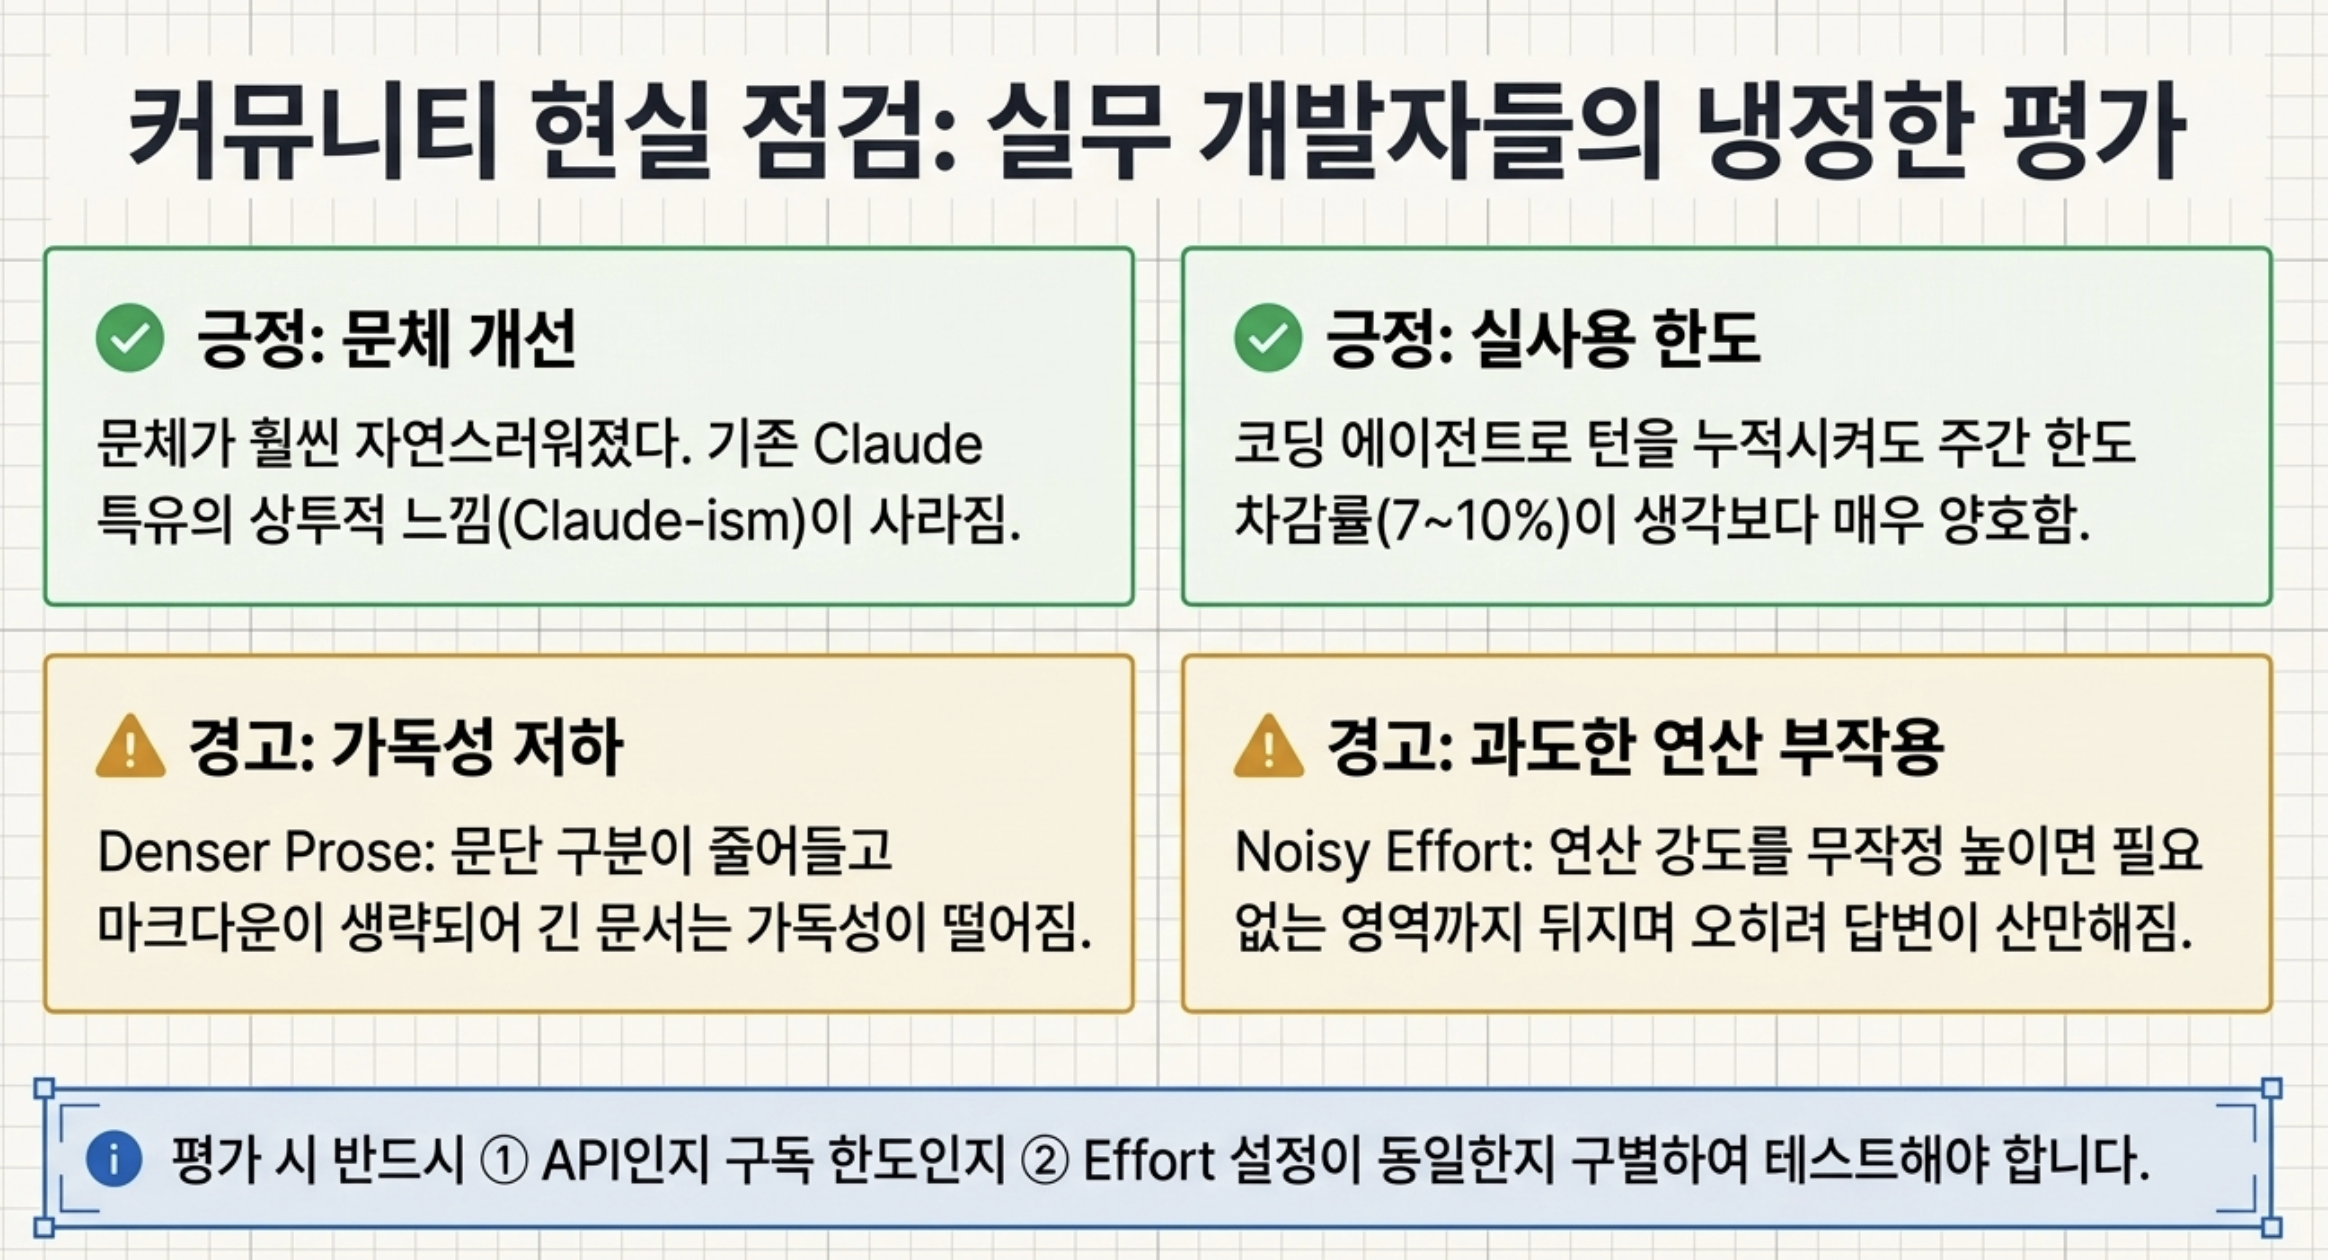
해커뉴스(Hacker News)와 레딧(Reddit) 쪽 초기 반응은 장단점이 꽤 뚜렷하게 갈린다.
문체가 자연스러워졌다는 평가
해커뉴스 최상단 댓글은 Anthropic 직원이 남긴 "벤치마크보다 문체 개선이 크다, 다른 Claude 모델 같은 상투적 느낌이 훨씬 줄었고 스타일 지시를 더 잘 따른다"는 글이었다. 코드 리뷰 코멘트나 문서 초안을 뽑아 쓰는 쪽에서는 체감할 만한 부분이다.
빽빽해진 문장과 마크다운 축소
반대로 같은 스레드에서 가장 길게 이어진 논쟁은 "Claude-ism"이라 불리는 빽빽하고 난해한 문장이었다. 긴 세션의 인수인계 문서를 원어민도 이해하기 어렵다는 불만이 여럿 달렸다. 공식 문서도 단락 구분이 줄고(Denser Prose) 마크다운 서식을 덜 쓰며 요약할 때 원문을 인용 표시 없이 옮기는 경향을 인정하고, 프롬프트로 조정하는 방법을 안내한다.
연산 강도 부작용 및 한도 고갈
성능을 올리려고 강도를 높이면 모델이 필요 없는 영역까지 샅샅이 뒤지고 장황하게 설명하려 들어 결과가 산만해진다(Noisy)는 이야기가 있다. 긴 문맥을 주고받다 보면 클로드 웹 구독 한도가 몇 시간 만에 바닥난다는 우려도 많다.
해커뉴스 출시 스레드 (2026년 9월 2일 기준)
1,370포인트 · 댓글 1,321개. 이 스레드의 축은 최상단에 달린 앤스로픽 직원 댓글과, 바로 아래 붙은 반박이다.
벤치마크보다 문체 개선이 더 크다는 평가. 다른 클로드 모델 특유의 상투적인 느낌이 줄었고 스타일 지시를 더 잘 따른다는 이야기였다.
바로 아래에는 긴 세션에서 나온 인수인계 문서를 원어민도 이해하기 어렵다는 반박이 이어졌다. 앞서 본 ‘빽빽해진 문장’ 문제와 같은 지점이다.
원문: Hacker News 스레드
해외 반응만 보면 감이 잘 안 오니 한국어권도 찾아봤다. 출시 직후라 장문 후기는 드물었지만, 직접 재본 기록이 하나 있었다.
클로드 갤러리에 올라온 글인데 방식이 깔끔하다. 같은 작업을 새 세션에서 페이블 5 high와 페이블 5.1 high로 각각 돌려 주간 한도가 얼마나 깎이는지 비교했다. 결과는 5가 10%, 5.1이 7%였고, 결과물은 5.1이 조금 더 나았다고 적었다.
이 수치가 흥미로운 이유는 공식 발표와 방향이 맞기 때문이다. 앤스로픽은 페이블 5를 100으로 뒀을 때 실사용 비용 지수가 일반 작업 75, 에이전트 작업 55라고 밝혔다. 10%에서 7%로 줄었다면 지수로는 70 근처다. 표본 한 명의 한 번 측정이라 일반화할 수는 없지만, 공식 수치와 크게 어긋나지 않는다는 점은 참고할 만하다.
반면 같은 갤러리의 다른 글은 평가가 갈렸다. 보안 관련 거절이 줄어든 정도는 초기 페이블 5가 제일 나았고, 성능은 초기 페이블 5가 앞서며, 토큰 효율만 5.1이 낫다는 식으로 항목별로 순위를 다르게 매겼다. "초기 페이블 5"를 기준으로 삼는다는 점이 눈에 띄는데, 같은 모델도 운영 중에 안전장치 조정이 들어가면 체감이 달라진다는 이야기로 읽힌다.
국내 매체 쪽에서는 요즘IT가 캐시 인하를 다루면서도 절대 단가는 여전히 비싸다는 점을 같이 짚었다. GPT-5.6 Sol이 프로모션가로 4달러/20달러, 제미나이 3.7 Flash가 0.75달러/3.75달러인데 페이블은 10달러/50달러라는 비교였다. 캐시가 4분의 1이 됐다는 이야기와, 그래도 비싼 축이라는 이야기는 같이 봐야 한다.
"토큰을 덜 먹는다"와 "한도가 금방 닳는다"가 같이 보이면 대개 재는 대상이 다르다. 세 가지만 구분하면 정리된다. ① 같은 effort로 맞춰 비교했는가, ② API 청구서인가 구독 한도인가, ③ 병렬 에이전트를 썼는가. 이 셋을 밝히지 않은 후기는 방향만 참고하고, 판단은 자기 로그로 하는 편이 낫다.
여기까지 읽고 바로 해볼 수 있는 것만 추렸다. 이 글에서 확인한 범위 안에 있는 것들이다.
오늘 확인할 것 (5분)
claude --version으로 버전부터 본다. 2.1.250 이상이면 선택할 수 있고, 2.1.257 이상이면 fable 별칭이 5.1로 붙는다.tool_choice가 any나 tool로 박혀 있는지 검색한다. 모델 ID만 바꾸면 바로 400이 난다.이번 주에 판단할 것
/claude-api prompt-audit를 한 번 돌려서 낡은 지시가 쌓여 있는지 본다. 이미 /doctor를 쓰고 있어도 보는 각도가 달라서 겹치지 않는 부분이 나온다.display: "updates"를 켜고 화면이 조용해지지 않는지 확인한다.
기록할 항목은 다섯 개면 충분하다. 환경(모델·effort·도구), 결과 정확성, 실제로 완료한 상태, 사람이 검토·수정한 시간, 그리고 총비용이다. 이 다섯 개를 남겨두면 다음 모델이 나왔을 때 비교 기준이 이미 준비돼 있다.
아니다. '캐시를 꺼내 읽는 비용'만 75% 싸졌다. 기본 입출력 단가는 그대로고, 연산 강도를 올려 답변(출력)이 길어지면 오히려 돈이 더 나간다.
경우에 따라 다르다. 2.1.250부터 목록에서 고를 수 있고, 2.1.257 이상에서는 Fable 5.1이 기본 Fable 모델이라 fable 별칭이 5.1로 연결된다. 다만 사내 gateway를 거치는 세션은 gateway 설정이 따라올 때까지 Fable 5로 남아 있으니 /model에서 직접 골라야 하고, 어느 쪽이든 현재 모델은 /model로 한 번 확인하는 편이 안전하다.
작업 형태로 갈린다. 같은 코드베이스를 수백 턴 돌리는 에이전트, 27만 토큰이 넘는 긴 문서, RAG처럼 같은 프롬프트를 재사용하는 구조라면 캐시 읽기가 4배 싼 Fable 5.1이 유리하다. 반대로 화면을 직접 조작하는 자동화는 Astra가 앞선 벤치가 많다. 일반 대화나 문서 작업은 차이가 작아서 구독 조건이나 사내 정책으로 정하는 편이 낫다. 자세한 비교는 9장에 있다.
보는 각도가 다르니 둘 다 돌리는 편이 낫다. /doctor는 설치와 설정이 깨졌거나 안 쓰이는지를 보고, /claude-api prompt-audit은 프롬프트 내용이 지금 모델에 맞는지를 본다. 문장도 설정도 멀쩡한데 지시가 낡은 경우는 /doctor가 잡아주지 않는다. 5장에 실행 방법과 예상 결과를 정리해뒀다.
아니다. 요금제가 아니라 승인 문제다. 프로젝트 글래스윙 같은 신뢰 접근 프로그램을 통과한 조직만 쓸 수 있고, 사이버 방어나 생명과학 목적이 전제다. 성능이 더 좋은 상위 모델이 아니라 같은 모델에 안전장치를 덜 씌운 버전이라는 점도 같이 봐야 한다.
캐시 읽기 비용 인하와 5단계 연산 강도 조절은 분명 쓸모 있는 변화다.
다만 파라미터 수정 불가, 출력 토큰 증가, 파일 전체를 다시 쓰는 성향처럼 구조적으로 달라진 부분도 많다.
기존 프로젝트를 한 번에 갈아타기보다, 정답이 확실한 작은 리팩터링 과제에서 강도를 medium부터 천천히 올려보며 A/B 테스트를 해보는 편이 낫다.
모델 ID를 바꾸는 김에 프롬프트도 같이 손보길 권한다.
예전 모델용으로 넣어둔 “두 번 확인하라” 같은 지시가 새 모델에서는 토큰만 더 쓰게 만든다. 측정된 사례에서는 이걸 걷어내는 것만으로 비용이 내려가고 정확도가 올랐다.
감사합니다. : )
소중한 공감 감사합니다