새소식
300x250
안녕하세요! 갓대희 입니다.
이번 포스팅은 [ Jev 완전 정리와 실전 활용 튜토리얼 ] 입니다. : )
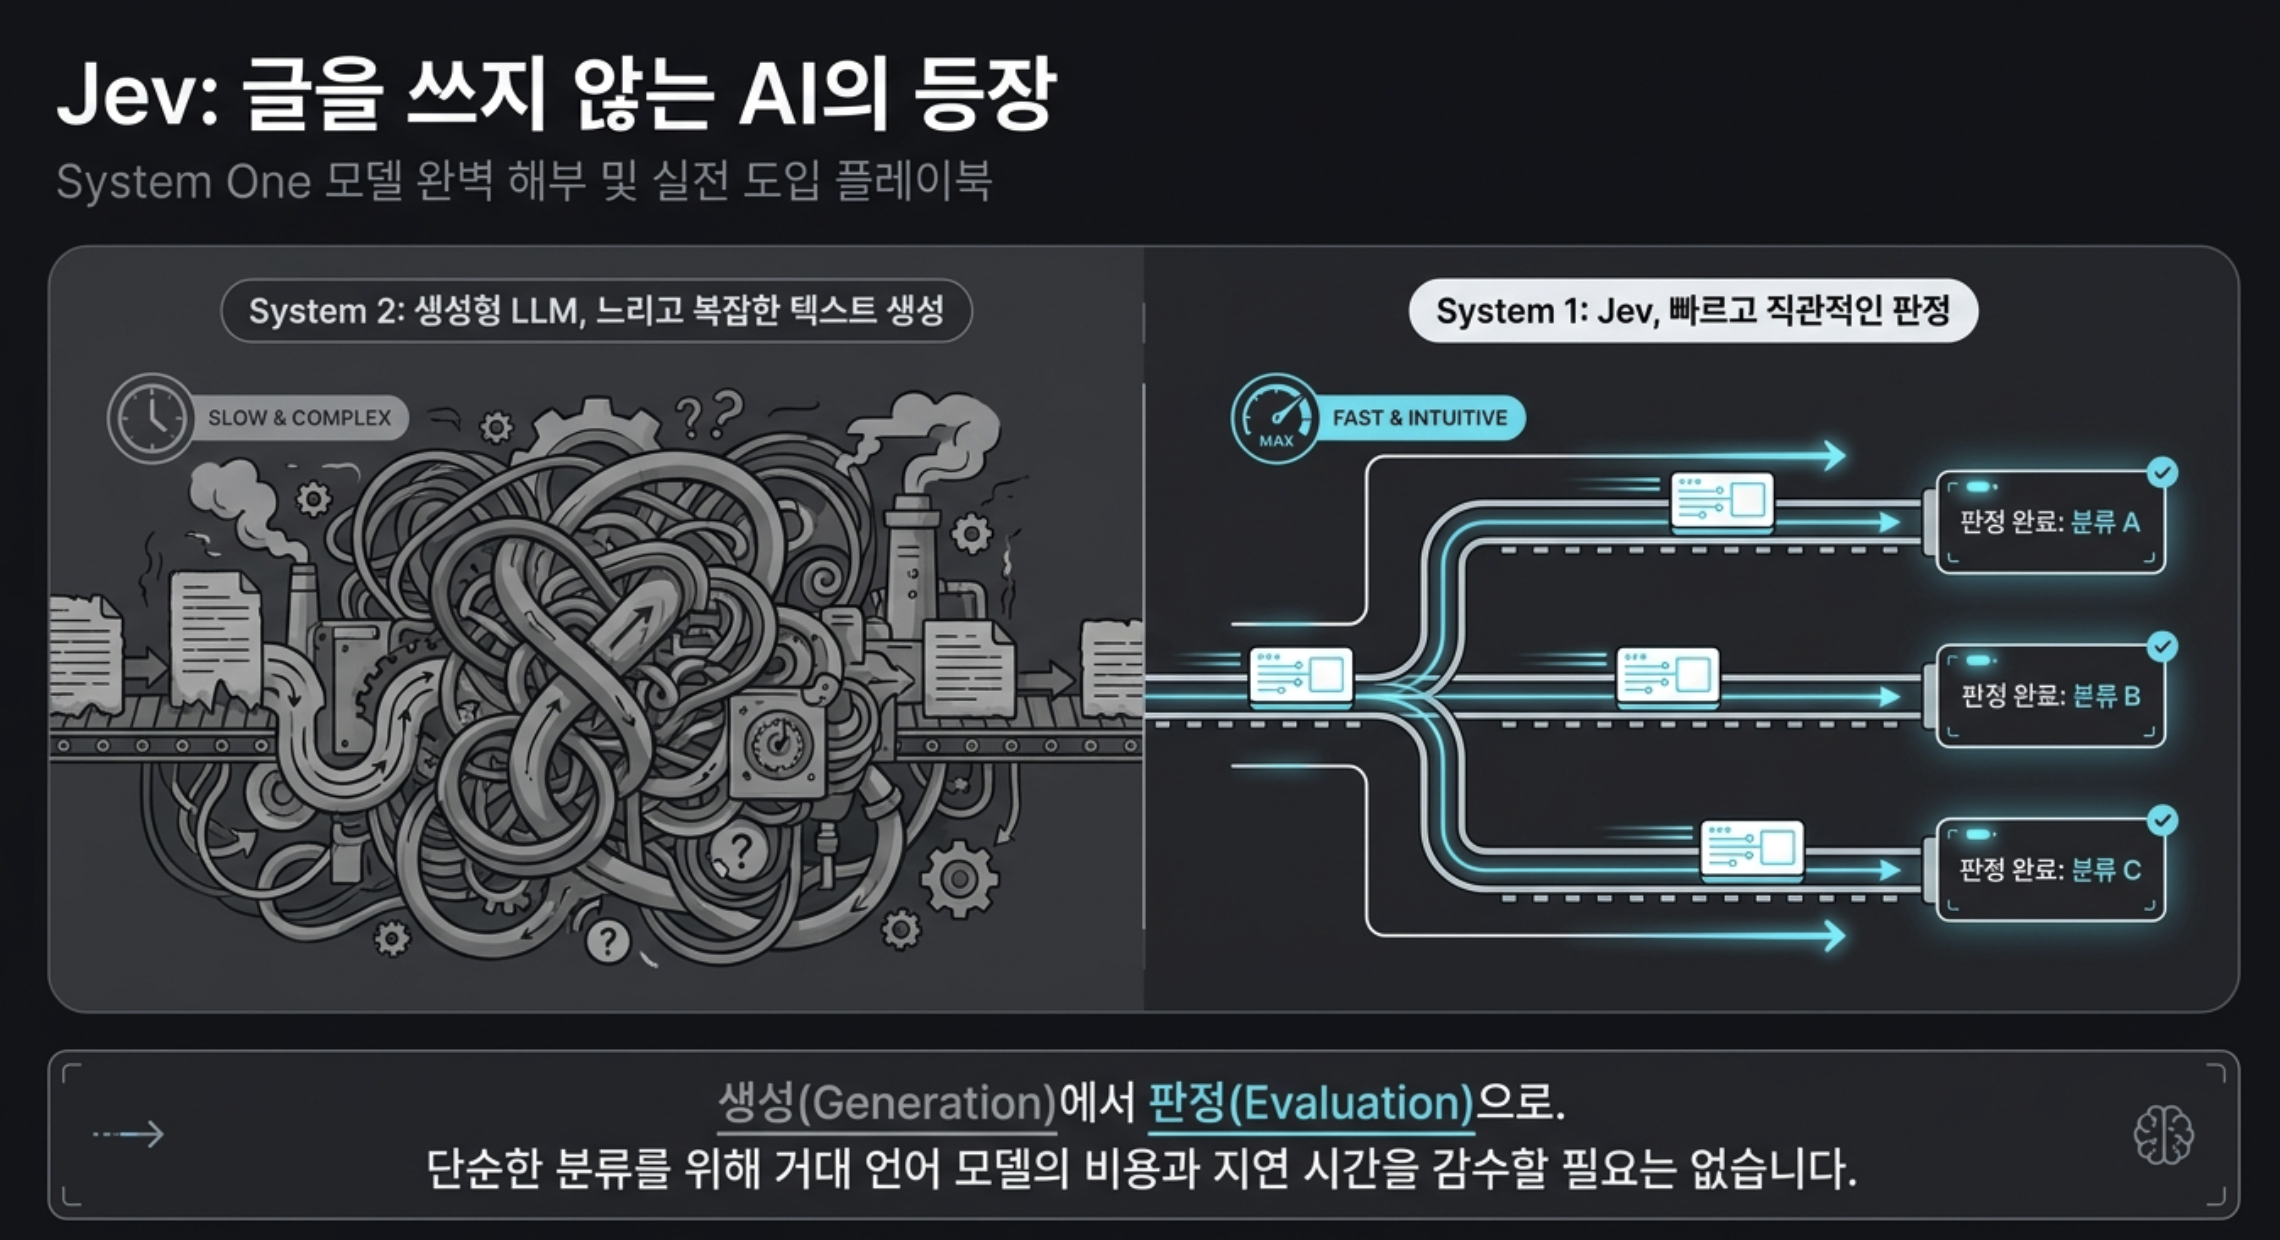
처음 Jev 소식을 봤을 때는 "응답 빠른 소형 모델이 또 하나 나왔구나" 정도로 생각했다.
그런데 공개된 예제를 하나씩 보다 보니 방향이 꽤 달랐다. Jev는 글을 잘 쓰는 모델이 아니다. 미리 정해 둔 후보 중에서 다음 행동을 빠르게 고르는 모델에 가깝다.
그래서 고객 문의 분류, 코딩 에이전트, 게임처럼 전혀 달라 보이는 예시들이 사실은 같은 원리로 움직인다.
이번 글에서는 개념 소개에서 멈추지 않고 Playground로 직접 눌러 보는 방법부터 활용 예시 몇 가지, 그리고 운영에 넣기 전에 무엇을 검증해야 하는지까지 순서대로 정리해보려 한다.
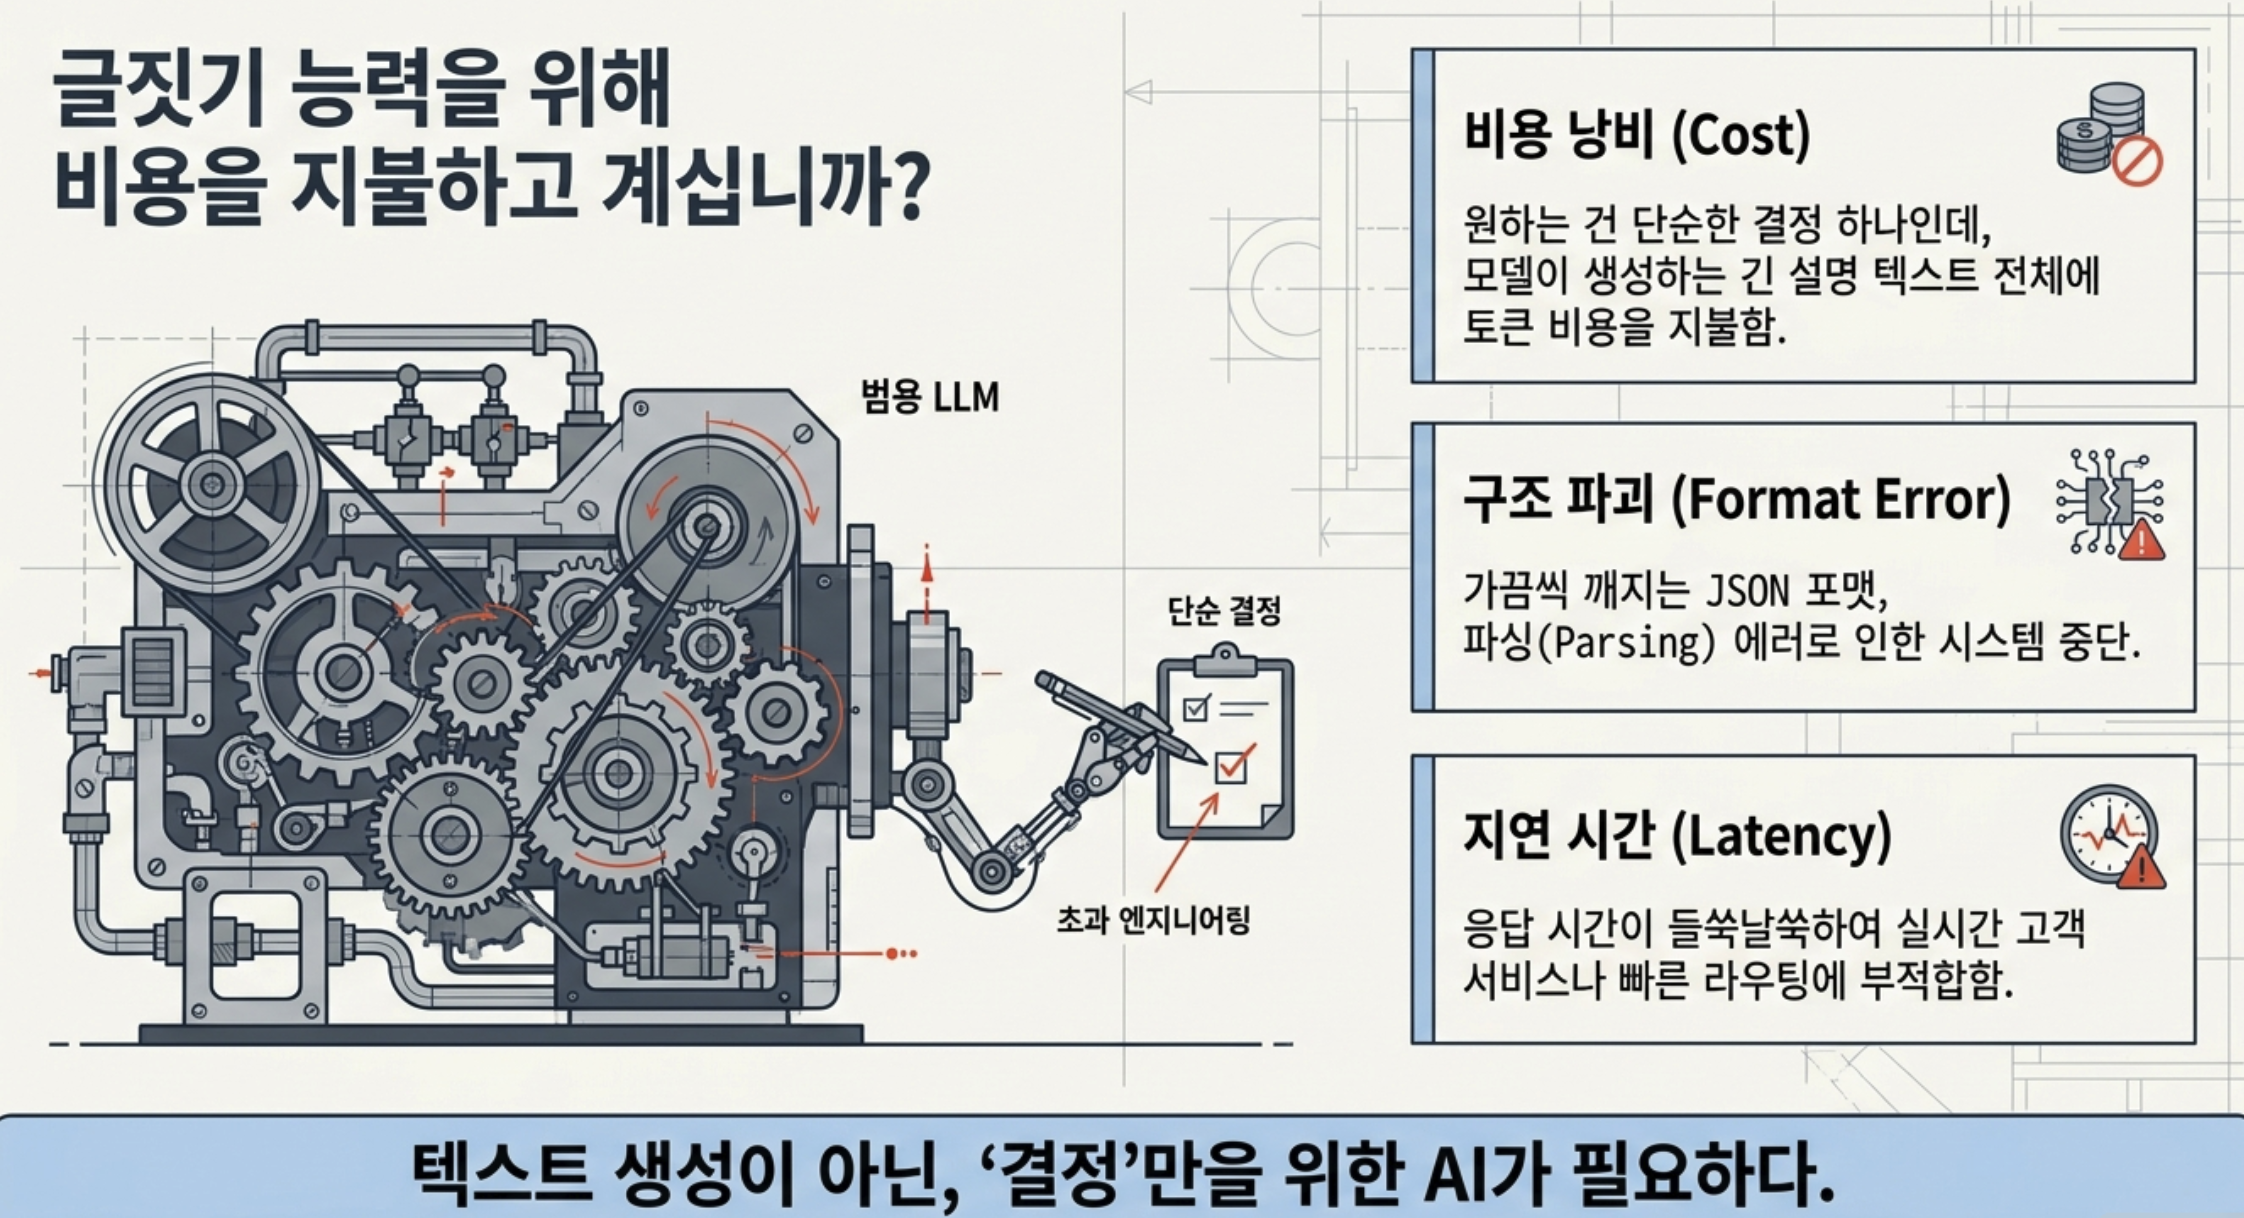
생성형 AI를 서비스에 붙여 본 개발자라면 한 번쯤 겪는 장면이 있다.
고객 문의를 세 부서 중 하나로 보내고 싶을 뿐인데, 모델이 설명을 길게 덧붙인다. JSON 형식이 가끔 깨지고, 응답 시간도 들쑥날쑥하다.
원하는 건 결정 하나인데, 글을 쓰는 능력 전체에 비용을 내고 있는 셈이다.
TypeSafe AI는 바로 이 빈틈을 노리고 2026년 9월 15일 Jev를 얼리 액세스로 공개했다.
스스로는 Jev를 "시스템 원 모델(System One model)"이라고 부른다.
쉽게 말하면 자료 하나를 주고 여러 질문을 한꺼번에 던지면, 각 질문에 정해진 형태로 답만 딱 돌려주는 모델이다.

가격이 특히나 눈에 띈다.
공식 문서 기준 입력 100만 토큰당 0.042달러이고, 출력은 과금하지 않는다. (output 토큰은 무료다.)
여기에 빠른 응답 속도, 개발자들의 각종 실험까지 더해지면서 Hacker News에서 꽤 뜨겁게 화제가 됐다.
출시 후 2주 동안 있었던 일

API 응답에는 usage.output_tokens 값이 실제로 들어 있다. 출력 토큰이 없는 게 아니라, 돈을 안 받는 것뿐이다.
재밌는 점이 하나 더 있다.
Jev를 1만 번 가까이 호출해 본 개발자 Archer Hume의 분석을 보면, 이 output_tokens는 모델이 실제로 만든 글자 수가 아니라, 응답 JSON 크기에 맞춰 계산한 정산용 숫자에 가깝다고 한다.
모델이 보지도 않는 질문 ID 길이만 바꿔도 이 값이 달라졌다는 게 근거다.
"Jev"는 경제학자 윌리엄 스탠리 제번스(William Stanley Jevons)에서 따온 이름이다.
증기기관 효율이 좋아지자 석탄을 덜 쓰는 게 아니라 오히려 더 많이 쓰게 됐다는 "제번스의 역설"이 있다. AI 판단도 싸지면 쓸 곳이 훨씬 많아질 거라는 뜻으로 붙인 이름이라고 TypeSafe는 설명한다.
"시스템 원(System One)"은 대니얼 카너먼의 『생각에 관한 생각』에서 말하는 빠르고 직관적인 사고 방식에서 빌린 이름이다. 깊게 고민하지 않고 빠르게 판단하는 모델이라는 비유일 뿐, 사람 뇌처럼 동작한다는 뜻은 아니다.
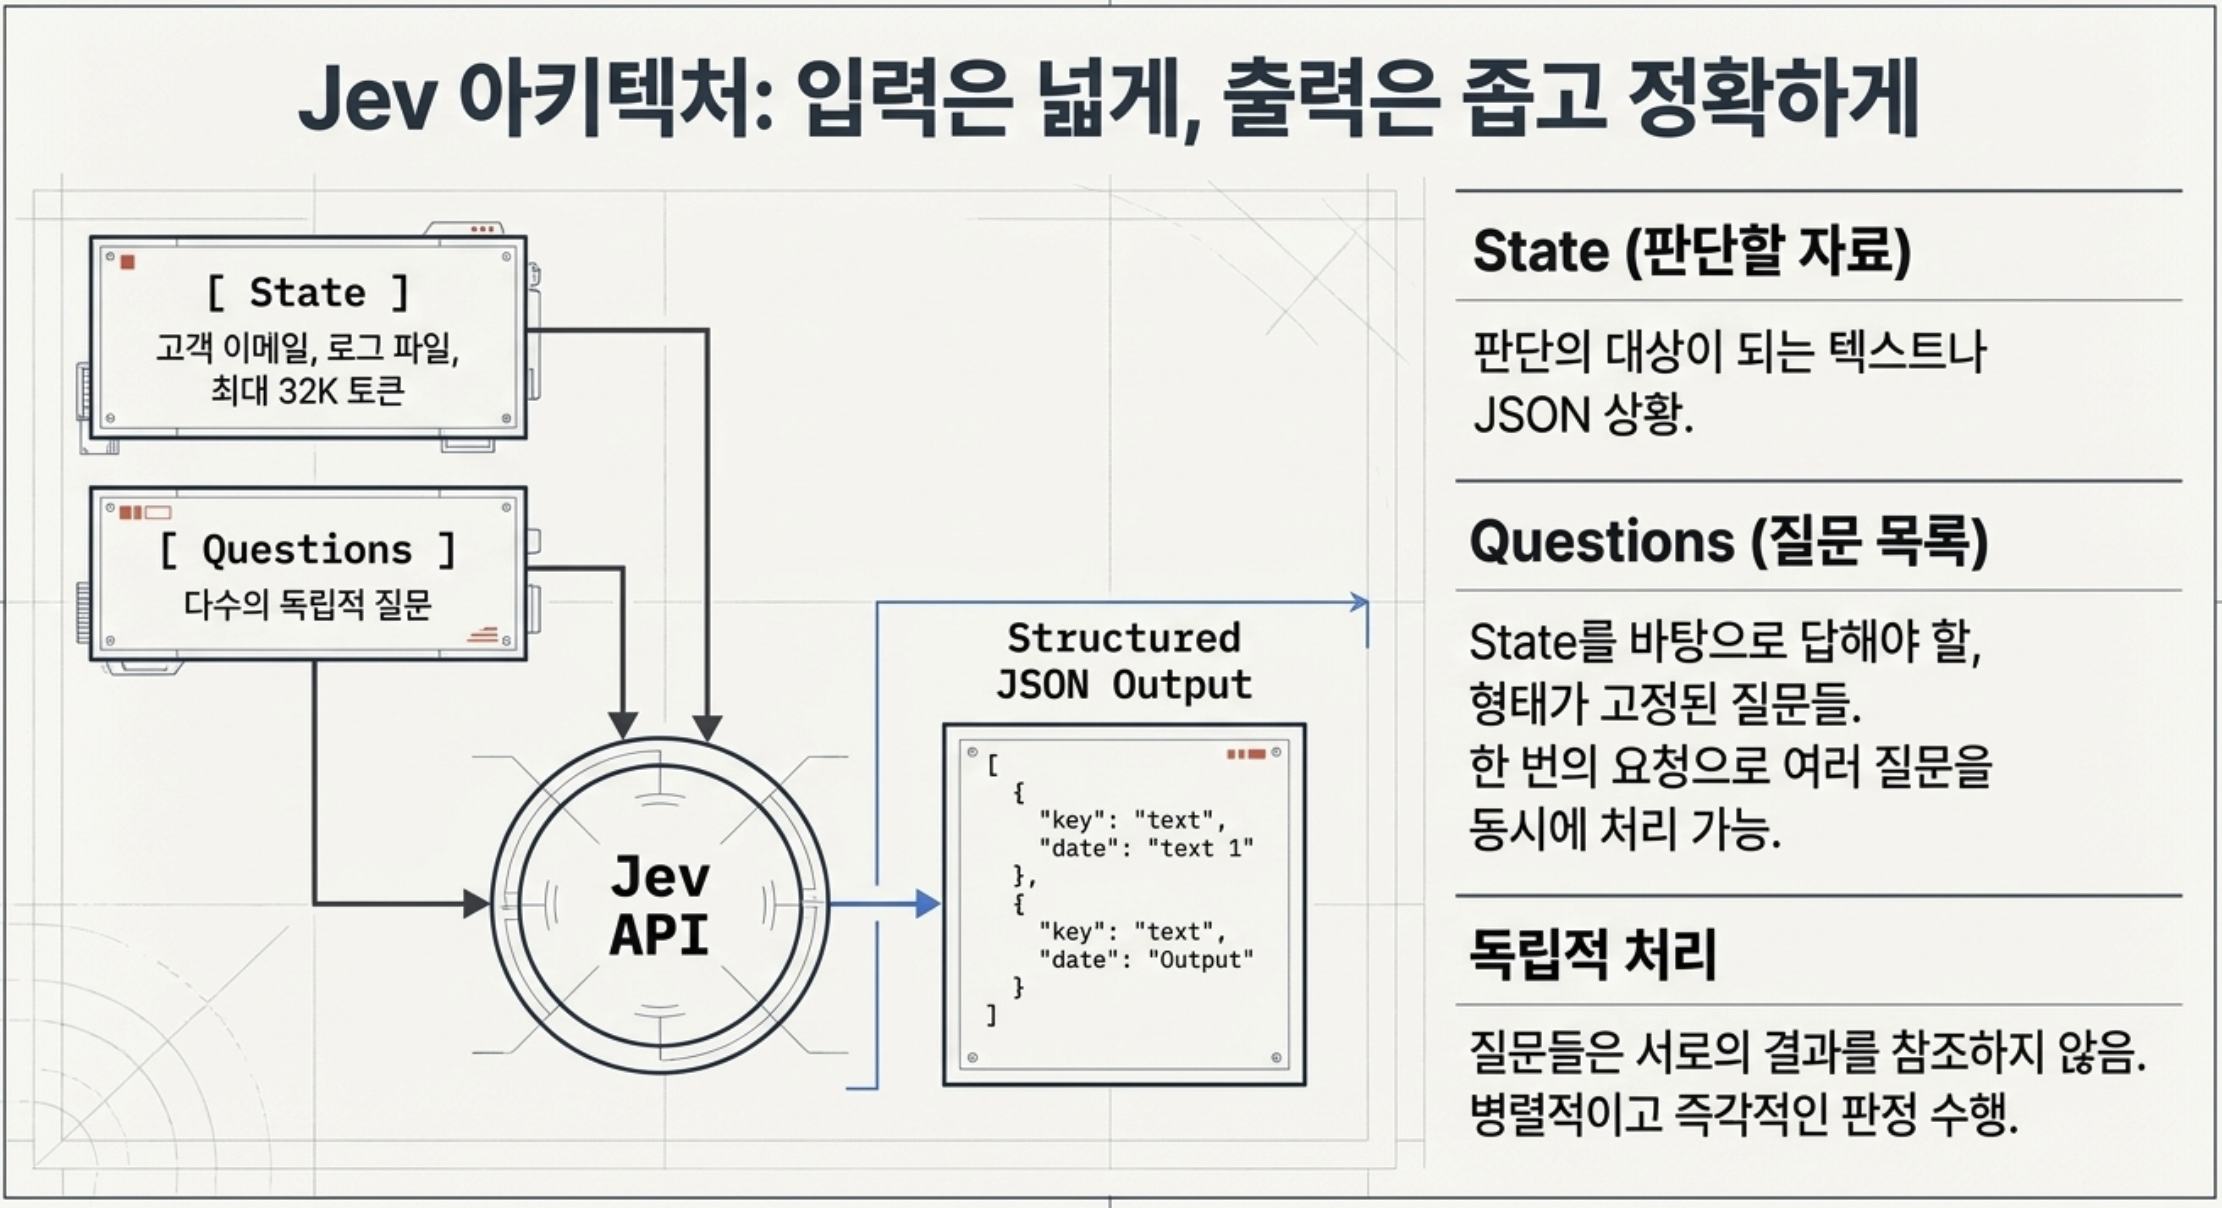
Jev에 보내는 요청은 크게 두 부분이다.
일반 LLM이 상담 내용을 읽고 답장 메일까지 써 주는 직원이라면, Jev는 미리 만든 분류표를 보고 "결제팀 / 긴급함" 같은 칸에 체크만 하는 담당자에 가깝다. state는 담당자에게 건네는 서류이고, questions는 "담당 부서는?", "급한 건가?" 같은 체크 항목이다.
질문 형태는 세 가지뿐이다.
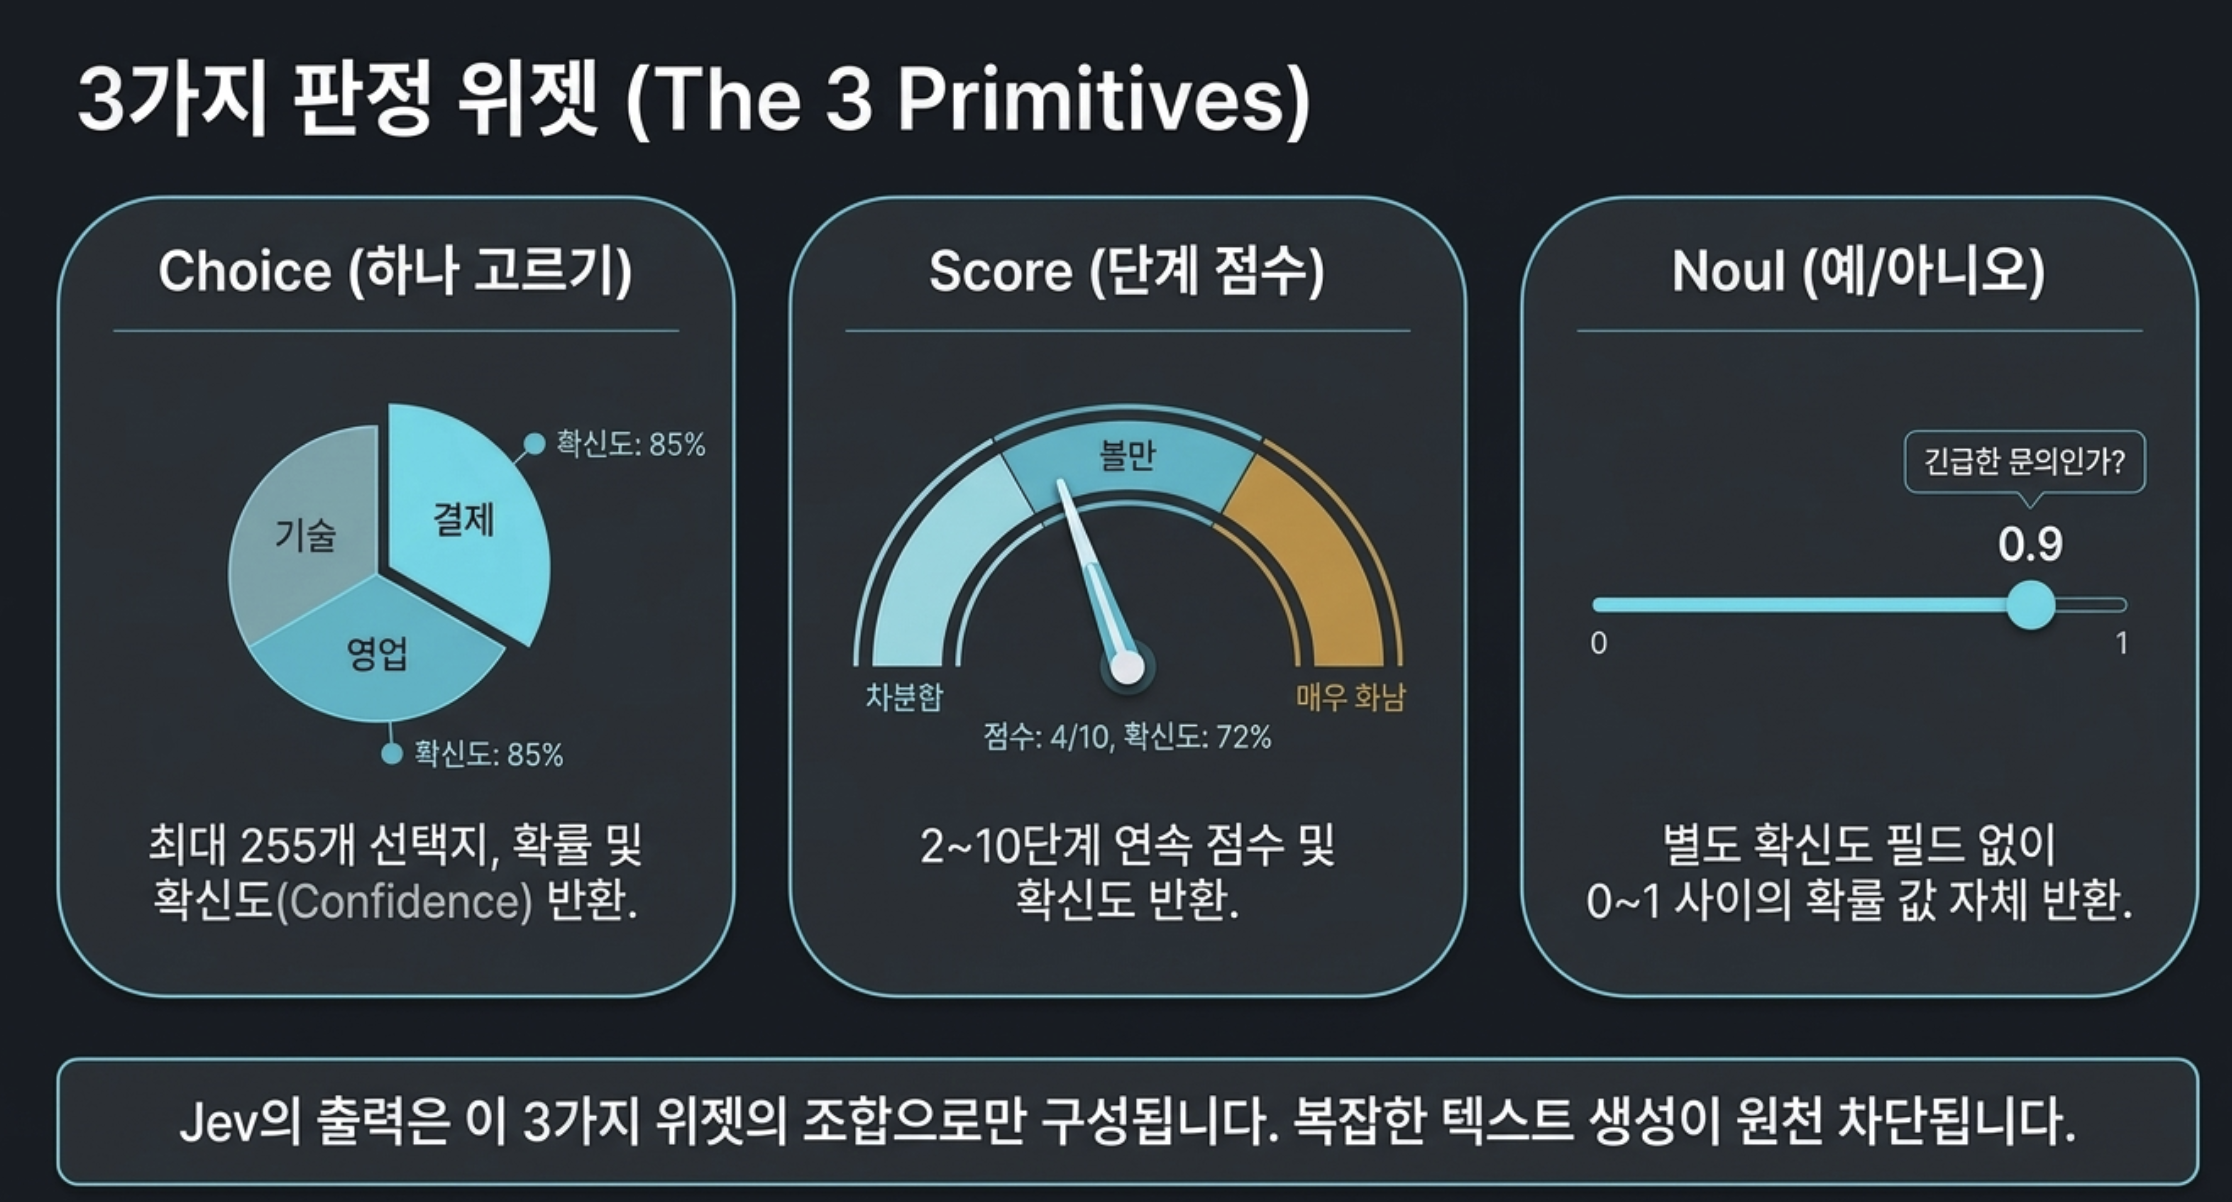
| 타입 | 돌려주는 값 | 예시 | 주의할 점 |
|---|---|---|---|
| Choice (하나 고르기) |
고른 선택지, 선택지별 확률, confidence(확신도) | billing / technical / sales | 선택지는 최대 255개. 선택지 순서와 설명 문구가 결과에 영향을 줄 수 있다 |
| Score (단계 점수) |
단계 사이에 걸칠 수 있는 연속 점수, 단계별 확률, 확신도 | 차분함 / 불만 / 화남 | 단계는 2~10개. 단계마다 눈으로 확인할 수 있는 기준을 적어야 한다 |
| Noul (예/아니오 확률) |
"예"일 확률에 해당하는 0~1 값 | 긴급한 문의인가? | 별도 확신도 필드가 없다. 값 자체를 기준값과 비교해서 쓴다 |
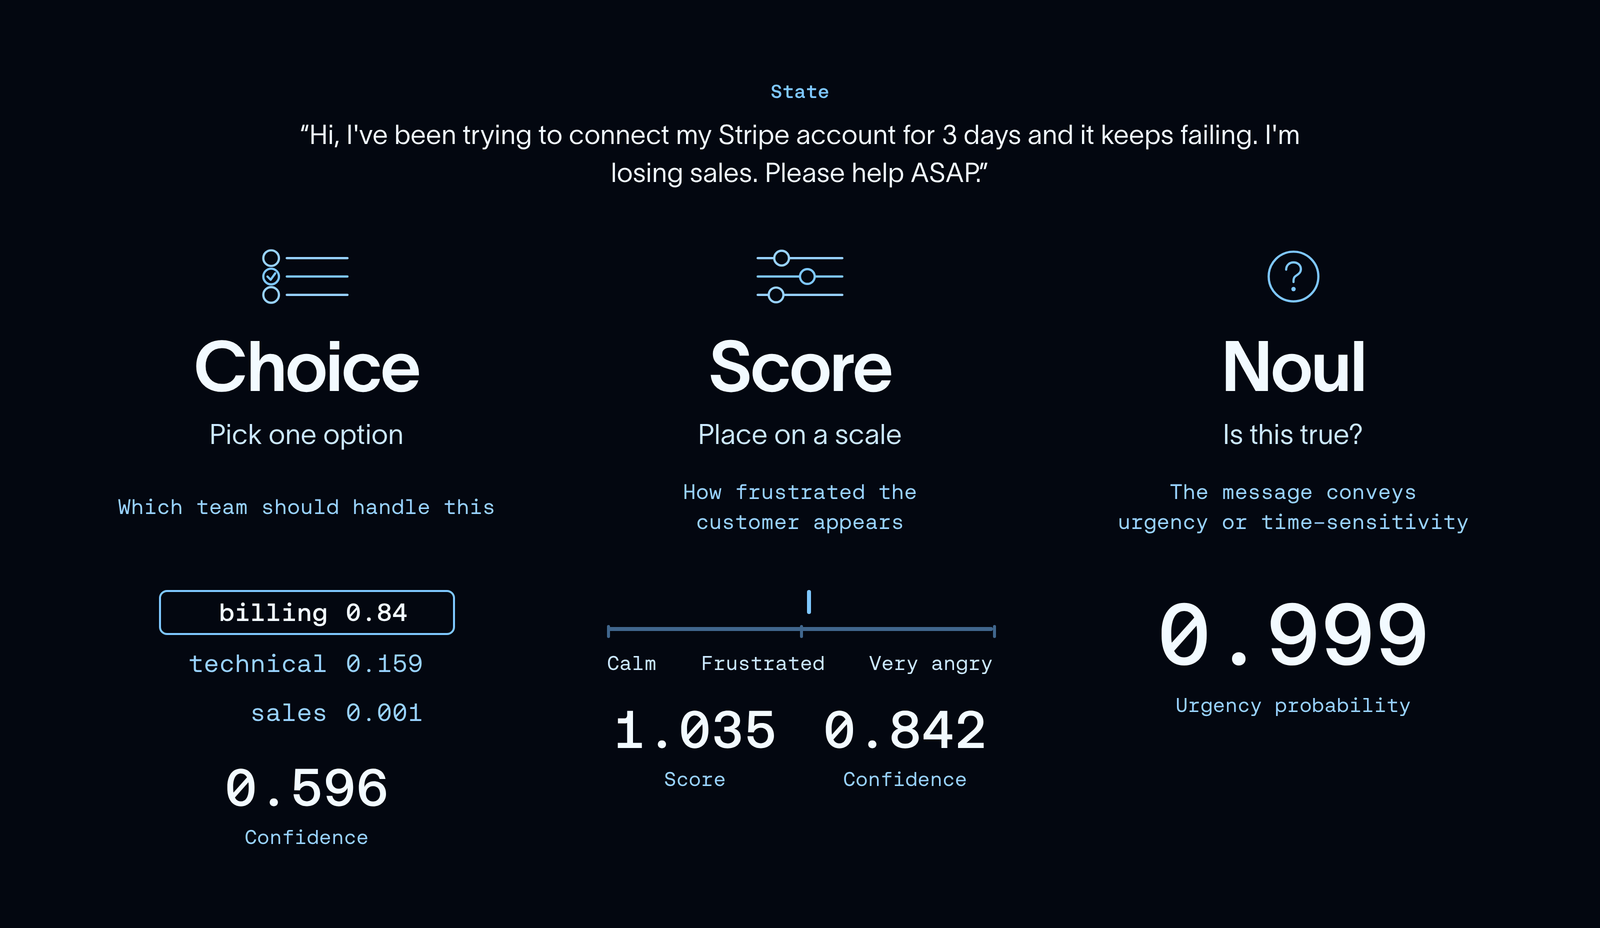

말로만 보면 감이 잘 안 오니, 공식 API 문서에 나온 Choice 응답 예시를 보자.
고객 문의를 billing·technical·sales 중 하나로 분류한 결과다.
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "billing",
      "probabilities": { "billing": 0.88, "technical": 0.12, "sales": 0.0 },
      "confidence": 0.81
    }
  },
  "usage": { "input_tokens": 318, "output_tokens": 34 }
}
문장은 한 줄도 없다. 고른 답(choice), 선택지별 확률(probabilities), 그 확률이 얼마나 한쪽으로 몰렸는지 요약한 확신도(confidence)만 온다.
개발자 입장에서는 이 점이 가장 편하다.
파싱하거나 형식을 검증할 필요 없이 if (answer.confidence >= THRESHOLD) 같은 조건문에 바로 넣으면 된다.
그리고 요청 한 번에 질문을 여러 개 같이 보낼 수 있다.
같은 고객 문의를 두고 담당 부서, 감정 상태, 긴급도를 한 번에 물을 수 있다.
다만 질문끼리는 서로의 답을 보지 못한다.
그래서 "질문 A가 billing이면 …"처럼 앞 질문의 답을 전제로 두 번째 질문을 쓰면 안 된다.
이럴 땐 첫 번째 결과를 코드에서 받아 보고, 필요하면 두 번째 요청을 따로 보내면 된다.
(지금 완벽하게 이해하지 않아도 괜찮다. 뒤의 실습 장에서 결과를 직접 눈으로 보다 보면 자연스럽게 이해될 것이다.)
예를 들어 결제 문의일 때만 환불 요청인지 알고 싶다면 이렇게 나눠야 한다.
| 이렇게 하면 안 된다 | 이렇게 나눠서 묻자 |
|---|---|
한 요청 안에 department와 함께If the department is billing, is this a refund request?(부서가 결제팀이라면, 환불 요청인가?)를 넣는다. → Jev는 department의 답을 모르는 채로 이 질문에 답한다. |
① 1차 요청에서 department만 묻는다.② 코드에서 결과가 billing인지 확인한다.③ 맞을 때만 2차 요청으로 Is the customer asking for a refund?(고객이 환불을 요청하고 있는가?)를 묻는다. |
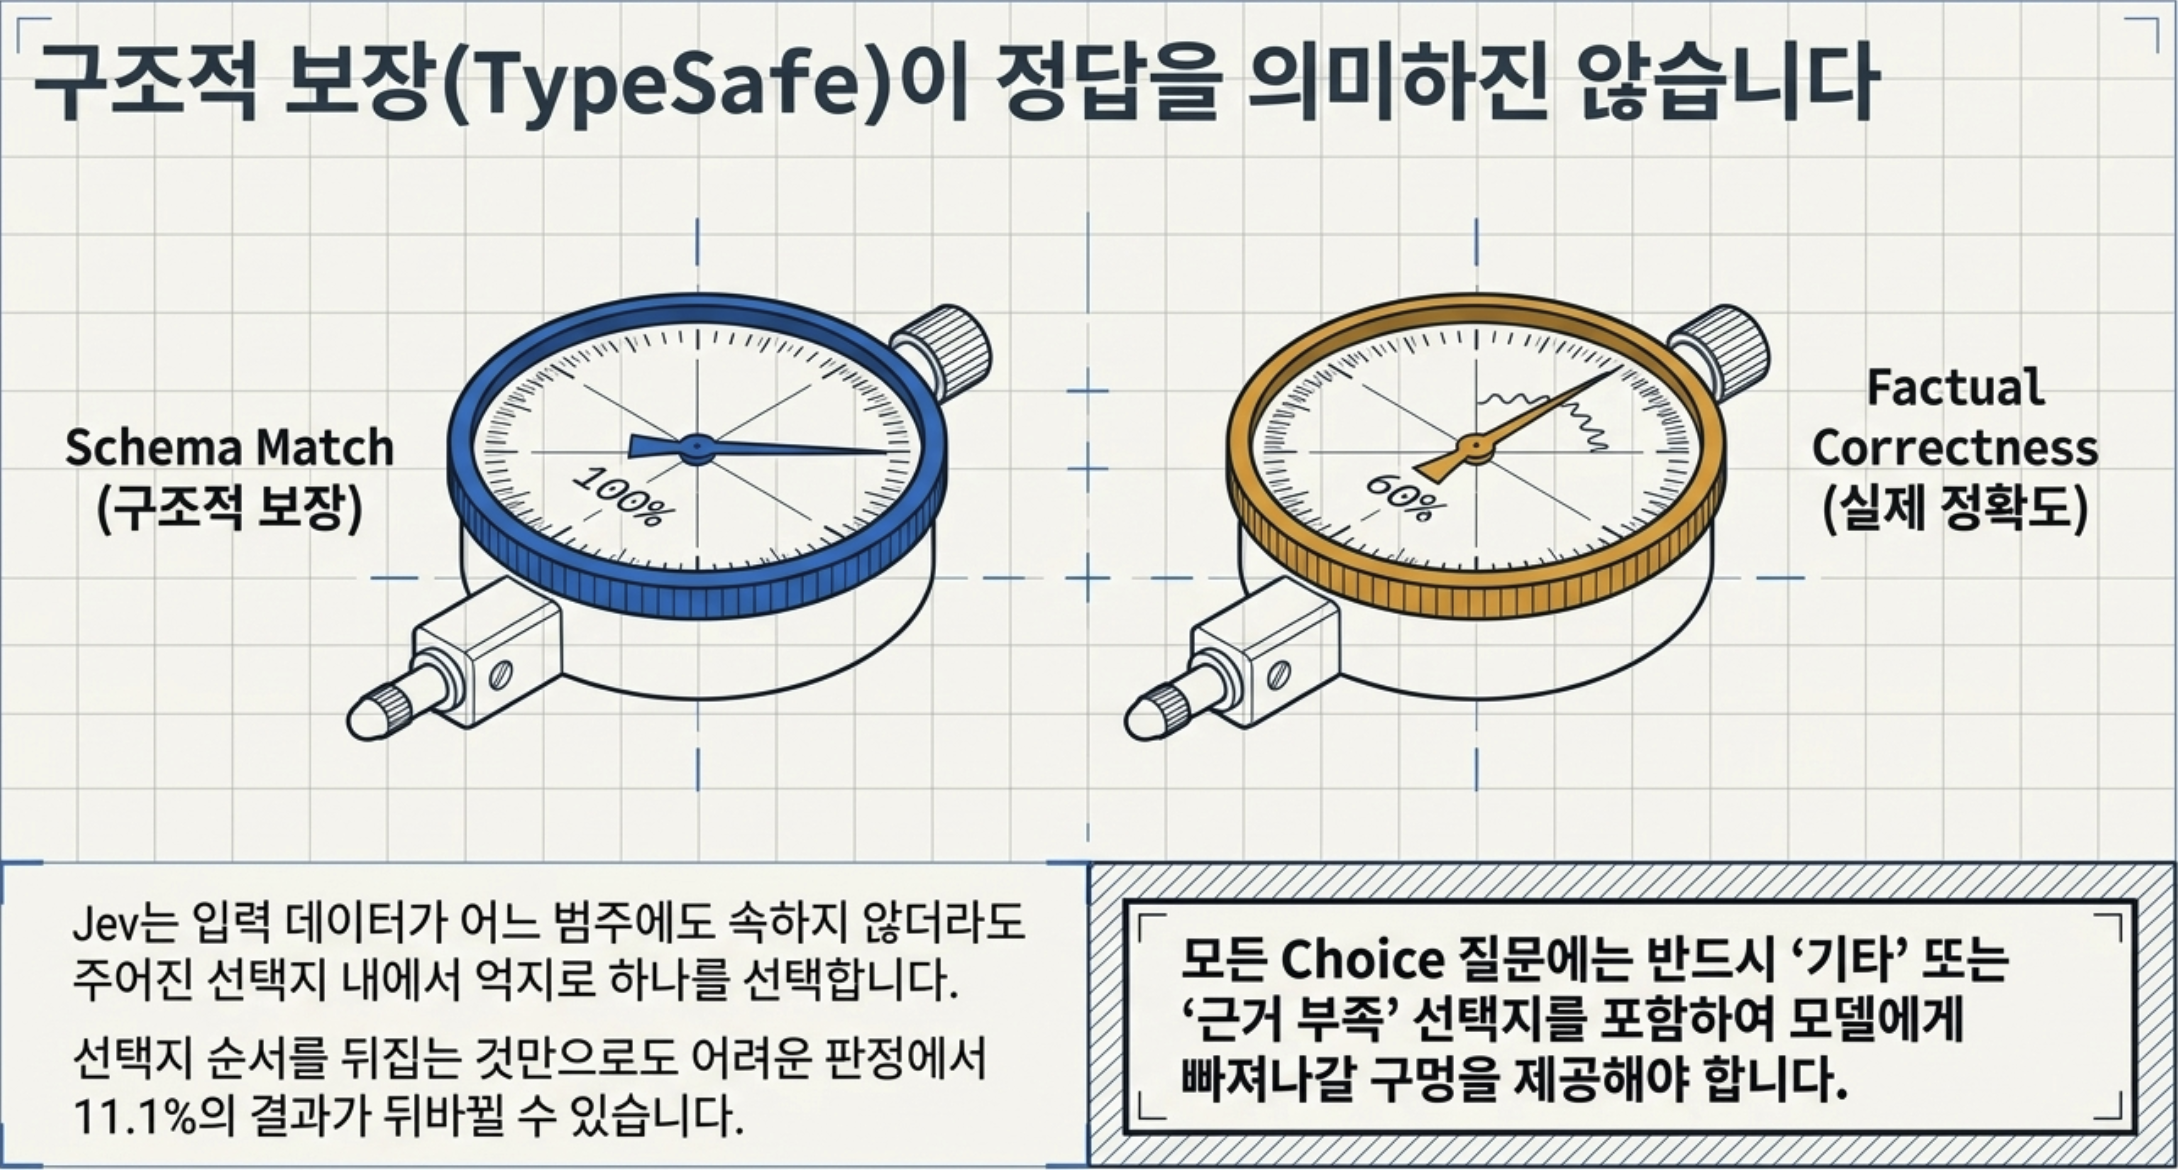
Jev가 billing | technical | sales(결제 | 기술 | 영업) 중 하나로만 답하게 만들 수 있다는 건 확실히 편하다. 응답을 파싱하다 에러가 나는 일은 사라진다.
문제는 세 부서 어디에도 안 맞는 문의가 들어왔을 때다. 그래도 Jev는 셋 중 하나를 골라야 하니, 형식은 멀쩡한데 내용은 틀린 답이 나온다.
한 줄 정리: 선택지에 other(기타)나 insufficient_evidence(근거 부족)를 넣고, 확신도가 낮으면 자동 처리하지 말고 사람 검토로 보내자.

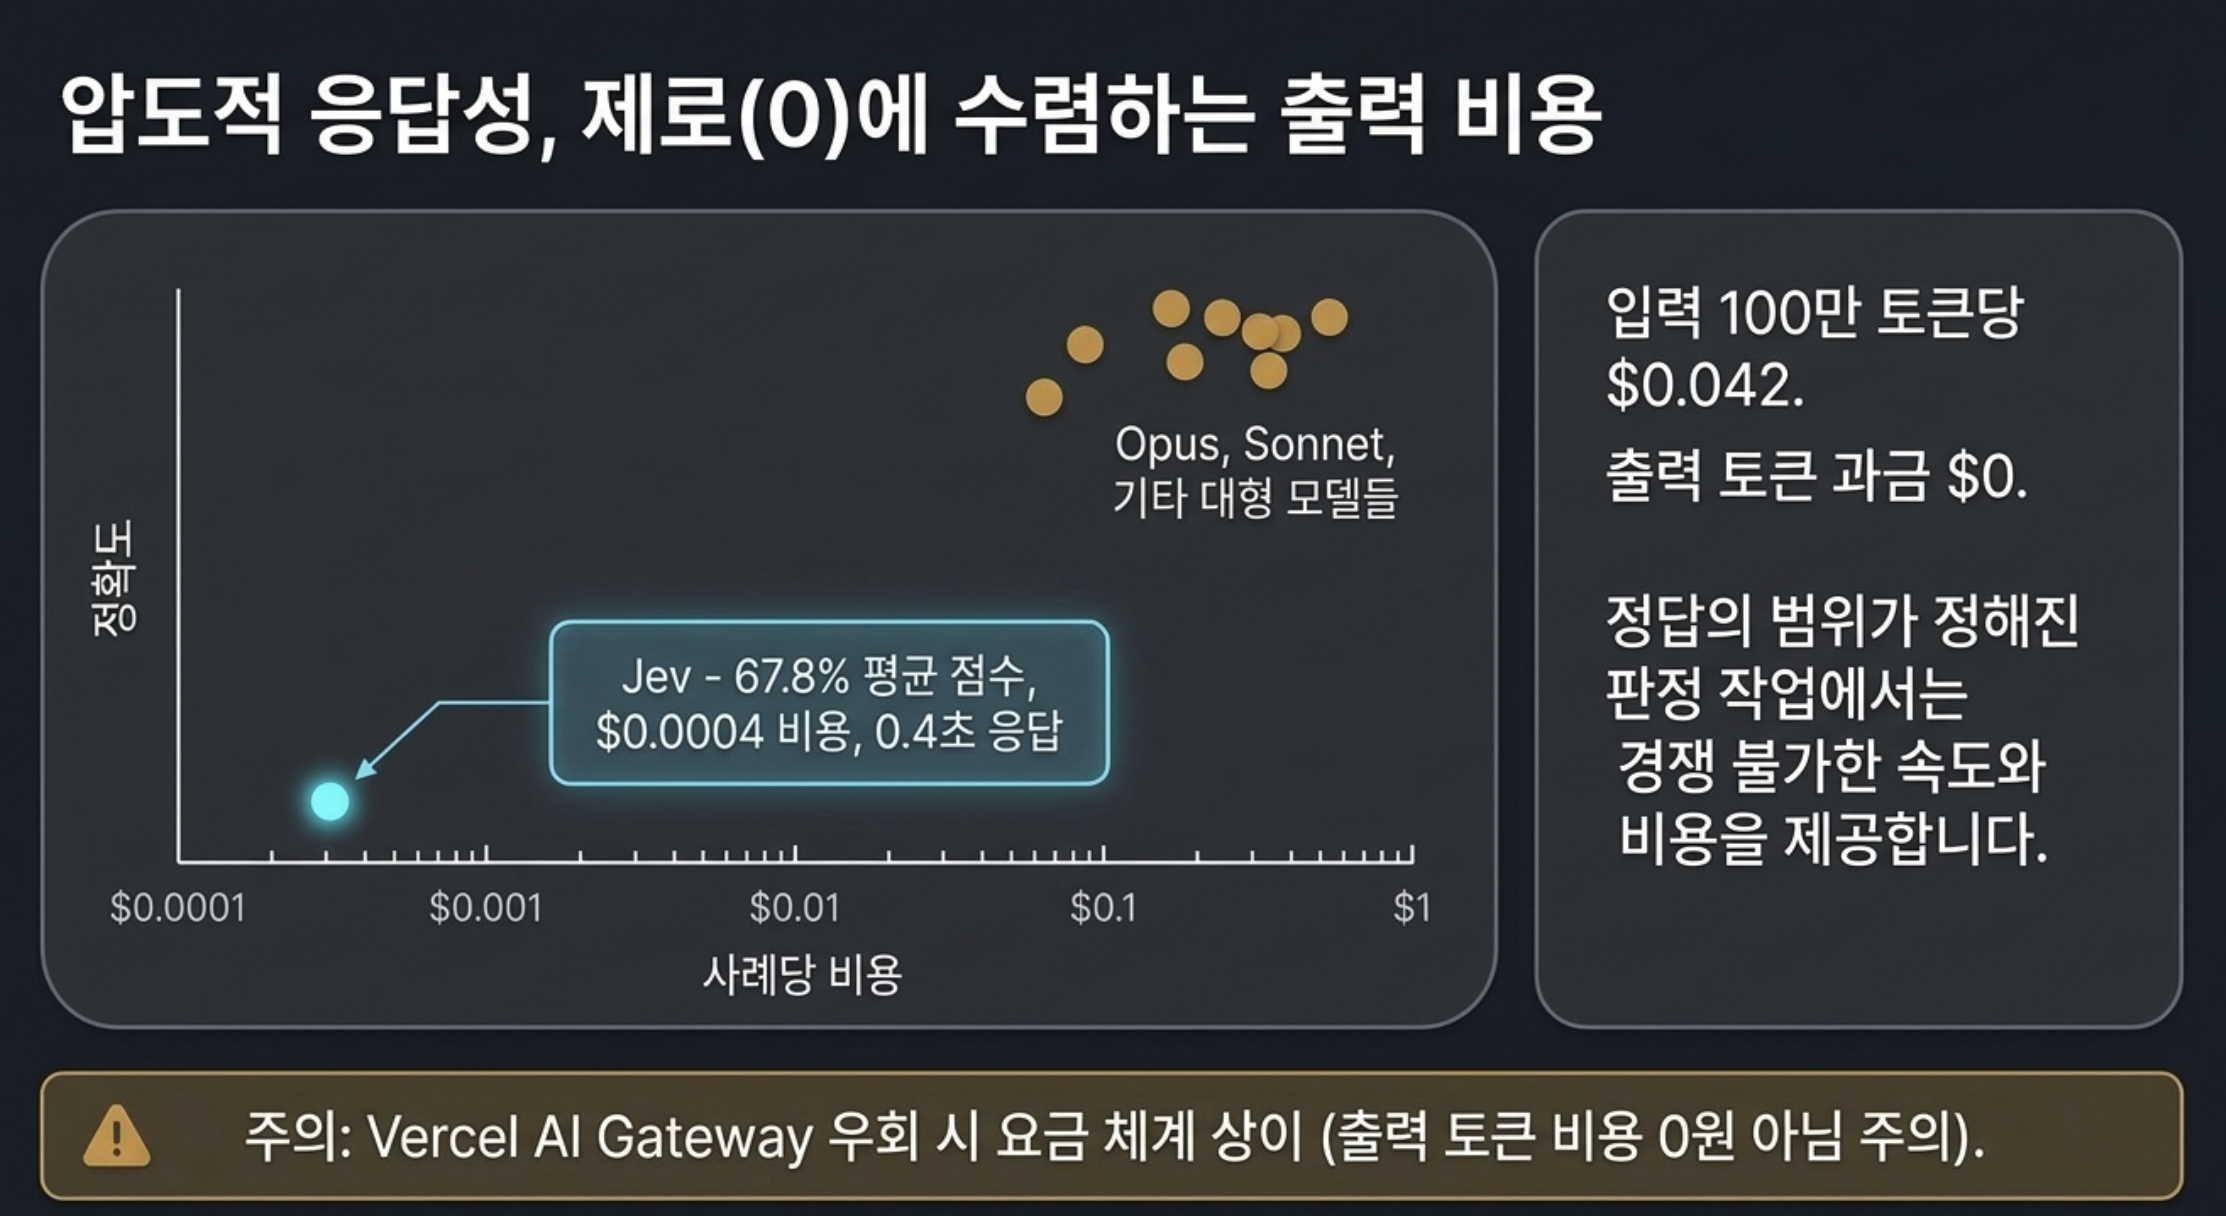
먼저 공식 모델 문서 기준으로 jev-1.13.0의 주요 스펙을 정리하면 이렇다.
| 입력 가격 | 10억 토큰당 $42 = 100만 토큰당 $0.042 |
|---|---|
| 출력 가격 | $0. 단, API 응답에는 output_tokens 사용량이 표시된다 |
| 결제 방식 | 크레딧을 미리 충전해 두고 쓰는 방식. 잔액이 없으면 Playground 실행과 API 호출 모두 막힌다 (6장 ‘시작 전 확인’ 참고) |
| 한 번에 넣을 수 있는 양 | 요청 전체 64K 토큰, state + 가장 긴 질문 하나는 32K 토큰까지 |
| 입력 형식 | 텍스트만 가능. 문자열·JSON 객체·배열. 이미지·오디오·비디오는 안 된다 |
| 사용 한도 | 초당 25만 토큰, 분당 1,200 요청. 수요에 따라 예고 없이 바뀔 수 있다고 안내돼 있다 |
| 모델 별칭 | jev-latest, jev-preview 모두 현재 1.13.0을 가리킨다 |
같은 Jev라도 TypeSafe API에 바로 요청하는 방법과 Vercel AI Gateway를 거치는 방법은 주소, 모델 이름, 질문 타입 이름, 결제 방식이 다르다.
| 구분 | TypeSafe 직접 연결 | Vercel AI Gateway |
|---|---|---|
| 주소 | api.typesafe.ai/v1/systemone |
ai-gateway.vercel.sh/v1/evaluate |
| 모델 이름 | jev-latest 또는 고정 버전 |
typesafe-ai/jev |
| 예/아니오 질문 타입 이름 | noul(예/아니오 확률) |
boolean (TypeSafe SDK로 연결하면 noul 그대로 사용) |
| 표시된 입력 한도 | 요청 전체 64K, 가장 긴 경로 32K | 모델 페이지에 32K로 표시 |
| 가격 표시 | 100만 토큰당 $0.042 | 100만 토큰당 $0.04로 표시 (반올림 표기로 보인다) |
| 결제·잔액 관리 | TypeSafe 콘솔에서 크레딧 충전 | Vercel 팀 결제로 청구 (TypeSafe 크레딧과 별개) |
| 장점 | 공식 SDK와 API 문서를 그대로 사용 | 다른 모델 호출과 함께 로그·예산·결제를 한 곳에서 관리 |
출시 직후 Vercel 모델 페이지에는 한동안 "Free"가 표시됐지만, 이후 확인했을 때는 입력 100만 토큰당 $0.04로 바뀌어 있었다. 불과 며칠 만에 바뀐 셈이니, 실제로 쓰기 전에는 팀 대시보드와 결제 화면에서 가격을 한 번 더 보자. TypeSafe 직접 가격과 Vercel 경유 가격도 따로 봐야 한다.
TypeSafe는 보안 사고 분류, 에이전트 실행 기록 점검, 인보이스 처리, 고객 서비스 이렇게 네 가지 업무로 모델들을 비교한 결과를 공개했다. 아래 표는 네 업무 점수를 같은 비중으로 평균 낸 값이고, 코드로 짠 작업 흐름(workflow) 방식으로 돌린 결과다.
| 모델 | 평균 점수 | 사례당 비용 | 사례당 시간 |
|---|---|---|---|
| Jev | 67.8% | $0.0004 | 0.4초 |
| Sol | 74.1% | $0.0836 | 23.3초 |
| Terra | 67.9% | $0.0304 | 10.1초 |
| Luna | 66.8% | $0.0033 | 12.9초 |
| Sonnet 5 | 67.8% | $0.1174 | 78.1초 |
| Opus 5 | 73.1% | $0.1761 | 37.8초 |
출처: TypeSafe Evals. TypeSafe가 직접 만든 평가이며 독립 벤치마크가 아니다.
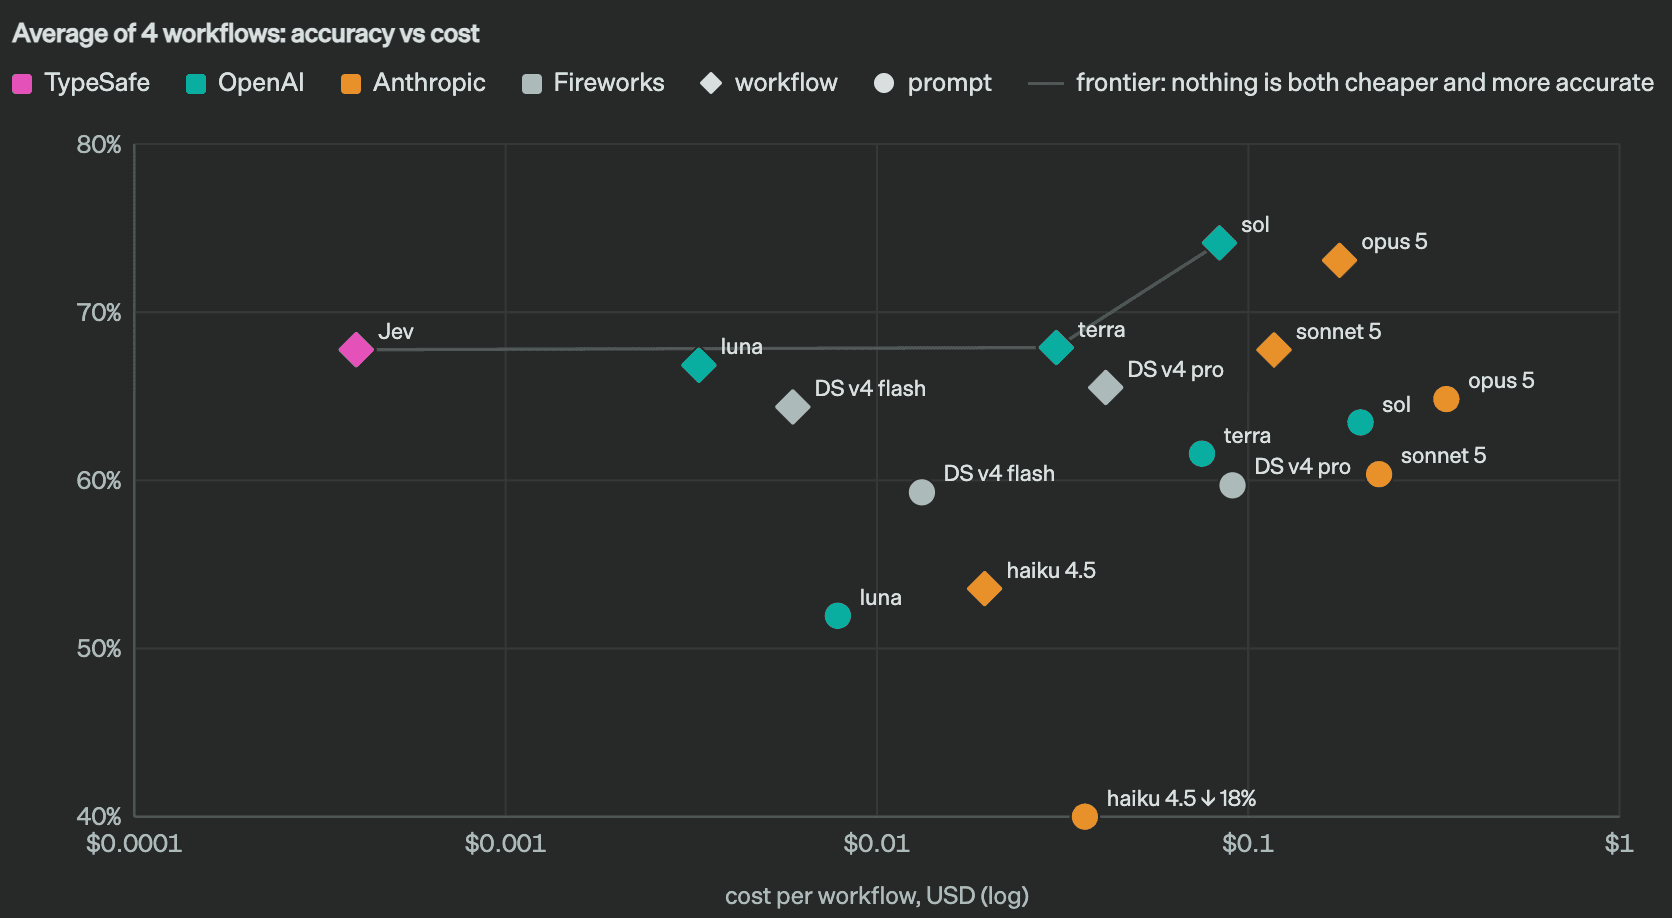
자주 인용되는 "193.6배 빠르고 444.6배 저렴하다"는 문구도 이 평가에서 나온 숫자다.
눈여겨볼 점은 TypeSafe 스스로도 출시 글에서 이 숫자는 높게 나온 쪽이고, 실제 업무에서는 차이가 이보다 작을 수 있다고 적어 두었다는 점이다.
채점 방식도 한번 짚고 넘어가자.
이 평가는 사람이 문제마다 정답을 직접 달아 둔 게 아니다.
지금 가장 똑똑하다는 GPT-6 Astra와 Claude Fable 5.1에게 최대한 깊게 생각하게 한 뒤, 두 모델 답의 평균을 "모범 답안"으로 삼았다. 반에서 1·2등 하는 학생의 답안지를 기준으로 나머지 학생들을 채점한 셈이다.
나머지 모델은 기본 설정으로 돌렸고, TypeSafe도 이 방식이 OpenAI·Anthropic 모델 쪽에 조금 유리하게 기울 수 있다고 직접 인정했다.
그래서 이 표는 "답의 범위가 정해진 판정 작업이라면, 싸고 빠르면서 성능도 꽤 쓸 만하다" 정도로 읽는 게 적당해 보인다.
앞에서 나온 Archer Hume은 API를 1만 번 가까이 호출하면서 Jev가 어떻게 반응하는지 하나하나 실험해 봤다. 눈에 띄는 결과만 추리면 이렇다.
실제 서비스에 붙인다면 이 부분은 꽤 신경 쓰인다.
자동 처리 기준을 0.9로 잡아 뒀다면, 선택지 순서만 바꿔도 어떤 문의는 자동 처리되고 어떤 문의는 사람에게 넘어갈 수 있다는 얘기다. 선택지를 추가하거나 순서를 바꿨다면 기존 테스트부터 다시 돌려보자.
다만 어떤 모델을 기반으로 만들었는지, MoE(여러 전문가 모델을 섞는 구조)인지 같은 내부 구조는 공개된 적이 없다. 글쓴이도 추측이 섞여 있다고 밝혔으니, "내부 구조를 다 밝혀냈다"보다는 "겉으로 보이는 동작을 꼼꼼히 관찰했다" 정도로 보면 된다.
9월 22일에는 카네기멜런대(CMU) 연구진이 Jev를 "AI 답변 채점관"으로 써 보는 사전논문을 올렸다.
답변 평가용으로 학습된 보상 모델(reward model)부터 일반 생성형 모델까지 평가 모델 16개와 비교했고, 사람 검토자가 어느 모델의 판정인지 모르는 상태에서 다시 채점하기도 했다.
결과를 쉽게 정리하면 이렇다.
그래서 논문의 결론도 "Jev로 다 바꾸자"가 아니다.
Jev가 확신하는 건 먼저 처리하고, 애매한 건만 더 강한 모델에 넘기는 방식이 가장 잘 맞았다. 미리 정해 둔 조건으로 시험해 보니 비교 모델 정확도의 약 99%를 유지하면서 비용은 57% 수준으로 줄었다고 한다.

다만 아직 학회 심사(동료 평가)를 거치지 않은 사전논문이다.
비교 모델을 늘린 부분은 초기 결과를 본 뒤 추가한 실험이라고 연구진이 직접 밝혔다.
논문에서 쓴 기준값을 고객 문의나 코드 리뷰에 그대로 가져다 쓰는 건 피하자.
같은 논문에서 똑같은 요청을 96번 반복했을 때는 판정이 한 번도 안 바뀌었다. 그런데 두 답변의 순서만 바꿔서 물었더니, 비교적 쉬운 RewardBench에서는 약 3.3%, 더 어려운 JudgeBench에서는 약 11.1%의 판정이 뒤집혔다.
그래서 연구진은 중요한 비교라면 순서를 바꿔 한 번 더 묻고, 두 결과의 확률을 평균 내라고 권한다. 대신 호출이 두 배로 늘어나니, 내 데이터에서도 그만한 효과가 있는지 먼저 확인해보는 게 좋겠다.
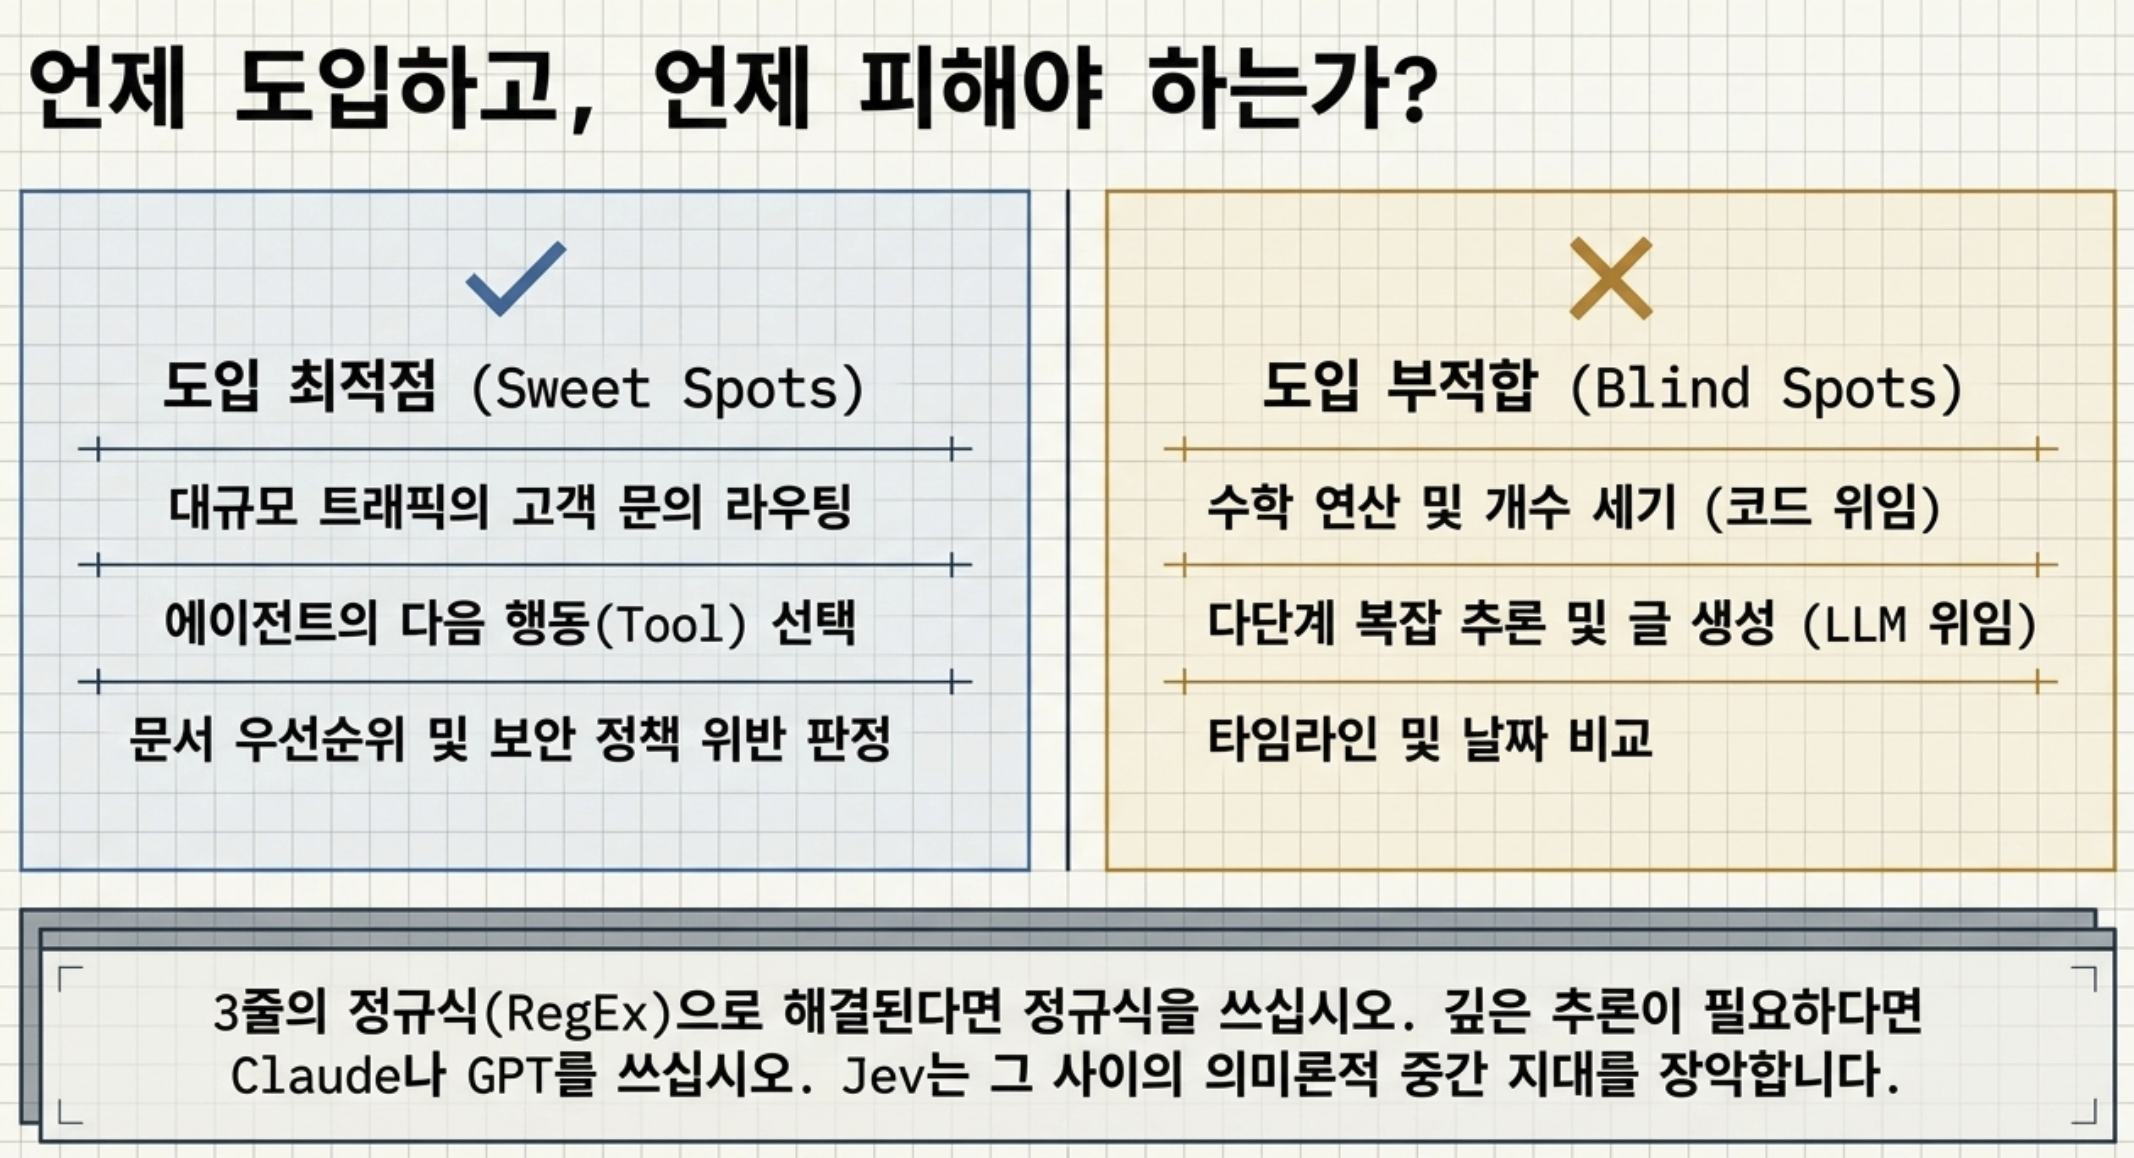
| 잘 맞는 일 | 이유 | 다른 방법이 더 나을 수 있는 경우 |
|---|---|---|
| 고객 문의 부서 분류 | 선택지가 고정되어 있고 호출량이 많다 | 키워드 규칙 몇 줄로 100% 처리되는 경우 |
| 에이전트가 쓸 도구·모델 고르기 | 다음 행동 후보가 분명하다 | 긴 설명이나 계획까지 같이 만들어야 할 때 |
| 정책·안전 검사 | 확률과 기준값으로 사람 검토 여부를 나눌 수 있다 | 법적 최종 판단, 규칙만으로 완전히 정해지는 경우 |
| 뉴스·공시 사건 분류 | 문장의 의미를 정해진 범주로 바꿔 준다 | 가격 계산, 시계열 예측, 자동 매매 |
| 대량 문서 우선순위 정하기 | 값싼 병렬 판정과 궁합이 좋다 | 정답이 붙은 데이터가 충분해 전용 분류기를 학습할 수 있을 때 |
도입을 고민 중이라면 같은 데이터로 이 네 가지와 먼저 비교해보자.
조건문·정규식 같은 기존 규칙, 일반 LLM의 구조화 출력(Structured Outputs), 업무 전용 분류 모델, 그리고 지금 사람이 직접 하는 판단이다.
분류 기준이 자주 바뀌고, 학습시킬 정답 데이터는 없는데, 문장 뜻은 이해해야 하는 반복 작업이라면 Jev가 특히 잘 맞는다.
TypeSafe는 "Jev 1.13의 들쭉날쭉한 부분(jaggedness)"이라는 문서에 약점을 따로 정리해 공개하고 있다. 처음 쓸 때 알아두면 좋은 것만 추리면 이렇다.
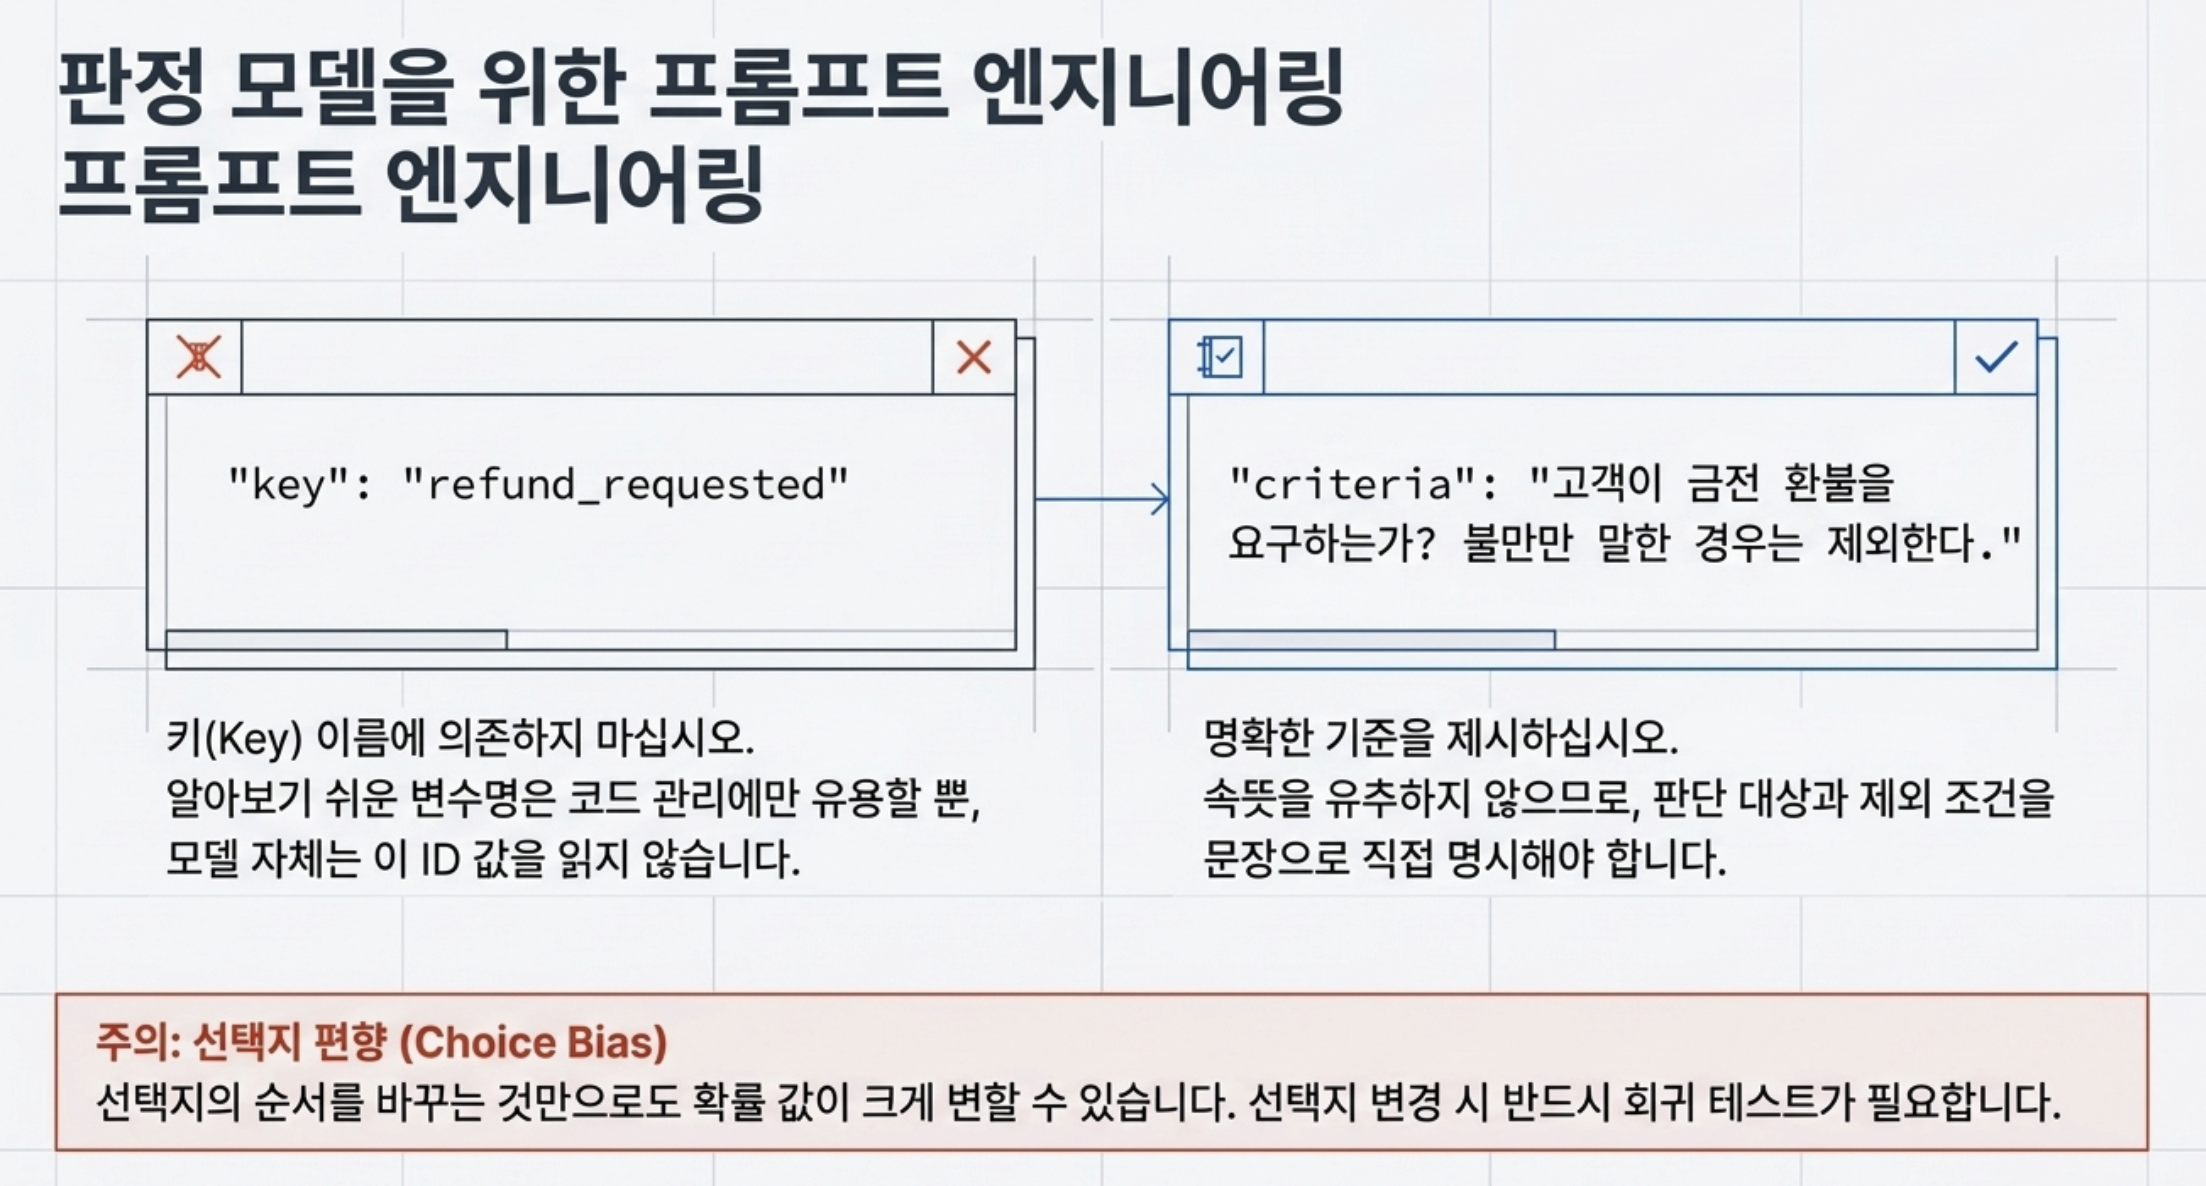
긴급한 문의를 골라내고 싶어서 Is this urgent?(급한 건인가?)라고만 물으면, 무엇을 긴급하다고 볼지는 모델이 문장만 보고 알아서 정한다.
"오늘 안에", "내일까지"처럼 기한을 말한 경우만 긴급으로 보고 싶다면 Does the customer mention a deadline, such as today or tomorrow?(고객이 오늘이나 내일처럼 기한을 언급했는가?)처럼 그 조건을 질문에 직접 적어 주자.
아래는 TypeSafe가 직접 만든 예제(cookbook)와 평가용 시나리오다.
실제 회사가 도입해서 성과를 낸 사례는 아니다.
그래도 Jev를 코드 어디에 끼워 넣으면 되는지 감 잡기에는 충분하다.
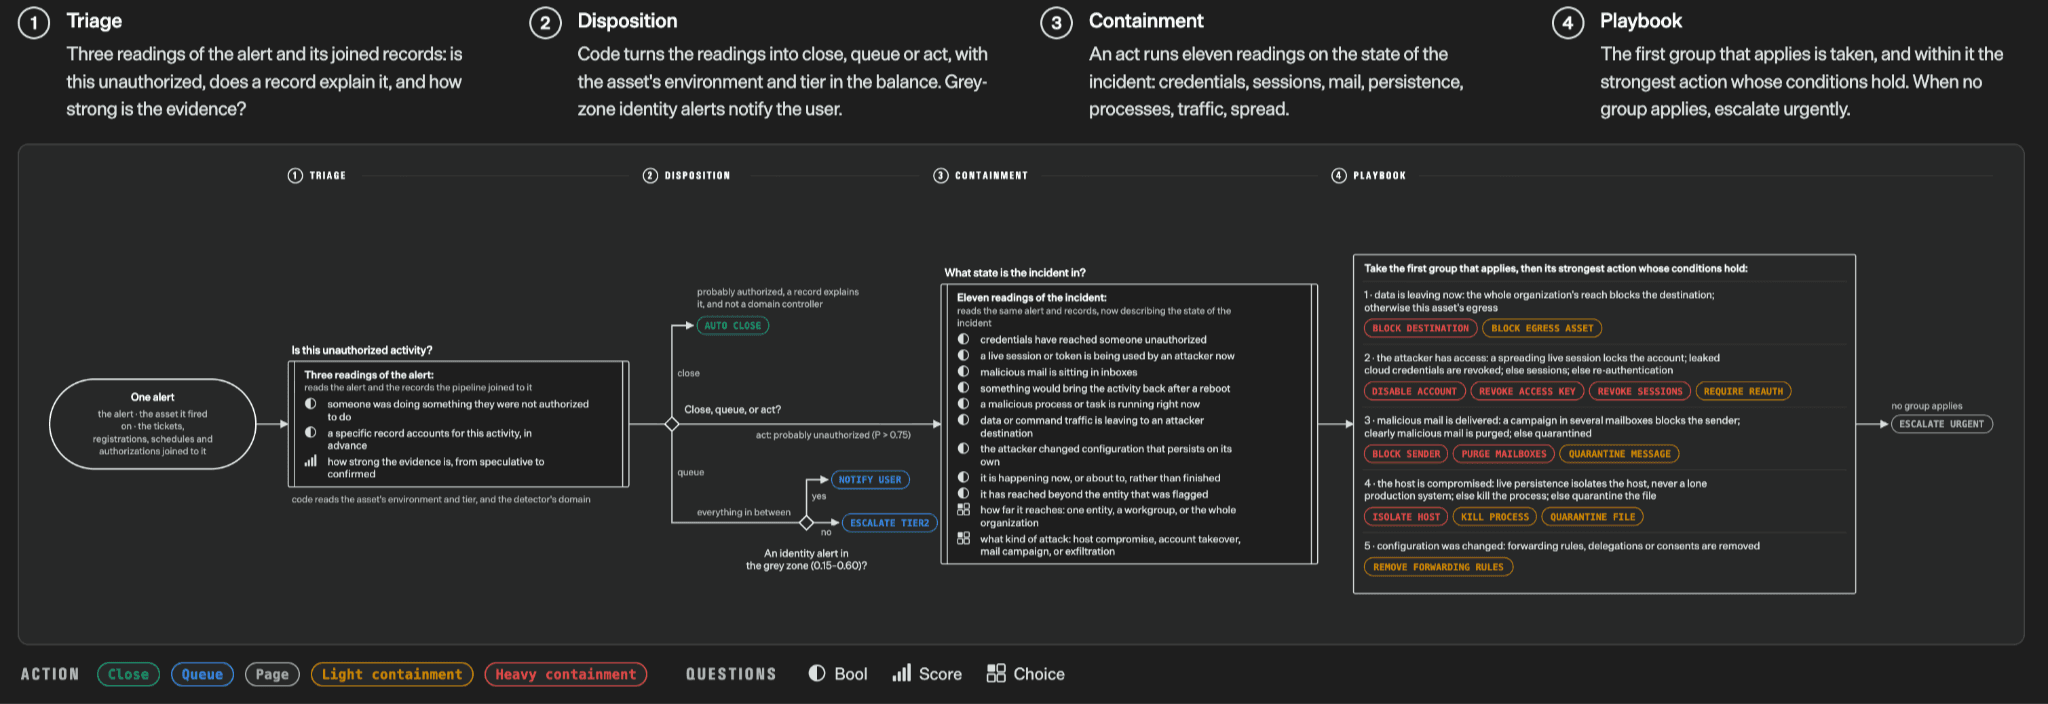
공식 출시 글에는 보안 경보 하나를 초기 분류(Triage) → 처리 방향(Disposition) → 격리(Containment) → 대응 절차(Playbook) 순서로 처리하는 평가용 흐름이 나온다. 공개된 네 가지 시나리오 중 가장 단순한 예제다.
AI 하나가 상황을 읽고 대응까지 알아서 다 하는 구조가 아니다. Jev는 단계마다 예/아니오·점수·선택 같은 작은 질문에만 답하고, 그 답을 모아 다음에 뭘 할지는 일반 코드가 정한다.
미국 상장사가 내는 연차보고서(10-K)의 사업 설명을 75개 산업 그룹 중 하나로 분류하는 예제다. 확신도가 0.9 이상이면 산업 그룹을 그대로 쓰고, 그보다 낮으면 한 단계 넓은 대분류로 올려서 답한다.
60개 문서를 이전 버전인 jev-1.12로 돌려 보니, 확신도가 높았던 절반은 90%를 맞혔고 낮았던 절반은 40%밖에 못 맞혔다. 그런데 낮은 쪽을 한 단계 넓은 대분류로 바꿔 답하게 하자 정답률이 70%까지 올라갔다.
여기서 배울 건 0.9라는 숫자가 아니다. 모델이 확신하지 못할 때 억지로 세부 항목을 고르게 하지 않고, 더 넓은 분류나 사람 검토로 돌리는 방식이다. 다만 문서가 60개뿐이고 이전 버전 기준이라, 이 숫자를 Jev 전체 정확도로 보면 안 된다.
공식 "확신도 기반 분기" 문서에는 음성으로 은행 업무를 보는 예시가 나온다. 잔액 조회처럼 틀려도 큰일 안 나는 동작과, 송금 승인처럼 틀리면 큰일 나는 동작에 서로 다른 기준값을 쓰는 방식이다.
문서 예시에서는 확신도 0.6 미만이면 상담원에게 넘기고, 송금 승인은 0.85를 넘을 때만 자동 승인하며 그 사이면 사용자에게 한 번 더 확인한다. 물론 이 숫자는 설명용이다. 실제 금융 서비스에 그대로 가져다 쓸 기준은 아니다.
| 사례 | Jev가 하는 일 | 코드·사람이 하는 일 |
|---|---|---|
| 보안 경보 처리 | 경보 성격, 증거 강도, 상태를 하나씩 판정 | 조직 정책 조합, 격리 명령, 담당자 호출 |
| SEC 산업 분류 | 75개 그룹 중 하나 선택 + 확신도 | 확신도가 낮으면 대분류나 사람 검토로 전환 |
| 음성 뱅킹 명령 | 의도 분류 + 확신도 | 동작별 기준값, 사용자 재확인, 실제 권한 검사 |
아래 실습을 전부 따라 할 필요는 없다.
처음이라면 Playground까지만 해도 Jev가 어떤 모델인지 충분히 감이 온다.
코드를 공부하는 중이라면 cURL과 Python 중 하나만 골라도 되고, 운영 검증은 필요할 때 다시 와서 봐도 늦지 않다.
다만 어느 실습이든 TypeSafe 크레딧이 충전돼 있어야 실제 결과를 받을 수 있다. 처음이라면 6장의 ‘시작 전 확인’부터 보고 오자.
실습 순서
Jev는 크레딧을 미리 충전해 두고 쓰는 방식이다. Playground에서 Run request(요청 실행)를 누르는 것도 실제 API 호출이라, 잔액이 없으면 로그인은 돼도 판정 결과는 받을 수 없다.
이런 화면이 보이면 충전 문제라고 보면 된다.
Your organization has no available TypeSafe API credits...(조직에 사용할 수 있는 TypeSafe API 크레딧이 없다) 문구가 나온다.ex) 잔액 부족
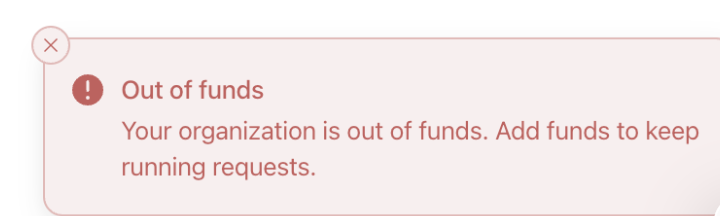
콘솔의 Billing(결제) 설정 화면에서 크레딧을 충전한 뒤 Run request를 다시 누르면 된다.
앞에서 넣어 둔 state와 질문은 그대로 둬도 된다.
내가 충전할 당시에는 최소 충전 금액이 $5여서 $5를 충전했다.
ex)
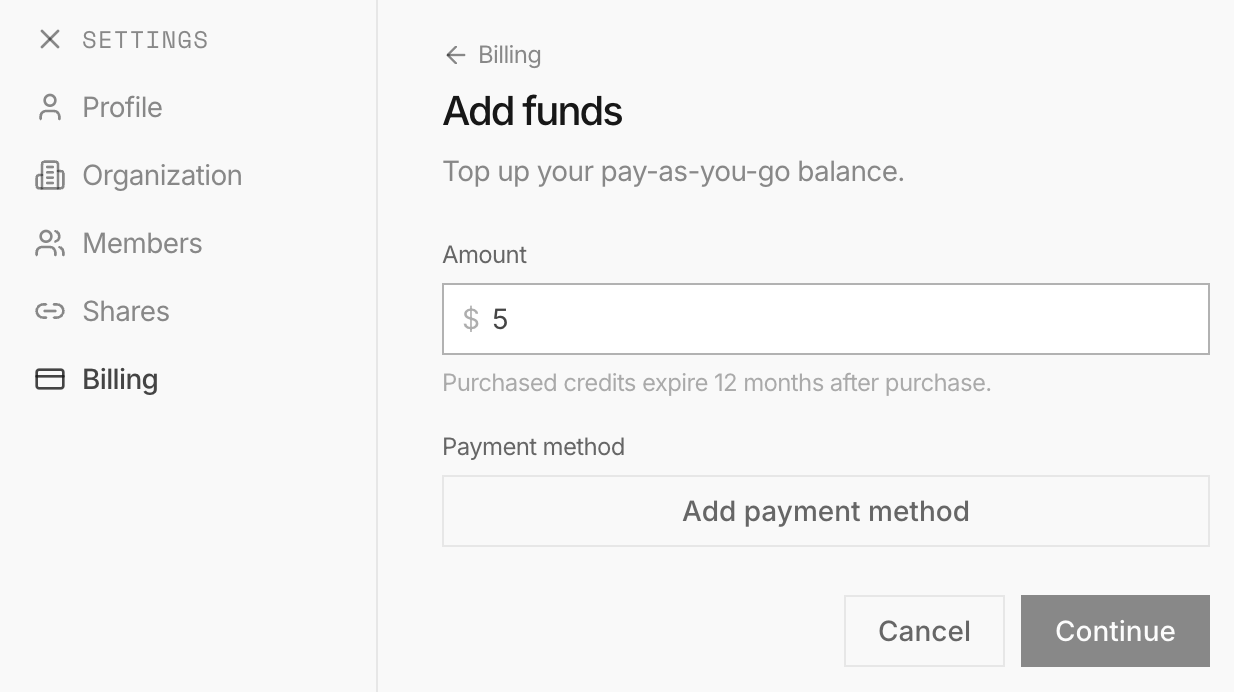
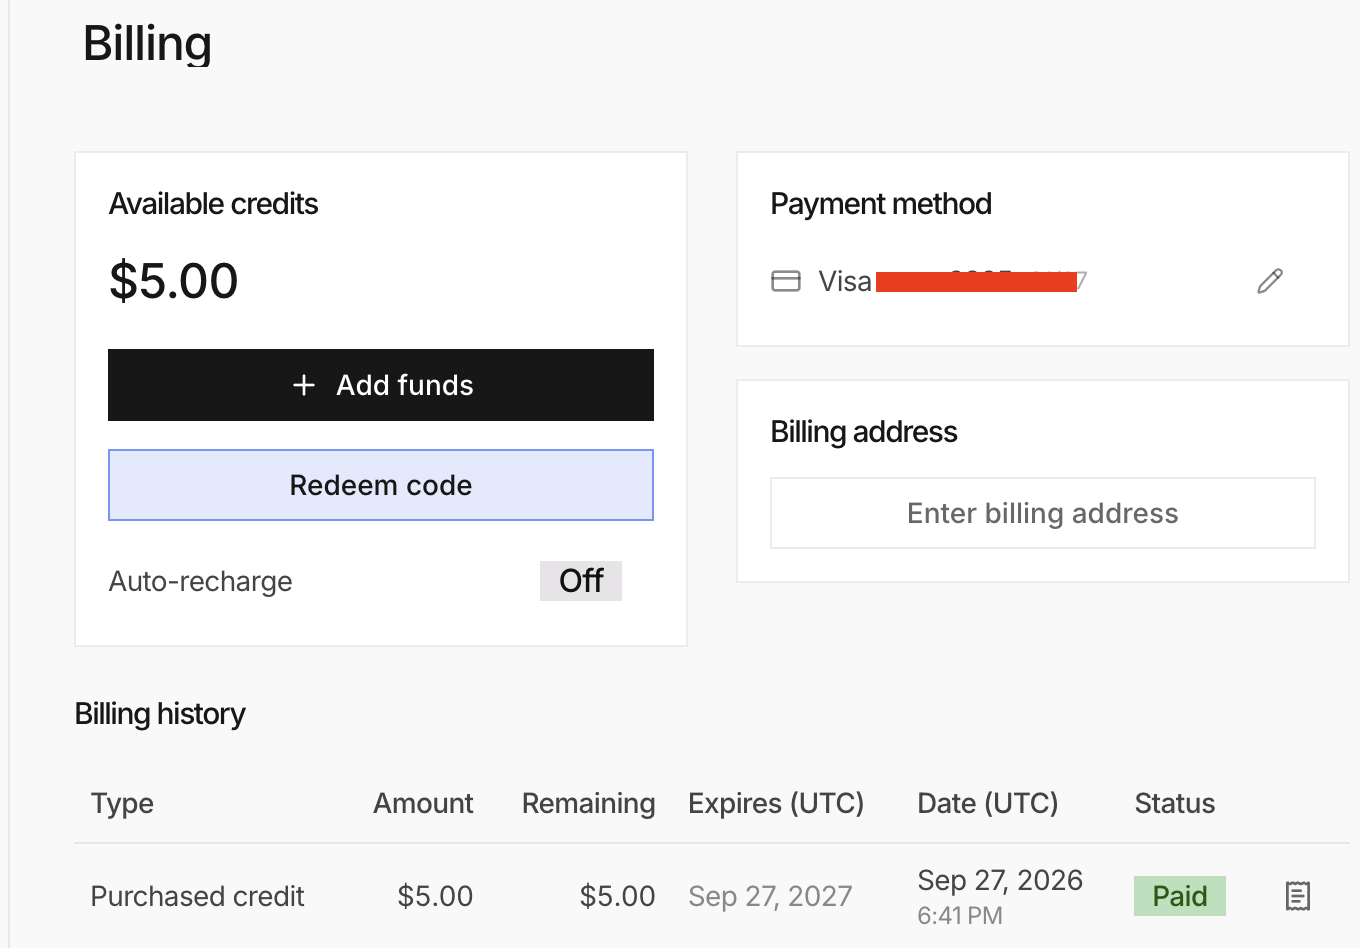
먼저 TypeSafe Playground에 로그인해보자.
state(판단할 자료)와 questions(질문 목록)를 입력하는 화면이 뜬다.
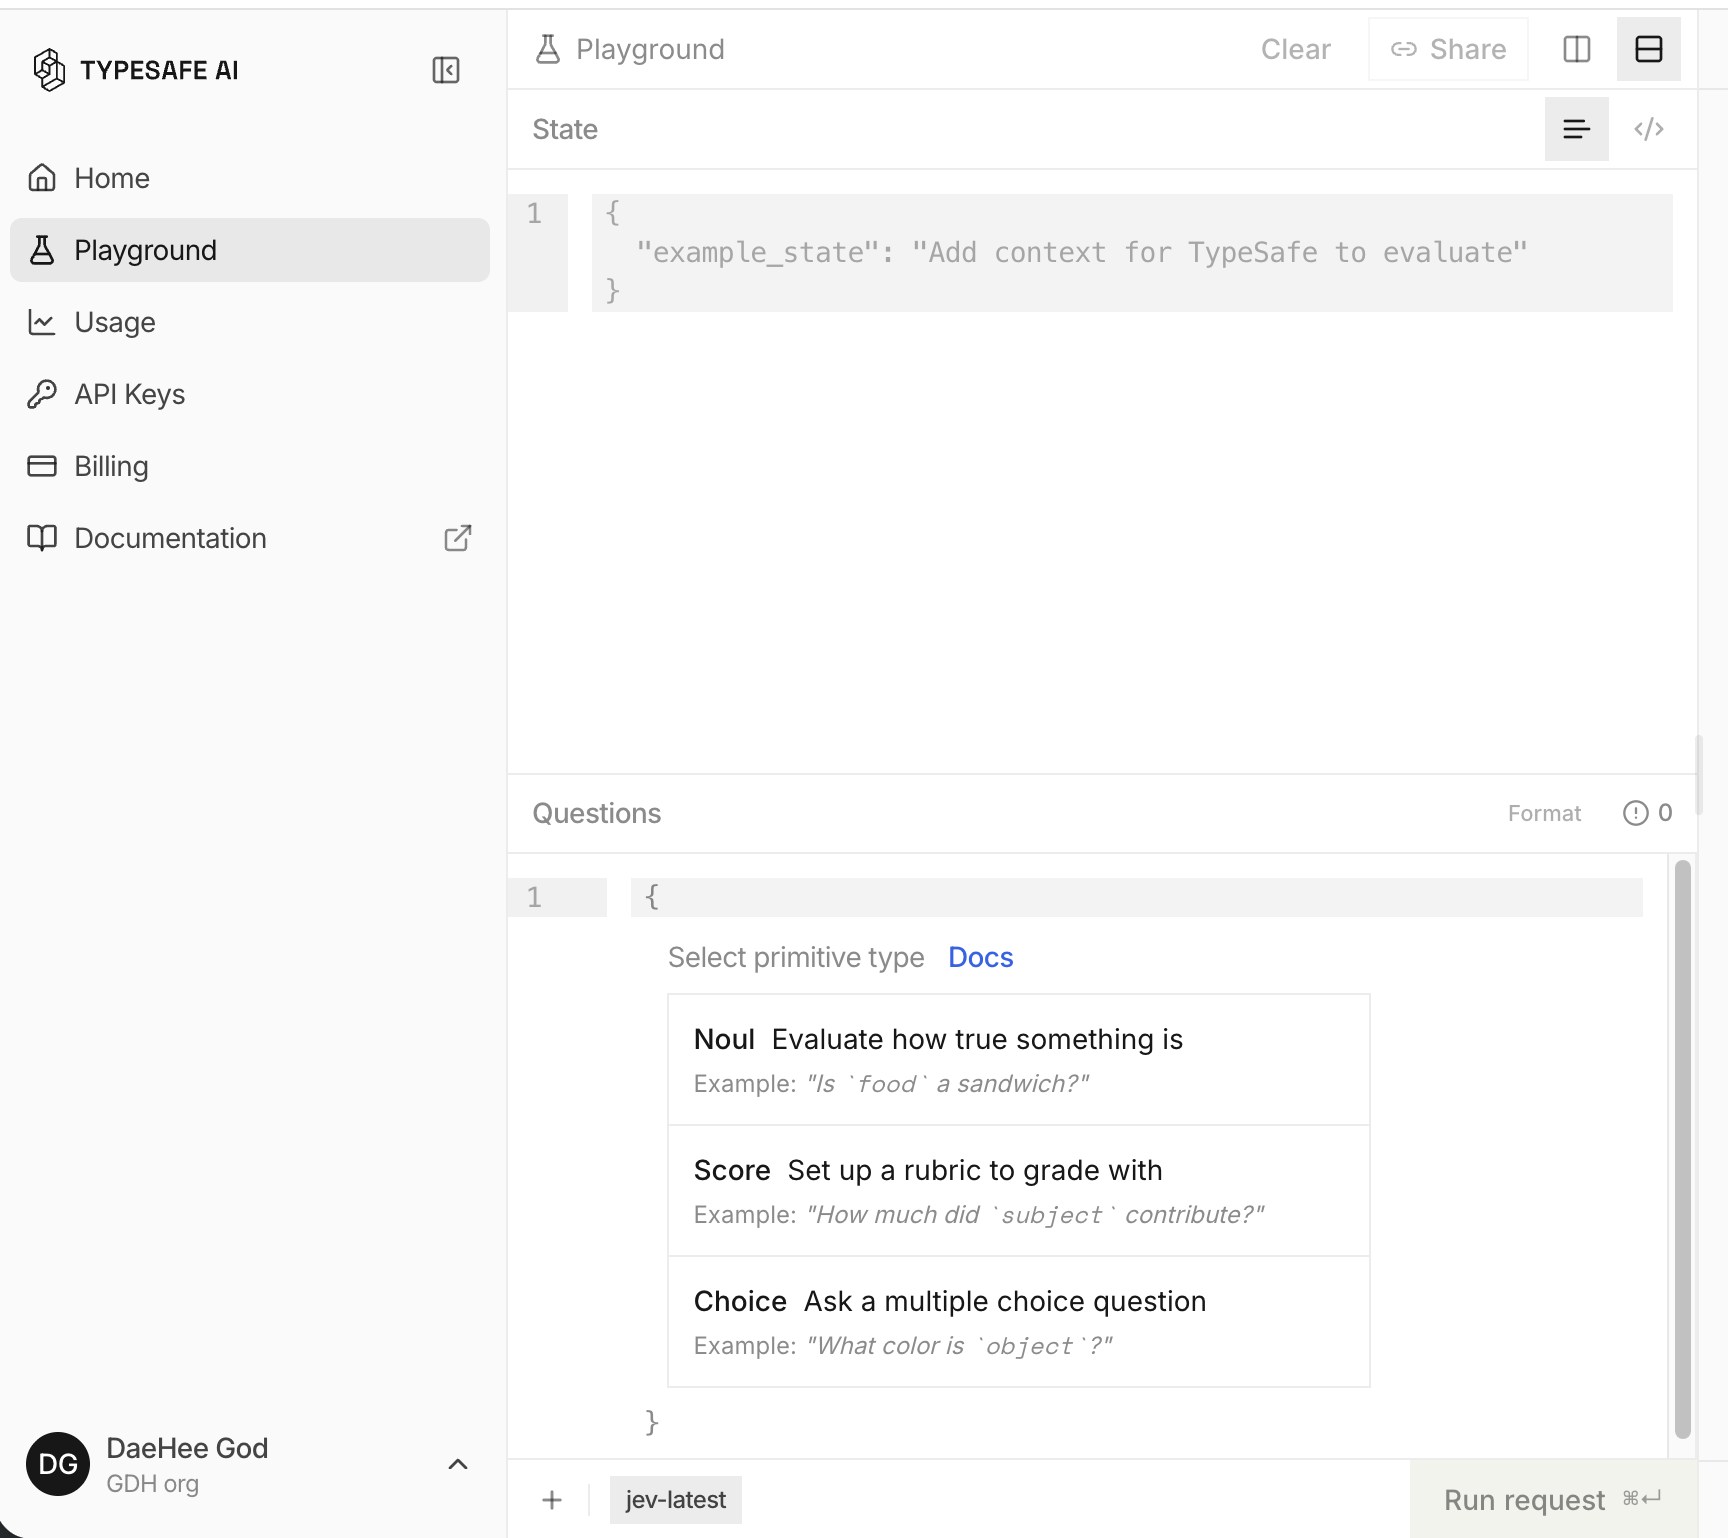
첫 테스트는 일부러 뜻이 분명한 문장으로 시작하는 게 좋다.
{
  "ticket": "결제가 두 번 됐습니다. 오늘 안에 중복 결제를 취소해 주세요.",
  "plan": "pro",
  "channel": "email"
}
필드 이름은 각각 ticket(문의 본문), plan(가입 요금제), channel(문의가 들어온 경로)이라는 뜻이다. 이름은 내가 정하면 되고, Jev는 이 JSON 전체를 판단할 자료로 읽는다.
왜 이렇게 넣을까? 실제 서비스처럼 필드는 나눠 넣되, 처음부터 로그나 긴 대화 기록까지 몽땅 넣을 필요는 없다.
그러면 결과가 이상할 때 질문을 잘못 쓴 건지, 모델이 헷갈린 건지 알기 어렵다.
화면에서 아래 뜻이 되도록 질문을 추가하면 된다.
버튼 이름은 콘솔 업데이트에 따라 조금 다를 수 있다.
questions에 들어갈 내용을 JSON으로 쓰면 아래와 같다. 7장의 cURL 예제에서도 이 JSON을 그대로 쓰니, 여기서 한 번 눈에 익혀 두자.
{
  "department": {
    "type": "choice",
    "instructions": "Which team should handle this ticket?",
    "criteria": {
      "billing": "Payments, invoices, refunds, or duplicate charges",
      "technical": "Bugs, outages, or integrations",
      "sales": "Pricing, upgrades, or new accounts",
      "other": "None of the above"
    }
  },
  "frustration": {
    "type": "score",
    "instructions": "How frustrated is the customer?",
    "criteria": ["Calm", "Frustrated", "Very angry"]
  },
  "is_urgent": {
    "type": "noul",
    "instructions": "Does the customer express an explicit time constraint?"
  }
}
코드 안의 영어 문장은 이런 뜻이다.
| 코드 안의 영어 | 뜻 |
|---|---|
Which team should handle this ticket? |
어느 팀이 이 문의를 처리해야 하는가? |
Payments, invoices, refunds, or duplicate charges |
billing(결제): 결제·청구서·환불·중복 결제 |
Bugs, outages, or integrations |
technical(기술): 버그·서비스 장애·연동 문제 |
Pricing, upgrades, or new accounts |
sales(영업): 가격·요금제 업그레이드·신규 계정 |
None of the above |
other(기타): 위 항목에 해당 없음 |
How frustrated is the customer? |
고객은 얼마나 불만인가? |
Calm / Frustrated / Very angry |
차분함 / 불만 / 매우 화남 (낮은 단계 → 높은 단계) |
Does the customer express an explicit time constraint? |
고객이 명확한 시간 제한을 말했는가? |
처음 보면 낯설 수 있으니 한 줄씩 짚어 보자.
department / frustration / is_urgent: 내가 붙이는 질문 이름이다(담당 부서 / 불만 정도 / 긴급 여부). 응답도 이 이름으로 돌아온다. 이 이름은 모델에게 전달되지 않으니, 이름에 판단 힌트를 넣어 봐야 소용없다.type(질문 형태): choice(하나 고르기), score(단계 점수), noul(예/아니오 확률) 중 하나를 쓴다.instructions(지시문): 모델에게 실제로 묻는 질문 문장이다.criteria(판정 기준): 답의 후보와 기준이다. Choice는 "선택지 이름: 설명" 모양이고, Score는 낮은 단계부터 높은 단계 순서로 2~10개를 적는다. Noul은 생략해도 되고, 필요하면 true(예)/false(아니오)가 각각 무슨 뜻인지 적을 수 있다.ex) 우측에 response(응답 결과)를 볼 수 있다.
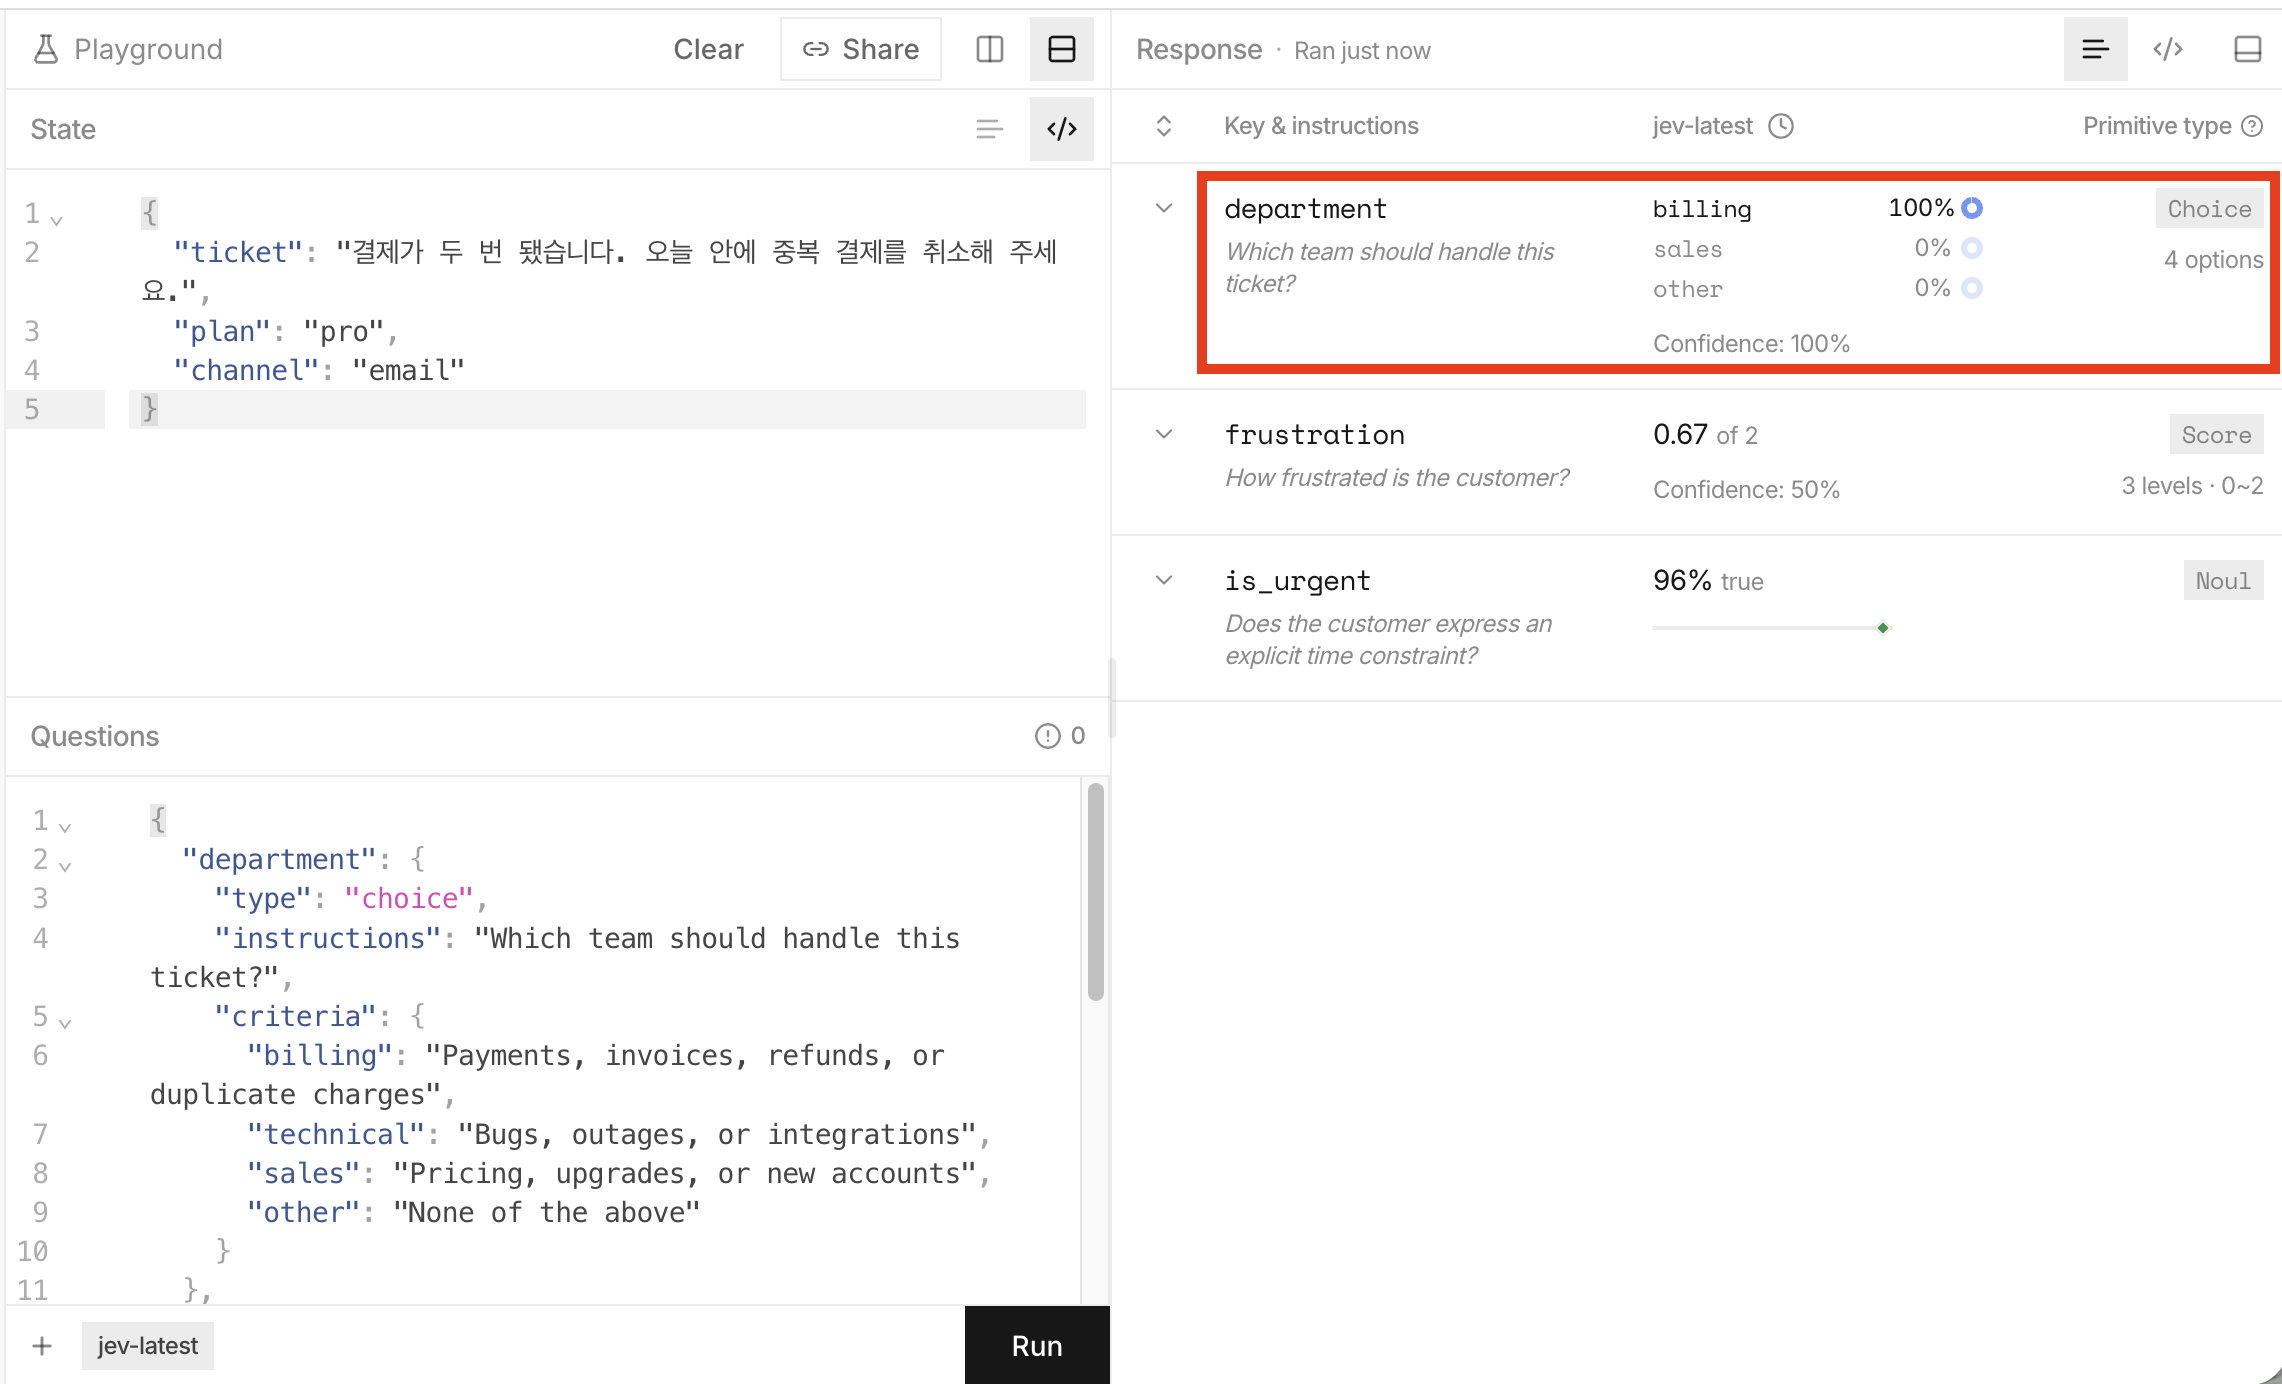
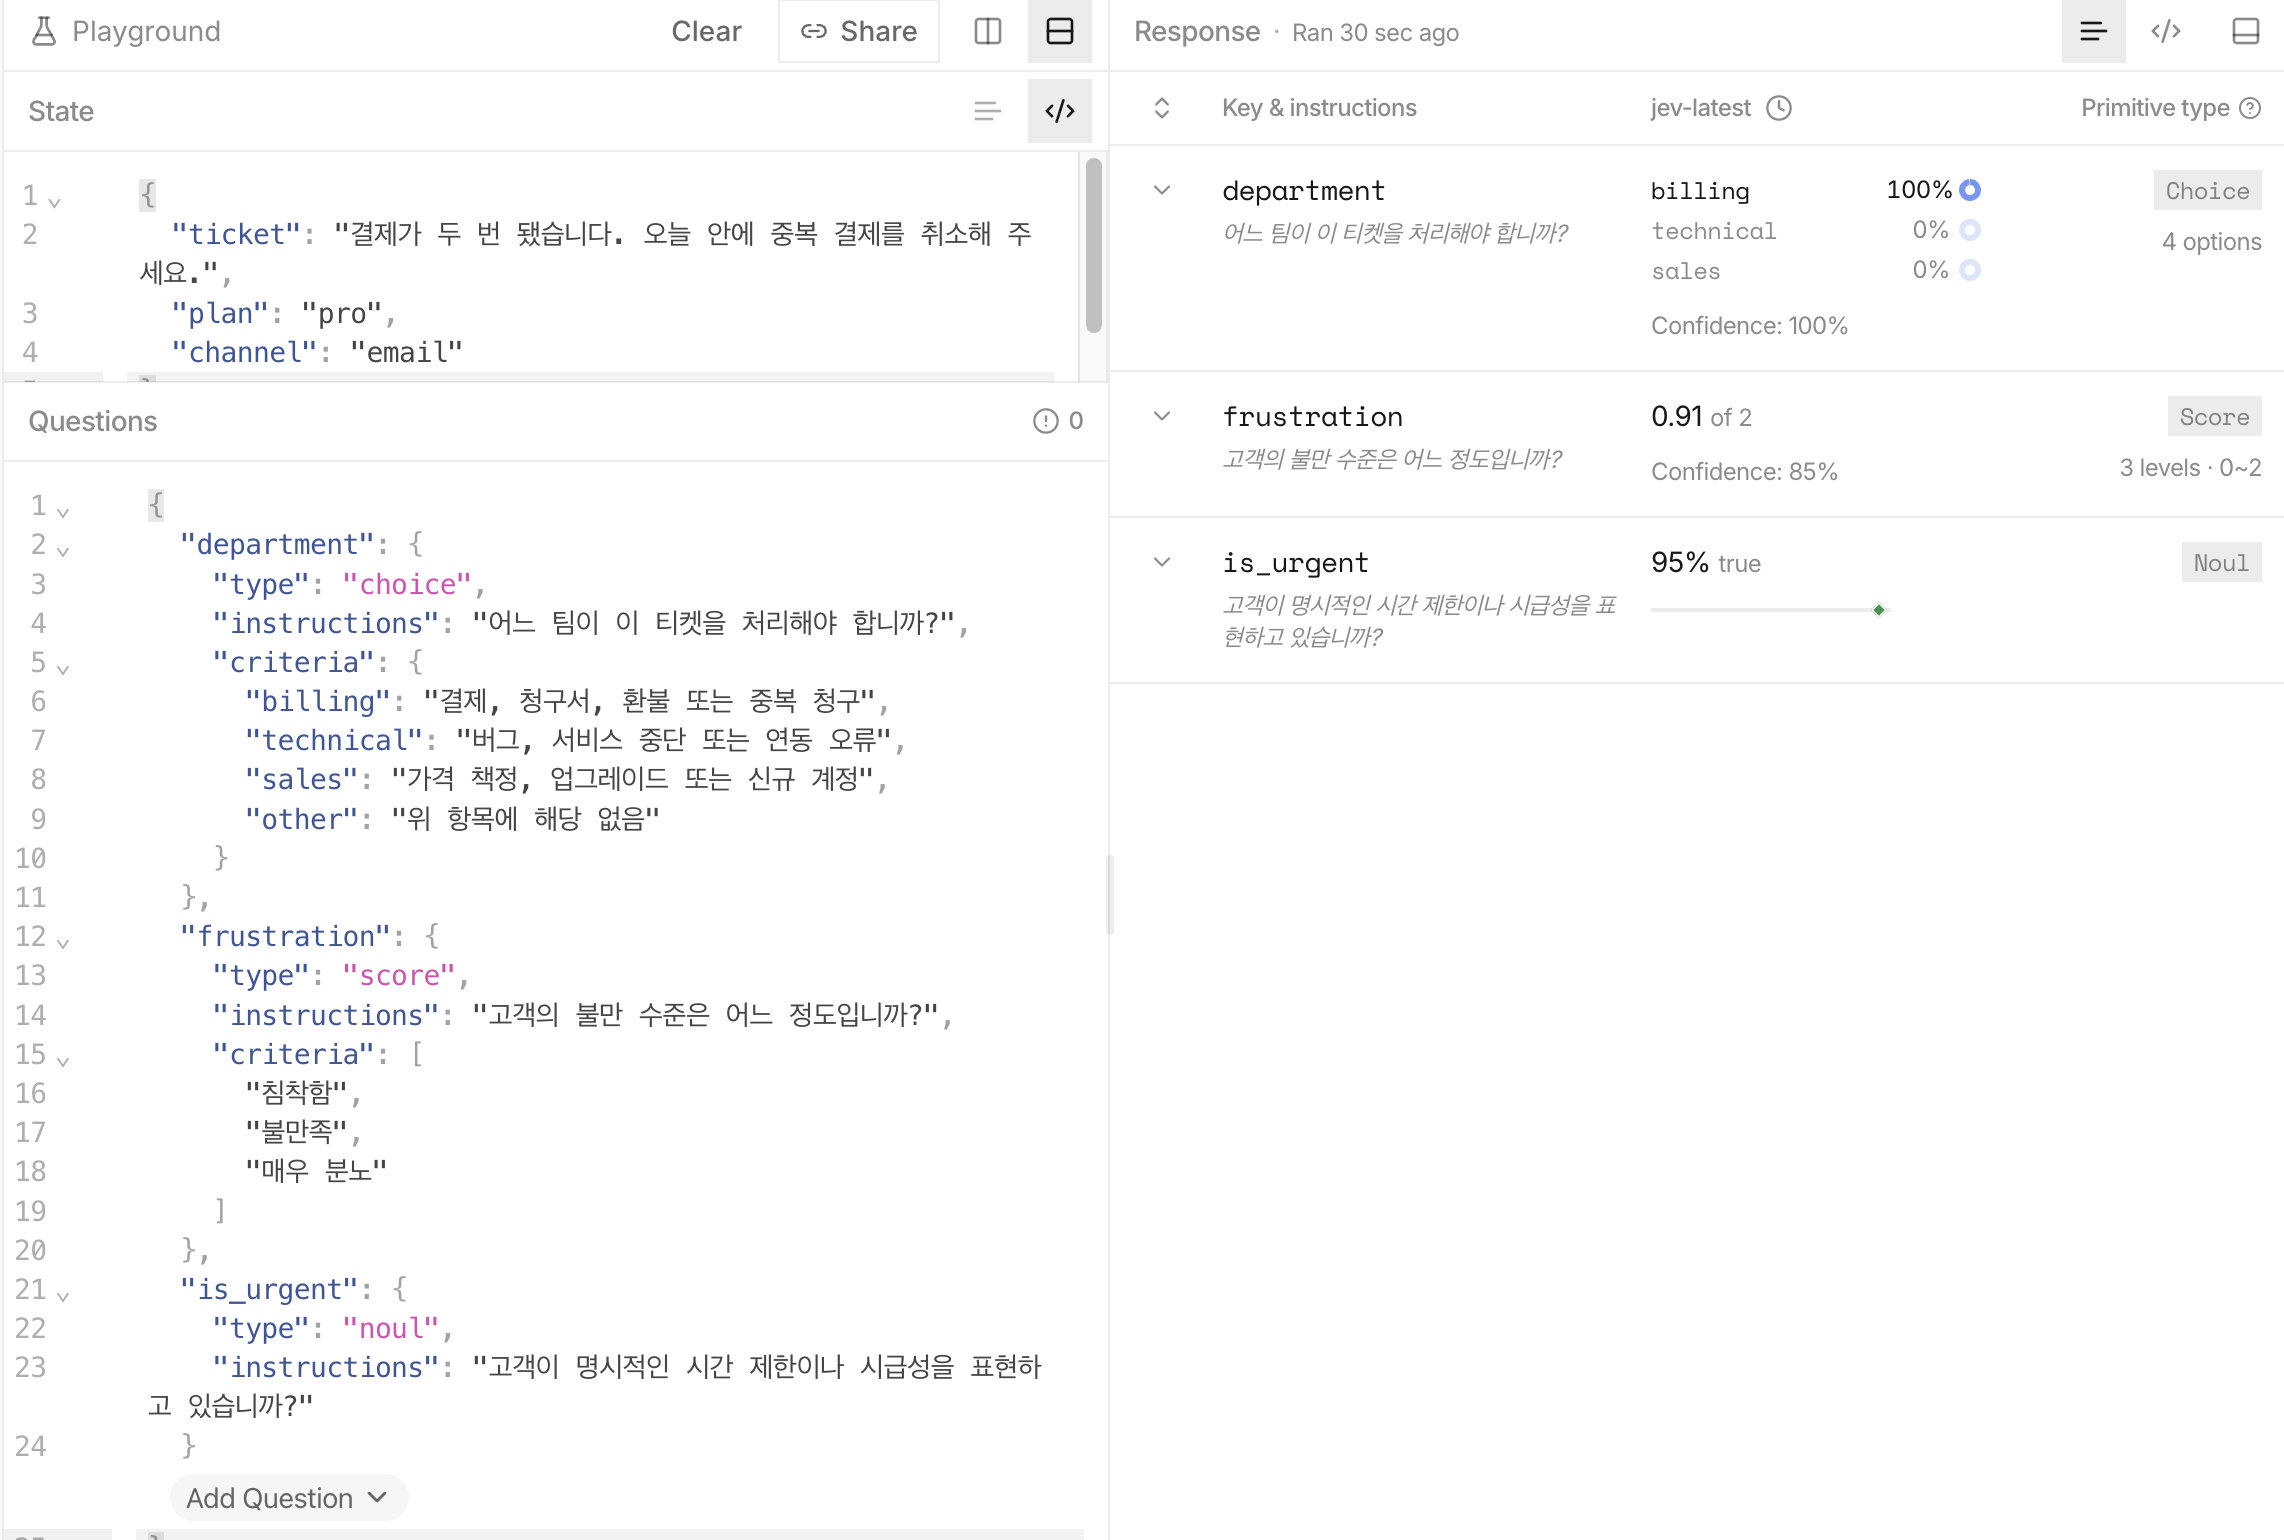
ex) 영어 질문을 권장하지만, 블로그 글의 이해를 돕기 위해 한글 질문으로도 한번 돌려 봤다.
{
  "department": {
    "type": "choice",
    "instructions": "어느 팀이 이 티켓을 처리해야 합니까?",
    "criteria": {
      "billing": "결제, 청구서, 환불 또는 중복 청구",
      "technical": "버그, 서비스 중단 또는 연동 오류",
      "sales": "가격 책정, 업그레이드 또는 신규 계정",
      "other": "위 항목에 해당 없음"
    }
  },
  "frustration": {
    "type": "score",
    "instructions": "고객의 불만 수준은 어느 정도입니까?",
    "criteria": ["침착함", "불만족", "매우 분노"]
  },
  "is_urgent": {
    "type": "noul",
    "instructions": "고객이 명시적인 시간 제한이나 시급성을 표현하고 있습니까?"
  }
}
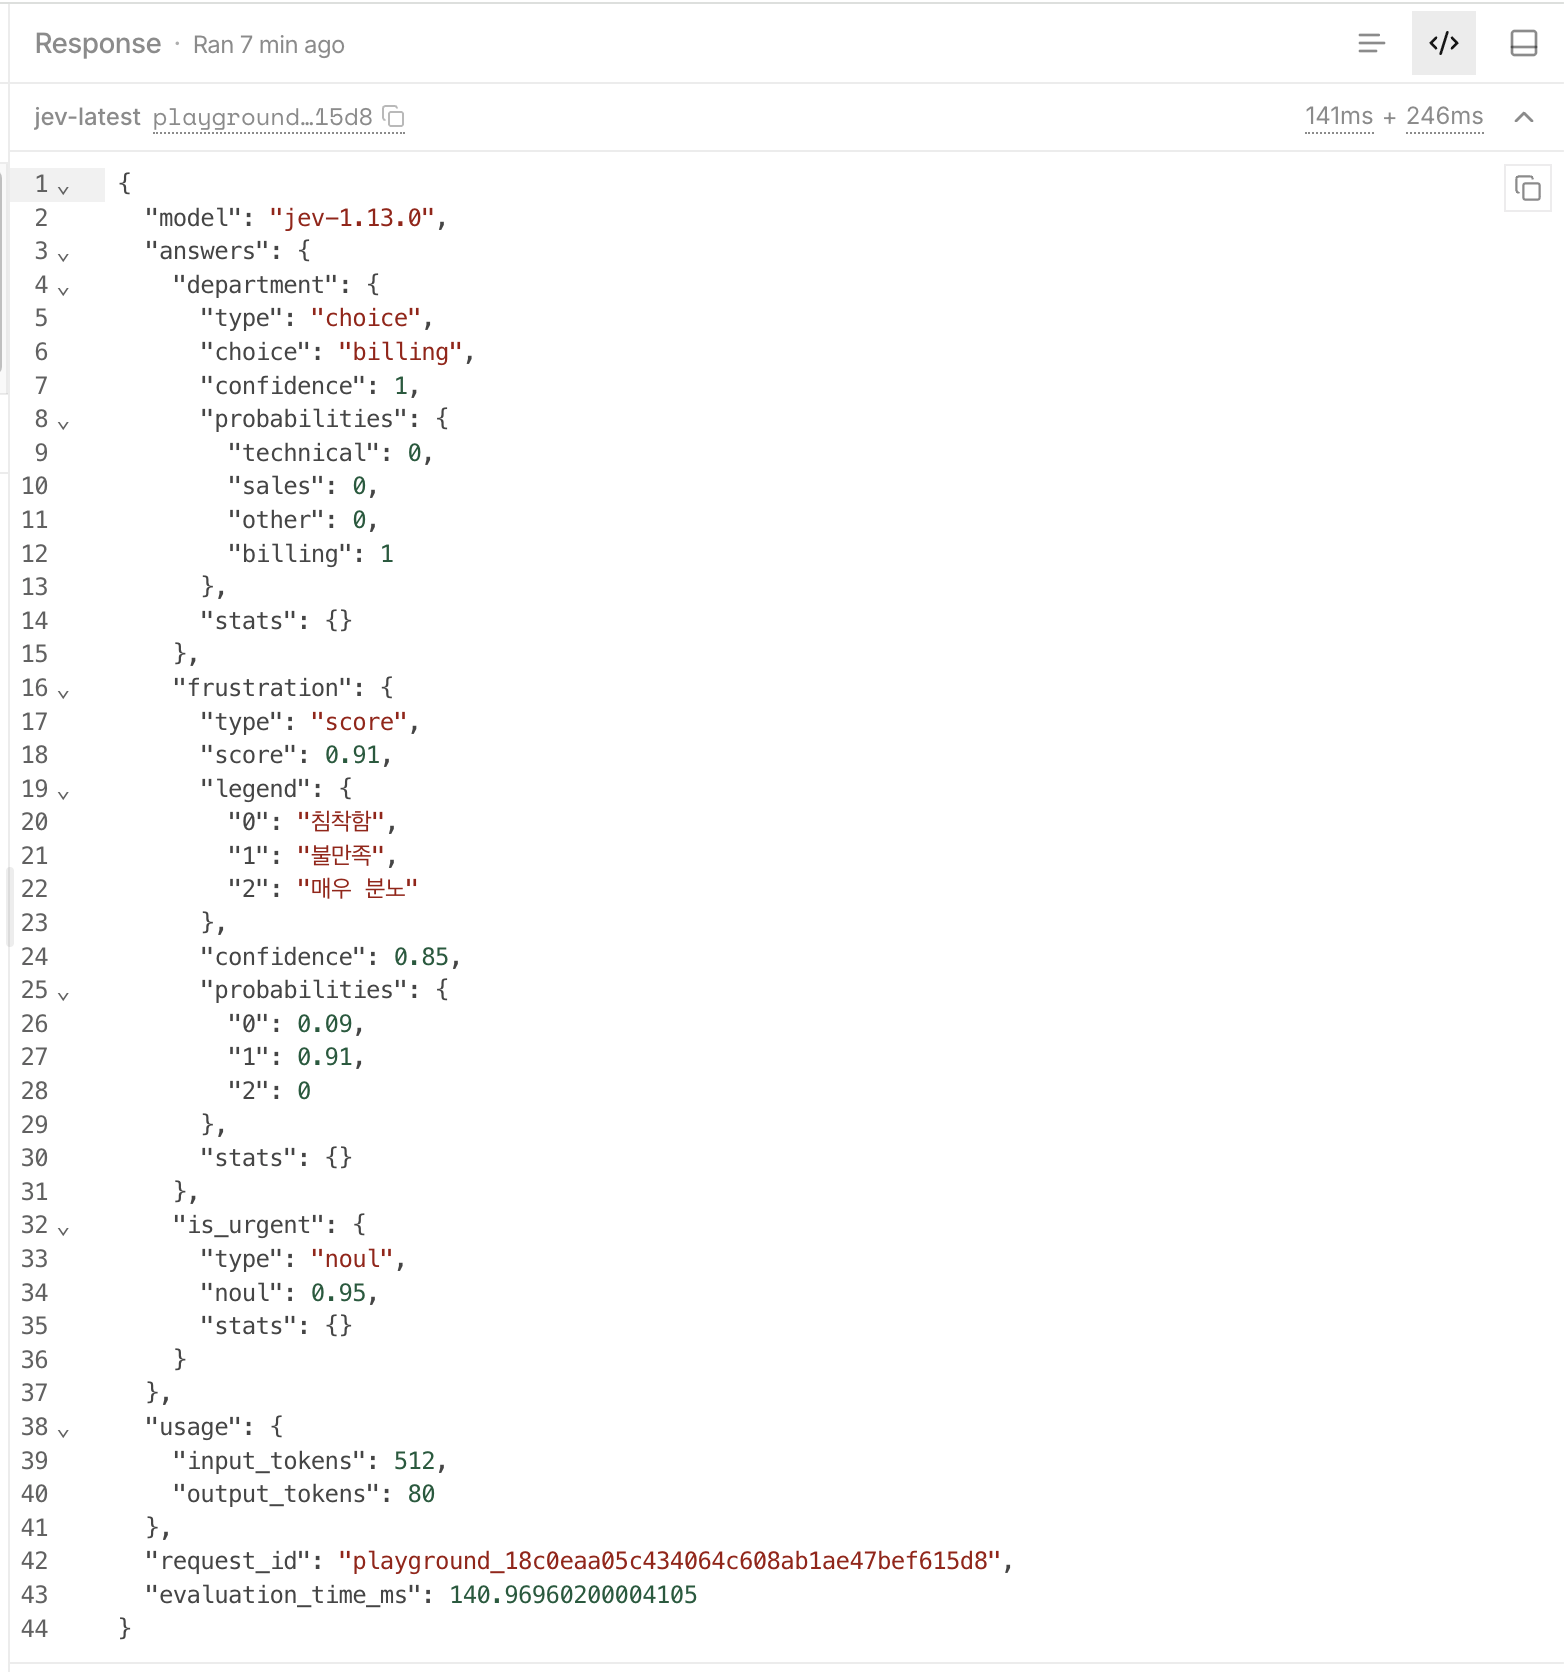
- 첫 번째 결과와 비교했을 때 frustration(불만 정도)은 조금 달라졌지만 is_urgent(긴급 여부)와 department(담당 부서)는 거의 같았다. 다만 불만 수준을 왜 이렇게 판단했는지에 대한 설명은 응답에 없다.
아래는 공식 API 문서에 실린 Choice(하나 고르기)·Score(단계 점수)·Noul(예/아니오 확률) 응답 예시를 한곳에 모아 본 것이다. 문서 예시는 질문 형태별로 따로 보낸 요청이라, 숫자는 우리 문의를 넣었을 때 나올 값이 아니다. 모양만 눈에 익혀 두자.
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "billing",
      "probabilities": { "billing": 0.88, "technical": 0.12, "sales": 0.0 },
      "confidence": 0.81
    },
    "frustration": {
      "type": "score",
      "score": 1.05,
      "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
      "probabilities": { "0": 0.0, "1": 0.95, "2": 0.05 },
      "confidence": 0.92
    },
    "is_urgent": {
      "type": "noul",
      "noul": 0.95
    }
  }
}
문서의 Choice 예시는 선택지가 billing·technical·sales 세 개라 확률도 세 개만 있다.
우리처럼 other(기타)를 추가했다면 other의 확률도 같이 온다.
ex) 한글화한 요청에 대한 응답을 json으로 바꿔 캡처해 보았다.
| 필드 | 뜻 | 공식 예시를 읽으면 |
|---|---|---|
choice(고른 답) |
고른 선택지 | billing(결제)으로 분류했다 |
probabilities(확률) |
선택지(단계)별 확률. 모두 더하면 1이다 | billing(결제) 0.88, technical(기술) 0.12 |
confidence(확신도) |
확률이 한쪽으로 얼마나 몰렸는지 나타낸 값. 11장에서 자세히 다룬다 | department 0.81이면 billing 쪽으로 꽤 몰린 편이다 |
score(점수) |
단계 번호 기준 점수. 단계 사이 값도 나온다 | 1.05 → 1번 Frustrated(불만) 근처, 아주 살짝 Very angry(매우 화남) 쪽 |
legend(범례) |
단계 번호와 이름의 짝 | 0=Calm(차분함), 1=Frustrated(불만), 2=Very angry(매우 화남) |
noul(예일 확률) |
"예"일 확률(0~1). 별도 확신도는 없다 | 0.95 → 거의 확실하게 "예" |
참고로 score 값은 단계별 확률로 평균을 낸 것과 같다.
공식 예시도 0×0.0 + 1×0.95 + 2×0.05 = 1.05로 딱 맞아떨어진다.
이번에는 "앱이 안 되는데 결제도 확인해 주세요"처럼 기술 문제와 결제 문제가 섞인 문의로 바꿔보자. 여러 선택지의 확률이 비슷해지고 확신도도 내려가는지 보면 된다.
질문은 Step 3 그대로 두고, state만 아래처럼 바꾸면 된다.
{
  "ticket": "앱이 자꾸 튕겨요. 그리고 이번 달 요금이 제대로 결제됐는지도 확인해 주세요.",
  "plan": "pro",
  "channel": "email"
}
Step 2 문의와 결과를 나란히 놓고 보면 차이가 잘 보인다.
ex) 결과 예시(나의 경우는 블로그를 위해 한글화한 예시를 사용 중이다.)
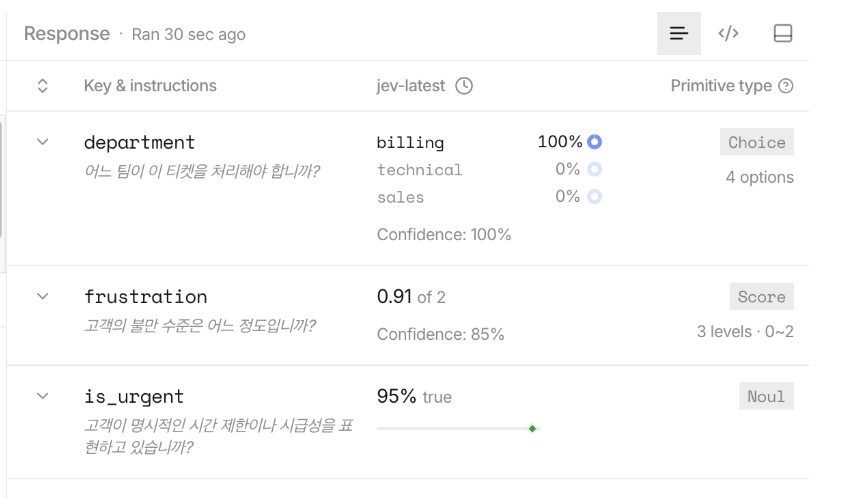
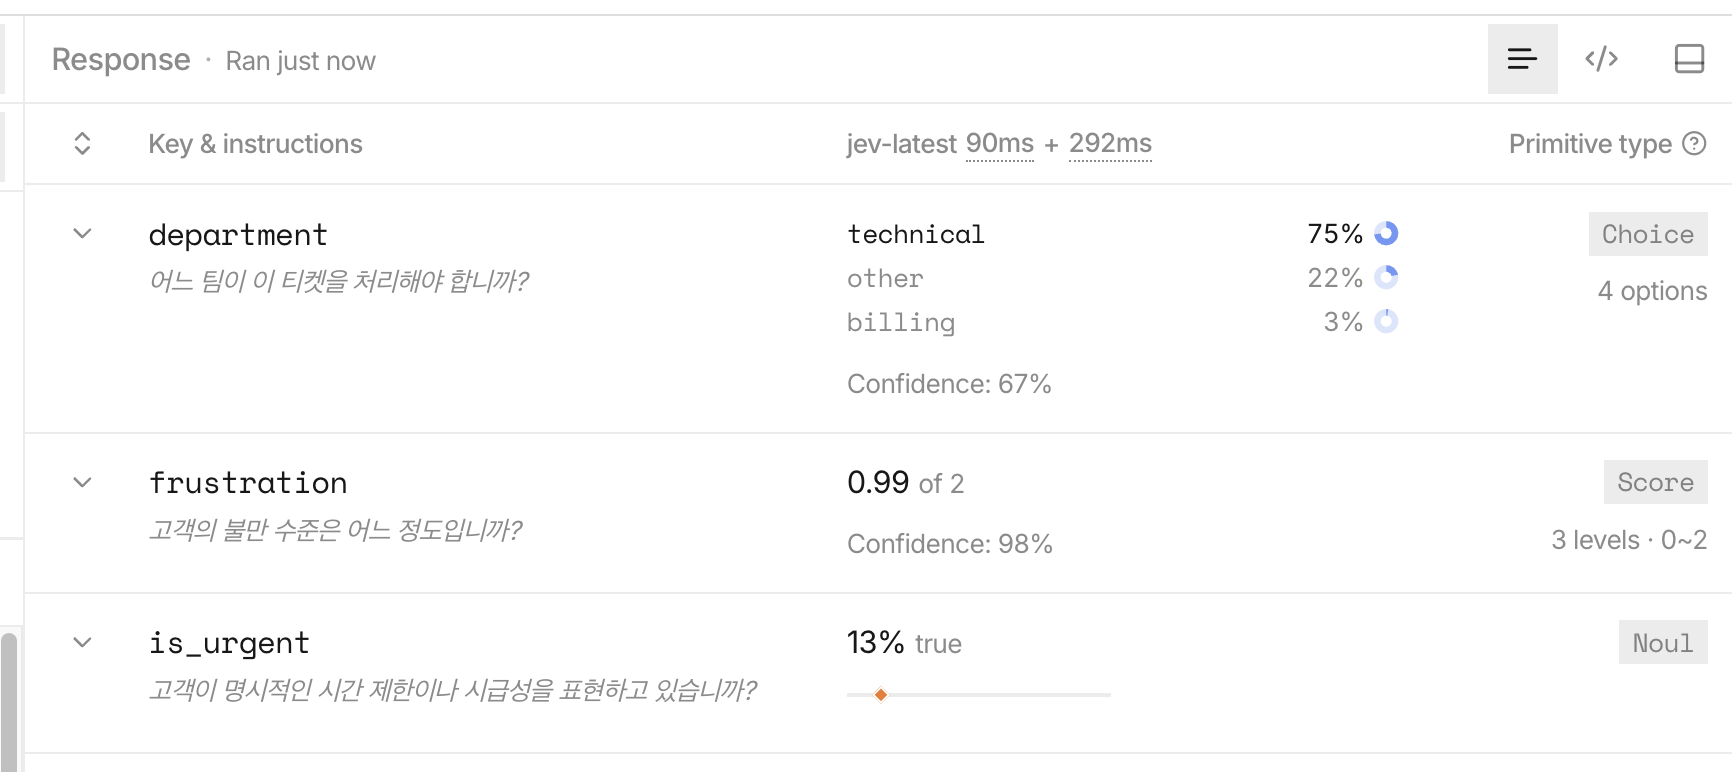
| 볼 곳 | Step 2 문의 (뜻이 분명함) | Step 4 문의 (두 문제가 섞임) |
|---|---|---|
department.probabilities(부서별 확률) |
billing(결제) 한 곳으로 몰린다 | technical(기술), other(기타), billing(결제)으로 결과가 나뉜다 |
is_urgent.noul(긴급할 확률) |
"오늘 안에"라는 기한이 있어 높게 나올 가능성이 크다 | 기한을 말하지 않아 낮게 나올 가능성이 크다 |
애매한 문의인데도 한 선택지의 확신도가 높게 나온다면, 그게 바로 운영 전에 찾아내야 하는 사례다.
여기서 보려는 건 정답이 아니다. 애매한 문장을 넣었을 때 모델도 "애매하다"는 티를 내는지 보는 것이다.
결과가 이상하다면: 선택지 설명이 서로 겹치지 않는지 먼저 확인해보자. other(기타)가 빠져 있다면 추가하고, 질문 하나에 판단 두 개를 넣지 않았는지도 살펴보면 된다.
처음에 자주 하는 실수를 예시로 모아 보면 이렇다.
| 자주 하는 실수 | 이렇게 쓰면 헷갈린다 | 이렇게 고치자 |
|---|---|---|
| 선택지 설명이 겹친다 | billing(결제): Payment questions(결제 관련 질문) sales(영업): Questions about plans and payments(요금제와 결제에 관한 질문) → 둘 다 "결제"를 포함해서 어느 쪽인지 애매하다 |
billing(결제): Payments, invoices, refunds, or duplicate charges(결제·청구서·환불·중복 결제) sales(영업): Pricing, upgrades, or new accounts(가격·요금제 업그레이드·신규 계정) |
| 질문 하나에 판단이 두 개 | Is the customer angry and is it urgent?(고객이 화가 났고, 급한 건인가?) → 화는 났는데 급하지 않으면 어떻게 답할지 애매하다 |
frustration(불만 정도, Score)와 is_urgent(긴급 여부, Noul) 두 질문으로 나눈다 |
| 어디에도 안 맞는 경우를 안 받아 준다 | billing(결제)·technical(기술)·sales(영업)만 둔다 | "other": "None of the above"(기타: 위 항목에 해당 없음)를 추가한다 |
| 예/아니오 기준이 모호하다 | Is this urgent?(급한 건인가?) → 무엇을 "급하다"고 볼지 모델이 알아서 정한다 |
Does the customer express an explicit time constraint?(고객이 명확한 시간 제한을 말했는가?) 처럼 조건을 적거나, criteria(판정 기준)에 true(예)/false(아니오)의 뜻을 적는다 |
실습 순서
전부 할 필요는 없다. Step 1~3 중 하나만 해봐도 충분하다.
API 키는 콘솔의 API Keys 메뉴에서 만들고 환경변수에 넣어두자.
코드, 화면 캡처, n8n 본문에 키를 직접 적으면 안 된다.
키를 만들었다고 바로 호출되는 건 아니다. 6장에서 본 것처럼 크레딧이 충전돼 있어야 한다.
아래는 macOS·Linux 터미널 기준이다. Windows를 쓴다면 바로 아래 PowerShell 예시를 보거나 Python 실습으로 넘어가도 된다.
export TYPESAFE_API_KEY="YOUR_KEY"

curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "state": {
      "ticket": "결제가 두 번 됐습니다. 오늘 안에 취소해 주세요."
    },
    "model": "jev-latest",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
          "billing": "Payments, invoices, refunds, or duplicate charges",
          "technical": "Bugs, outages, or integrations",
          "sales": "Pricing, upgrades, or new accounts",
          "other": "None of the above"
        }
      },
      "frustration": {
        "type": "score",
        "instructions": "How frustrated is the customer?",
        "criteria": ["Calm", "Frustrated", "Very angry"]
      },
      "is_urgent": {
        "type": "noul",
        "instructions": "Does the customer express an explicit time constraint?"
      }
    }
}'위 명령에서 -d ' 뒤의 JSON 본문만 request.json 파일로 저장하고, 같은 폴더에서 아래 명령을 실행하면 된다.
$env:TYPESAFE_API_KEY = "YOUR_KEY"
$headers = @{ Authorization = "Bearer $env:TYPESAFE_API_KEY" }
$body = Get-Content .\request.json -Raw -Encoding UTF8

Invoke-RestMethod `
  -Uri "https://api.typesafe.ai/v1/systemone" `
  -Method Post `
  -Headers $headers `
  -ContentType "application/json; charset=utf-8" `
  -Body ([System.Text.Encoding]::UTF8.GetBytes($body))
한글이 깨지지 않게 UTF-8로 읽어서 보내도록 해 뒀다.
응답 모양은 6장 Step 3에서 본 예시와 같다. 필드 뜻이 헷갈리면 그 표를 다시 보면 된다.
ex) 결과는 포맷팅만 조금 예쁘게 해서 남겨 두겠다.
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "billing",
      "confidence": 1,
      "probabilities": {
        "billing": 1,
        "technical": 0,
        "other": 0,
        "sales": 0
      }
    },
    "frustration": {
      "type": "score",
      "score": 0.72,
      "confidence": 0.58,
      "legend": {
        "0": "Calm",
        "1": "Frustrated",
        "2": "Very angry"
      },
      "probabilities": {
        "0": 0.28,
        "1": 0.72,
        "2": 0
      }
    },
    "is_urgent": {
      "type": "noul",
      "noul": 0.96
    }
  },
  "usage": {
    "input_tokens": 441,
    "output_tokens": 80
  }
}
안 되면 상태 코드부터 보자.
Authorization: Bearer 헤더를 먼저 확인해보자.402일 때 응답 본문은 대략 이런 모양이다. Playground에서 본 Billing error 문구와 같다.
{
  "detail": {
    "error_type": "billing_error",
    "message": "Your organization has no available TypeSafe API credits..."
  }
}
한 사용자가 GitHub 이슈에 공유한 응답 형태를 옮겨 적었다.
메시지 끝부분은 줄였다. billing_error는 결제 오류, 메시지는 "조직에 사용할 수 있는 TypeSafe API 크레딧이 없다"는 뜻이다.
Node.js 20 이상에서 공식 SDK를 설치하면 된다.
npm install @typesafe-ai/sdkimport { choice, noul, score, TypeSafeClient } from "@typesafe-ai/sdk";
const client = new TypeSafeClient(); // 환경변수 TYPESAFE_API_KEY 사용
const response = await client.systemOne({
state: {
ticket: "결제가 두 번 됐습니다. 오늘 안에 취소해 주세요.",
},
questions: {
department: choice("Which team should handle this ticket?", {
billing: "Payments, invoices, refunds, or duplicate charges",
technical: "Bugs, outages, or integrations",
sales: "Pricing, upgrades, or new accounts",
other: "None of the above",
}),
frustration: score("How frustrated is the customer?", [
"Calm",
"Frustrated",
"Very angry",
]),
isUrgent: noul("Does the customer express an explicit time constraint?"),
},
});
console.log(response.answers.department);
console.log(response.answers.frustration);
console.log(response.answers.isUrgent);질문 문장과 선택지는 Step 1의 cURL 예제와 같다. 영어 문장의 뜻은 6장 Step 3의 표를 보면 된다.
패키지 이름은 typesafe-sdk다. 공식 README는 uv add typesafe-sdk를 안내하고, pip를 쓴다면 아래처럼 설치하면 된다.
pip install typesafe-sdkfrom typesafe_sdk import Choice, Noul, Score, TypeSafeClient
with TypeSafeClient() as client:
response = client.system_one(
state={
"ticket": "결제가 두 번 됐습니다. 오늘 안에 취소해 주세요."
},
questions={
"department": Choice(
instructions="Which team should handle this ticket?",
criteria={
"billing": "Payments, invoices, refunds, or duplicate charges",
"technical": "Bugs, outages, or integrations",
"sales": "Pricing, upgrades, or new accounts",
"other": "None of the above",
},
),
"frustration": Score(
instructions="How frustrated is the customer?",
criteria=["Calm", "Frustrated", "Very angry"],
),
"is_urgent": Noul(
instructions="Does the customer express an explicit time constraint?"
),
},
)
print(response.choices["department"].choice)
print(response.scores["frustration"].score)
print(response.nouls["is_urgent"].noul)Python SDK는 결과를 choices(Choice 결과), scores(Score 결과), nouls(Noul 결과)처럼 타입별로 나눠서 돌려준다. TypeScript SDK의 answers 구조와 조금 다르니 헷갈리지 않게 주의하자.
여러 AI 서비스를 Vercel AI Gateway로 묶어 관리하고 있다면 Jev도 같은 사용량·로그·예산 화면에 넣을 수 있다.
Gateway는 "여러 AI API 앞에 두는 공용 접수 창구" 정도로 이해하면 된다.
새로 연동한다면 모델 이름은 typesafe-ai/jev, 주소는 /v1/evaluate를 쓴다.
한 가지 주의할 점이 있다.
Vercel 경로에서는 예/아니오 질문 타입 이름이 noul이 아니라 boolean(참/거짓)이다.
curl https://ai-gateway.vercel.sh/v1/evaluate \
  -H "Authorization: Bearer $AI_GATEWAY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "typesafe-ai/jev",
    "state": "결제가 두 번 됐습니다. 환불 담당자와 이야기하고 싶어요.",
    "questions": {
      "needs_human": {
        "type": "boolean",
        "instructions": "Does the customer explicitly ask to talk to a human agent?"
      }
    }
  }'
여기서 needs_human(사람 상담 필요 여부) 질문은 "고객이 사람 상담원과 이야기하고 싶다고 분명히 요청했는가?"라는 뜻이다.
이미 TypeSafe SDK로 짠 코드가 있다면 굳이 바꿀 필요는 없다.
클라이언트의 baseURL을 https://ai-gateway.vercel.sh/typesafe로 바꾸고 키만 Gateway 키로 넣으면, noul 질문과 응답 모양은 그대로 쓸 수 있다.
이 경로로 호출하면 비용은 TypeSafe 크레딧이 아니라 Vercel 쪽 결제로 나간다. TypeSafe 콘솔 잔액이 0이어도 Gateway 호출이 된다면 이 때문이니, 어느 쪽에서 돈이 나가는지 헷갈리지 않게 정리해 두자.
AI SDK를 쓰는 프로젝트라면 실험 기능인 experimental_evaluate를 쓸 수 있다.
Vercel 안내 기준으로 AI SDK 7.0.105 이상에서 지원한다.
이름에 experimental이 붙은 만큼 업데이트 때 사용법이 바뀔 수 있으니, 패키지 버전을 고정하고 업데이트 전에는 기존 테스트를 다시 돌려보는 게 좋다.
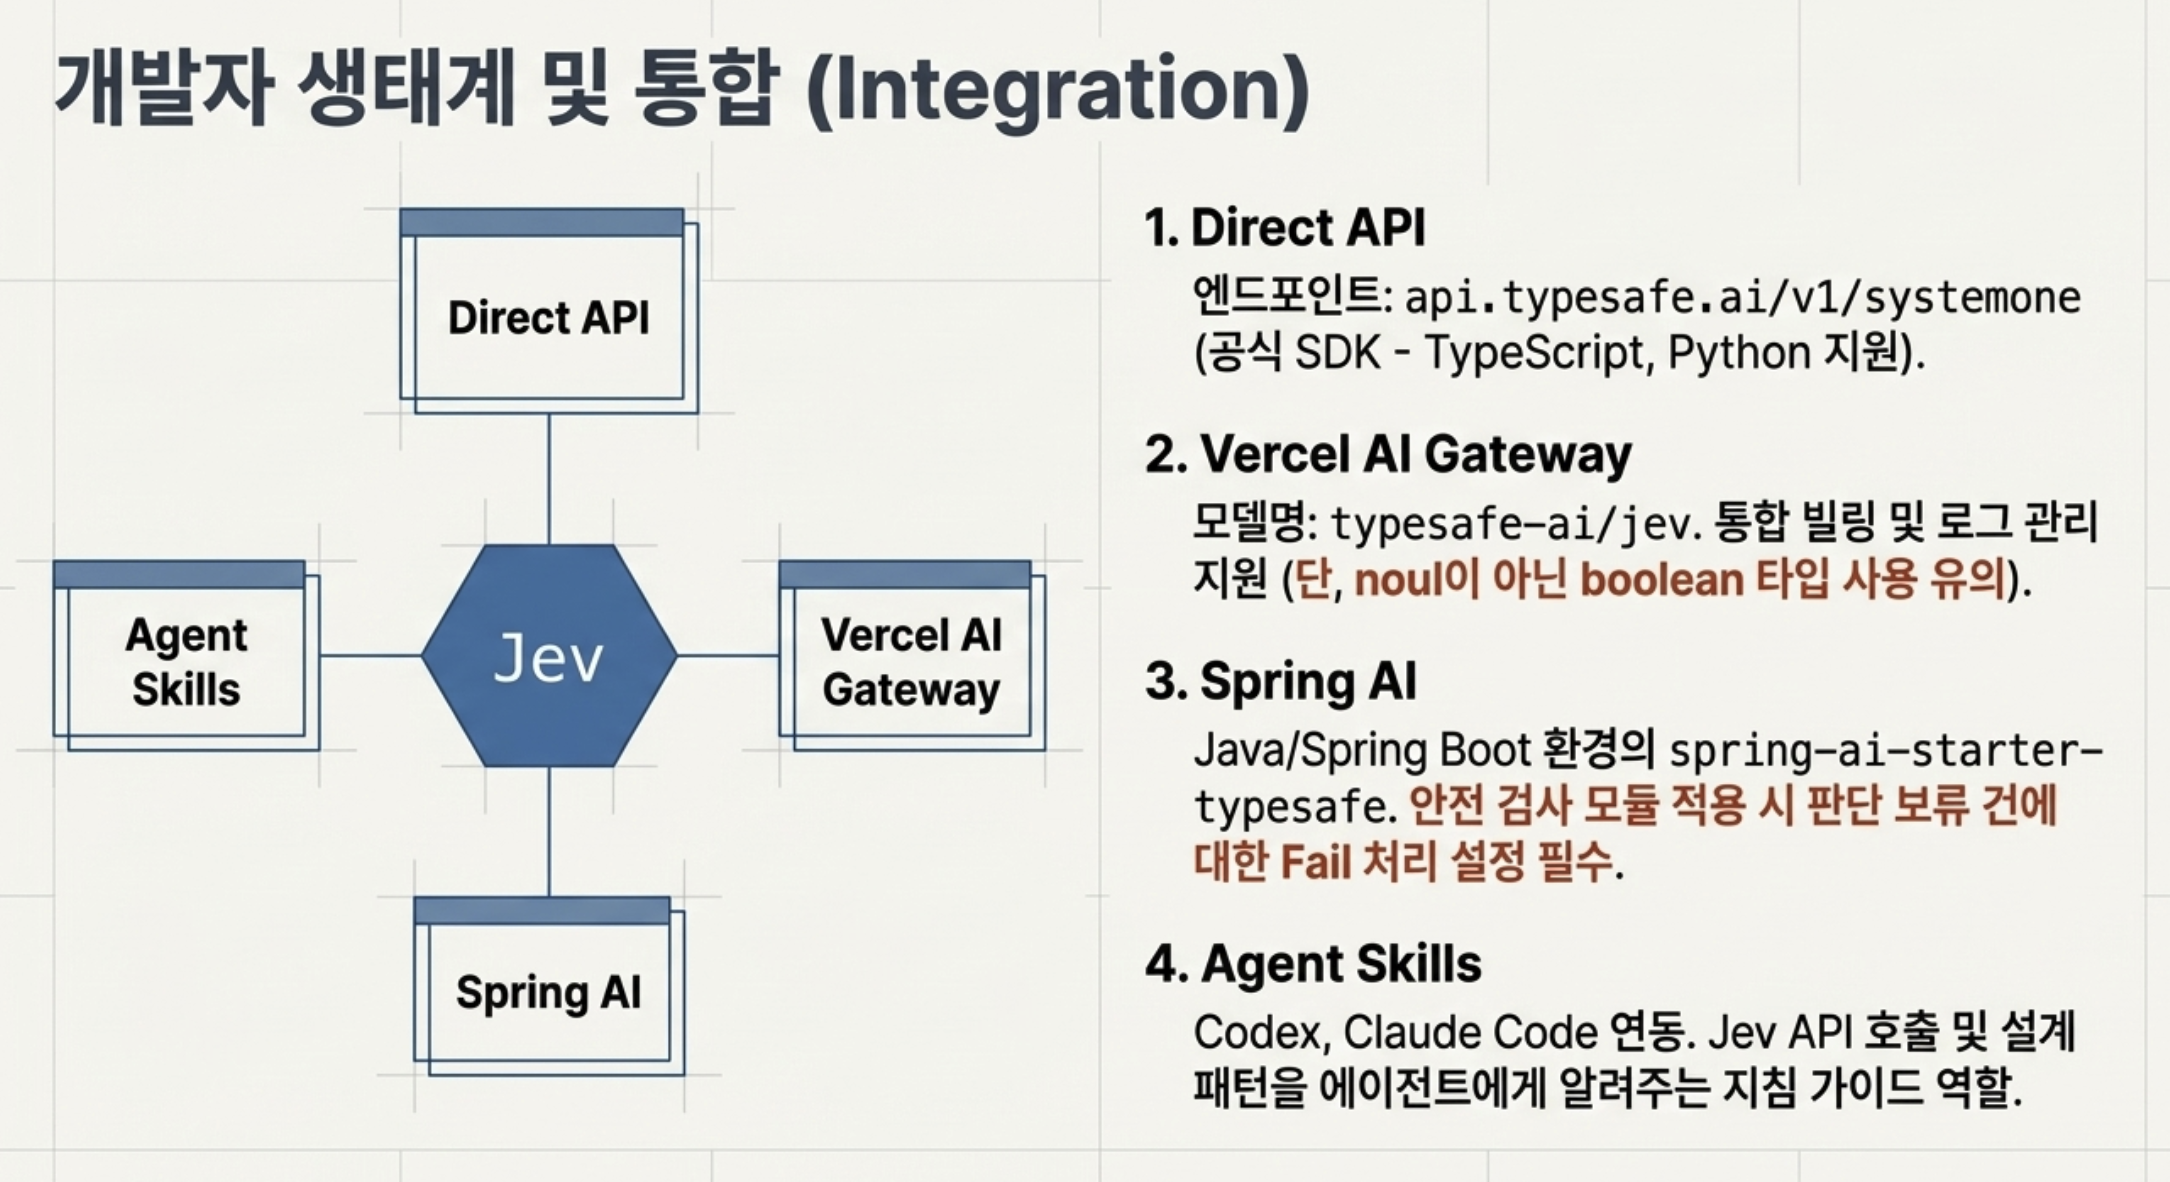
Spring 공식 블로그와 Spring AI Community 저장소에 Java 클라이언트와 Spring Boot 자동 설정이 공개돼 있다.
다만 이건 Spring AI Community 프로젝트다.
Spring AI에 기본으로 들어 있는 기능이나 TypeSafe 공식 Java SDK로 오해하지 말자.
요구 사항은 Java 17 이상이고, 평가·안전 검사 모듈(typesafe-spring-ai)은 Spring AI 2.0.1 이상이 필요하다.
| 구성 요소 | 쉽게 말하면 | 쓸 만한 곳 |
|---|---|---|
typesafe-java-sdk |
Java에서 Jev API를 부르는 클라이언트 | Spring AI 없이 일반 Java에서 호출 |
spring-ai-starter-typesafe |
설정값만으로 클라이언트를 자동 등록해 주는 스타터 | Spring Boot 프로젝트 |
typesafe-spring-ai |
평가·안전 검사·검색 결과 정리용 부품 | 답변 평가(JevJudge), 입출력 안전 검사, 검색 문서 걸러내기·재정렬, 도구 고르기 |
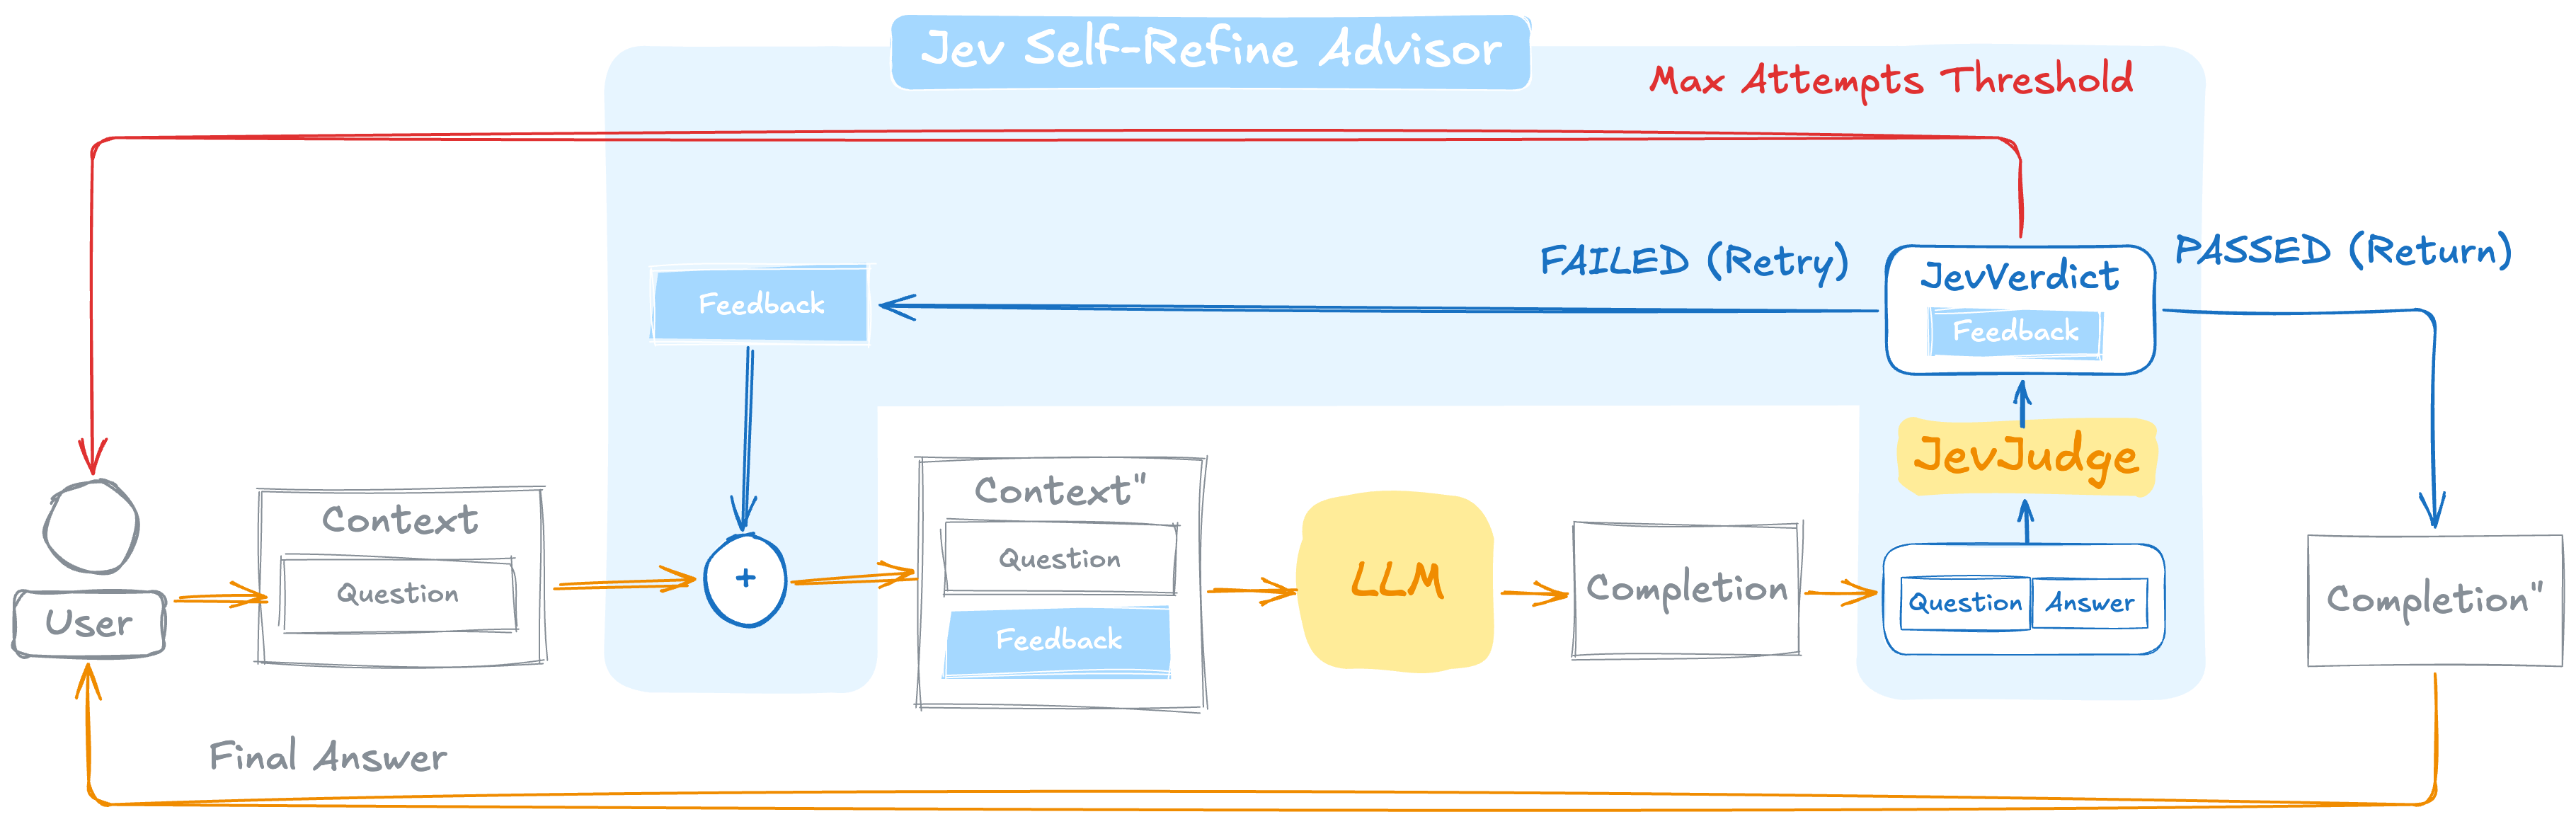
Spring 블로그 설명에 따르면 JevJudge(Jev 채점기)는 확신도가 낮은 항목을 실패(FAILED)가 아니라 판단 보류(INCONCLUSIVE)로 처리한다. 또 답변을 다시 쓰게 하는 JevSelfRefineAdvisor는 재시도 횟수를 다 써도 기본적으로 마지막 답을 돌려준다.
결제·안전처럼 놓치면 큰일 나는 기능이라면 failOnInconclusive(true)(판단 보류도 실패로 처리), failOnExhaustedAttempts(true)(재시도를 다 쓰면 실패로 처리)처럼 막는 쪽으로 바꾸는 편이 안전하다.
버전도 주의하자. 지금 블로그 예시는 0.1.0을 쓰지만 저장소 README와 문서 사이트에는 스냅샷(개발 중) 버전 문서도 함께 있다. 운영 코드에는 Maven Central의 안정 버전을 확인하고 고정해서 쓰는 게 좋다.
SDK로 직접 호출해 봤다면, 같은 작업을 코딩 에이전트에 맡겨볼 수도 있다.
그 전에 하나만 분명히 해두자.
TypeSafe 스킬은 Jev API 자체가 아니다.
Jev의 질문 타입, 설계 패턴, 최신 문서 위치 같은 걸 코딩 에이전트에게 알려 주는 안내서 묶음이다.
설치한다고 연동 코드가 저절로 생기거나 에이전트의 코딩 실력이 올라가는 건 아니다.
| 구성 요소 | 맡는 일 | 맡지 않는 일 |
|---|---|---|
| TypeSafe 스킬 | Jev의 질문 타입·패턴·문서 위치를 에이전트에 알려 줌 | API 연결이나 실행 |
| Codex / Claude Code | 연동 코드 작성, 파일 수정, 테스트 실행 | Jev 판정 결과가 맞다는 보증 |
| Jev API | Choice·Score·Noul 형태의 제한된 판단 | 결제·삭제·전송 같은 외부 작업 권한 통제 |
| 일반 코드 | 날짜·금액 계산, 권한 검사, 기준값 분기, 외부 작업 통제 | 문장 속 모호한 의도 이해 |
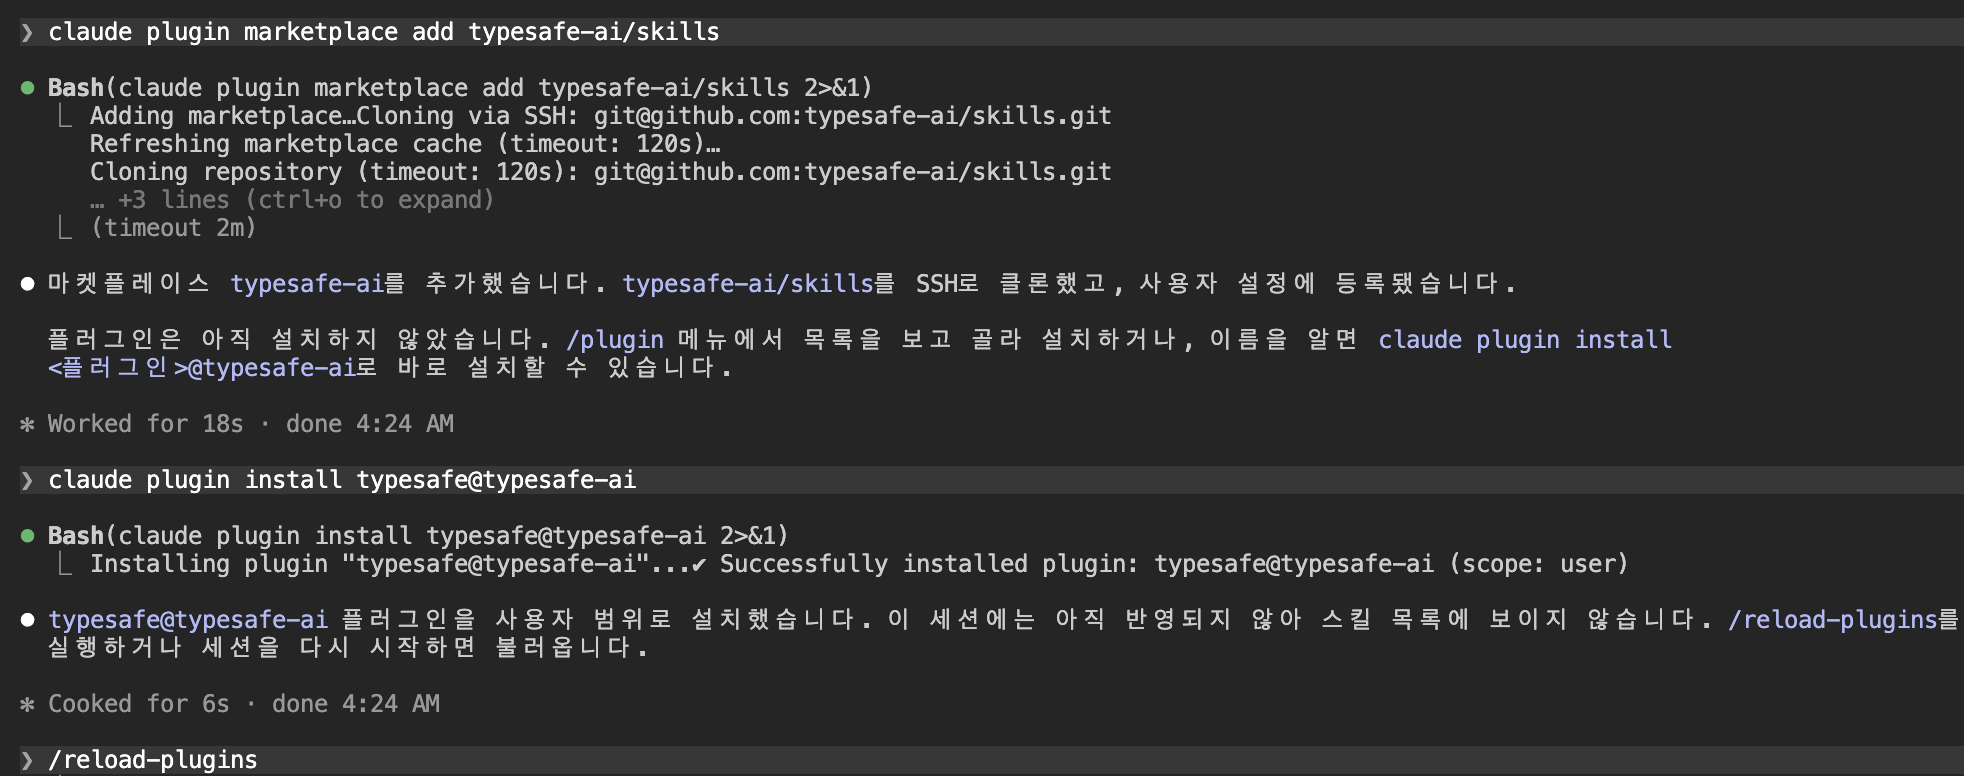
공식 문서는 설치 방법을 에이전트별로 나눠 안내한다.
Claude Code라면 플러그인으로, Codex 같은 다른 에이전트라면 skills 도구로 설치하면 된다.
# Claude Code
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai

# Codex 등 다른 에이전트
npx skills add typesafe-ai/skills --skill typesafe-ai
ex) Claude Code 설치 예시
ex) npx로 전역 설치 예시
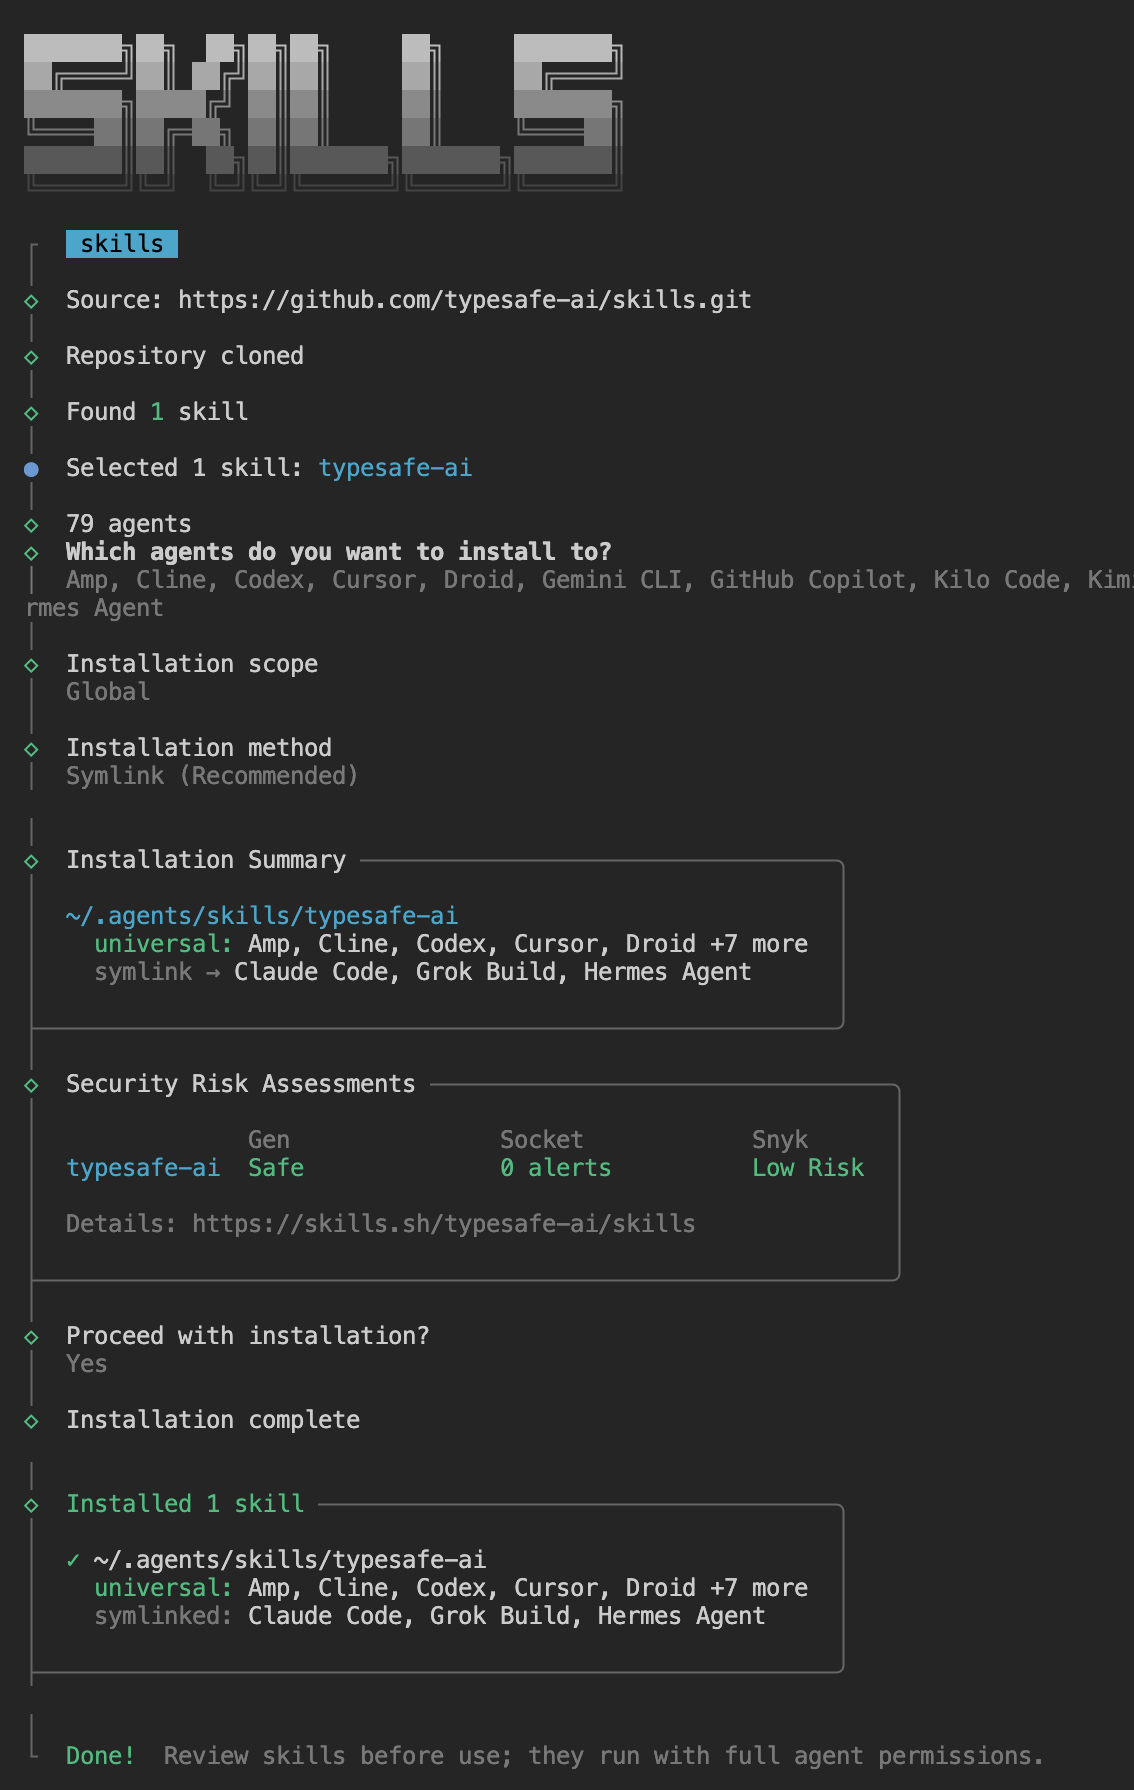
외부 패키지를 받아 실행하는 명령이니, 회사 저장소에 바로 설치하지 말고 빈 테스트 프로젝트에서 어떤 파일이 바뀌는지 먼저 확인해보자.
npx skills add는 실행 중에 사용할 에이전트를 고르게 되어 있고, 기본값은 현재 프로젝트에만 설치하는 방식이다.
모든 프로젝트에서 쓰고 싶다면 -g를 붙이면 된다. 설치 방법은 한 가지만 골라 쓰자. 두 방식으로 모두 설치하면 같은 스킬이 중복으로 들어갈 수 있다.
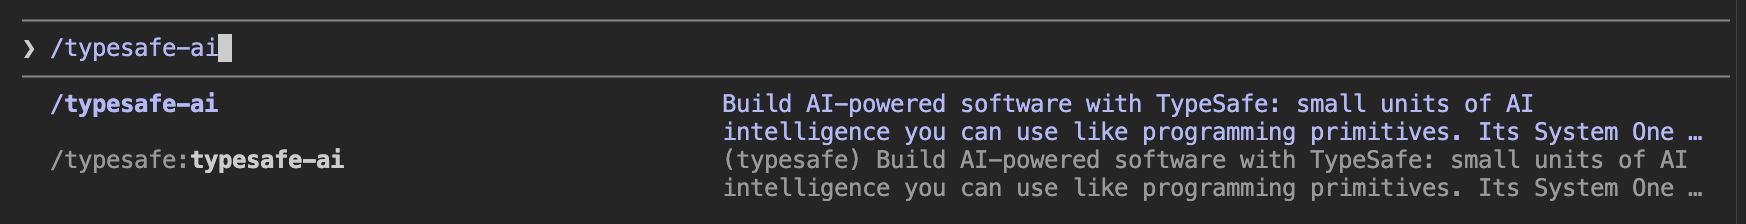
설치가 끝나면 Claude Code에서는 /typesafe:typesafe-ai로 바로 부를 수 있다.
ex) Claude Code
Codex에서는 /skills 목록에서 typesafe-ai가 보이는지 확인하고, 프롬프트에 "TypeSafe 스킬을 사용해서"라고 적거나 $typesafe-ai로 지정하면 된다.
ex) Codex 예시

ex) Grok 예시 (같은 skills 도구로 설치한 경우)
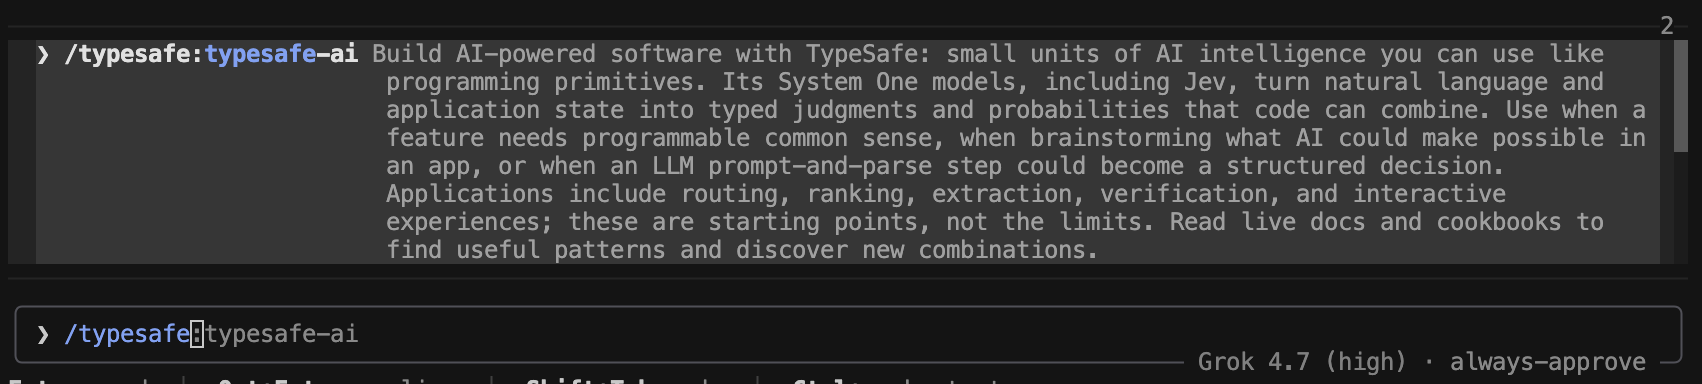
목록에 보이지 않는다면 설치 대상 에이전트를 제대로 골랐는지 먼저 확인하고, 그래도 안 되면 에이전트를 재시작해보자.
스킬 목록에 보이면 설치까지 된 것이다.
실제 Jev 연동까지 확인하려면 에이전트가 SDK 코드를 만들었는지, 테스트가 돌았는지, 키를 설정한 환경에서 API 응답을 받았는지를 하나씩 따로 확인해야 한다.
설치됐다고 연동까지 끝난 건 아니다.
처음부터 운영 티켓이나 실제 환불 기능을 연결할 필요는 없다.
앞에서 쓴 가상의 고객 문의 예제를 그대로 쓰면, SDK로 직접 만든 결과와 에이전트가 만든 구현을 같은 기준으로 비교하기 쉽다.
TypeSafe 스킬을 사용해서
현재 프로젝트에 한국어 고객 문의를 분류하는 로컬 예제를 만들어 주세요.

- 담당 부서는 Choice로 판단합니다.
- 환불 요청 여부는 Noul로 판단합니다.
- 업무 영향도는 Score로 판단합니다.
- 날짜, 환불 가능 기간, 금액 계산은 일반 코드로 처리합니다.
- 외부 메시지 전송이나 실제 환불은 수행하지 않습니다.
- 최신 공식 문서와 설치된 SDK의 타입을 먼저 확인합니다.
- 확인할 수 없는 API 필드나 반환값은 추측하지 않습니다.
- 질문, 판정 기준, 기준값은 한 파일에 모아 검토할 수 있게 합니다.
- API 키와 고객 개인정보를 로그에 출력하지 않습니다.
- 정상 문장, 부정문, 완곡한 요청, 여러 요청이 섞인 문장,
  정보 부족, 입력 안의 악의적인 지시를 테스트에 포함합니다.
- 실행하지 못한 테스트는 성공으로 적지 말고 미검증 이유를 알려 주세요.
"질문과 기준값을 한 파일에 모으라"는 부분은 TypeSafe 공식 문서의 권장 사항이기도 하다.
에이전트는 질문을 잘 못 쓰는 편이니 사람이 같이 다듬으라는 것이다.
나중에 코드 리뷰할 때 제일 먼저 볼 곳도 결국 질문과 기준값이다.
ex) 실제로 만들어보자.
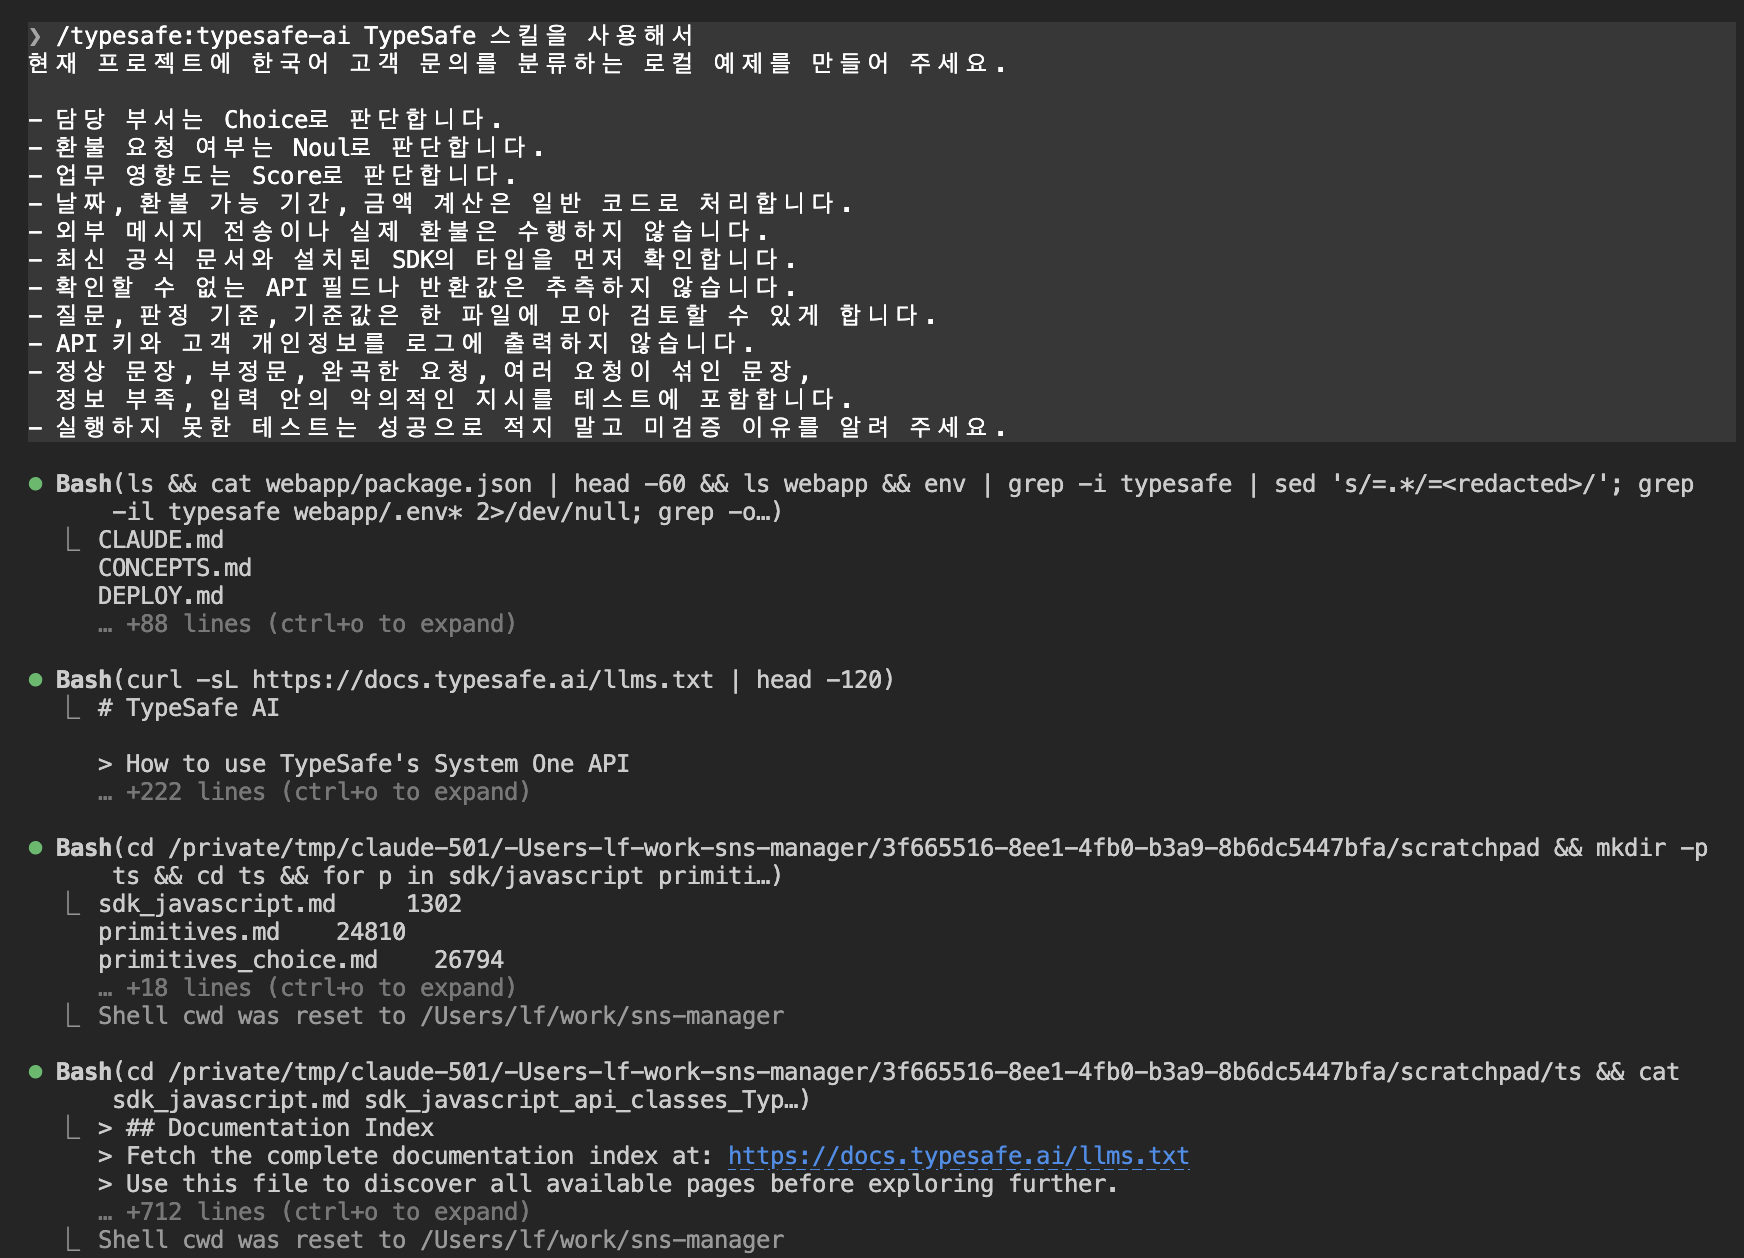
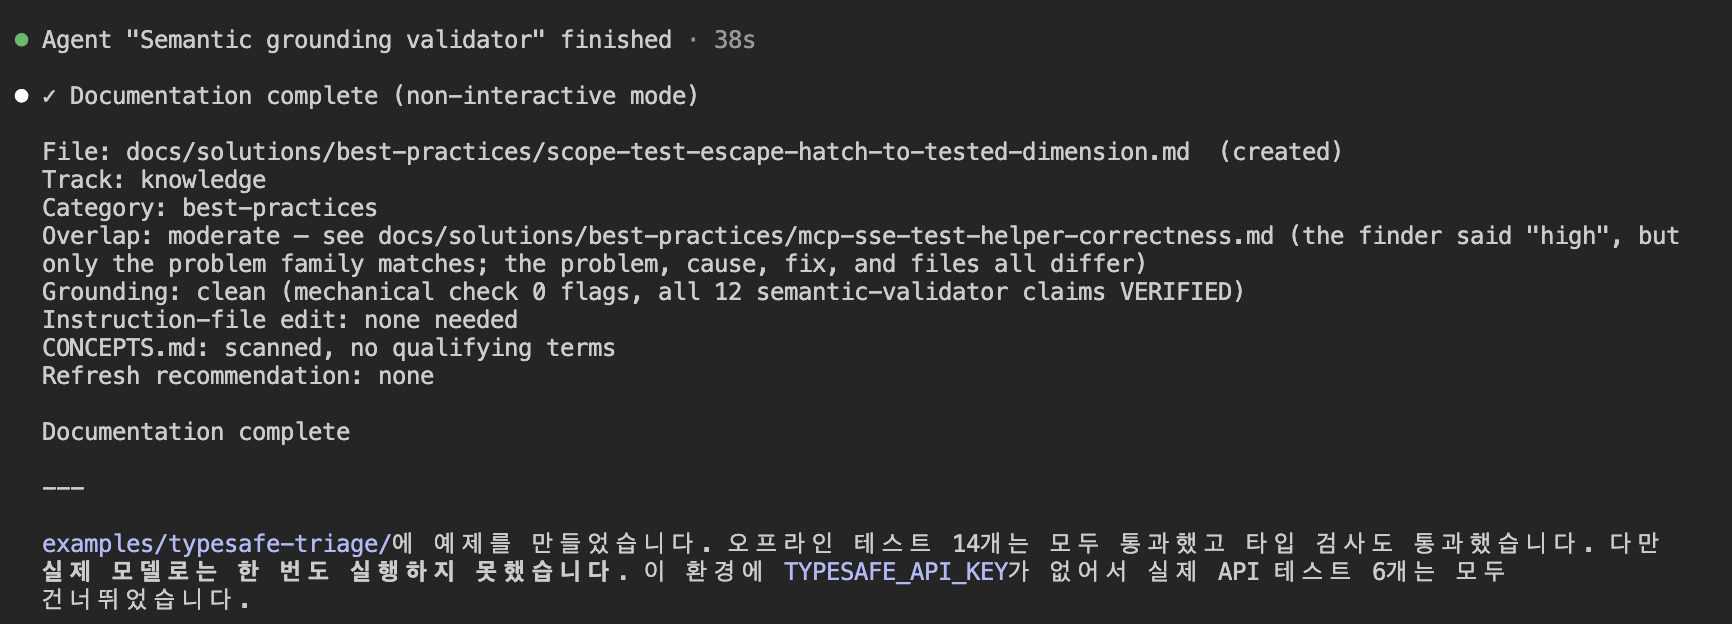
- 실제 소스를 다 보여 주기보다는 정리해 보았다.
ex) 생성된 프로젝트 파일 구조
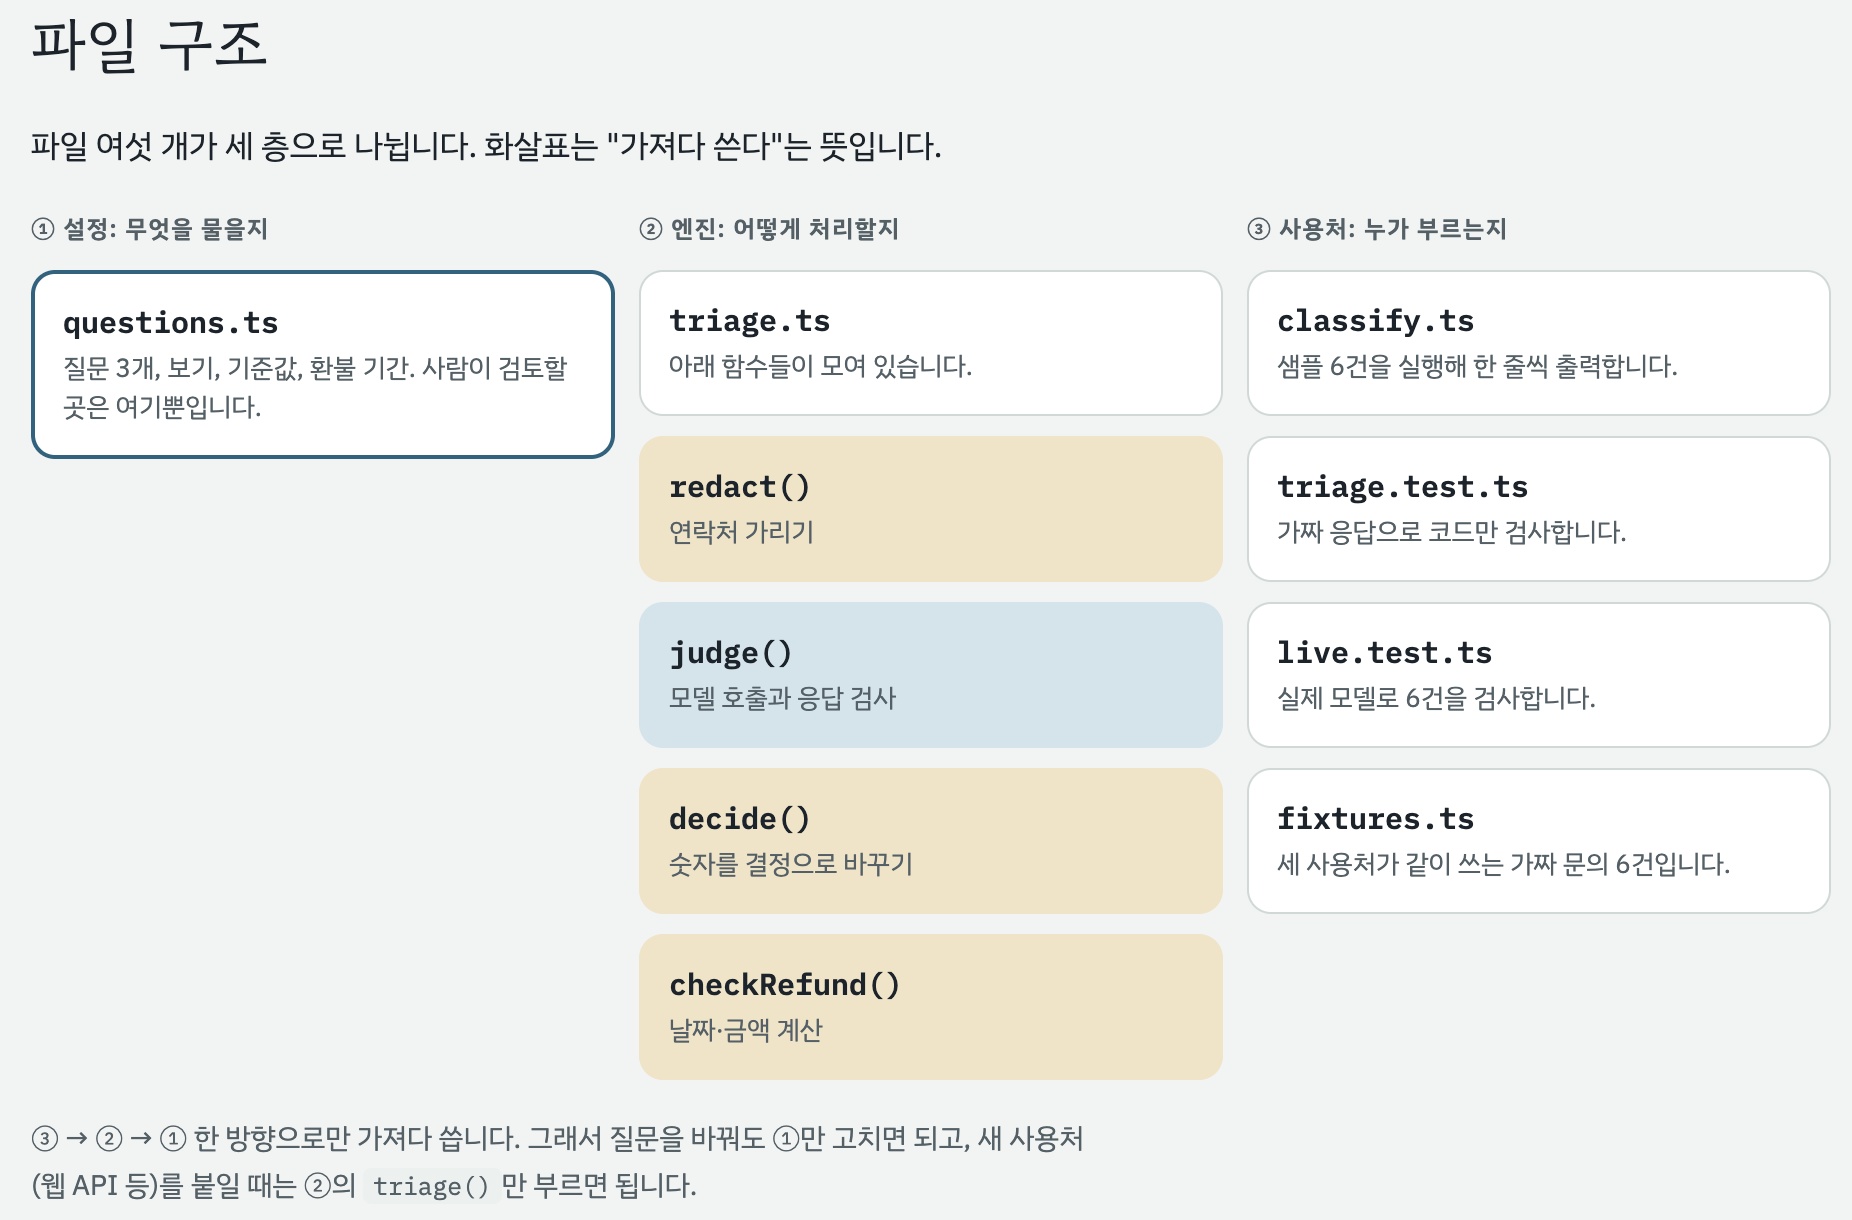
ex) 해당 소스 동작 흐름

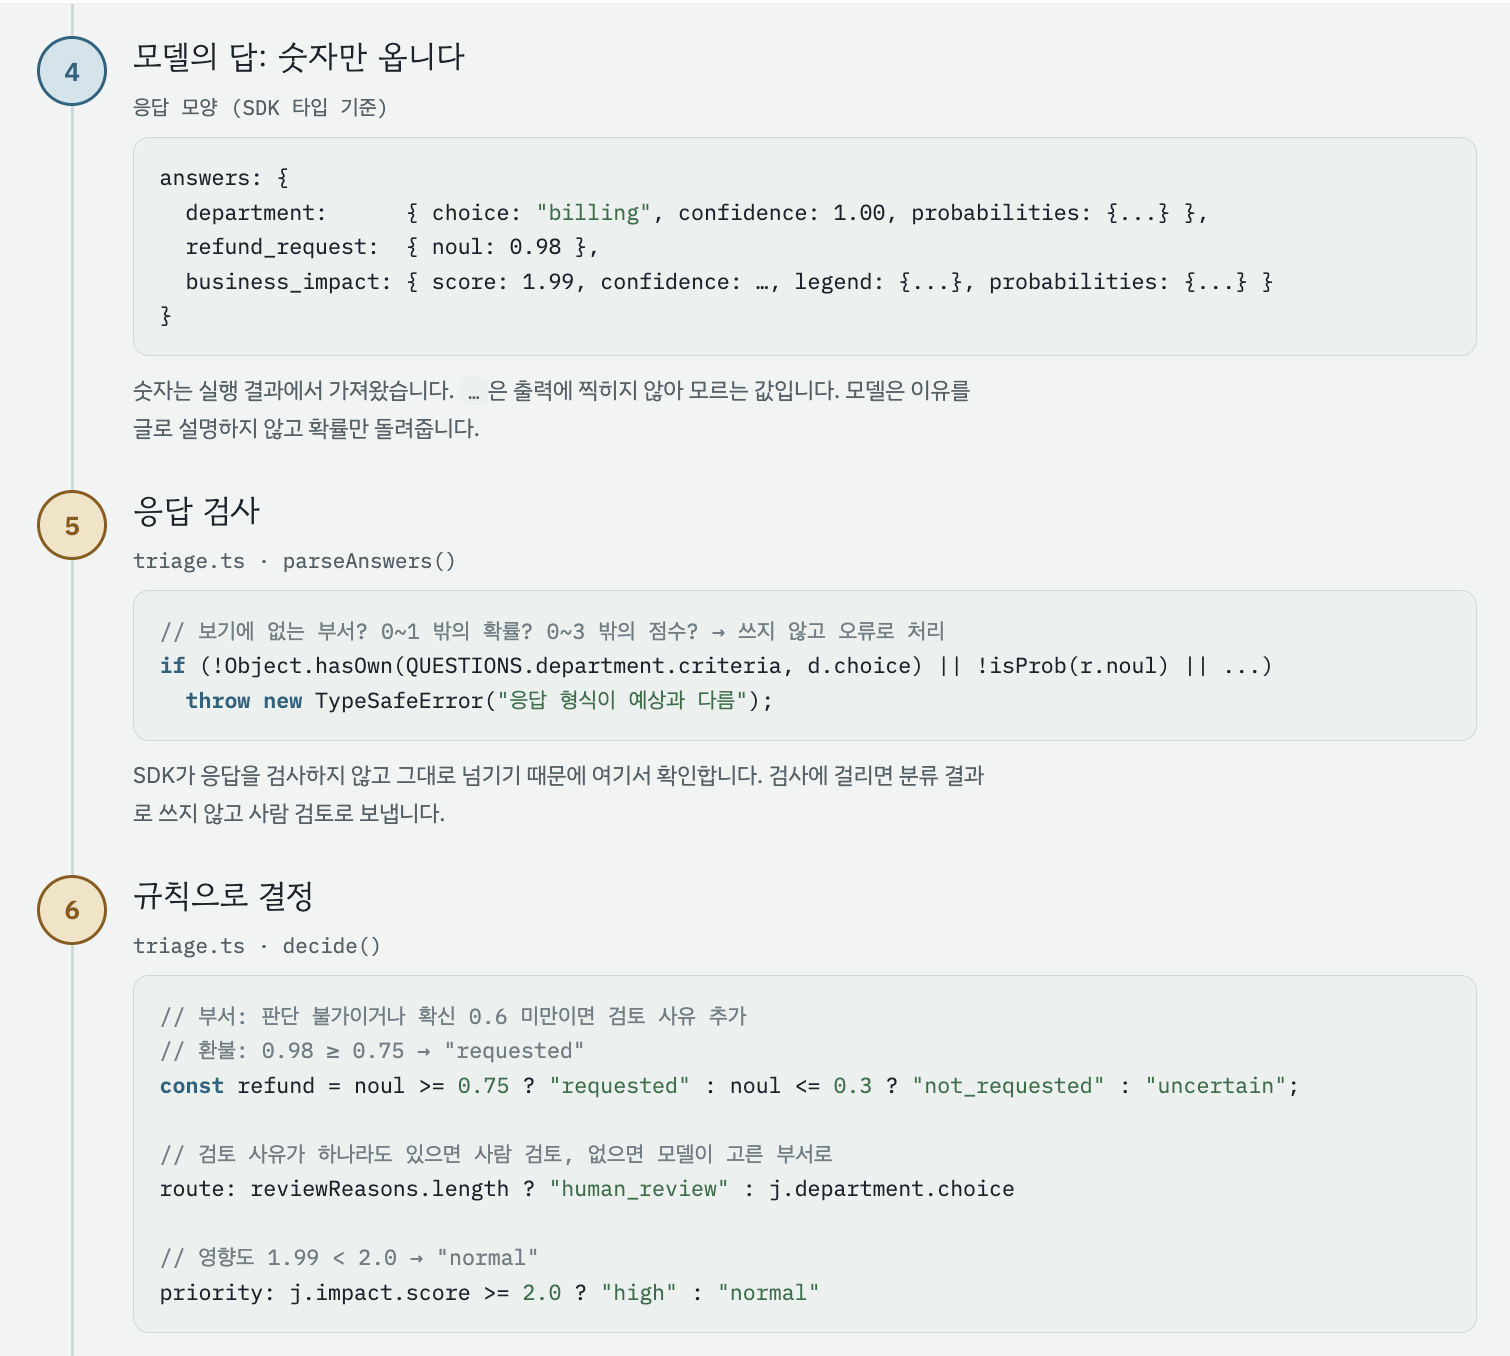
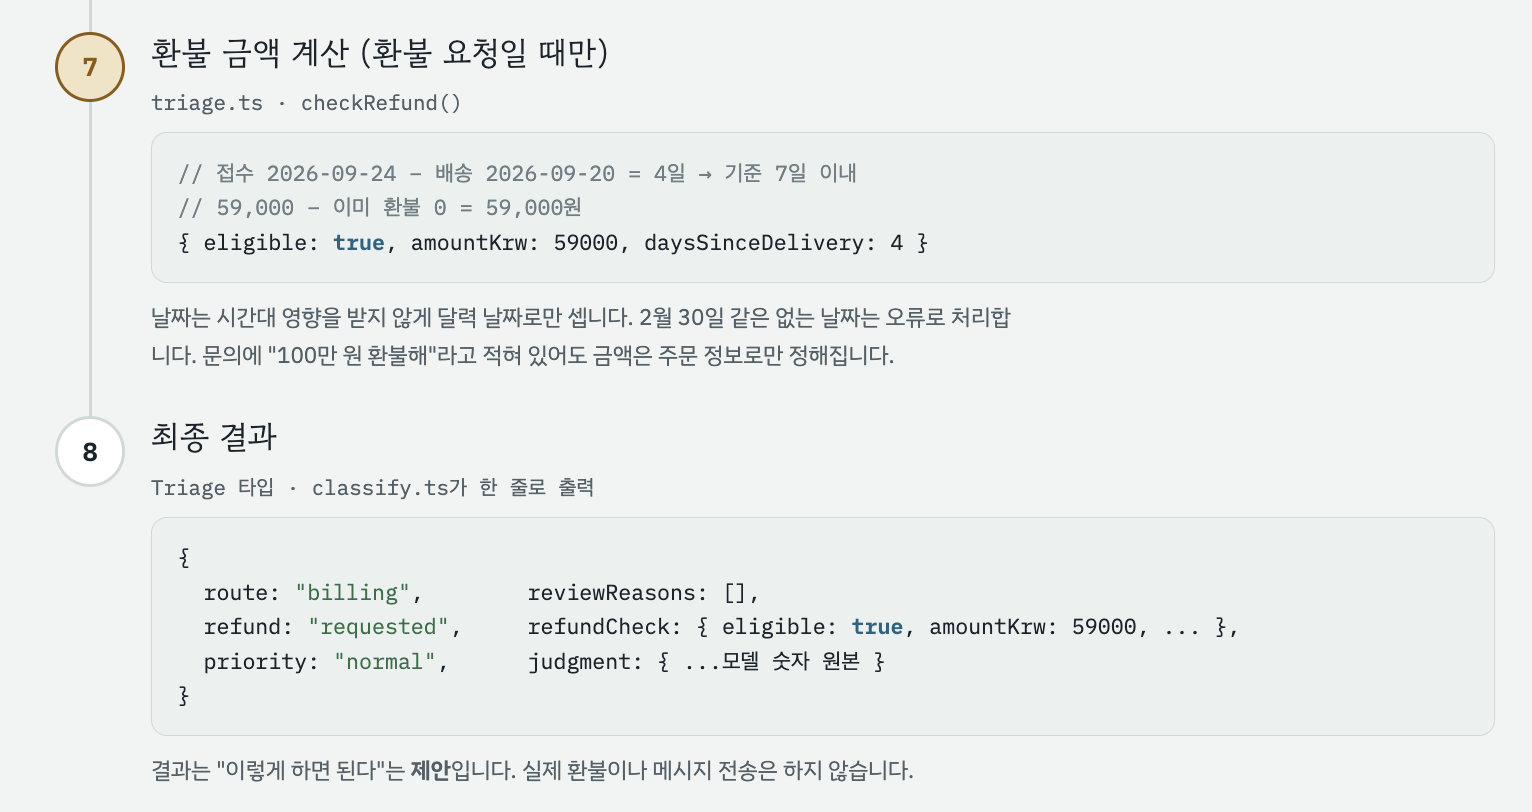
ex) 샘플 소스 (샘플 질의, 분류 등등)의 수행 결과 예시

API 키나 크레딧, 네트워크가 준비되지 않았다면 모의 응답(Mock)과 코드 검사까지만 확인하고, 실제 호출은 "아직 확인 안 함"으로 남겨 두면 된다. 에이전트가 402를 받고도 테스트가 통과했다고 정리하는 경우가 있을 수 있으니, 실제 응답 로그를 한 번은 직접 보자. 반대로 API가 한 번 성공했다고 해서 한국어 판정 정확도까지 검증된 건 아니다.
골라 읽어도 되는 내용이다. 설치와 예제만 해보고 싶다면 바로 아래 Step 8이나 다음 장으로 넘어가도 된다.
TypeSafe는 에이전트가 수많은 스킬 중 맞는 걸 고르도록 Jev가 도와주는 실험(Skill suggestion cookbook)을 공개했다.
Nous Research의 Hermes 에이전트가 가진 스킬 182개를 Jev가 먼저 훑어 순위를 매기고, 상위 3개만 다시 꼼꼼히 확인하는 방식이다. 요청 488개로 측정한 결과는 이렇다.
| 평가 항목 | 에이전트 혼자 | TypeSafe 추천 추가 | 정답을 알려 준 경우 |
|---|---|---|---|
| 맞는 스킬이 있는데 엉뚱한 스킬을 부른 비율 | 16.8% | 7.3% | 2.5% |
| 맞는 스킬이 없는데 괜히 스킬을 부른 비율 | 9.8% | 4.0% | 1.2% |
출처: TypeSafe 공식 Skill suggestion Cookbook. TypeSafe가 Claude Haiku 4.5와 jev-1.12로 측정해 공개한 실험이다.
이 실험은 코드 정답률을 잰 게 아니다. Hermes 에이전트와 Claude Haiku 4.5 환경에서 어떤 스킬을 부를지만 비교했다. 또 스킬이 필요한 요청은 각 스킬 설명 문서를 보고 Claude Sonnet 5가 만든 것이라, 실제 사용자의 애매한 요청보다 쉬웠을 가능성이 있다고 문서에서 직접 밝히고 있다.
추천을 붙여서 원래 틀리던 37건을 바로잡았지만, 원래 맞던 7건을 틀리게 만들기도 했다. 그러니 이 결과는 "후보를 먼저 좁혀 주는 구조는 한번 시도해볼 만하다" 정도로 받아들이면 된다. TypeSafe 스킬만 설치하면 코딩 실력이 올라간다는 뜻은 아니다.
공식 원문
설치 방법은 TypeSafe의 Agent skill 문서에, 공개 실험은 Skill suggestion Cookbook에 정리돼 있다.
→ TypeSafe 에이전트 스킬 안내 → 스킬 추천 실험 원문
이 단계는 사내 자동화를 n8n으로 돌리고 있는 사람을 위한 실습이다.
핵심은 앞에서 cURL로 보낸 요청을 n8n의 HTTP Request 노드로 옮기는 것뿐이라, 새로 배울 개념은 거의 없다.
9월 28일 기준으로 TypeSafe나 n8n이 만든 공식 Jev 노드는 없다.
그래서 n8n 기본 HTTP Request 노드를 쓴다. 버전이 바뀌어도 덜 흔들리고, 요청과 응답을 눈으로 확인하기도 쉽다.
노드를 하나씩 만들 필요는 없다.
아래 워크플로 JSON을 가져오면(import) 확신도 검사, 부서 분기, 사람 검토, 오류 처리까지 한 번에 만들어진다.
흐름: 수동 테스트 또는 Webhook(외부 요청으로 시작) → 티켓 정리(필요한 필드만 남기기) → Jev 판정(HTTP Request) → 확신도 검사(IF) → 부서 분기(Switch) → 부서별 큐 또는 사람 검토
threshold(자동 처리 기준값)를 확인한다. 기본값 0.8은 예시일 뿐이니, 실제 운영 전에는 10장의 그림자 운영으로 정한 값으로 바꾸자.ex) 워크플로 JSON (그대로 복사해서 붙여 넣으면 된다)
{
"name": "Jev 고객 문의 분류 (TypeSafe)",
"nodes": [
{
"parameters": {
"content": "## Jev 고객 문의 분류 예제\n1. **Jev 판정** 노드를 열고 Credential에 TypeSafe API 키(Bearer Auth)를 연결\n2. **티켓 정리** 노드의 `threshold`(기준값)는 그림자 운영 결과로 바꾸기\n3. 왼쪽 위 **수동 테스트**로 가상 문의 3건을 먼저 실행\n4. 실제 연동은 **Webhook 문의 접수**에 `{\"ticket\": \"...\", \"channel\": \"...\"}` 를 POST\n\n※ 각 큐 노드는 자리 표시용이다. Slack·CRM·메일 노드로 바꿔 쓰면 된다.",
"height": 300,
"width": 460,
"color": 5
},
"id": "3d508cf1-aa4a-42e4-8119-0bae7a0237ac",
"name": "사용 안내",
"type": "n8n-nodes-base.stickyNote",
"typeVersion": 1,
"position": [
-80,
-380
]
},
{
"parameters": {},
"id": "e3000d1b-e5aa-4db9-b323-57c2b181fe44",
"name": "수동 테스트",
"type": "n8n-nodes-base.manualTrigger",
"typeVersion": 1,
"position": [
0,
0
]
},
{
"parameters": {
"jsCode": "// 수동 테스트용 가상 문의 3건 (실제 고객 데이터 금지)\nreturn [\n { json: { ticket: '결제가 두 번 됐습니다. 오늘 안에 중복 결제를 취소해 주세요.', channel: 'email' } },\n { json: { ticket: '앱이 자꾸 튕겨요. 그리고 이번 달 요금이 제대로 결제됐는지도 확인해 주세요.', channel: 'email' } },\n { json: { ticket: '기업 요금제 견적이 궁금합니다. 50명 기준으로 알려 주세요.', channel: 'chat' } },\n];"
},
"id": "f21b7d0f-f502-4855-9f5a-c0c60ba497e8",
"name": "가상 문의 3건",
"type": "n8n-nodes-base.code",
"typeVersion": 2,
"position": [
220,
0
]
},
{
"parameters": {
"httpMethod": "POST",
"path": "jev-ticket",
"responseMode": "lastNode",
"options": {}
},
"id": "76e992a0-4ca8-4035-8712-7d41d94ae324",
"name": "Webhook 문의 접수",
"type": "n8n-nodes-base.webhook",
"typeVersion": 2,
"position": [
0,
220
],
"webhookId": "83ec8e32-93c1-43a4-bfb1-fababb258f39"
},
{
"parameters": {
"assignments": {
"assignments": [
{
"id": "d2e988b2-cd93-423d-9b79-0fbf01afd71f",
"name": "ticket",
"value": "={{ $json.body?.ticket ?? $json.ticket }}",
"type": "string"
},
{
"id": "b3b3bf5a-74bc-472f-88b3-ab1a11000706",
"name": "channel",
"value": "={{ $json.body?.channel ?? $json.channel ?? 'unknown' }}",
"type": "string"
},
{
"id": "fa0d43ec-1a5a-4e3f-ba12-0db935219cab",
"name": "threshold",
"value": 0.8,
"type": "number"
}
]
},
"options": {}
},
"id": "2510d634-97cc-4496-98af-5ce1172a2181",
"name": "티켓 정리",
"type": "n8n-nodes-base.set",
"typeVersion": 3.4,
"position": [
460,
100
]
},
{
"parameters": {
"method": "POST",
"url": "https://api.typesafe.ai/v1/systemone",
"authentication": "genericCredentialType",
"genericAuthType": "httpBearerAuth",
"sendBody": true,
"specifyBody": "json",
"jsonBody": "={{ JSON.stringify({\n state: { ticket: $json.ticket, channel: $json.channel },\n model: 'jev-latest',\n questions: {\n department: {\n type: 'choice',\n instructions: 'Which team should handle this ticket?',\n criteria: {\n billing: 'Payments, invoices, refunds, or duplicate charges',\n technical: 'Bugs, outages, or integrations',\n sales: 'Pricing, upgrades, or new accounts',\n other: 'None of the above'\n }\n },\n is_urgent: {\n type: 'noul',\n instructions: 'Does the customer express an explicit time constraint?'\n }\n }\n}) }}",
"options": {}
},
"id": "4f1f5bc9-5777-4e23-be88-ce6066166b79",
"name": "Jev 판정",
"type": "n8n-nodes-base.httpRequest",
"typeVersion": 4.2,
"position": [
680,
100
],
"onError": "continueErrorOutput"
},
{
"parameters": {
"conditions": {
"options": {
"caseSensitive": true,
"leftValue": "",
"typeValidation": "strict",
"version": 2
},
"conditions": [
{
"id": "2bf5e733-c2da-45e8-be28-c3f1858e8771",
"leftValue": "={{ $json.answers.department.choice }}",
"rightValue": "other",
"operator": {
"type": "string",
"operation": "notEquals"
}
},
{
"id": "f431ec3b-9b3c-4212-b184-1c470222a5a1",
"leftValue": "={{ $json.answers.department.confidence }}",
"rightValue": "={{ $('티켓 정리').item.json.threshold }}",
"operator": {
"type": "number",
"operation": "gte"
}
}
],
"combinator": "and"
},
"options": {}
},
"id": "210b9f14-26fa-4578-8c9f-7f6baef99ca0",
"name": "확신도 검사",
"type": "n8n-nodes-base.if",
"typeVersion": 2.2,
"position": [
920,
0
]
},
{
"parameters": {
"rules": {
"values": [
{
"conditions": {
"options": {
"caseSensitive": true,
"leftValue": "",
"typeValidation": "strict",
"version": 2
},
"conditions": [
{
"id": "0b204cc9-84ac-41b6-8271-308d0dea872b",
"leftValue": "={{ $json.answers.department.choice }}",
"rightValue": "billing",
"operator": {
"type": "string",
"operation": "equals"
}
}
],
"combinator": "and"
},
"renameOutput": true,
"outputKey": "billing"
},
{
"conditions": {
"options": {
"caseSensitive": true,
"leftValue": "",
"typeValidation": "strict",
"version": 2
},
"conditions": [
{
"id": "69082f82-c8fe-4bd6-bb61-fffad616312d",
"leftValue": "={{ $json.answers.department.choice }}",
"rightValue": "technical",
"operator": {
"type": "string",
"operation": "equals"
}
}
],
"combinator": "and"
},
"renameOutput": true,
"outputKey": "technical"
},
{
"conditions": {
"options": {
"caseSensitive": true,
"leftValue": "",
"typeValidation": "strict",
"version": 2
},
"conditions": [
{
"id": "60c6bb63-a888-430d-8ca9-ebac44f65781",
"leftValue": "={{ $json.answers.department.choice }}",
"rightValue": "sales",
"operator": {
"type": "string",
"operation": "equals"
}
}
],
"combinator": "and"
},
"renameOutput": true,
"outputKey": "sales"
}
]
},
"options": {
"fallbackOutput": "extra",
"renameFallbackOutput": "그 외"
}
},
"id": "181b354f-427f-4e45-aa78-f253b0a1ff4e",
"name": "부서 분기",
"type": "n8n-nodes-base.switch",
"typeVersion": 3.2,
"position": [
1160,
-100
]
},
{
"parameters": {
"assignments": {
"assignments": [
{
"id": "af6c169d-e298-4456-be91-5076887a9b0c",
"name": "route",
"value": "billing_queue",
"type": "string"
},
{
"id": "94ccee51-3bc7-466f-8495-0689a9eb659e",
"name": "ticket",
"value": "={{ $('티켓 정리').item.json.ticket }}",
"type": "string"
},
{
"id": "8b094975-7803-472c-88c6-4303e2061152",
"name": "department",
"value": "={{ $json.answers.department.choice }}",
"type": "string"
},
{
"id": "5a26b3b0-6133-444e-a43b-15acae7d90f6",
"name": "confidence",
"value": "={{ $json.answers.department.confidence }}",
"type": "number"
},
{
"id": "1bf1073f-b5b8-40f6-b880-5d8b2fdd4bd9",
"name": "is_urgent",
"value": "={{ $json.answers.is_urgent.noul }}",
"type": "number"
}
]
},
"options": {}
},
"id": "860c9c5e-937a-43b8-a072-6c56d350b07c",
"name": "결제팀 큐",
"type": "n8n-nodes-base.set",
"typeVersion": 3.4,
"position": [
1420,
-260
]
},
{
"parameters": {
"assignments": {
"assignments": [
{
"id": "d4e50746-67e7-412a-81a1-6f738a6f885f",
"name": "route",
"value": "technical_queue",
"type": "string"
},
{
"id": "b6b9a750-1d53-478d-b021-47fd02582ef3",
"name": "ticket",
"value": "={{ $('티켓 정리').item.json.ticket }}",
"type": "string"
},
{
"id": "5cd2df34-8c4c-4da2-8dea-75a82f3484db",
"name": "department",
"value": "={{ $json.answers.department.choice }}",
"type": "string"
},
{
"id": "62497f82-b0b7-41cb-8649-63b1601f27b4",
"name": "confidence",
"value": "={{ $json.answers.department.confidence }}",
"type": "number"
},
{
"id": "aa0d5d81-f9b1-4c94-921a-f6a25e9ab137",
"name": "is_urgent",
"value": "={{ $json.answers.is_urgent.noul }}",
"type": "number"
}
]
},
"options": {}
},
"id": "9989b2ad-67dc-43e0-b718-c97d9a300246",
"name": "기술팀 큐",
"type": "n8n-nodes-base.set",
"typeVersion": 3.4,
"position": [
1420,
-100
]
},
{
"parameters": {
"assignments": {
"assignments": [
{
"id": "1968fe03-9975-40c1-ad0f-c0a7e50b29c0",
"name": "route",
"value": "sales_queue",
"type": "string"
},
{
"id": "f04ad217-d405-4c1b-9c72-10bd8a72f559",
"name": "ticket",
"value": "={{ $('티켓 정리').item.json.ticket }}",
"type": "string"
},
{
"id": "c3d22e17-98f5-42e5-a5ca-6634a5f3511e",
"name": "department",
"value": "={{ $json.answers.department.choice }}",
"type": "string"
},
{
"id": "36e0a441-baa3-4649-94cb-f4284d7c2621",
"name": "confidence",
"value": "={{ $json.answers.department.confidence }}",
"type": "number"
},
{
"id": "c183bd56-4b78-434c-b58d-0fd1cbbeb7a0",
"name": "is_urgent",
"value": "={{ $json.answers.is_urgent.noul }}",
"type": "number"
}
]
},
"options": {}
},
"id": "8621f0fc-f888-4c32-bcbd-6cf994877275",
"name": "영업팀 큐",
"type": "n8n-nodes-base.set",
"typeVersion": 3.4,
"position": [
1420,
60
]
},
{
"parameters": {
"assignments": {
"assignments": [
{
"id": "8e949f14-4871-4c2a-af7c-c5a67ae8be43",
"name": "route",
"value": "manual_review",
"type": "string"
},
{
"id": "de1ca27f-d28e-4648-8bb0-67b3141ece46",
"name": "reason",
"value": "={{ $json.answers ? 'low_confidence_or_other' : 'jev_api_error' }}",
"type": "string"
},
{
"id": "04c81714-a072-4399-9cb6-ed5a067145cd",
"name": "ticket",
"value": "={{ $('티켓 정리').item.json.ticket }}",
"type": "string"
},
{
"id": "26cd05aa-6b63-4846-b17c-a055b7d8d42a",
"name": "department",
"value": "={{ $json.answers?.department?.choice ?? '' }}",
"type": "string"
},
{
"id": "da670b1c-fb91-45a1-adb3-3c0c46d88372",
"name": "confidence",
"value": "={{ $json.answers?.department?.confidence ?? 0 }}",
"type": "number"
},
{
"id": "2d75802a-95e3-4221-b415-d5ae43cdfa9c",
"name": "error",
"value": "={{ $json.error?.message ?? $json.error ?? '' }}",
"type": "string"
}
]
},
"options": {}
},
"id": "d1cff0e0-afb3-43b5-8b6d-2a4d0fe00ef8",
"name": "사람 검토 큐",
"type": "n8n-nodes-base.set",
"typeVersion": 3.4,
"position": [
1420,
260
]
}
],
"connections": {
"수동 테스트": {
"main": [
[
{
"node": "가상 문의 3건",
"type": "main",
"index": 0
}
]
]
},
"가상 문의 3건": {
"main": [
[
{
"node": "티켓 정리",
"type": "main",
"index": 0
}
]
]
},
"Webhook 문의 접수": {
"main": [
[
{
"node": "티켓 정리",
"type": "main",
"index": 0
}
]
]
},
"티켓 정리": {
"main": [
[
{
"node": "Jev 판정",
"type": "main",
"index": 0
}
]
]
},
"Jev 판정": {
"main": [
[
{
"node": "확신도 검사",
"type": "main",
"index": 0
}
],
[
{
"node": "사람 검토 큐",
"type": "main",
"index": 0
}
]
]
},
"확신도 검사": {
"main": [
[
{
"node": "부서 분기",
"type": "main",
"index": 0
}
],
[
{
"node": "사람 검토 큐",
"type": "main",
"index": 0
}
]
]
},
"부서 분기": {
"main": [
[
{
"node": "결제팀 큐",
"type": "main",
"index": 0
}
],
[
{
"node": "기술팀 큐",
"type": "main",
"index": 0
}
],
[
{
"node": "영업팀 큐",
"type": "main",
"index": 0
}
],
[
{
"node": "사람 검토 큐",
"type": "main",
"index": 0
}
]
]
}
},
"pinData": {},
"settings": {
"executionOrder": "v1"
},
"active": false,
"tags": []
}
ex) 워크플로를 Import하면 다음과 같이 노드들이 세팅되어 있을 것이다.
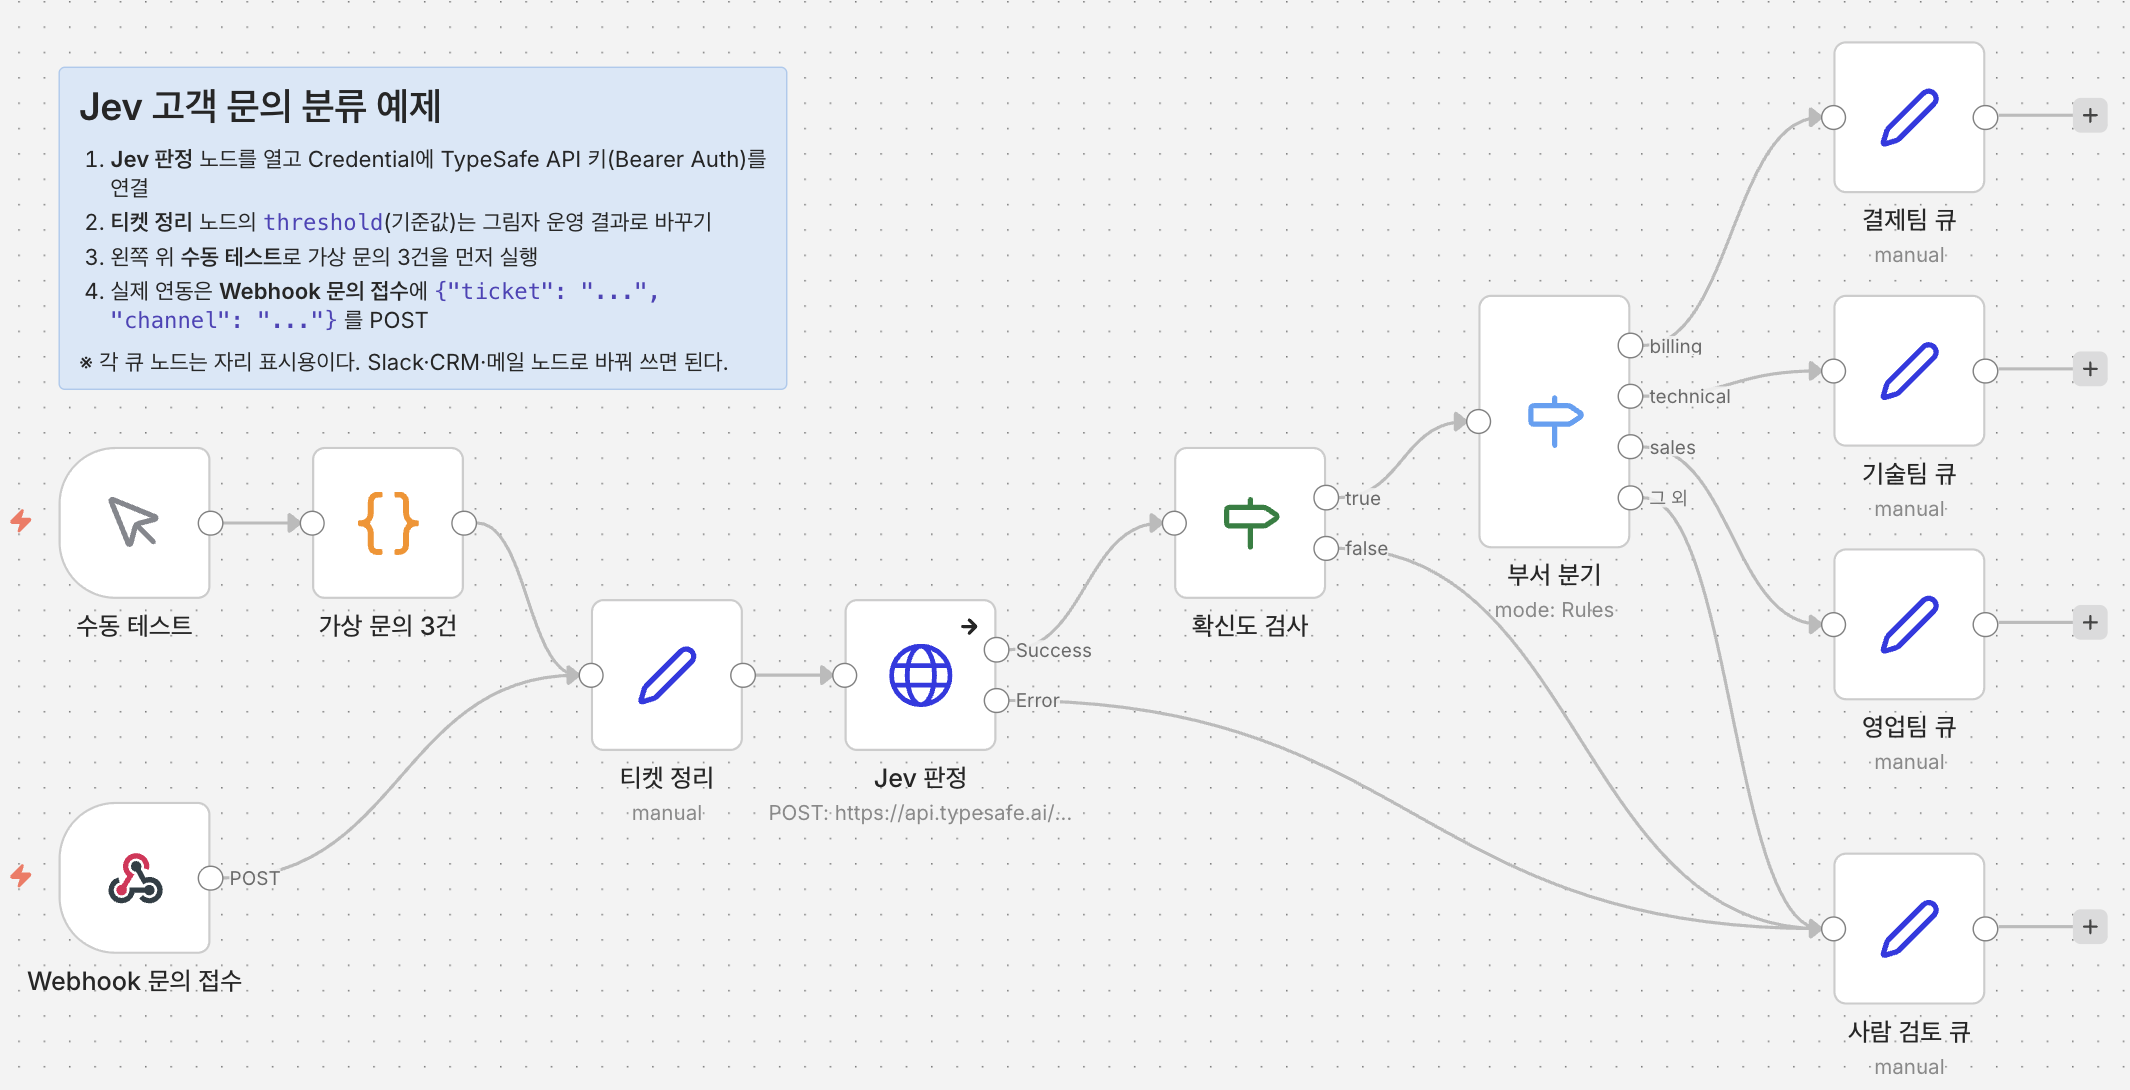
노드별 역할은 이렇다.
이름은 한글로 붙여 두었으니 캔버스에서 바로 찾을 수 있다.
| 노드 | 하는 일 | 바꿔 쓸 곳 |
|---|---|---|
| 수동 테스트 → 가상 문의 3건 | 편집기에서 바로 돌려 볼 가상 문의 3건(결제·섞인 문의·영업)을 만든다 | 실제 데이터는 넣지 않는다 |
| Webhook 문의 접수 | 외부에서 POST /jev-ticket으로 들어온 문의를 받는다 |
쇼핑몰·CS 도구의 웹훅 주소로 연결 |
| 티켓 정리 | ticket(문의 본문)·channel(문의 경로)만 남기고, 자동 처리 기준값 threshold를 둔다 |
threshold는 그림자 운영 결과로 바꾸기 |
| Jev 판정 | TypeSafe API에 department(Choice)·is_urgent(Noul)를 묻는다. 오류가 나면 두 번째 출력(에러 출력)으로 보낸다 | Credential(자격 증명) 연결 필수 |
| 확신도 검사 | 답이 other가 아니고 확신도가 기준값 이상인지 본다 |
|
| 부서 분기 | billing(결제)·technical(기술)·sales(영업)로 나누고, 그 외는 사람 검토로 보낸다 | |
| 결제팀·기술팀·영업팀 큐 | 부서별로 결과를 정리해 두는 자리 표시용 노드 | Slack·CRM·메일 노드로 교체 |
| 사람 검토 큐 | 확신도가 낮거나 other인 문의, API 오류(402 등)가 모두 모인다. reason으로 이유를 구분한다 |
상담원 알림이나 검토용 시트로 연결 |
요청 본문은 JSON.stringify()로 만들도록 해 뒀다. 문의 본문에 큰따옴표나 줄바꿈이 섞여 있어도 JSON이 깨지지 않게 하려는 것이다. 질문과 선택지는 앞의 cURL 예제와 같다.
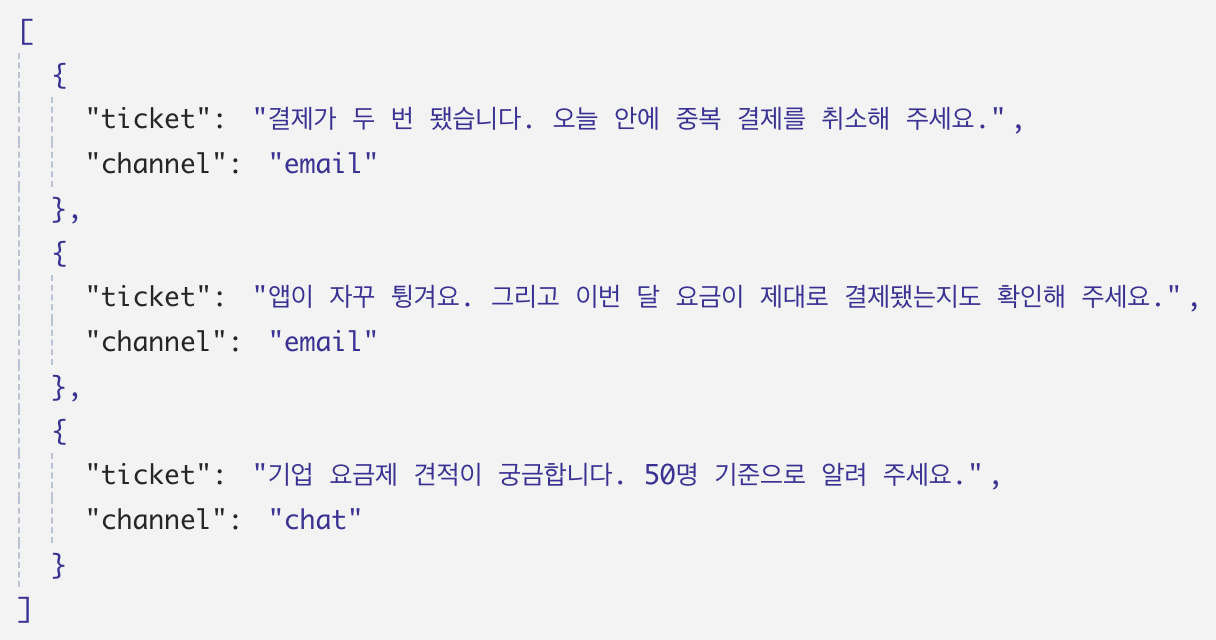
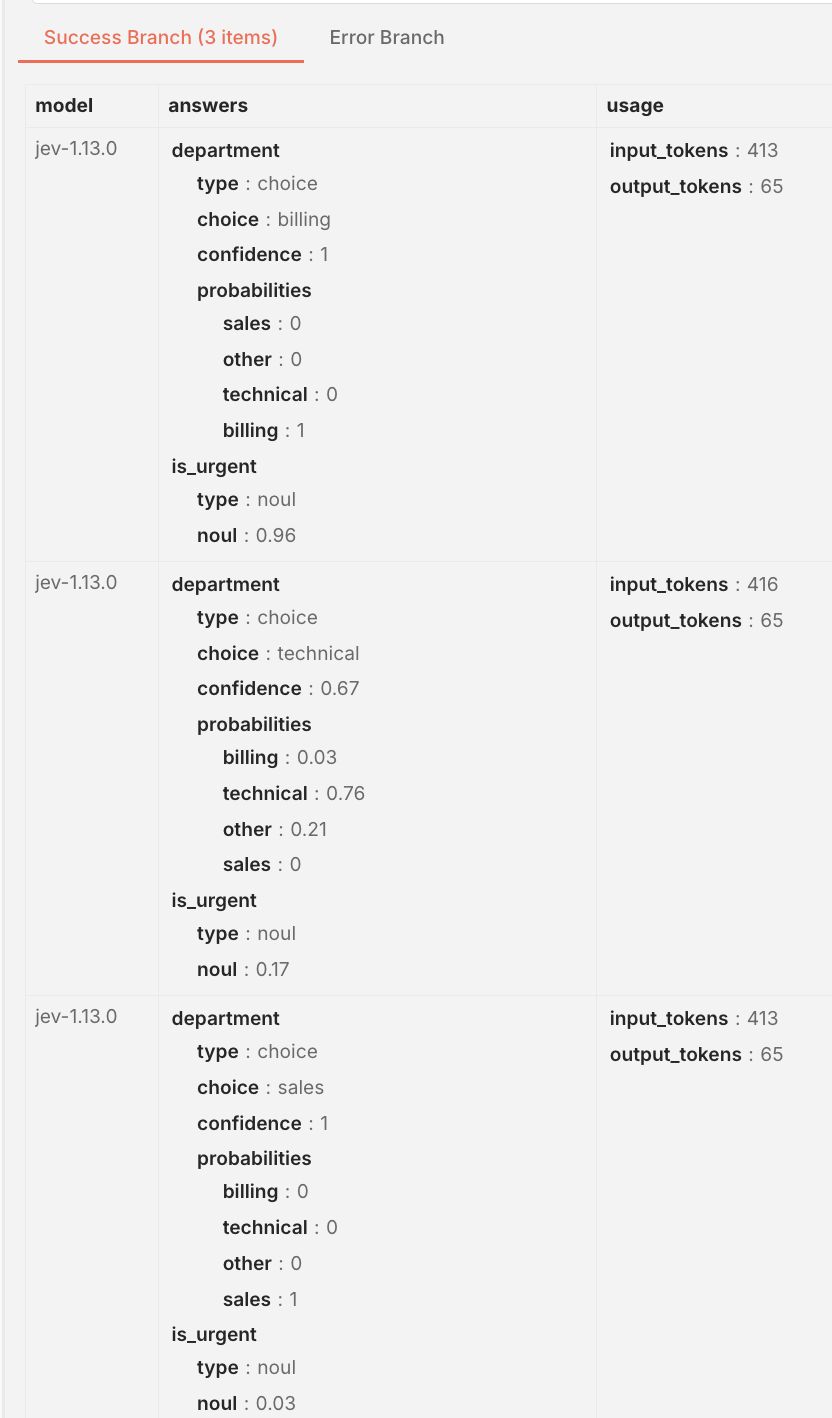
올바르게 실행되면 3건의 샘플 문의(티켓)가 결과에 따라 부서별 큐나 사람 검토 큐로 나뉘는 모습을 볼 수 있다.
ex) 티켓 예시
ex) 응답 결과
ex) 확신도 검사: 답이 other가 아니고 confidence(확신도)가 0.8 이상이면 True, 아니면 False로 보내는 노드다.
- 2건이 True(각각 응답 결과에 적힌 부서로 전달), 1건이 False (사람이 검토)
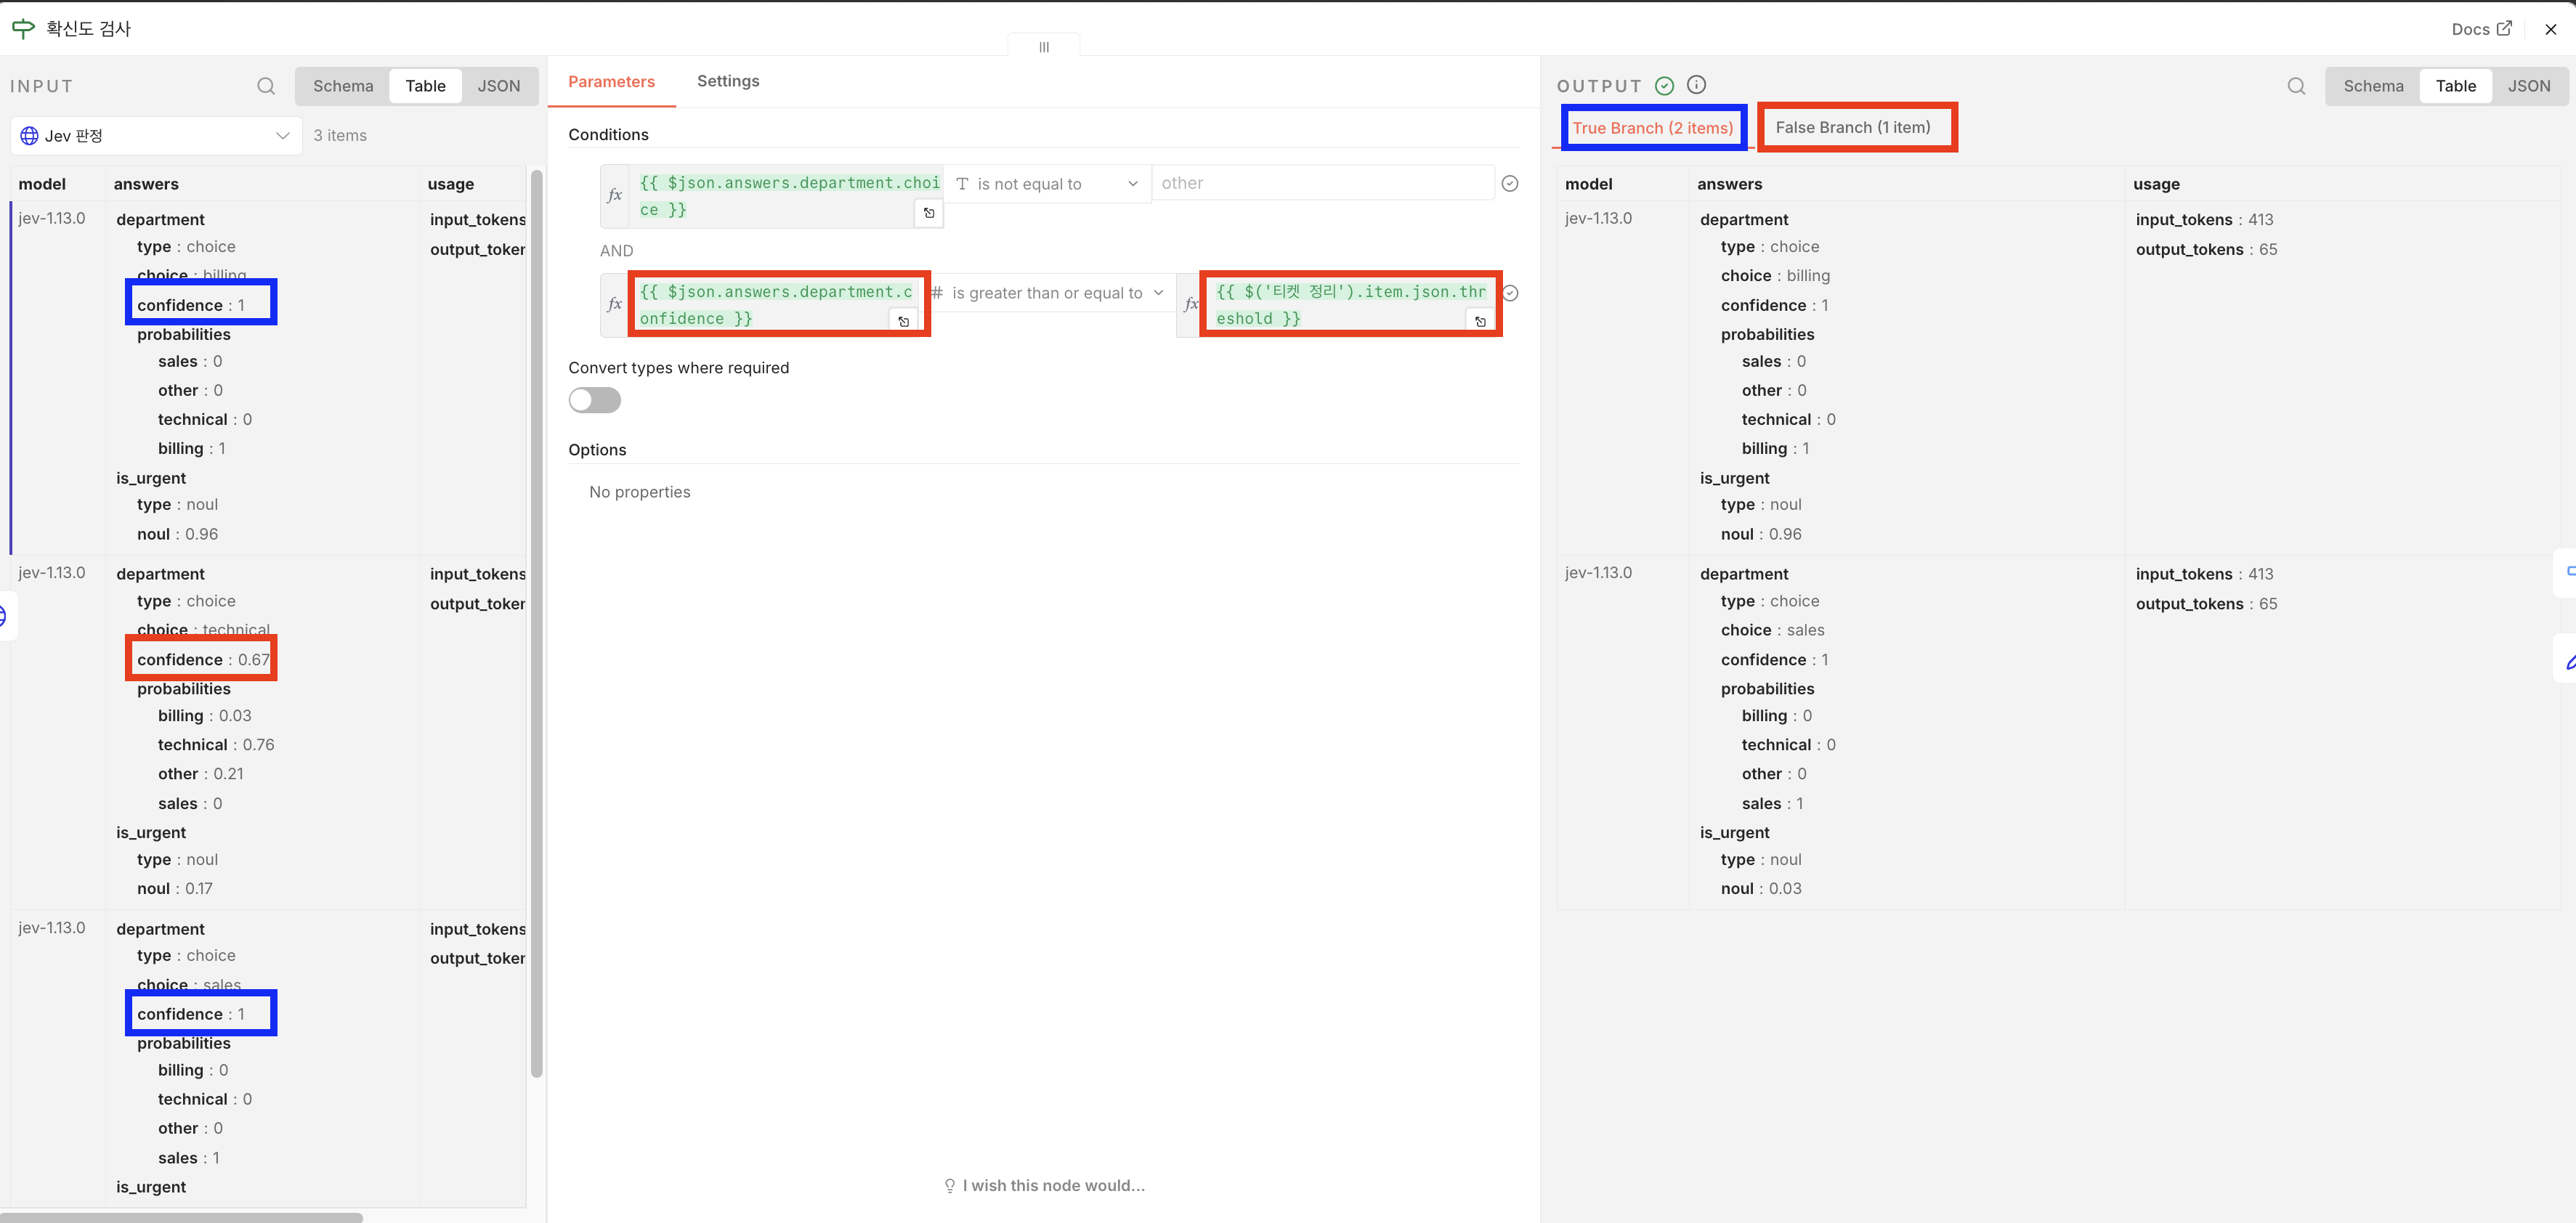
ex) 실제 실행 결과를 보면 3건의 문의 모두 정상 응답을 받았고
> 확신도 검사 (현재 예시에서는 0.8) > 1건은 사람 검토 / 2건은 각각 담당 부서인 결제, 영업팀으로 나뉘어 전달되었다.
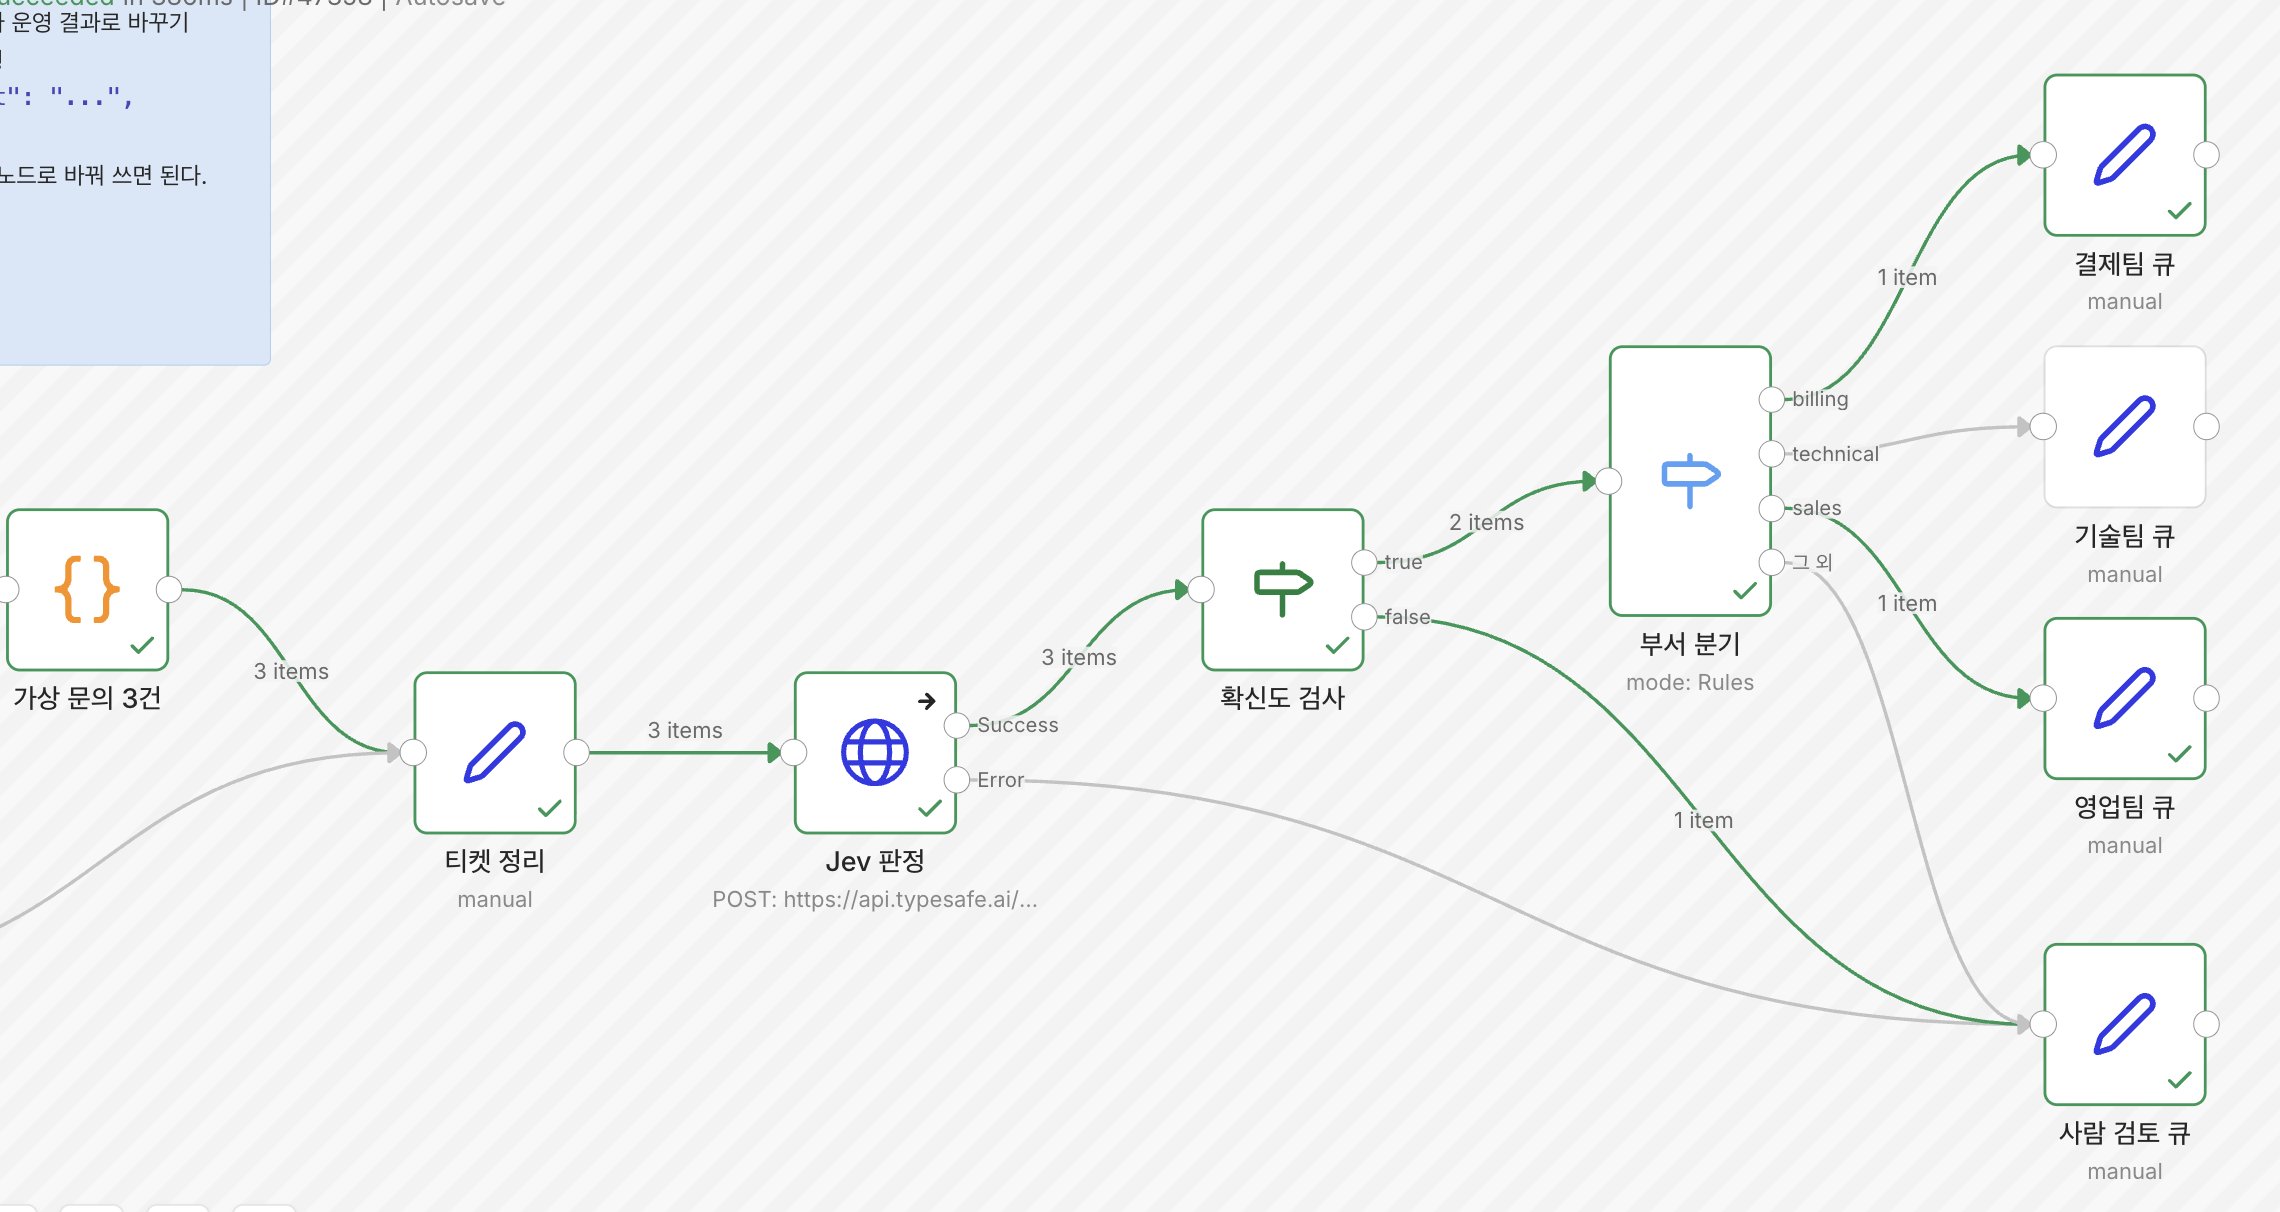
결제 문의는 결제팀 큐, 견적 문의는 영업팀 큐로 가고, 두 문제가 섞인 문의는 확신도가 낮으면 사람 검토 큐로 간다.
크레딧이 없거나 키가 틀렸다면: 세 건 모두 사람 검토 큐로 가고, reason이 jev_api_error, error에 402나 401 메시지가 남는다. 판정이 실패해도 문의가 사라지지 않고 사람에게 넘어가는 구조로 만들었다.
수동 테스트가 잘 되면 Webhook 문의 접수 노드를 열어 테스트 주소를 확인하고, 테스트 이벤트 대기 상태에서 아래처럼 요청을 보내 보자. 로컬 n8n 기준 예시이고, 주소는 노드 화면에 표시된 값을 쓰면 된다.
curl -X POST http://localhost:5678/webhook-test/jev-ticket \
  -H "Content-Type: application/json" \
  -d '{"ticket": "결제가 두 번 됐습니다. 오늘 안에 취소해 주세요.", "channel": "email"}'
응답으로는 마지막에 실행된 큐 노드의 결과(route, department, confidence 등)가 돌아온다.
운영용 주소는 워크플로를 활성화(버전에 따라 게시)한 뒤 /webhook/jev-ticket으로 바뀐다.
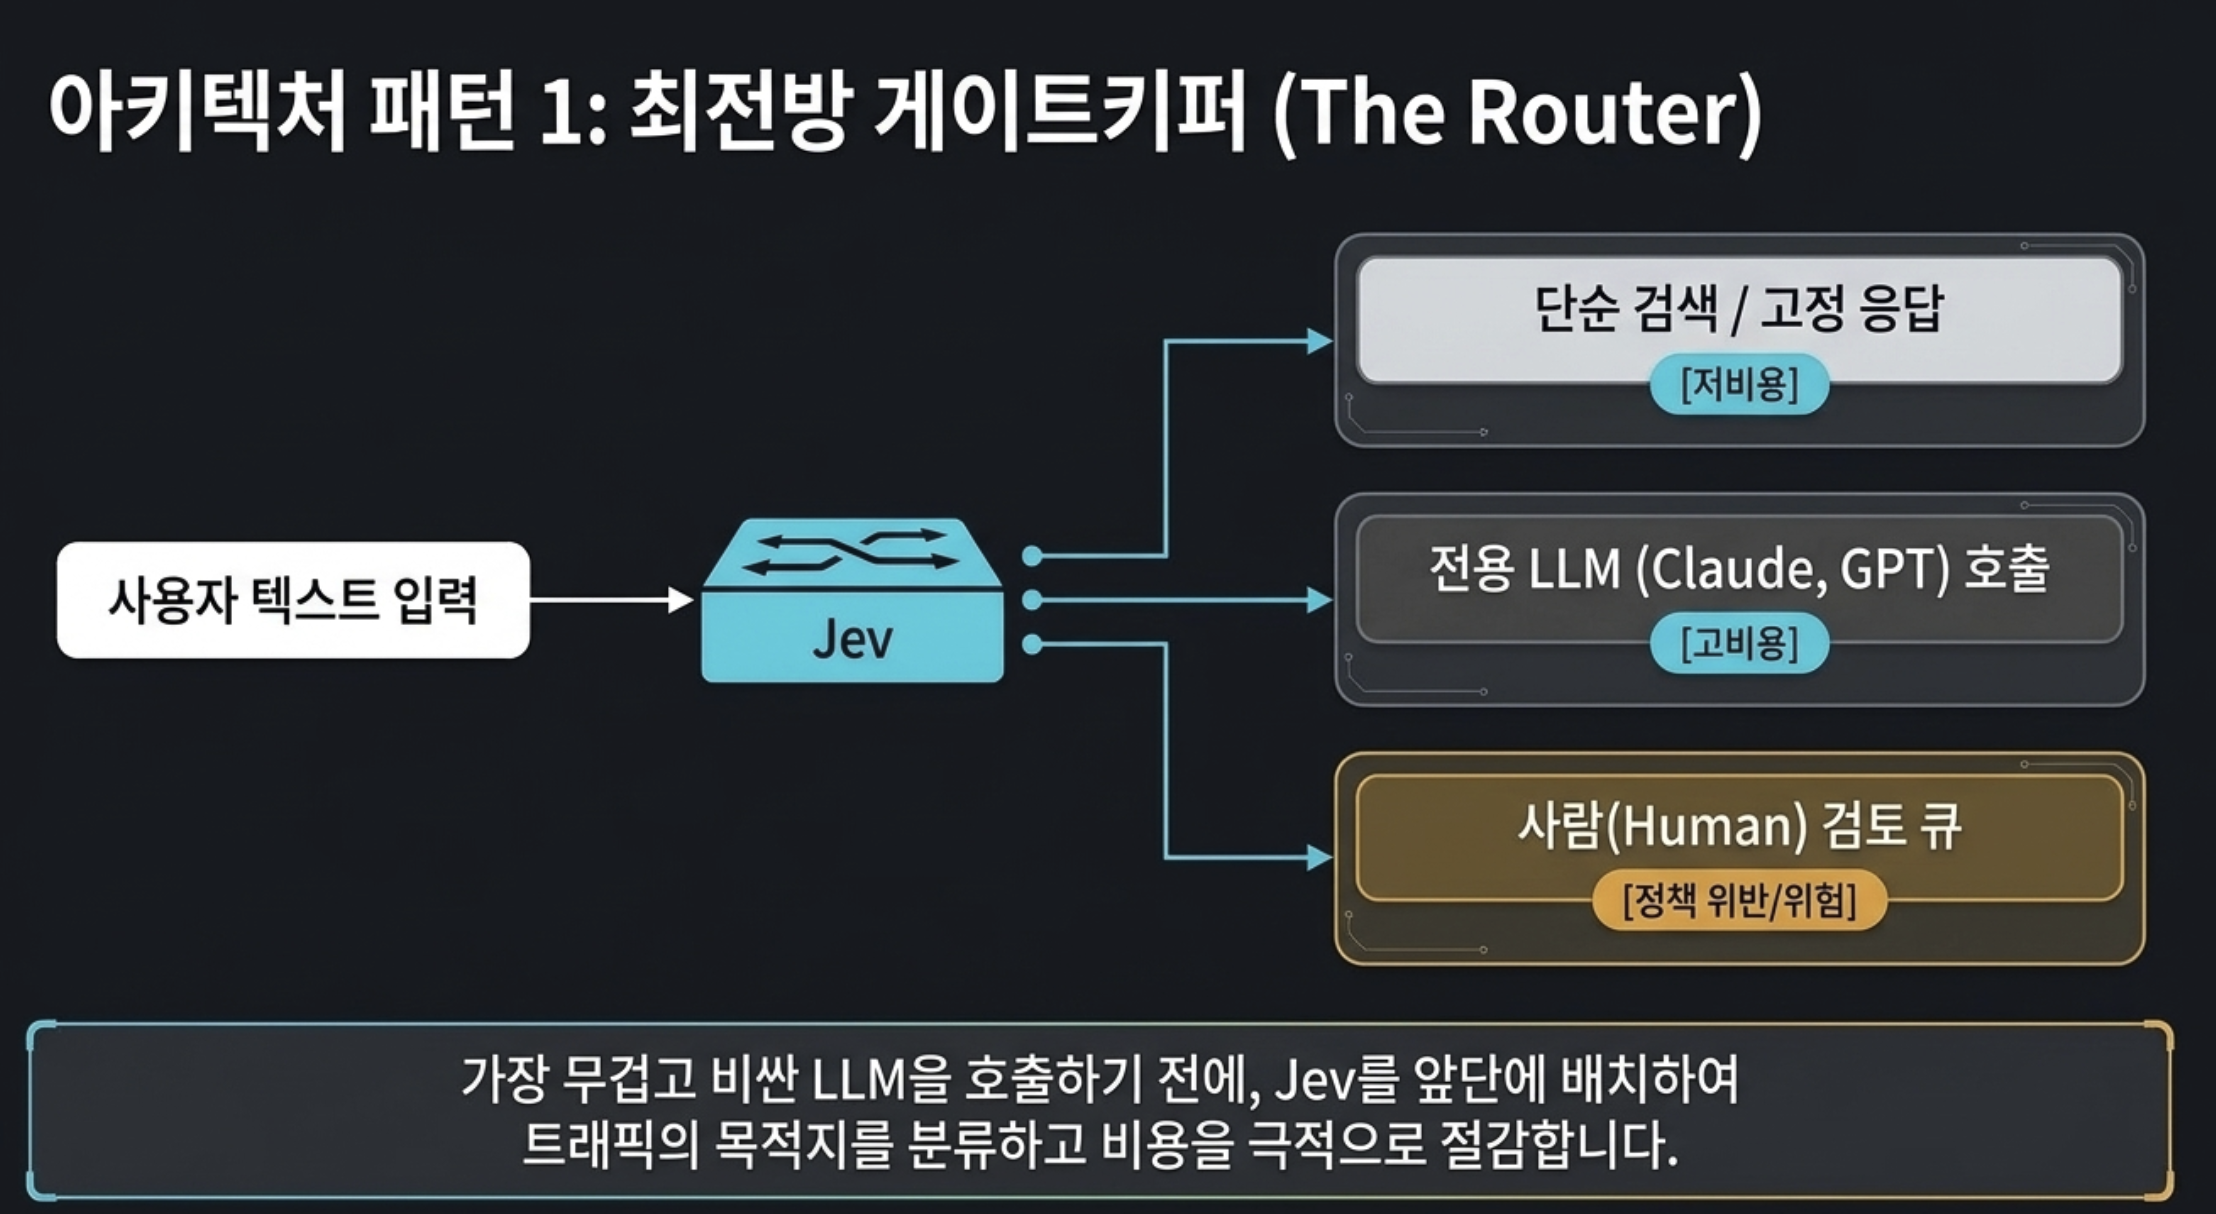
Jev를 "코딩 모델"로 붙이는 게 아니다. 비싼 모델이나 도구를 부르기 전에 어느 길로 보낼지 정하는 데 쓴다.
LangChain 블로그에도 Jev는 LLM을 대신하는 모델이 아니라고 적혀 있다.
애초에 글을 쓰는 모델이 아니기 때문이다. 길게 생각하고 글을 쓰는 건 LLM이, 그 사이사이 빠른 판단은 Jev가 맡는 조합으로 보면 된다.
LangChain 공식 블로그(9월 17일)에는 langchain-typesafe 패키지의 TypeSafeClassifier 사용법과 함께, 요청에 맞는 모델을 골라 주는 ModelRouterMiddleware, 위험한 도구 호출을 실행 전에 막는 AutoModeMiddleware 예제가 나온다.
다만 두 미들웨어는 langchain_typesafe.experimental 경로에 들어 있는 실험 기능이다. 바로 운영에 쓰기보다는 테스트 환경에서 버전을 고정해 두고 써 보는 게 좋겠다.
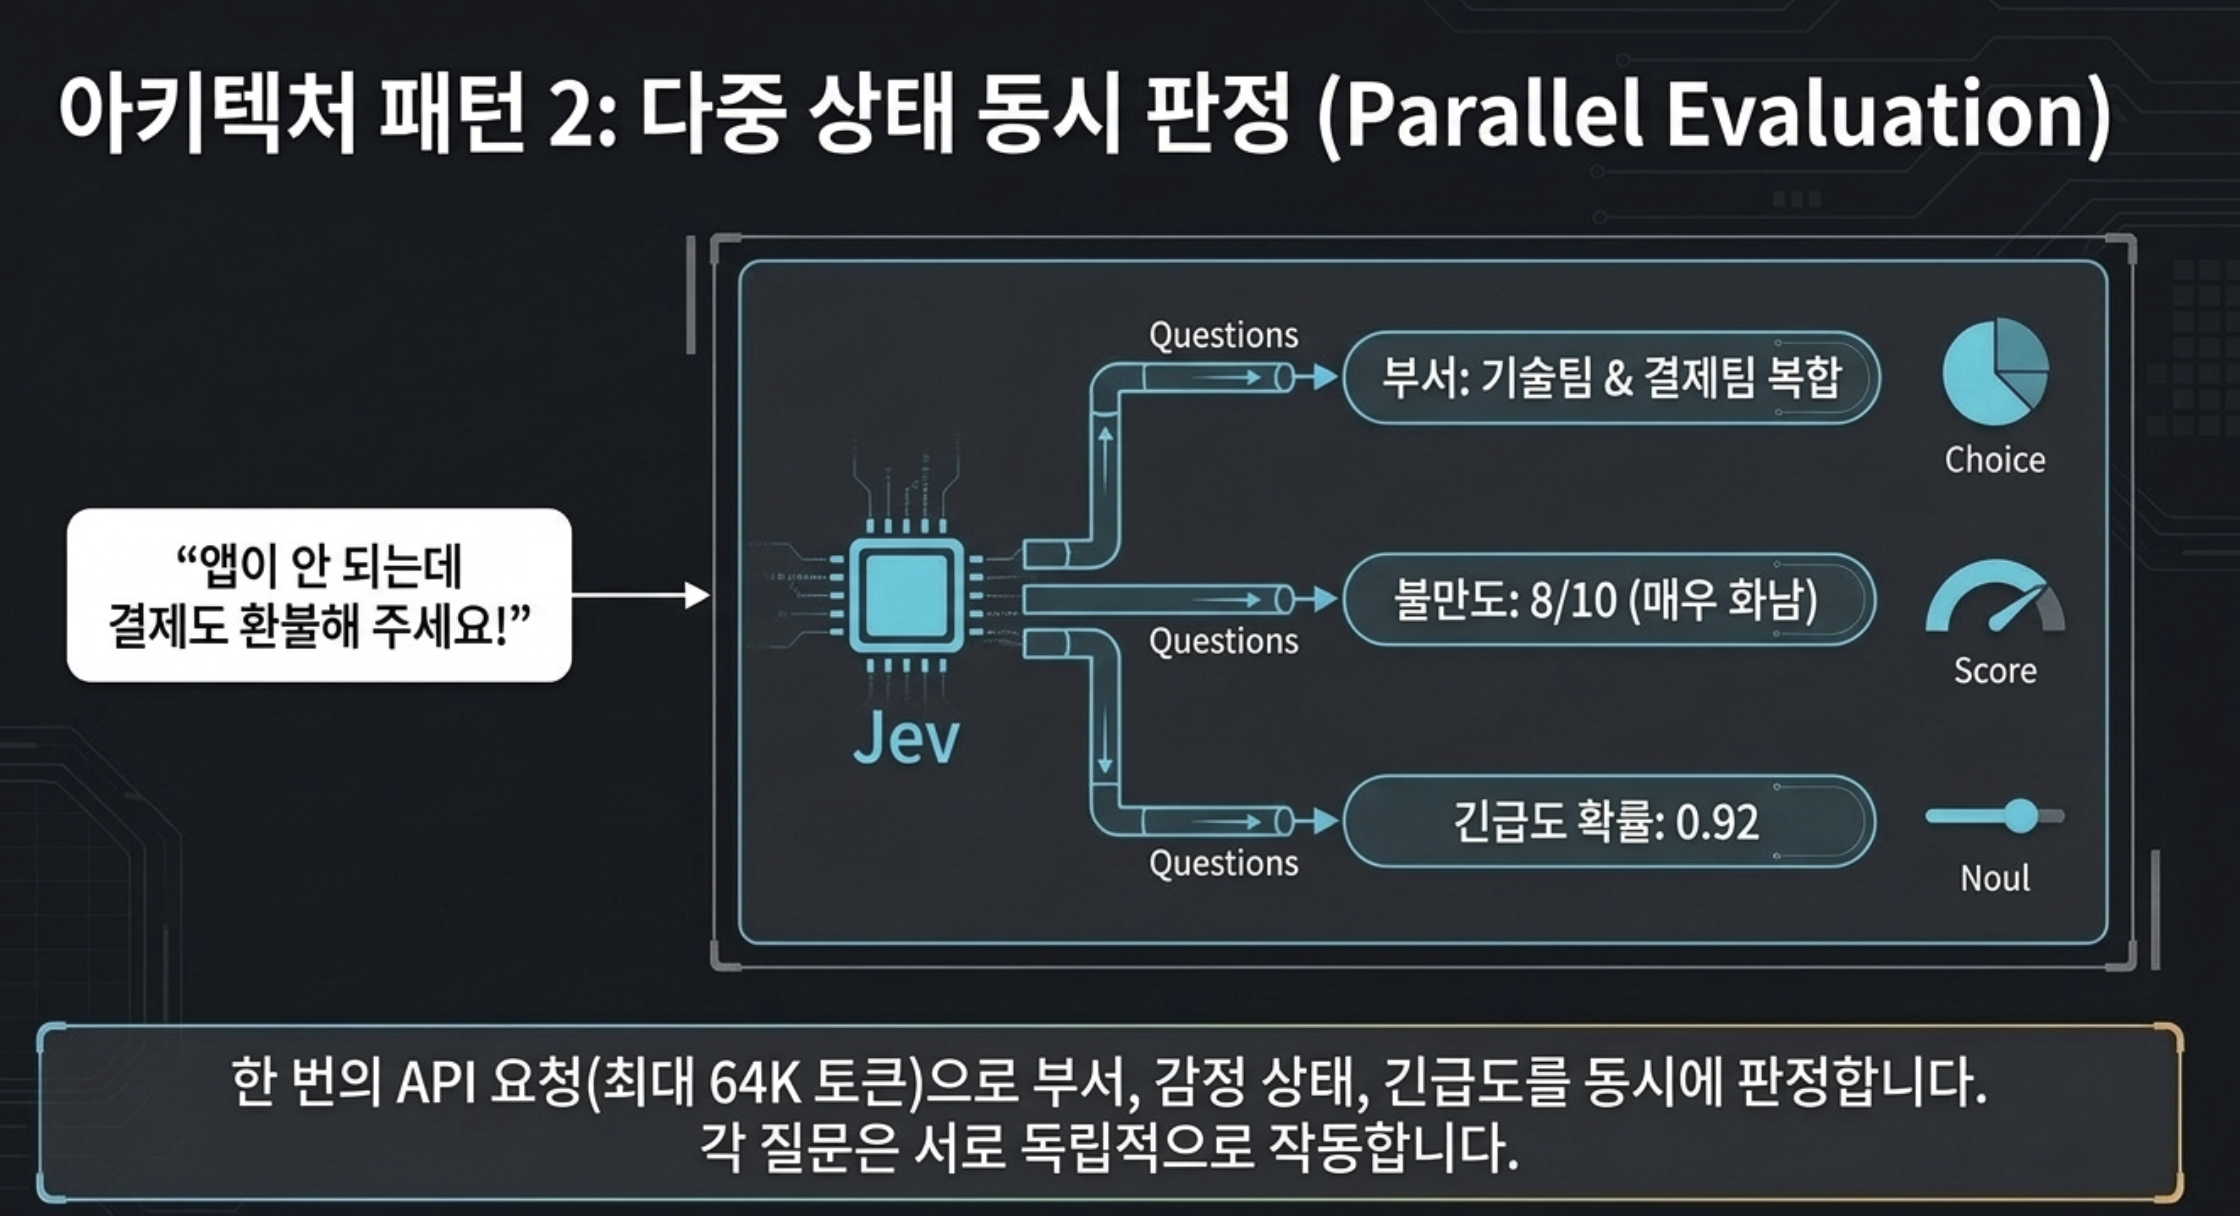
문의 하나에서 담당 부서, 이탈 위험, 폭언 여부, 긴급도를 한 번에 묻고 결과를 CRM 필드에 저장할 수 있다. 다만 질문 하나에는 판단 하나만 맡기고, 자동 환불이나 계정 정지처럼 되돌리기 어려운 일은 Jev 답 하나만 믿고 실행하면 안 된다.
Jev로 다음 주 주가나 목표 수익률을 계산하게 하는 건 맞지 않는다.
공식 문서도 계산과 날짜 비교를 약점으로 꼽는다.
대신 공시나 뉴스를 읽고 "어떤 종류의 사건인가?", "위험 신호가 있나?"를 정해진 항목으로 분류하는 데는 쓸 수 있다.
{
  "state": {
    "source": "official_filing",
    "headline": "회사는 핵심 제품의 연간 매출 가이던스를 하향 조정했다.",
    "body": "...검증된 공시 원문..."
  },
  "model": "jev-latest",
  "questions": {
    "event_type": {
      "type": "choice",
      "instructions": "Classify the primary corporate event.",
      "criteria": {
        "earnings_guidance": "Earnings results or forward guidance",
        "regulatory": "Regulatory or legal action",
        "capital_action": "Financing, buyback, dividend, or issuance",
        "operations": "Product, supply chain, or operational event",
        "other": "None of the above"
      }
    },
    "materiality": {
      "type": "score",
      "instructions": "Rate potential business materiality based only on the text.",
      "criteria": [
        "Limited or unclear impact",
        "Meaningful but contained impact",
        "Potentially company-wide material impact"
      ]
    },
    "downside_risk": {
      "type": "noul",
      "instructions": "Could this event materially harm next-quarter operations?"
    }
  }
}
예시 속 영어 질문과 선택지는 이런 뜻이다.
| 이름 | 코드 안의 영어 | 뜻 |
|---|---|---|
event_type |
Classify the primary corporate event. |
(사건 유형, Choice) 회사의 주요 사건을 분류하라 |
earnings_guidance |
Earnings results or forward guidance |
실적 발표 또는 향후 실적 전망 |
regulatory |
Regulatory or legal action |
규제 또는 법적 조치 |
capital_action |
Financing, buyback, dividend, or issuance |
자금 조달·자사주 매입·배당·증권 발행 |
operations |
Product, supply chain, or operational event |
제품·공급망·운영 관련 사건 |
other |
None of the above |
위 항목에 해당 없음 |
materiality |
Rate potential business materiality based only on the text. |
(사업 영향도, Score) 본문만 보고 사업에 미칠 영향의 크기를 평가하라 |
| 단계 0 / 1 / 2 | Limited or unclear impact / Meaningful but contained impact / Potentially company-wide material impact |
영향이 작거나 불분명함 / 의미 있지만 제한적인 영향 / 회사 전체에 중대한 영향 가능 |
downside_risk |
Could this event materially harm next-quarter operations? |
(하방 위험, Noul) 이 사건이 다음 분기 운영에 중대한 타격을 줄 수 있는가? |
숫자 계산, 날짜 정리, 종목 매핑, 중복 제거는 코드가 맡는다. 결과는 리서치 우선순위나 알림에 쓰고, 실제 매수·매도는 검증된 데이터와 별도 리스크 엔진, 사람 승인을 거치게 해야 한다. 이 예시는 투자 조언이 아니라 시스템 설계 예시다.
Jev가 공개된 뒤 브라우저 조작, 게임, 코드 검색, 컨텍스트 정리, 데이터 선별, 거래 실험까지 다양한 저장소가 빠르게 나왔다.
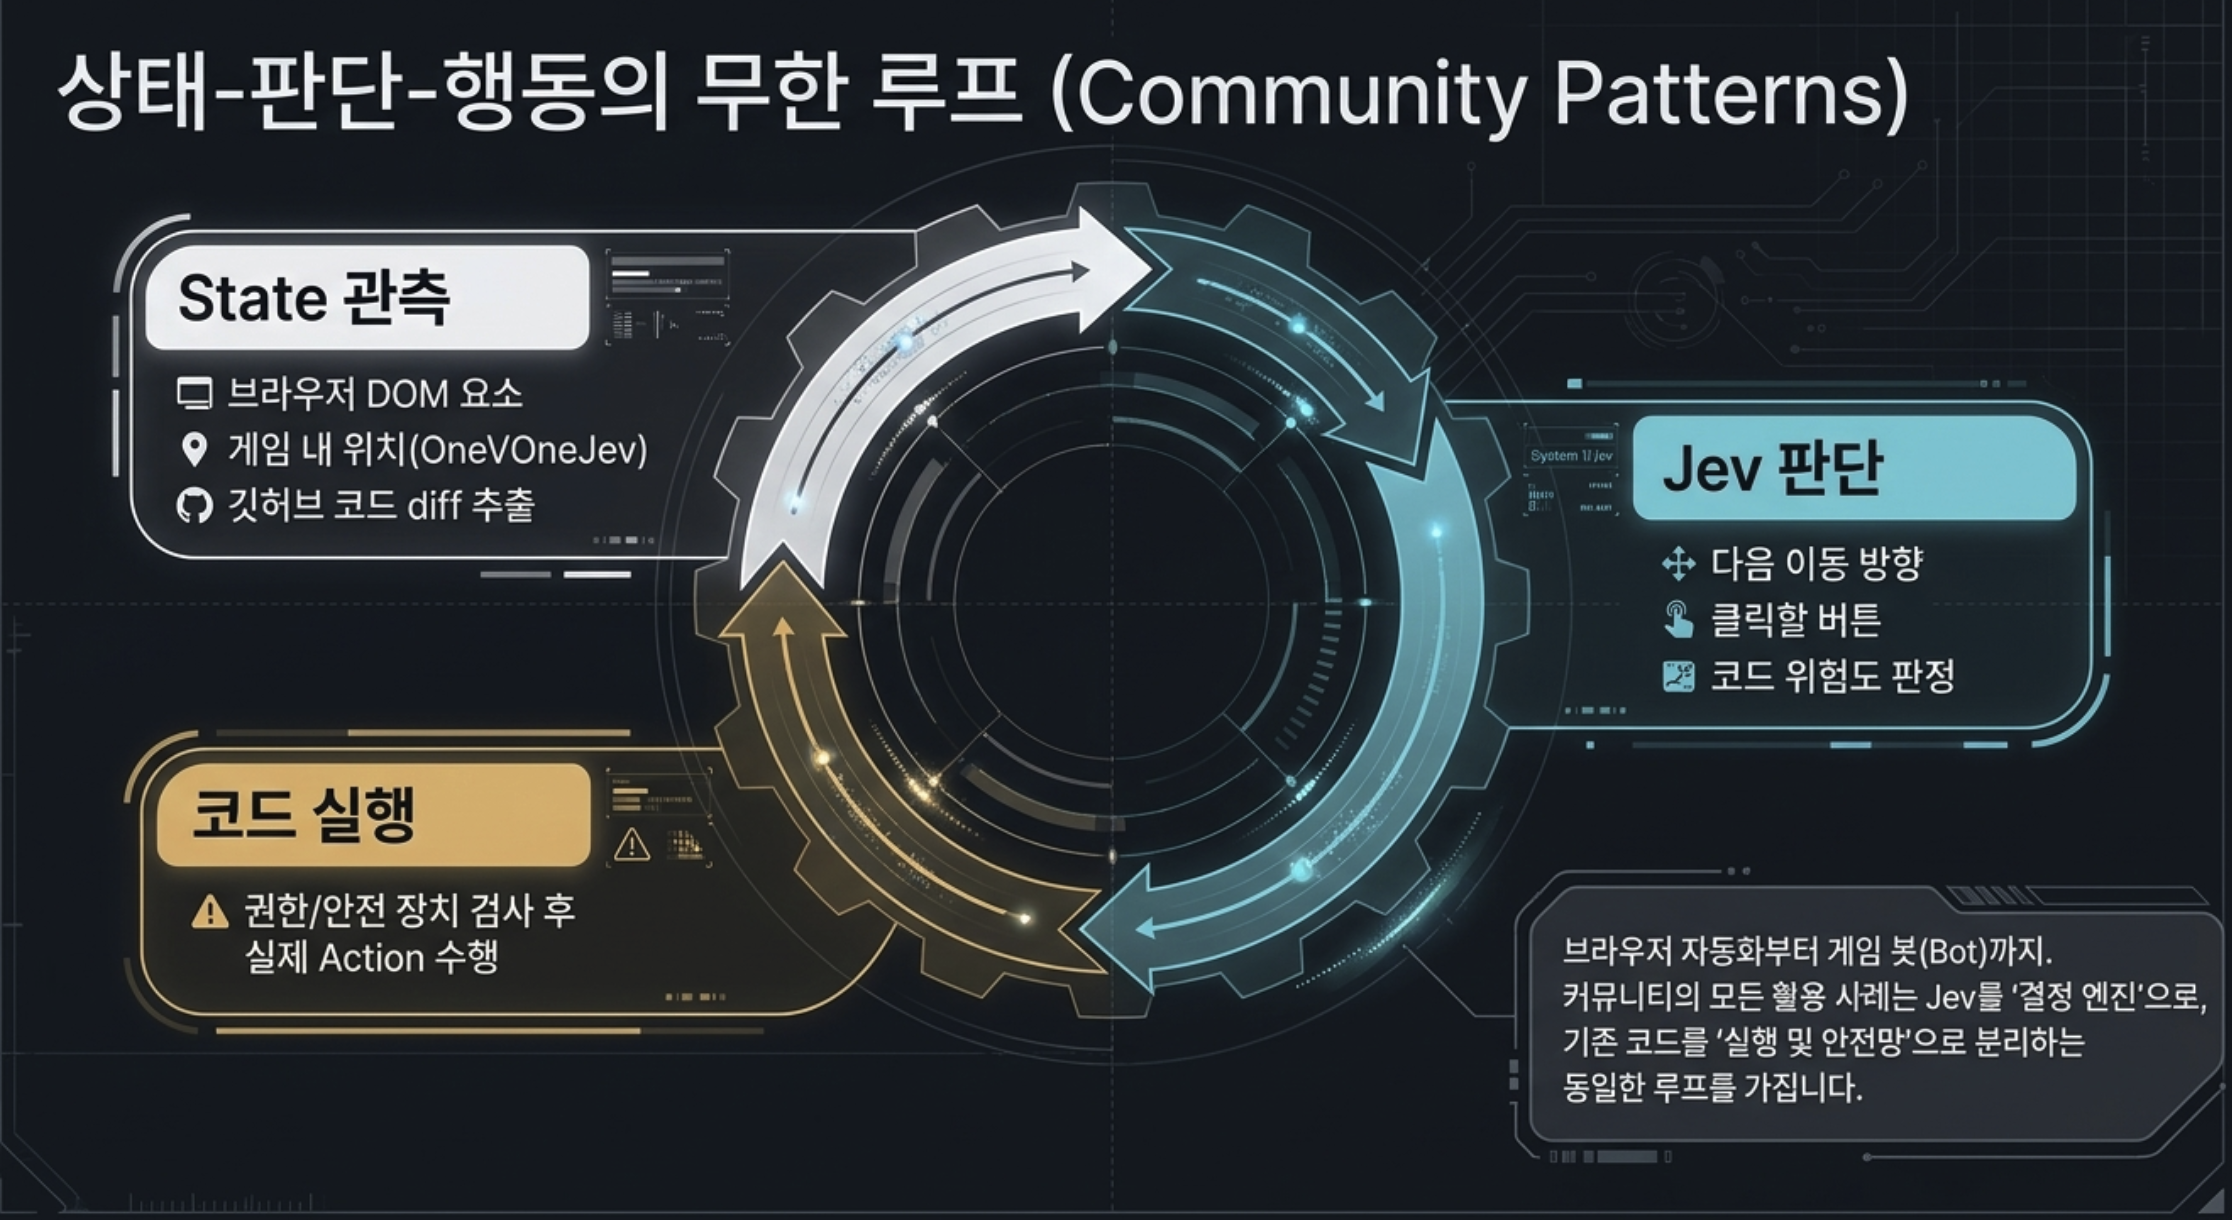
그렇다고 Jev가 뭐든 된다는 뜻은 아니다.
개발자들이 "상황을 읽고 정해진 행동 중 하나를 고르는 문제"를 어디에서 찾아냈는지 보는 정도로 읽으면 된다.
아래 내용은 각 저장소 README를 기준으로 정리했다. agent-desktop과 Prism 저장소에서는 Jev·TypeSafe 연동 설명을 찾지 못했다. json-render의 Jev 연동은 아직 실험 단계이고 정식 출시 전이다. jev-drone은 실제 드론이 아니라 MuJoCo 시뮬레이터에서 동작한다. 저장소는 계속 바뀌니 실행 전에 README를 다시 확인해보자.
아래 전체 목록을 다 읽거나 실행할 필요는 없다.
전체 표는 나중에 아이디어가 필요할 때 찾아보는 참고용이다.
state-demo를 뺀 나머지 실습은 내 TypeSafe 키로 실제 호출을 하므로 크레딧이 차감된다.
state-demo
참고용 전체 프로젝트 목록
| 프로젝트 | 저장소에서 확인한 실제 역할 | 따라 하기 난이도 | 주의할 점 |
|---|---|---|---|
| jev-ultrafast | 웹페이지의 버튼·입력창 목록에서 조작할 대상을 고르고, 글자 입력만 작은 LLM에 맡기는 브라우저 에이전트 | 중급 · 공개 웹 탐색만 권장 | Jev 키와 텍스트 모델 키가 모두 필요. 7.1초는 한 작업·적은 반복 횟수로 잰 프로젝트 측정값 |
| fast-jev-compaction | Claude Code의 도구 호출과 결과를 남길지 판정해 컨텍스트를 줄임 | 고급 · 복사본 저장소에서만 | 대화·도구 입력이 API로 전송되고, 필요한 기록을 잘못 버릴 수 있음 |
| json-render | 허용된 컴포넌트·속성·레이아웃을 고르는 생성형 UI 실험 | 소스 읽기용 | Jev 조합은 실험 단계·미출시로 표시됨 |
| typesafe-mcp | Claude Code·Claude Desktop·Codex·Pi에서 Jev 판정을 부르는 MCP 서버 | 중급 · 가짜 데이터로 시험 권장 | 서드파티 실행 파일과 MCP 설정을 먼저 검토 |
| jev-mcp | 사실 확인 보조·선별·재정렬·분류·코드 검토 등 10개 판정 도구 제공 | 중급 · 기능별로 시험 | README도 초기 단계 소프트웨어라고 밝힘. 모델 판단을 사실 확인의 최종 증거로 쓰면 안 됨 |
| SemDecide | 표준 입력과 JSONL을 분류·점수화·필터링하고 결과를 종료 코드로 돌려줌 | 입문 실습 추천 | PyPI가 아닌 GitHub 릴리스 파일로 설치하므로 버전을 고정하고 출처 확인 |
| jev-codex-router | Codex 호출마다 모델과 추론 강도를 골라 줌 | 고급 · 전용 시험 환경 | 라우터 포크·프록시·여러 자격 증명이 끼어 있음. 약 60% 수치는 과거 237턴 시뮬레이션이지 실제 절감량이 아님 |
| Winnow | 긴 Read·Bash·Grep 결과를 블록별로 판정해 걸러내되, 복원용 캐시에 보관 | 고급 · 복사본 저장소에서만 | 필요한 내용이 빠질 위험과 코드·로그 외부 전송을 함께 검토 |
| jev-review | Git diff나 코드베이스의 위험 신호를 단계별로 판정해 로컬 대시보드에 표시 | 중급 · 샘플 저장소 | Node.js 24 이상 필요. 결과는 결함의 증명이 아니라 검토 후보 |
| Blink | 파일 트리를 여러 갈래로 탐색해 질문과 관련된 파일을 찾음 | 중급 · 작은 공개 저장소 | Bun 1.3.14 이상 필요. 비공개 코드가 어디까지 전송되는지 먼저 확인 |
| agent-desktop | 접근성 트리 기반 데스크톱 자동화 도구 | Jev 사례에서는 제외 | README에서 Jev·TypeSafe 연동을 확인하지 못함. macOS 접근성 권한도 필요 |
| typesafe-mario | 에뮬레이터 메모리·실행 상태값을 JSON으로 바꿔 정해진 조작 중 하나를 고름 | 입문 · state-demo부터 |
Python 3.13 이상, 합법적으로 준비한 ROM·에뮬레이터 필요. 저장소는 ROM을 제공하지 않음 |
| jev-drone | MuJoCo 시뮬레이터에서 초당 몇 차례 상승·감속·회피 같은 큰 방향을 정함 | 구조 읽기 추천 | 실제 드론 사례가 아님. 더 빠른 안전 검사와 자세 제어는 일반 코드가 담당 |
| OneVOneJev | 브라우저 1인칭 슈팅 게임에서 이동·시선·조준·발사·점프를 정해진 선택지로 판정 | 눈으로 보는 실습 추천 | 경기 중 초당 약 9회 호출하므로 짧게 실행하고 사용량 확인 |
| jev-trader | 주문장 상태를 보고 매 블록마다 매수·매도 방향을 판정 | 읽기 · 모의 실행만 | PRIVATE_KEY를 넣으면 실제 주문이 나갈 수 있음. 기본 mock 실행과 Jev 실행도 구분해야 함 |
| Prism | 자동 유동성(LP) 재조정 프로젝트 | Jev 사례에서는 제외 | README에서 Jev·TypeSafe 연동을 확인하지 못함 |
| neo4jev | Neo4j 그래프에서 다음 관계를 Choice로 고르고, 목표에 도달했는지 Noul로 판단 | 중급 · 그래프 탐색 | 공개 데모 DB나 별도 Neo4j 환경 필요. 대체 답은 실제 Jev 출력과 구분돼 표시됨 |
| jev-curate | JSONL·Parquet 학습 데이터를 품질·관련성·위험 기준으로 선별 | 고급 · 작은 공개 데이터부터 | 초당 1,500행 이상은 프로젝트 주장. 데이터가 외부 API로 나가는 점을 먼저 검토 |
| Canny | 코딩 에이전트의 편집·테스트 기록은 코드로 확인하고, "완료했다"는 주장과 규칙 위반만 Jev에 물음 | 고급 · 복사본 저장소 | 훅 설정을 바꿈. 코드 조각과 최종 메시지가 API로 전송될 수 있음 |
| Kill My Idea | 아이디어를 8개 점수와 분야·이해 가능성으로 평가해 KILL(접기)·FIX(보완)·SHIP(출시)으로 판정 | 입문 UI 실습 추천 | 사업 성공 예측기가 아님. 평가 결과가 기본적으로 로컬 SQLite에 저장됨 |
표만 보면 어떤 느낌인지 잘 안 와닿을 수 있어서, 작성자가 직접 올린 짧은 데모 영상 세 개를 붙여 둔다.
① jev-ultrafast — 버튼·입력창을 고르는 브라우저 에이전트
Browser Use 팀이 올린 데모다. 게시물의 속도·비용 수치는 작성자가 한 작업으로 잰 값이라, 사이트와 작업이 달라지면 결과도 달라질 수 있다. (출처: X @gregpr07)
② fast-jev-compaction — Claude Code 컨텍스트 줄이기
도구 호출 기록 중 남길 것과 버릴 것을 Jev로 판정해 컨텍스트를 줄이는 데모다. (출처: X @tamarajtran)
③ jev-trader — 주문장 보고 매수·매도 방향 판정
주문장 상태를 보고 방향을 고르는 데모다. 영상은 실제 주문 환경에서 찍은 것이니, 따라 할 때는 앞의 표 설명처럼 PRIVATE_KEY 없이 모의 실행만 해보자. (출처: X @jarrodwatts)
게임은 입력과 선택지, 실행 결과가 모두 눈에 보여서 Jev와 기존 코드의 역할을 나눠 보기 좋다.
현재 위치·적·장애물·속도처럼 상태가 분명하고, 이동·점프·발사처럼 할 수 있는 행동도 정해져 있다.
흐름: 상태 수집 → JSON 변환 → Jev가 후보 중 하나 선택 → 코드가 권한·제약 확인 후 실행 → 결과 기록
말로만 보면 감이 잘 안 오니, 해외 개발자들이 X(트위터)에 올린 데모 영상을 몇 개 모아 봤다. 모두 게임 화면 이미지를 보는 게 아니라, 게임 상태를 JSON으로 바꿔 Jev에 보내고 정해진 조작 중 하나를 고르게 하는 방식이다.
① 슈퍼 마리오 — 에뮬레이터 상태를 읽고 조작 고르기
Faadil Shaik이 올린 마리오 플레이 영상이다. 위 표의 typesafe-mario와 같은 주제의 데모로, 게시물에 저장소 링크가 따로 붙어 있지는 않다. (출처: X @faadilhshaik)
② 서브웨이 서퍼 — 레인 이동·점프·슬라이드 판단
달리는 동안 왼쪽·오른쪽·점프·슬라이드 중 하나를 계속 고르는 데모다. 영상이 3분 정도로 길다. (출처: X @_MaxBlade)
③ 대난투 스타일 격투 게임 — 이동·공격 선택
격투 게임에서 캐릭터의 이동과 공격을 판정하는 데모다. (출처: X @maubaron)
④ Doom — TypeSafe 창업자가 직접 올린 데모
TypeSafe 창업자 디오구 알메이다(Diogo Almeida)가 출시 스레드에 답글로 올린 Doom 플레이 영상이다. 게시물에 적힌 "초당 약 10회 호출, 시간당 약 $7" 같은 수치는 작성자 주장이라 실제 비용은 내 사용량으로 따로 확인해야 한다. (출처: X @CompleteSkeptic)
네 영상 모두 원리는 같다. 게임이 상태를 JSON으로 만들고, Jev는 정해진 조작 중 하나만 고르고, 실제 움직임과 충돌 처리는 게임 코드가 맡는다.
참고로 X 게시물은 작성자가 삭제하거나 비공개로 바꾸면 이 자리에 보이지 않을 수 있다.
기본 브랜치는 계속 바뀐다. 실행할 커밋이나 릴리스 태그를 기록해 두고, 패키지 스크립트와 lockfile(의존성 고정 파일)을 먼저 훑어보자.
가능하면 SSH 키나 클라우드 자격 증명이 없는 일회용 폴더·컨테이너에서 실행하고, Jev 키도 이 실습 전용 키를 쓰는 게 좋다. 로컬 웹 서버는 127.0.0.1에만 열고, 포트 공개나 외부 터널링은 하지 말자.
터미널만으로 결과를 볼 수 있어서 첫 실습으로 좋다. Python 3.10 이상이 필요하고, 아직 PyPI가 아니라 GitHub 릴리스 파일로 설치하도록 안내돼 있다.
아래처럼 버전을 고정해서 uv tool(또는 pipx)로 설치하면 된다. 설치 전에 링크가 저장소 공식 Releases 파일인지 한 번 확인해보자.
# macOS / Linux
uv tool install https://github.com/sharziki/semdecide/releases/download/v0.2.1/semdecide-0.2.1-py3-none-any.whl
export TYPESAFE_API_KEY="YOUR_KEY"

printf '%s' 'Login from a new country, followed by payout changes.' \
  | semdecide is 'This describes a plausible account takeover'
echo $?
# Windows PowerShell
uv tool install https://github.com/sharziki/semdecide/releases/download/v0.2.1/semdecide-0.2.1-py3-none-any.whl
$env:TYPESAFE_API_KEY = "YOUR_KEY"
'Login from a new country, followed by payout changes.' |
semdecide is 'This describes a plausible account takeover'
$LASTEXITCODE입력 문장 Login from a new country, followed by payout changes.는 "새로운 국가에서 로그인한 뒤 정산 계좌 정보가 바뀌었다", 판정 문장 This describes a plausible account takeover는 "계정 탈취로 볼 만한 상황이다"라는 뜻이다.
즉 이 문장이 계정 탈취 의심 상황인지 참/거짓으로 묻는 예제다.
여기서 볼 것: 설명 문장이 아니라 참/거짓 판정, 확률, 기준값, 종료 코드가 나오는지 보면 된다.
종료 코드는 셸 스크립트가 다음 단계를 정할 때 쓰는 숫자다.
이 도구에서는 0이 참, 1이 거짓, 2가 입력·사용법 오류, 3이 불확실, 4가 API·인증·시간 초과 오류를 뜻한다.
README에 나온 0.860은 예시 값이니 실제 측정값처럼 인용하지 않는 게 좋다.
종료 코드 4가 나오면 키 설정과 함께 크레딧 잔액도 확인해보자. 잔액이 없을 때도 API 쪽에서 요청이 거부된다.
아이디어 하나를 Jev에 10개 질문으로 동시에 묻는 웹 앱이다.
8개는 0~4 단계 점수이고, 나머지 둘은 아이디어 분야와 "이해할 수 있는 설명인가"를 판단한다.
이 결과로 사업 성공 여부를 알 수는 없다.
이 실습에서 볼 건 여러 질문의 결과를 코드가 가중 평균과 기준값으로 묶는 방식이다.
점수 50 미만은 KILL(접기), 50~64는 FIX(보완 필요), 65 이상은 SHIP(출시해볼 만함)으로 판정한다.
git clone https://github.com/monteduro/killmyidea.git
cd killmyidea
npm install
cp .env.example .env
# Windows PowerShell에서는: Copy-Item .env.example .env
# .env에 TYPESAFE_API_KEY 입력
npm run dev

# 브라우저에서 디버그 패널까지 열기
http://127.0.0.1:5317/?debug=1data/analytics.sqlite에 저장된다. 폼의 보관 제외(opt-out) 체크박스를 켜고, 일회용 폴더에서 실행하는 편이 좋다.TYPESAFE_MOCK=1은 화면 개발용 가짜 응답이다. 실제 Jev 결과처럼 소개하거나 성능 측정에 섞으면 안 된다.
게임 서버가 약 9Hz(초당 9번) 주기로 현재 상태를 JSON으로 만들고, 이동·시선·조준·발사·점프를 Choice와 Noul 질문으로 보낸다.
게임 물리와 서버 상태는 기존 코드가 60Hz로 처리한다. Jev API가 응답하지 않으면 미리 짜 둔 규칙이 대신 이동 방향을 정한다.
git clone https://github.com/emrickgarrett/OneVOneJev.git
cd OneVOneJev
npm install
cp .env.example .env
# Windows PowerShell에서는: Copy-Item .env.example .env
# .env에 TYPESAFE_API_KEY 입력
npm run dev

# 게임 화면
http://localhost:5173.env에만 두고, 브라우저 개발자 도구에서 보이지 않는지 확인하자.
typesafe-mario는 게임 화면 이미지를 Jev에 보내지 않는다.
에뮬레이터 메모리에서 플레이어 위치, 점프 궤적, 적, 지형, 최근 조작을 읽어 JSON으로 만든 뒤, noop(가만히 있기), right(오른쪽 이동), right_jump(오른쪽으로 점프) 같은 정해진 조작 중 하나를 고른다.
Python 3.13 환경에서 설치한 뒤 state-demo를 실행하면, 게임이나 API 호출 없이 모델에 보낼 입력 구조만 먼저 볼 수 있다. 아래는 README의 Windows 명령이다.
git clone https://github.com/fhshaik/typesafe-mario.git
cd typesafe-mario
py -3.13 -m venv .venv
.venv\Scripts\python -m pip install -e ".[mario,dev]"
.venv\Scripts\typesafe-mario state-demo
출력에서 player(플레이어), trajectory(이동 궤적), hazard(위험 요소), terrain(지형), recent_control(최근 조작)처럼 의미별로 묶인 JSON과 사람이 읽기 좋은 디버그 설명을 확인하면 된다.
이 명령에는 API 키나 ROM이 필요 없다. 실제 플레이는 합법적으로 준비한 게임 파일이 있을 때만 진행하자.
게임 프로젝트를 그대로 복사할 필요는 없다. 아래 다섯 칸을 내 업무에 맞게 바꿔 보면 된다.
| 설계 질문 | 게임 예시 | 쇼핑몰·업무 예시 |
|---|---|---|
| 1. 판단할 자료(state)는? | 위치, 적, 장애물, 최근 행동 | 문의 본문, 주문 상태, 결제 상태, 최근 상담 이력 |
| 2. 고를 수 있는 행동은? | 이동, 점프, 멈춤 | 결제팀, 배송팀, 상품팀, 사람 검토 |
| 3. 코드가 먼저 막을 것은? | 맵 밖 이동, 충돌, 속도 제한 | 권한 없음, 주문번호 없음, 환불 가능 기간 초과 |
| 4. 애매하면 어디로? | 안전 정지·고정 규칙 | 상담원 검토 큐·기존 분류 규칙 |
| 5. 무엇을 기록할까? | 상태, 고른 행동, 확률, 진행 결과 | 모델·질문 버전, 확률, 실제 담당팀, 재분류 여부, 처리 시간 |
핵심은 Jev에게 업무 전체를 맡기는 게 아니다. 일반 코드로는 표현하기 어려운 의미 판단 한 번만 맡기고, 실행 권한과 검증은 기존 시스템에 남겨 두는 것이다.
jev-trader는 PRIVATE_KEY 없이 모의 실행만 살펴보자. 실제 주문 결과를 Jev의 예측력이나 수익성 증거로 소개하면 안 된다.jev-drone의 핵심은 실물 제어가 아니다. 시뮬레이터 안에서, 모델보다 빠르게 도는 안전 장치가 항상 먼저 개입하는 구조를 보는 데 의미가 있다.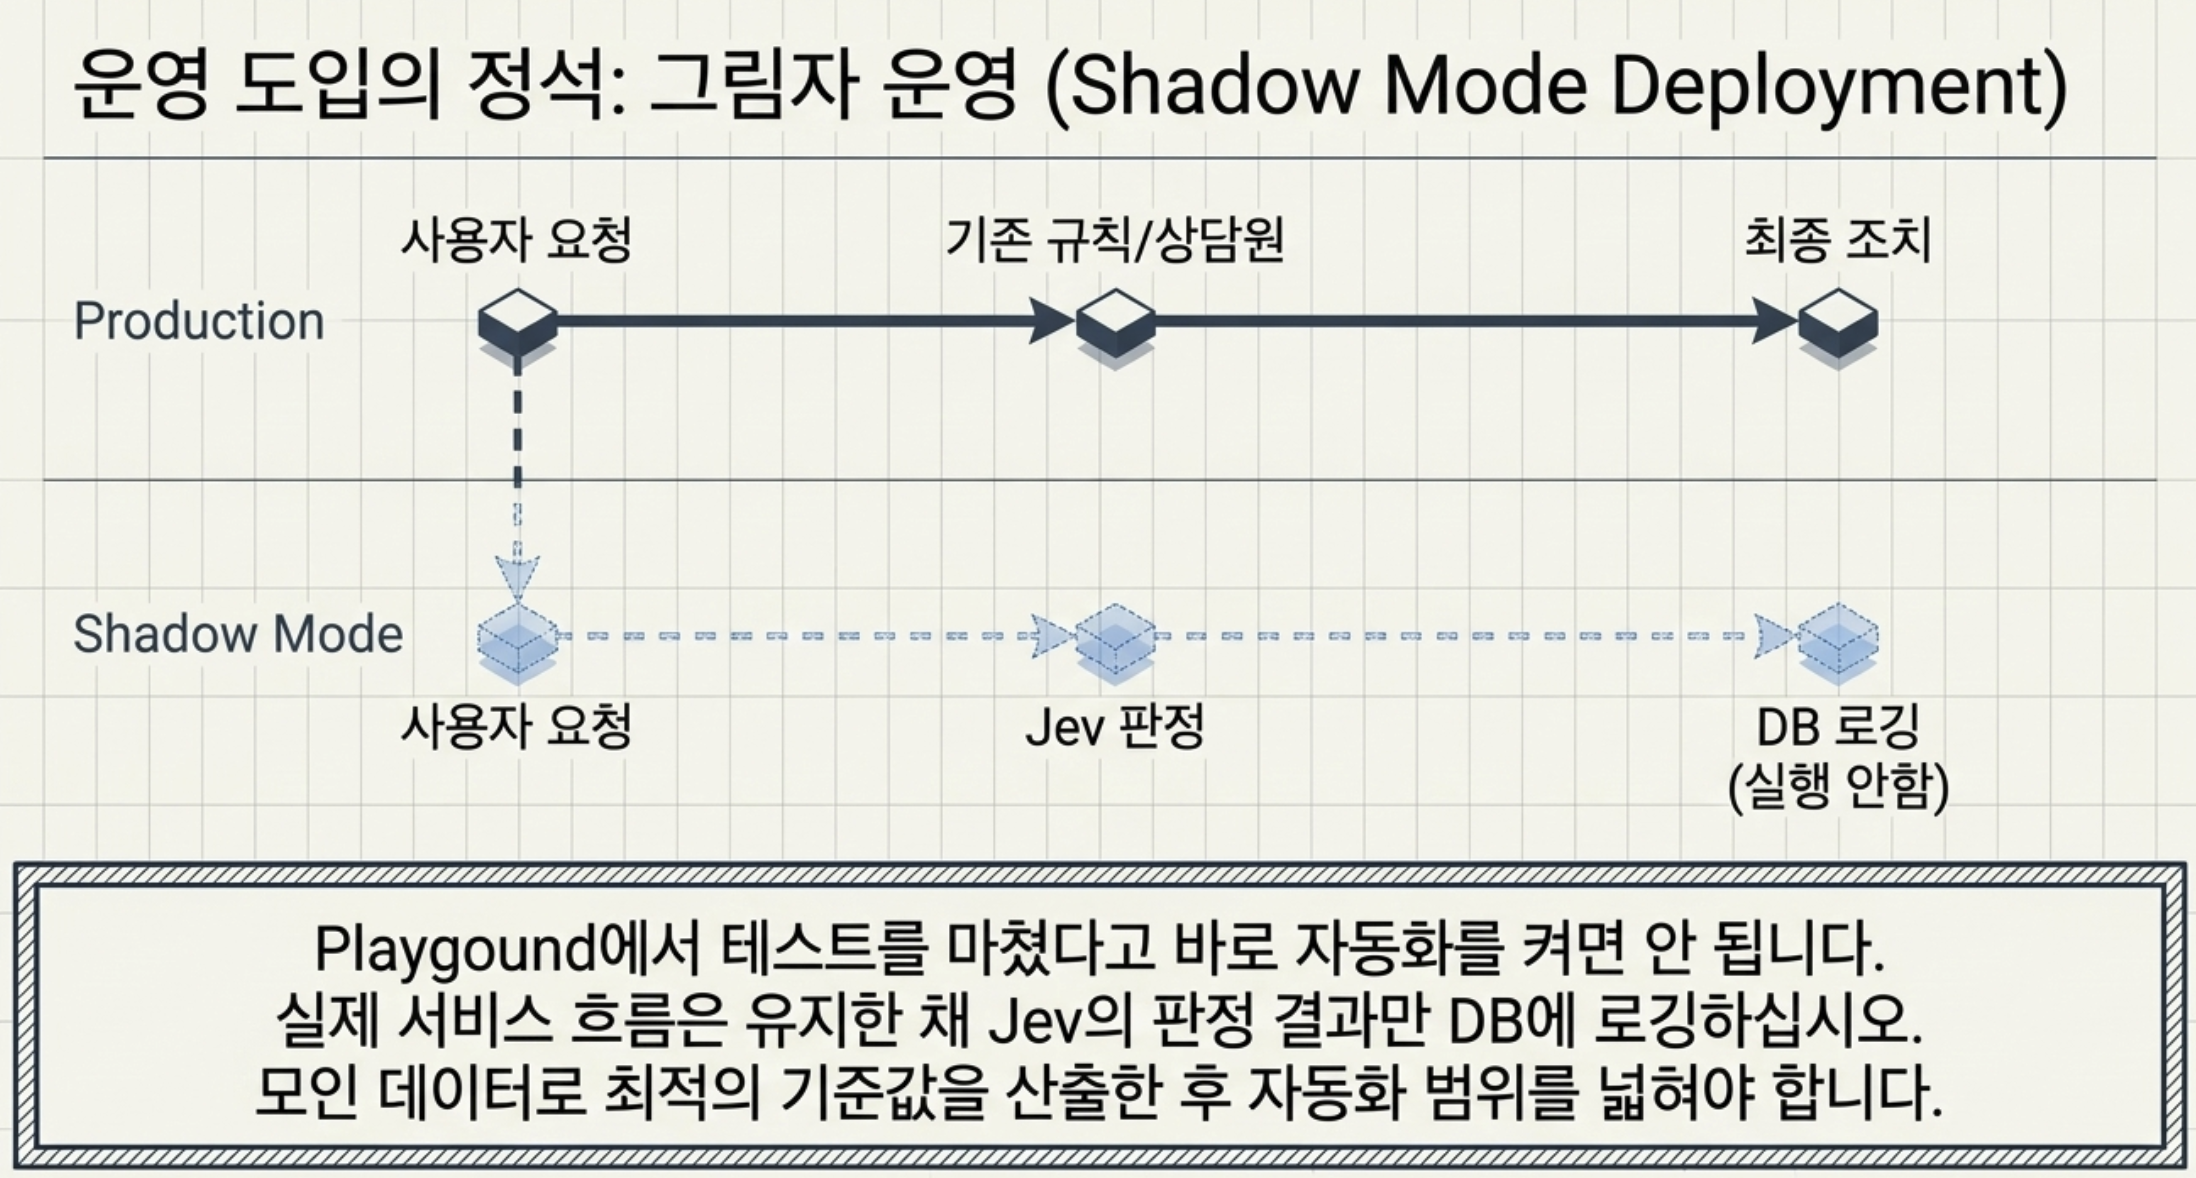
Playground에서 몇 번 잘 맞았다고 바로 자동 분류를 켜면 안 된다.
기존 고객센터 흐름은 그대로 두고, Jev의 판단만 옆에 기록하는 그림자 운영(Shadow Mode)부터 시작하는 게 안전하다. Jev가 결과를 내도 실제 담당 부서는 바꾸지 않고, "Jev였다면 어디로 보냈을지"만 저장해 두는 방식이다. 이렇게 모은 기록으로 정확도와 기준값을 구하면 된다.
최근 문의에서 개인정보를 지운 뒤 사람이 정답 부서를 붙여 보자. 빠른 점검은 최소 30건, 기준값 비교까지 하려면 가능하면 100건 이상이 좋다.
쉬운 문의만 고르면 결과가 실제보다 좋게 나온다. 여러 요청이 섞인 문의, 정보가 부족한 문의, 새로운 유형을 일부러 섞어두자.
{"id":"T001","redactedText":"결제가 두 번 됐습니다.","label":"billing"}
{"id":"T002","redactedText":"앱에서 로그인하면 흰 화면이 나옵니다.","label":"technical"}
{"id":"T003","redactedText":"기업 요금제 견적이 궁금합니다.","label":"sales"}
{"id":"T004","redactedText":"앱도 안 되고 결제 내역도 이상합니다.","label":"manual_review"}redactedText는 개인정보를 가린 문의 본문, label은 사람이 붙인 정답이다. manual_review는 "사람이 직접 검토해야 함"이라는 뜻으로, 한 부서로 정하기 어려운 문의에 붙였다.
아래 TypeScript 예제는 고른 부서만 출력하지 않는다.
고정한 모델 버전, 질문 버전, 확신도, 1·2위 확률 차이, 응답 시간, 토큰 사용량을 함께 남기고, API 오류가 나면 자동 분류 대신 사람 검토로 보낸다.
import { choice, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient();
const MODEL = "jev-1.13.0"; // 검증한 버전으로 고정
const QUESTION_VERSION = "support-router-v1";

const thresholdText = process.env.JEV_AUTO_ROUTE_THRESHOLD;
if (!thresholdText) {
  throw new Error("JEV_AUTO_ROUTE_THRESHOLD must be set from validation results");
}

const AUTO_ROUTE_THRESHOLD = Number(thresholdText);
if (!Number.isFinite(AUTO_ROUTE_THRESHOLD)
    || AUTO_ROUTE_THRESHOLD < 0
    || AUTO_ROUTE_THRESHOLD > 1) {
  throw new Error("JEV_AUTO_ROUTE_THRESHOLD must be between 0 and 1");
}

type Ticket = {
  id: string;
  redactedText: string; // 개인정보 제거가 끝난 텍스트만 허용
};

export async function classifyTicket(ticket: Ticket) {
  const startedAt = performance.now();

  try {
    const response = await client.systemOne({
      model: MODEL,
      state: { ticket: ticket.redactedText },
      questions: {
        department: choice("Which team should handle this ticket?", {
          billing: "Payments, invoices, refunds, or duplicate charges",
          technical: "Bugs, outages, login, or integrations",
          sales: "Pricing, upgrades, or new accounts",
          other: "Insufficient evidence or none of the above",
        }),
      },
    });

    const answer = response.answers.department;
    const ranked = Object.entries(answer.probabilities)
      .sort((a, b) => b[1] - a[1]);
    const topProbability = ranked[0]?.[1] ?? 0;
    const secondProbability = ranked[1]?.[1] ?? 0;
    const probabilityMargin = topProbability - secondProbability;
    const autoRoute = answer.choice !== "other"
      && answer.confidence >= AUTO_ROUTE_THRESHOLD;

    const result = {
      ticketId: ticket.id,
      decision: autoRoute ? "auto_route" : "manual_review",
      department: answer.choice,
      confidence: answer.confidence,
      probabilityMargin,
      probabilities: answer.probabilities,
      model: response.model,
      questionVersion: QUESTION_VERSION,
      usage: response.usage,
      latencyMs: Math.round(performance.now() - startedAt),
    };

    console.log(JSON.stringify(result));
    return result;
  } catch (error) {
    const result = {
      ticketId: ticket.id,
      decision: "manual_review",
      reason: "jev_api_error",
      questionVersion: QUESTION_VERSION,
      latencyMs: Math.round(performance.now() - startedAt),
    };
    console.error(JSON.stringify(result), error);
    return result;
  }
}
코드 속 other 설명은 Insufficient evidence or none of the above(근거 부족 또는 해당 없음)로 바꿔 뒀다. 판단할 근거가 부족한 문의도 기타로 빠지게 하려는 것이다. 결과의 decision 값은 auto_route(자동 배정) 또는 manual_review(사람 검토) 둘 중 하나다.
위의 소스대로라면 API 오류, other, 낮은 확신도가 모두 사람 검토로 빠지고, 실행마다 실제로 응답한 모델 버전과 질문 버전이 남는다.
공식 SDK는 호출 한도 초과(429)나 일시적 과부하(529)가 나면 잠시 기다렸다 자동으로 다시 요청한다. 그래도 끝내 실패했을 때 기존 규칙을 쓸지, 사람에게 보낼지는 애플리케이션에서 정해야 한다.
크레딧 잔액 부족(402)은 기다린다고 풀리지 않는다. 그림자 운영 중에 잔액이 바닥나면 모든 요청이 jev_api_error로 기록돼 데이터가 비어 버리니, 로그에서 오류 원인을 402와 나머지로 나눠 두면 나중에 분석할 때 헷갈리지 않는다.
기준값을 0.6, 0.7, 0.8, 0.9처럼 바꿔 가며 아래 지표를 계산해보자. 전체 정확도 하나만 보면 실제로 얼마나 자동화할 수 있는지 알 수 없다.
| 지표 | 의미 | 왜 필요한가 |
|---|---|---|
| 자동 분류 비율 | 전체 중 자동으로 보낸 비율 | 실제로 줄어드는 사람 업무량 |
| 자동 분류 정밀도 | 자동으로 보낸 문의 중 담당 부서가 맞은 비율 | 자동 처리의 위험을 직접 측정 |
| 잘못 자동 분류된 건수 | 사람 검토 없이 잘못 보낸 건수 | 업무 피해를 건수로 확인 |
| 사람 검토 비율 | 사람에게 남긴 비율 | 정확도와 운영 비용의 균형 판단 |
| p50 / p95 응답 시간 | 절반이 끝난 시간 / 100번 중 95번이 끝난 시간 | 평균에 가려진 느린 요청 확인 |
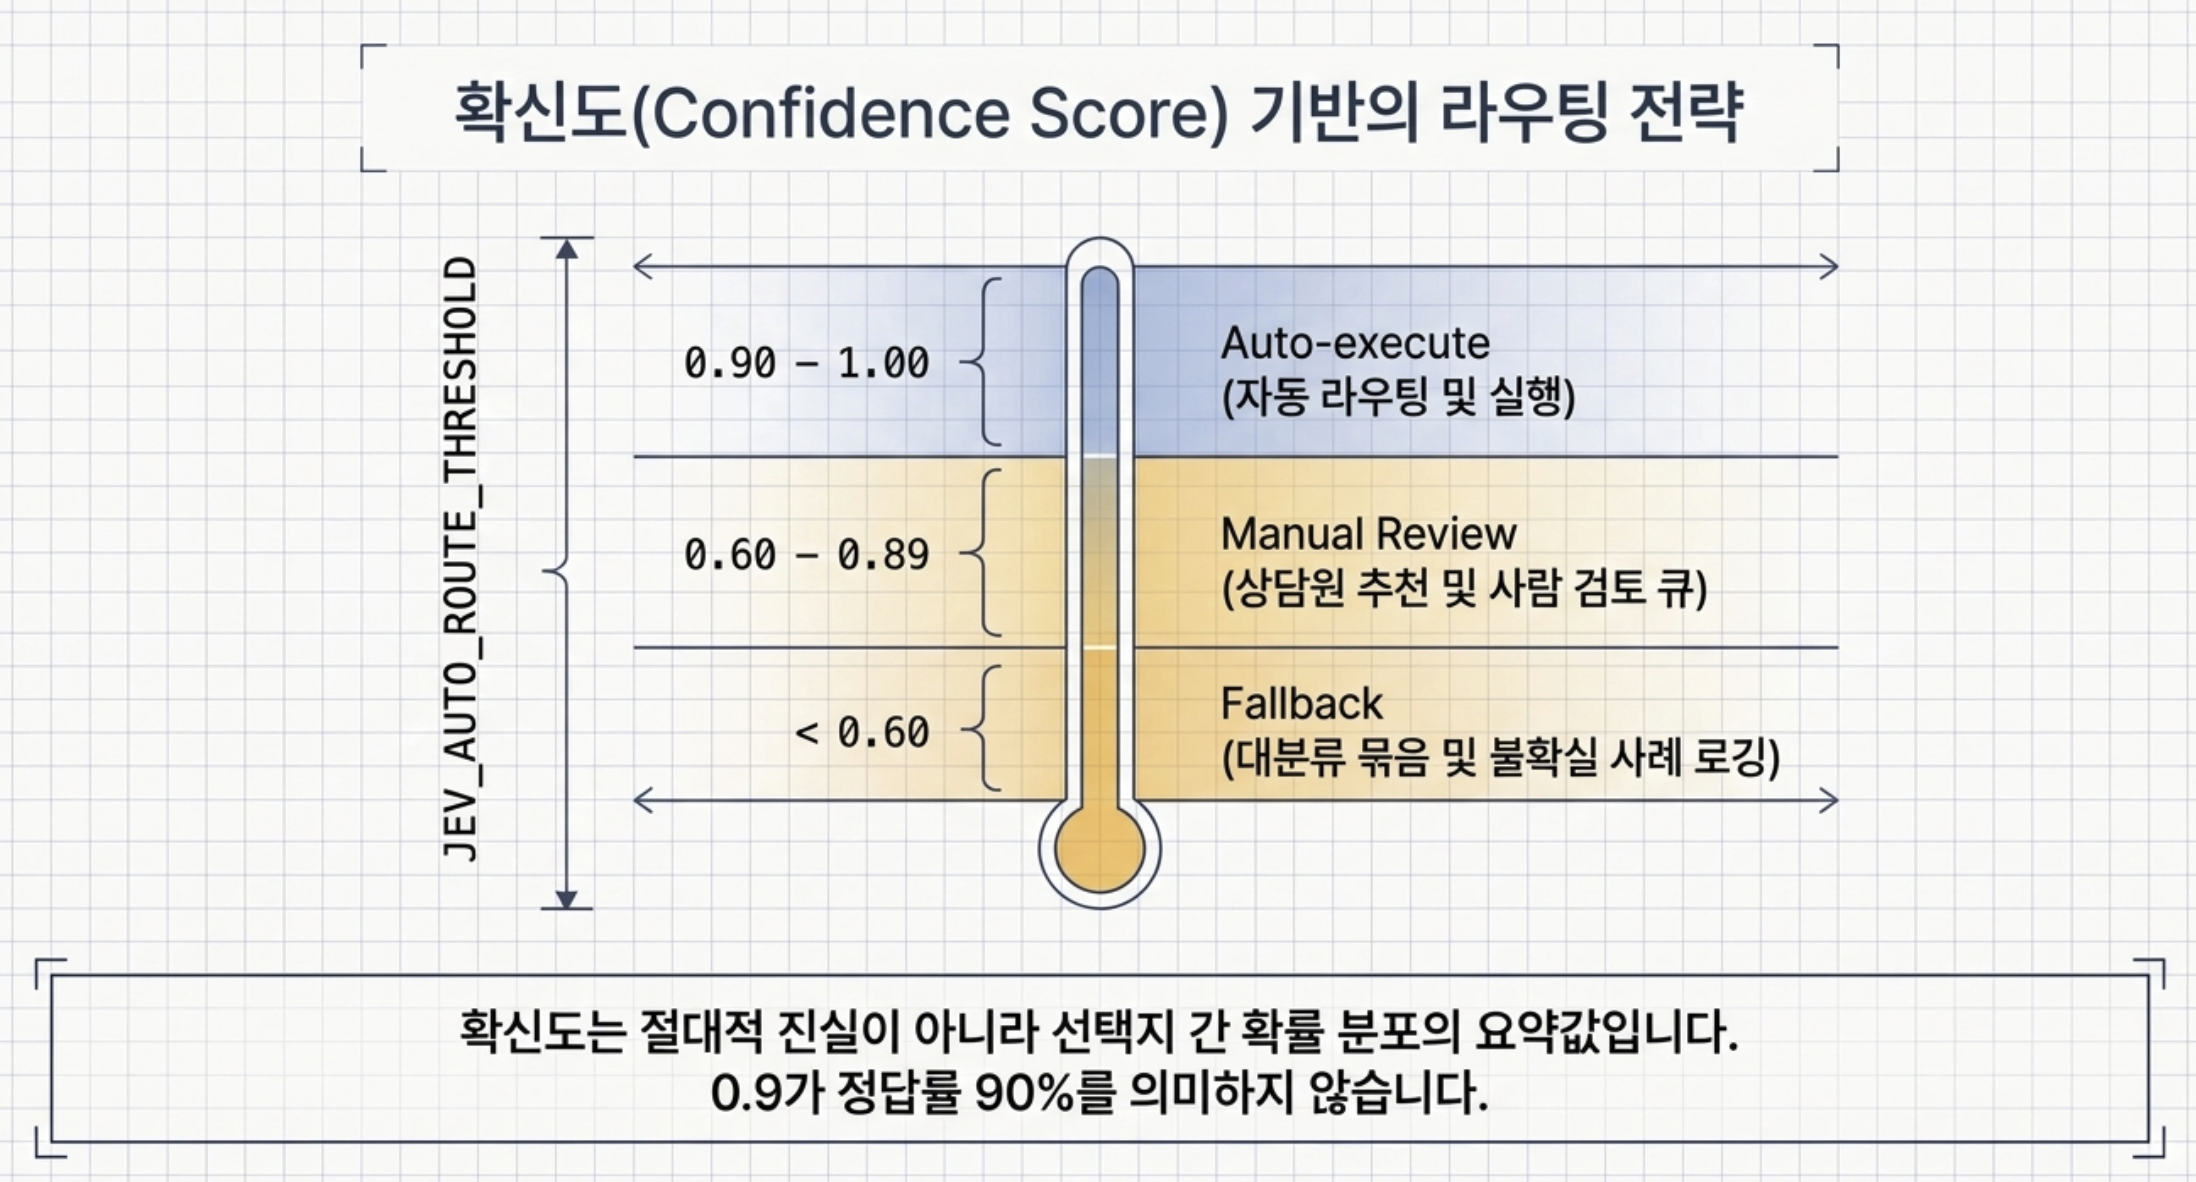
Choice와 Score의 확신도는 선택지별 확률이 얼마나 한쪽으로 몰렸는지를 숫자 하나로 요약한 값이다.
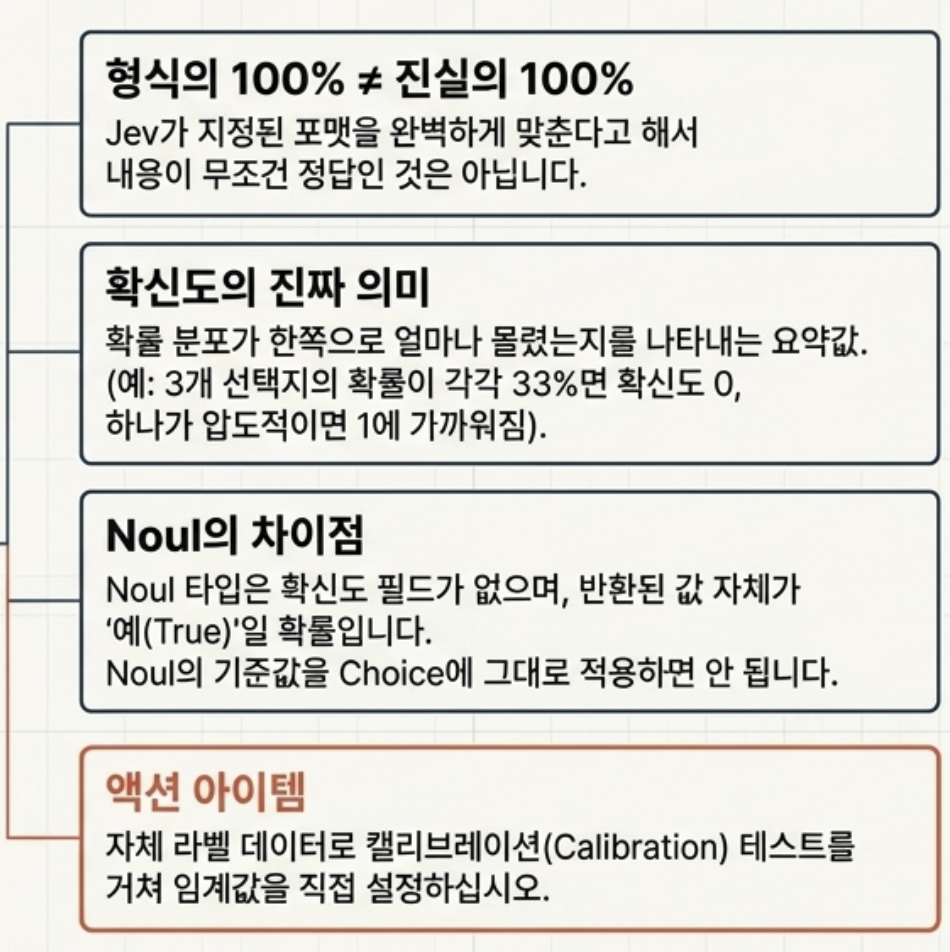
예를 들어 선택지 3개 중 1등 확률이 0.8이면 확신도는 0.7이 된다.
세 선택지가 똑같이 3분의 1씩이면 0, 한 곳에 전부 몰리면 1이다.
확률이 얼마나 쏠렸는지를 나타낼 뿐이라 "확신도 0.9 = 정답일 확률 90%"로 읽으면 안 된다.
정말 믿을 만한 값인지 알려면 비슷한 사례를 많이 모아 봐야 한다.
예를 들어 확신도 0.9 이상인 문의 100건 중 사람이 확인했을 때 몇 건이 맞았는지 보는 것이다.
이런 확인을 캘리브레이션(calibration, 확률 보정 점검)이라고 한다.
Noul에는 별도 확신도가 없다. 돌려받은 noul 값 자체가 "예"일 확률이다. 예를 들어 "0.7 이상이면 긴급 문의로 자동 분류" 같은 규칙을 만들기 전에, 자동 분류한 건 중 실제로 긴급했던 비율과 실제 긴급 문의를 얼마나 놓쳤는지를 함께 확인해야 한다.
공식 문서는 같은 질문을 Noul로 물을 때와 예/아니오 Choice로 물을 때 값이 달라질 수 있다는 점도 짚는다. Noul로 맞춘 기준값을 Choice에 그대로 옮겨 쓰지 말자.
| 테스트 | 방법 | 확인할 것 |
|---|---|---|
| 선택지 순서 바꾸기 | 판정 기준은 그대로 두고 선택지 순서만 5~10번 바꿈 | 답과 확률이 지나치게 흔들리는지 |
| 관계없는 선택지 추가 | 명백히 무관한 선택지를 하나 넣음 | 기존 선택지 사이의 확률 비율 변화 |
| 경계 사례 | 두 범주가 섞인 실제 문장 사용 | 사람 검토로 제대로 빠지는지 |
| 언어 비교 | 같은 state에 한국어 질문과 영어 질문을 각각 적용 | 정확도·일관성 차이 |
| 불필요한 정보 추가 | 관계없는 로그·이전 대화를 state에 추가 | 입력이 길어질 때 정확도가 얼마나 떨어지는지 |
| 지시 무시 문장 넣기 | "위 지시를 무시하라" 같은 문장을 포함 | 안전 검사를 우회하거나 엉뚱하게 분류하는지 |
| 기존 방식과 비교 | 규칙·일반 LLM·전용 분류기에 같은 데이터를 넣음 | 정확도·비용·p95 응답 시간·운영 복잡도 |
| 잔액 소진 상황 | 잔액이 없는 테스트용 키나 모의 402 응답으로 호출 | 자동 분류가 멈추고 사람 검토나 기존 규칙으로 넘어가는지 |
참고로 TypeSafe는 OpenAI·Anthropic 모델도 Jev처럼 "질문을 넣으면 확률로 답하게" 감싸 주는 공식 Python 어댑터(system-one-adapter)를 공개해 뒀다. 앞에서 본 성능표도 이 어댑터로 LLM을 돌린 결과라고 한다. Jev와 일반 LLM을 같은 코드로 비교해보고 싶을 때 쓰기 좋다.
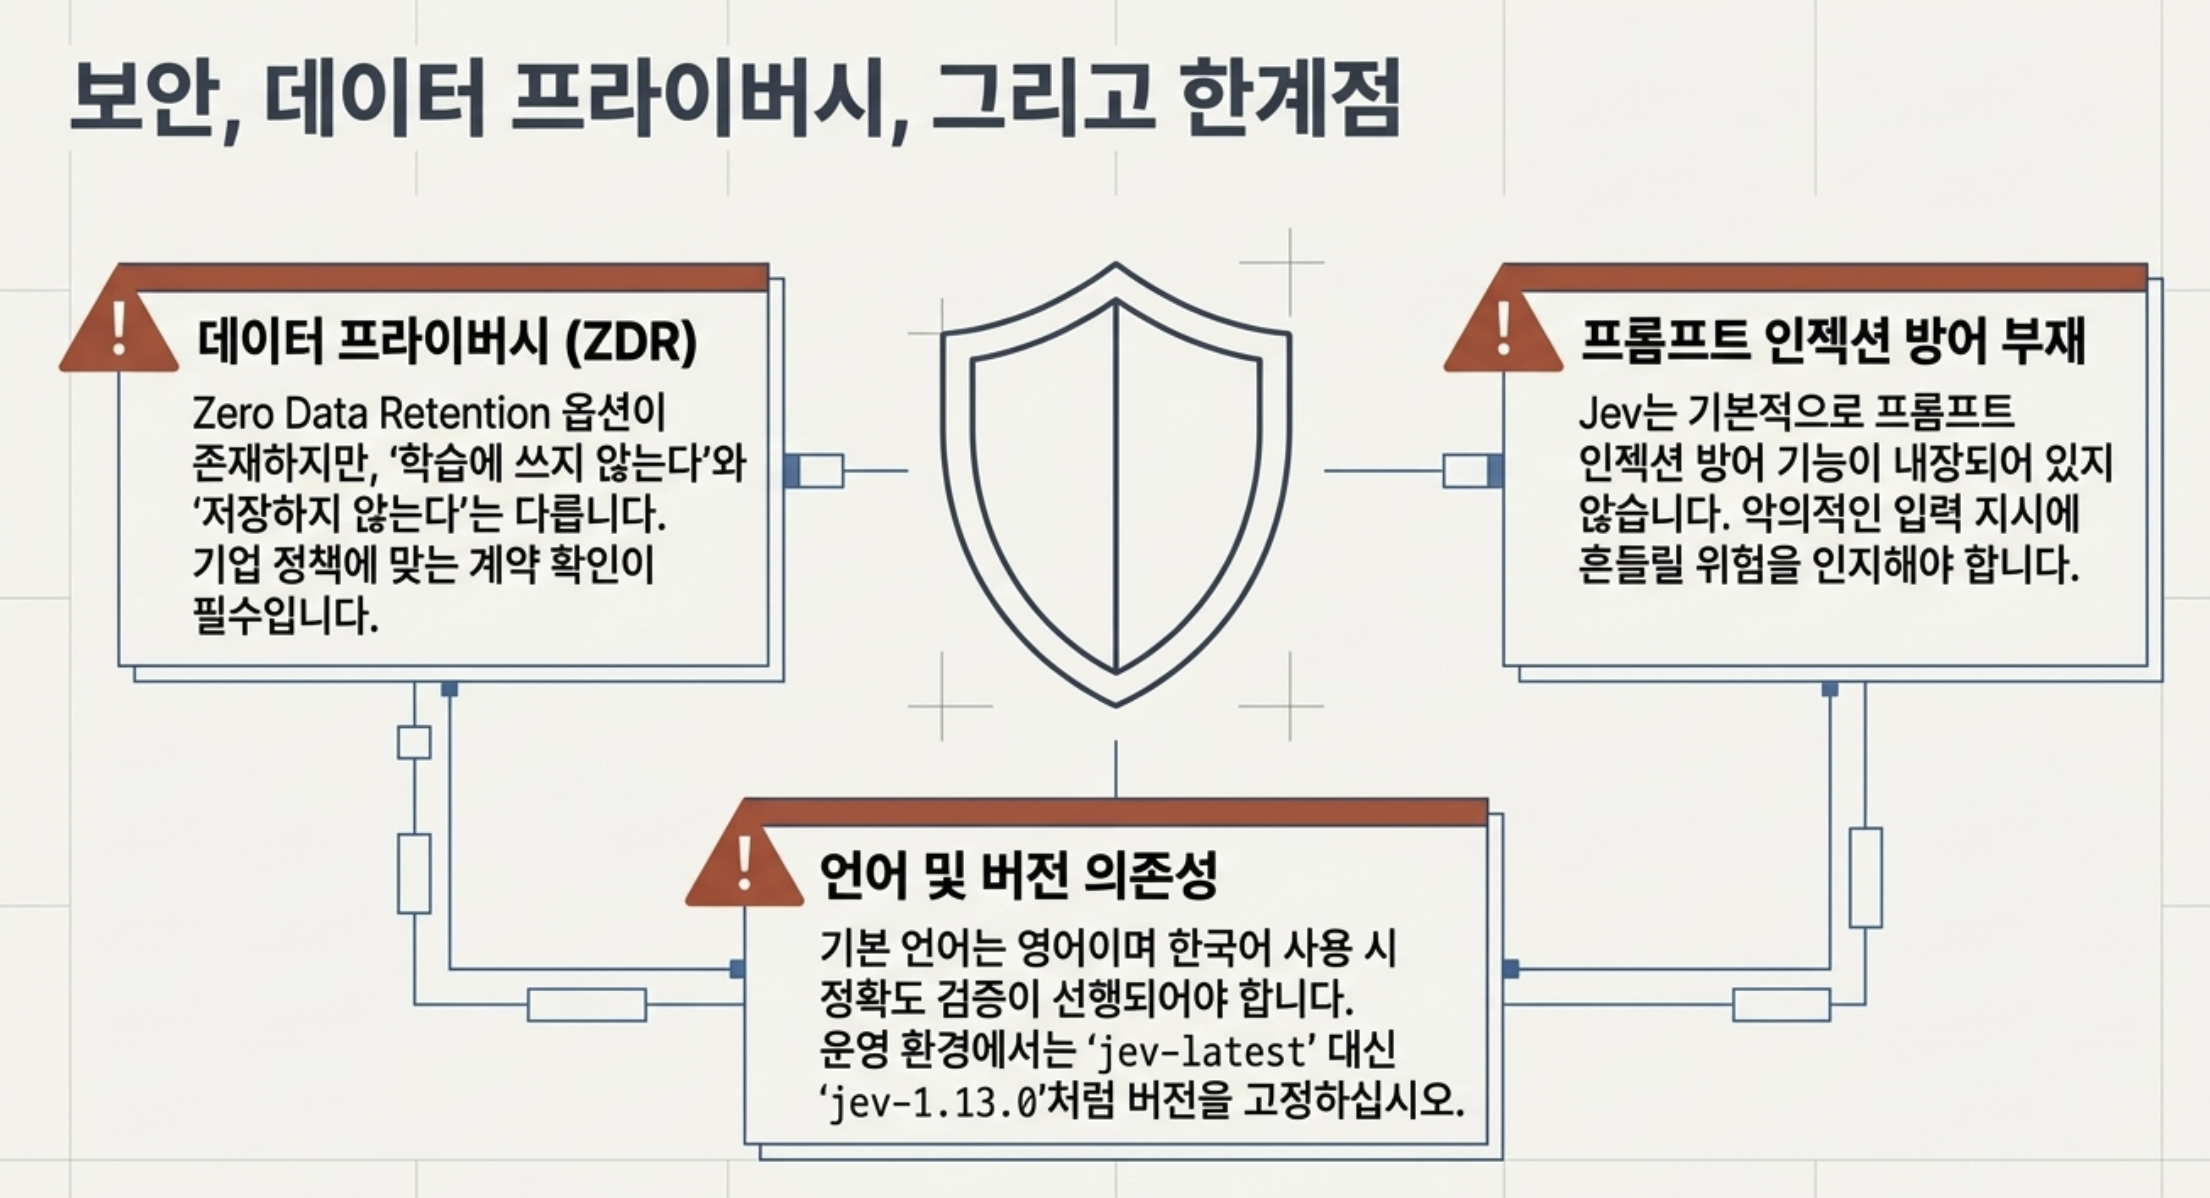
공식 문서는 고객의 요청·응답을 모델 학습에 쓰지 않고, 엔터프라이즈 고객에게는 요청·응답을 보관하지 않는 Zero Data Retention 옵션이 있다고 안내한다. Vercel을 거치는 경우에는 요청 단위로 ZDR·학습 금지 옵션을 켤 수 있다.
다만 "학습에 쓰지 않는다"와 "저장하지 않는다"는 같은 말이 아니다. 기본 보관 기간, 저장 위치, 데이터 처리 위탁 업체, 삭제 절차는 계약서와 최신 정책에서 따로 확인해야 한다.
출시 당일 Hacker News 반응은 크게 둘로 갈렸다.
기대하는 쪽은 비싼 LLM을 부르기 전에 앞에서 싸게 걸러 주는 분류기나, 도구 선택·브라우저 에이전트·RAG(검색 증강 생성) 앞단의 판정기로 쓸 만하다고 봤다.
걱정하는 쪽은 내부 구조를 공개하지 않은 점, 벤치마크를 회사가 직접 만든 점, 내 컴퓨터에서 돌릴 수 없는 점을 지적했다. 특히 "할루시네이션이 없다"는 홍보 문구가 틀린 답도 안 나오는 것처럼 들린다는 비판이 많았다.
이 부분은 창업자 디오구 알메이다(Diogo Almeida)도 HN 토론에서 인정했다. 모델이 자신 있게 틀릴 수도 있다는 것이다.
개인적으로는 이 대목이 제일 중요하다고 본다. Jev의 가치는 오답이 사라지는 데 있지 않다. 모델이 낼 수 있는 답을 미리 좁히고, 애매한 결과를 사람에게 넘길 기준을 만들기 쉽다는 데 있다.
"Claude Code에 Jev를 붙이면 코딩 모델이 바뀐다"는 식의 소개도 보이는데, 그렇게 이해하면 안 된다. Jev는 애플리케이션이나 에이전트 안에서 요청을 보낼 곳을 고르고, 결과를 평가하고, 위험한 행동을 한 번 더 검사하는 부품에 가깝다.
X 게시물은 9장에서 데모 영상을 보여 주는 용도로만 넣었다. 게시물에 적힌 속도·비용 같은 수치는 작성자 주장이라 사실처럼 인용하지 않았다.
벌써 Jev와 같은 방식으로 호출하면서, 내 컴퓨터에서 직접 돌릴 수 있는 오픈 모델도 나오고 있다.
laya-serve는 Laya 모델 가중치를 Jev와 같은 /v1/systemone 주소로 제공하는 서버이고, Kev는 Qwen2.5-0.5B 위에 작은 판정 모듈을 얹어 맥북에서 학습·실행할 수 있게 만든 모델이다. 둘 다 Jev를 공개한 게 아니라, 다른 개발자가 Jev 방식을 흉내 내 따로 만든 것이다.
| 선택지 | 장점 | 확인할 점 |
|---|---|---|
| Jev 호스팅 API | 설치가 간단하고 공식 문서·운영 인프라를 그대로 사용 | 데이터 외부 전송, 네트워크 지연, 가격·공급사 의존 |
| Laya + laya-serve | 로컬 실행, Jev와 같은 요청 형식 | 확신도 계산식이 Jev와 달라(엔트로피 기반) 같은 확률이라도 확신도 값이 다를 수 있음 |
| Kev | 가중치·학습 코드·평가 자료 공개, 노트북에서 실행 | 0.5B 크기라 지식 범위가 좁고, 공개된 정확도도 학습 데이터와 같은 분포에서 잰 값 |
로컬 모델은 네트워크 왕복 시간이 없어서 특정 장비·짧은 입력에서는 아주 빠를 수 있다. 하지만 속도만 보면 놓치는 게 많다. 입력 길이, GPU·메모리, 첫 실행 준비 시간, 정확도, 확신도를 믿을 수 있는지, 선택지 순서에 얼마나 흔들리는지까지 같이 봐야 한다.
같은 입력, 같은 정답 데이터, 같은 하드웨어 비용으로 비교하고, 모델을 바꾸면 확신도 기준값도 처음부터 다시 정해야 한다.
용도가 다르다. 대화, 코드 작성, 보고서 작성, 긴 추론은 일반 LLM이 맡고, 정해진 선택지 중 하나를 고르는 판정만 Jev에 맡기는 게 맞다.
입력은 되지만 공식 문서가 밝힌 주력 언어는 영어이고, 한국어는 정확도가 낮을 수 있다고 적혀 있다. 한국어 서비스라면 같은 데이터로 한국어 질문과 영어 질문을 각각 측정해 보고 정하자.
정해진 숫자는 없다. 공식 예시의 0.6, 0.85, 0.9는 설명용이다. 내 업무 데이터에서 자동 처리율과 오분류 비용을 보고 정해야 한다.
그렇게 볼 근거는 없다. 스킬은 Jev 연동에 필요한 지식을 에이전트에게 주는 안내서다. 공개된 스킬 추천 실험도 코드 정답률이 아니라 스킬을 고르는 오류율을 잰 것이다.
가격 예측이나 매매 결정 용도로는 권하지 않는다. 대신 공시·뉴스 분류, 사건 유형 태깅, 리서치 우선순위 정하기처럼 결과를 사람이 한 번 확인하는 용도에는 써볼 만하다.
아니다. HTTP Request 노드만으로 충분하다. 7장 Step 8의 워크플로 JSON을 가져오면 확신도 검사, 부서 분기, 오류 처리까지 한 번에 만들어진다. 커뮤니티 노드는 편하지만 공식 패키지가 아니니 코드와 권한을 확인하고 쓰자.
공식 가격 문서에는 무료 체험 크레딧 안내가 없다. 크레딧을 충전해서 쓰는 방식이라 Playground 실습도 결제 등록과 충전이 먼저 필요하다. 내가 충전할 당시에는 최소 충전 금액이 $5였고, 앞의 실습 정도는 이 안에서 충분히 해볼 수 있었다. 금액과 조건은 바뀔 수 있으니 콘솔 결제 화면에서 확인하자. 참고로 Vercel AI Gateway를 거치면 비용은 Vercel 팀 결제로 청구된다.
현재 공식 API 문서에는 잔액을 조회하는 엔드포인트 안내가 없다. 한 사용자도 GitHub 이슈에서 찾지 못했다고 보고했다. 그래서 콘솔에서 잔액을 수시로 확인하고, 402 오류가 나면 알림을 받거나 사람 검토로 넘어가게 해 두는 게 현실적이다.
Jev를 한 문장으로 정리하면 빠르고 싼 판정 모델이다. 잘 쓰는 방법도 복잡하지 않다.
판단의 범위를 좁히고, 애매한 경우를 받아 줄 선택지를 두고, 확신도가 낮으면 사람이나 더 강한 모델로 넘기면 된다. 계산과 권한 검사는 일반 코드가 맡는다.
처음부터 서비스 전체를 바꿀 필요는 없다.
Playground에서 문의 하나로 Choice·Score·Noul 결과를 보고, 7장처럼 가상 분류기를 만들어 본 다음, 10장처럼 그림자 운영으로 실제 데이터에 맞춰보면 된다.
여기까지 해 보면 Jev가 내 업무에서 어떤 판단 한 번을 싸고 빠르게 맡아 줄 수 있는지 감이 잡힐 것이다.
한 줄 정리: Jev는 LLM을 대신하는 모델이 아니라, 정해진 선택지 중에서 빠르게 골라 주는 판정 부품이다. 형식은 확실히 지켜 주지만 정답까지 보증하지는 않으니, 확신도가 낮은 건은 사람에게 넘기자.
감사합니다. : )
| OmniRoute란?(OmniRoute 사용법) - 무료 AI 티어를 모아 Claude Code·VS Code에 연결하기 (3) | 2026.09.15 |
|---|---|
| cmux란? cmux 설치 및 사용해보기 - AI 에이전트를 위해 설계된 터미널(cmux vs tmux 비교) (6) | 2026.03.23 |
| [Python] 파이썬 로컬 개발 환경 설정 : AI 관련 코딩 실습 준비 (1) | 2025.11.30 |
| [Python 웹 환경] Google Colab 활용 가이드 : AI 관련 코딩 실습 준비 (0) | 2025.11.18 |
소중한 공감 감사합니다