새소식
300x250
안녕하세요! 갓대희 입니다.
이번 포스팅은 [ Claude Sonnet 5.5 출시 ] 입니다. : )
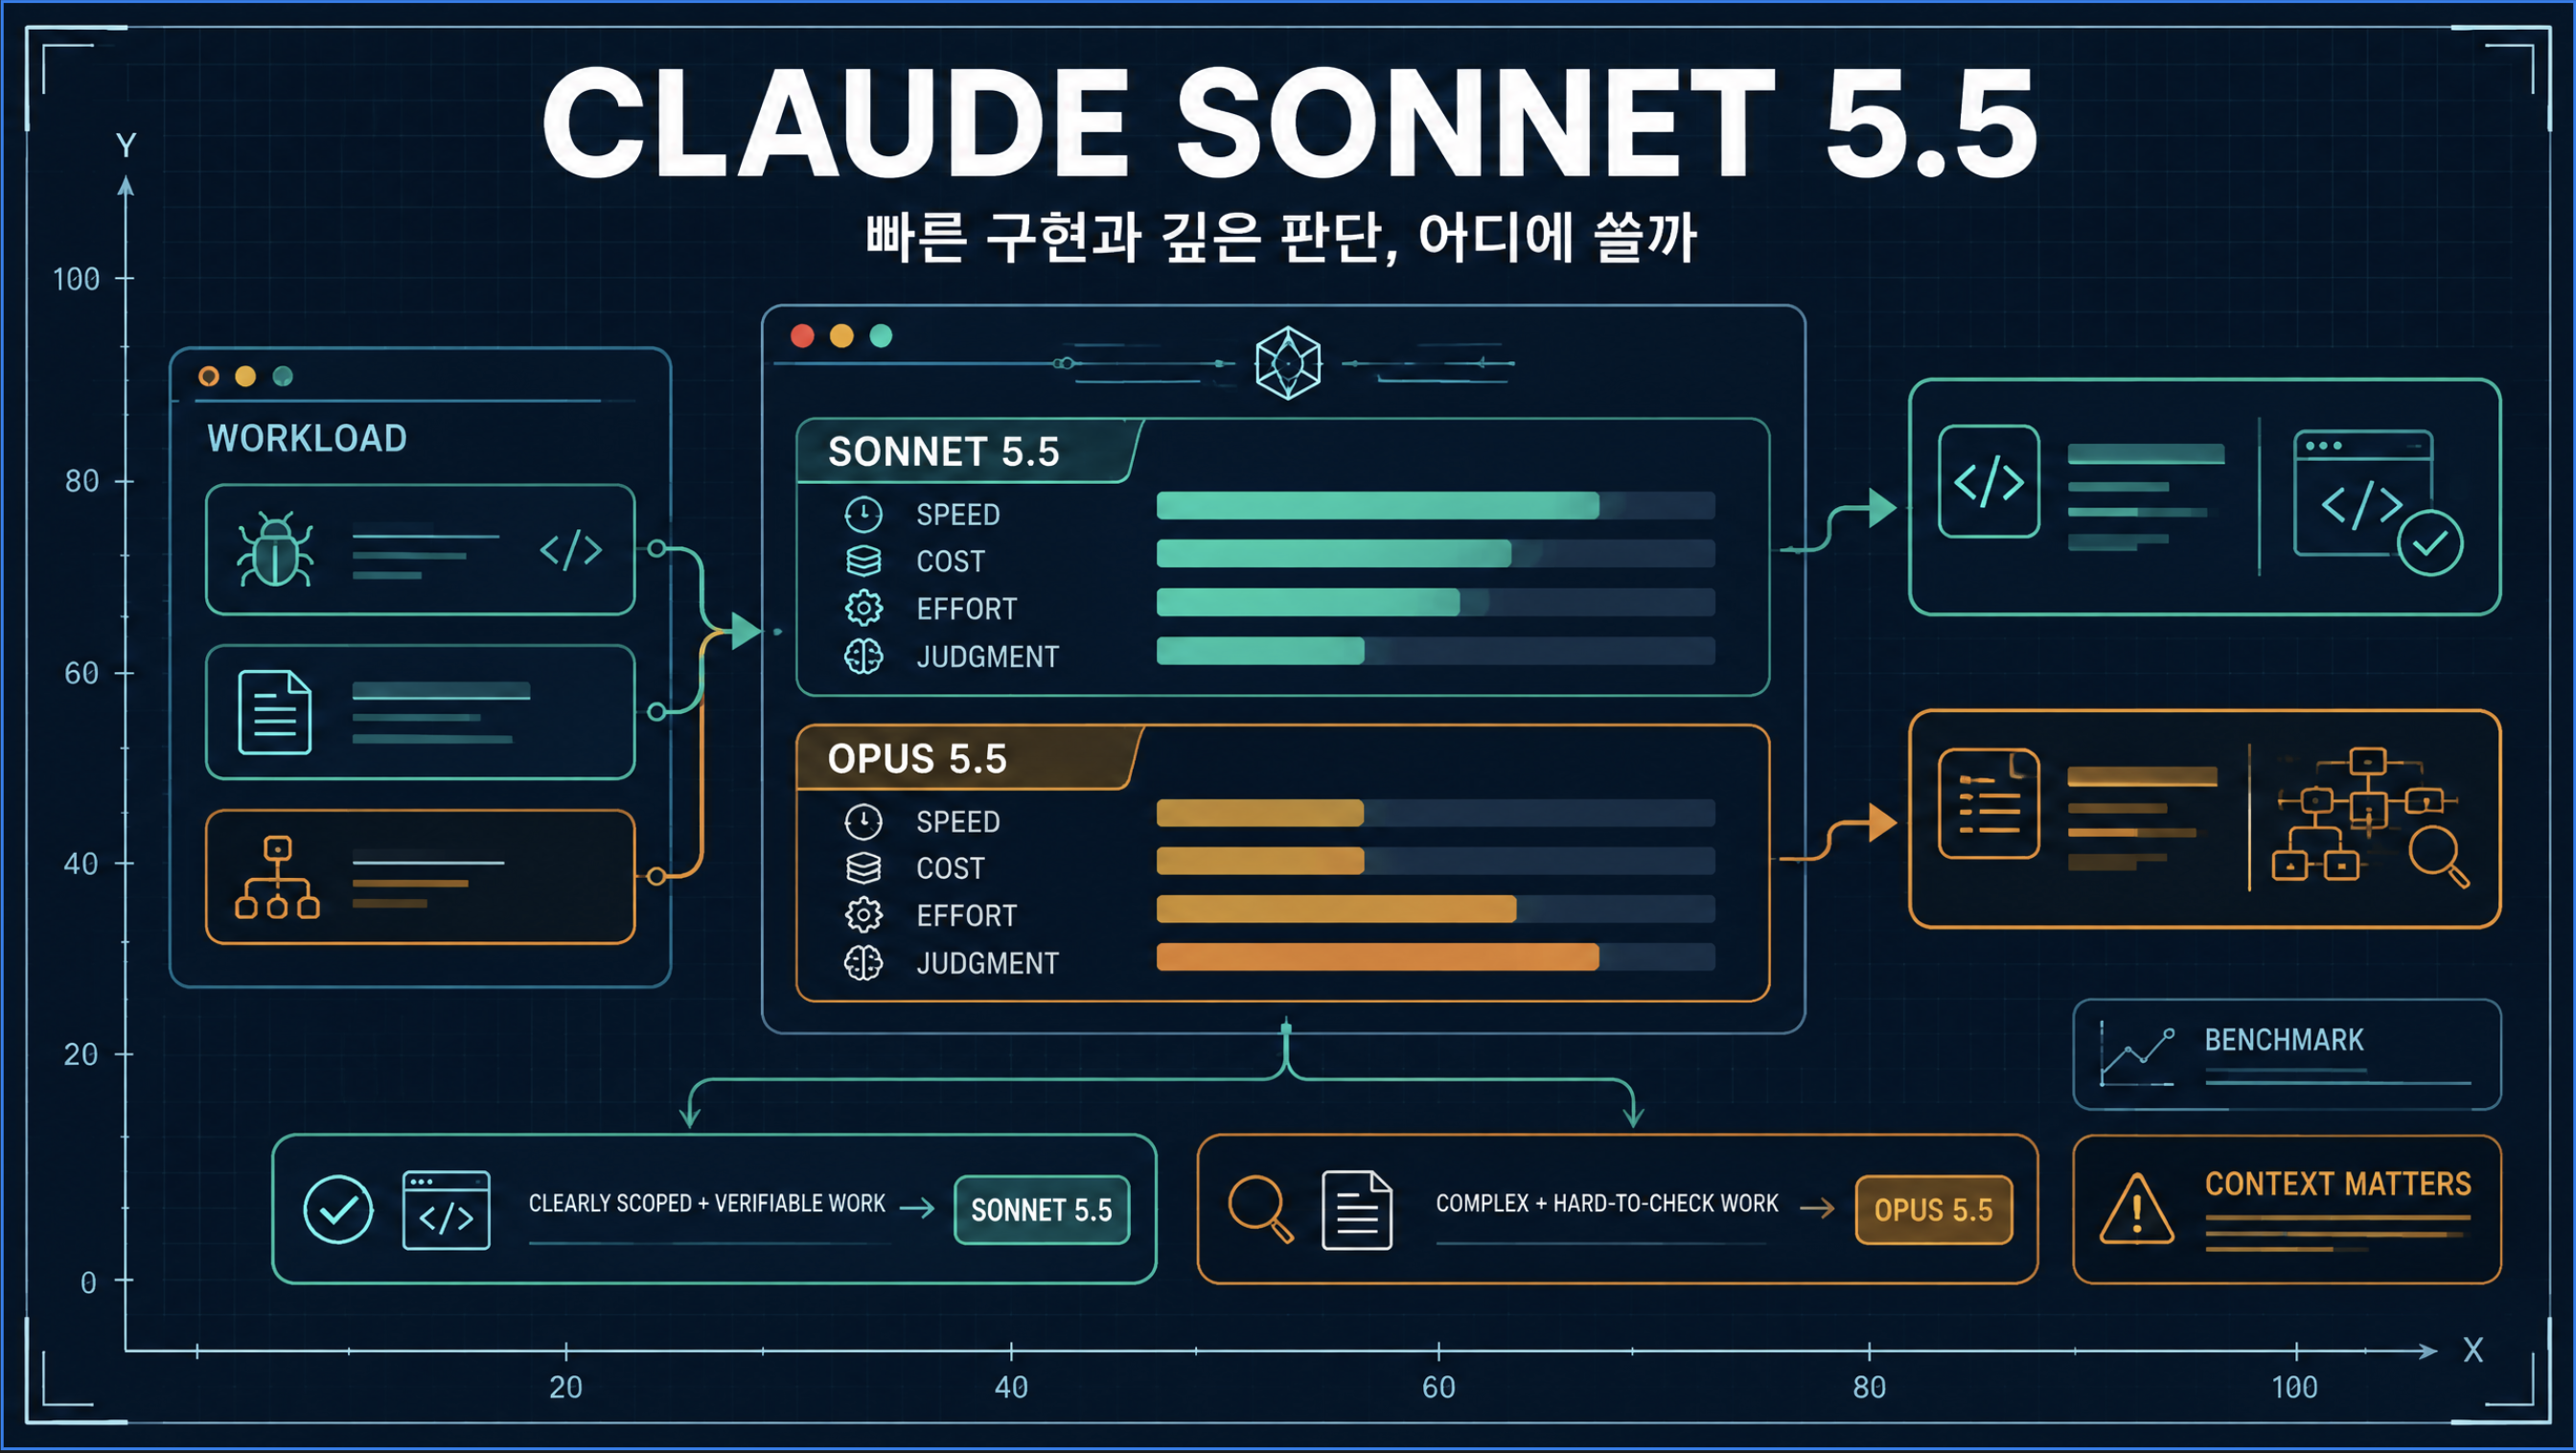
Anthropic이 2026년 9월 28일 Claude Sonnet 5.5를 공개했다.
발표 직후부터 "클로드를 다시 구독해볼까?"라는 이야기가 여기저기서 보인다.
이번 글에서는 공식 자료와 출시 직후 올라온 개발자 반응을 나란히 놓고, 어디서 쓸 수 있는지, 어떤 작업에 맞는지, 재구독은 어떻게 판단하면 좋을지까지 정리해봤다.
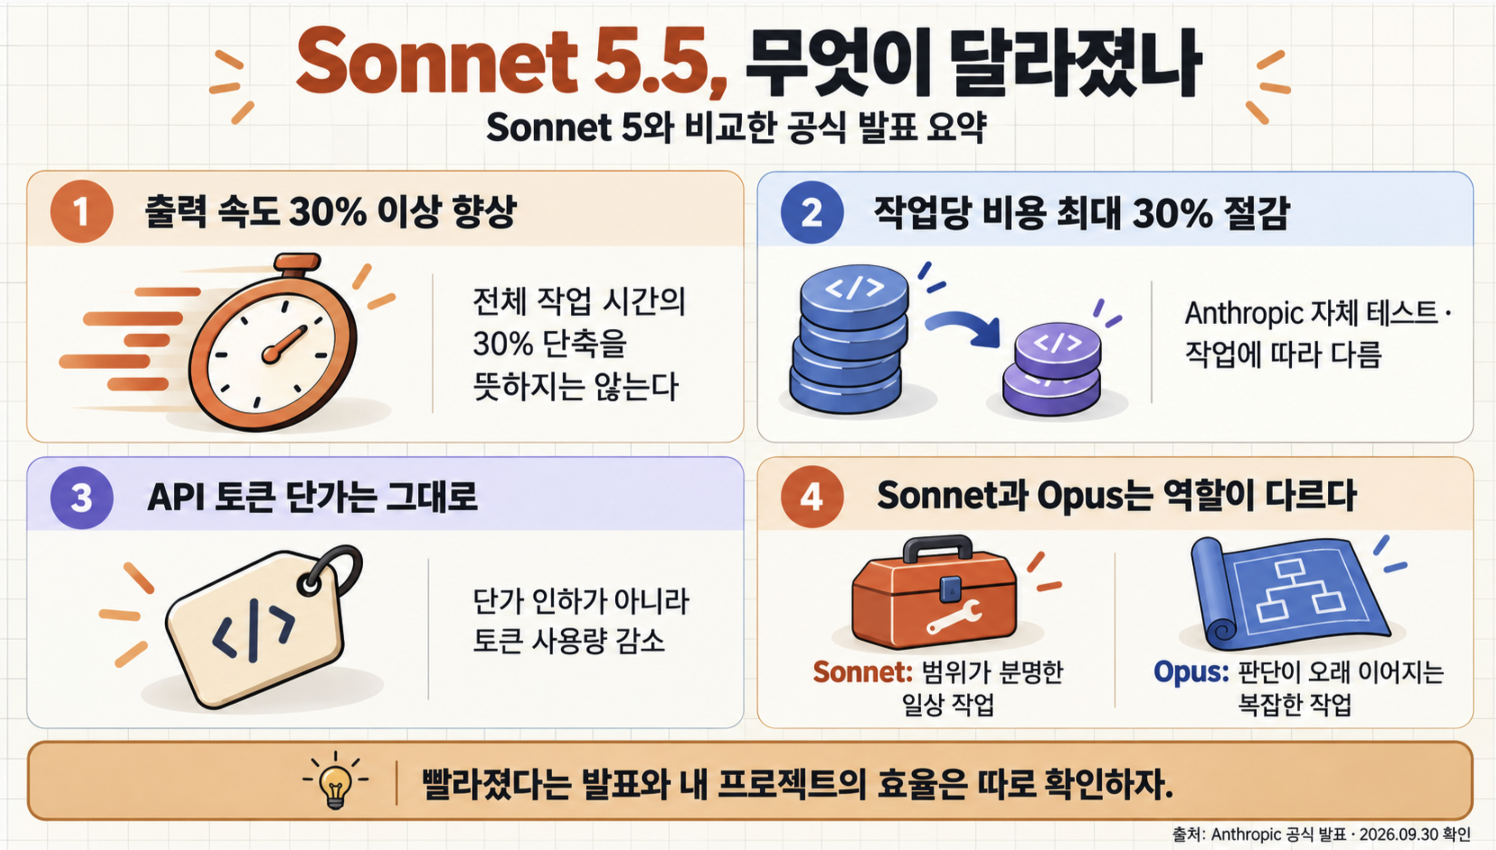
Sonnet 5.5는 Claude 5.5 계열의 두 번째 모델이다. Opus 5.5보다 빠르고 싸게 쓰라고 내놓은 모델이다.
Anthropic은 범위가 분명한 일상 작업, 버그 수정, 문서·슬라이드·스프레드시트 제작이 강점이라고 설명한다.
복잡하고 판단이 오래 이어지는 일은 Opus 5.5가 여전히 낫다고 스스로 적어 뒀다.
| 항목 | 공식 발표에서 확인한 내용 | 읽을 때 주의할 점 |
|---|---|---|
| 속도 | Sonnet 5보다 출력 속도가 30% 이상 빠르다 | Anthropic이 직접 잰 값이다. 실제 체감은 도구 호출과 네트워크에도 좌우된다 |
| 작업당 비용 | Anthropic 테스트에서 Sonnet 5보다 최대 30% 낮다 | 단가 인하가 아니라 토큰을 덜 쓴다는 뜻이다 |
| API 단가 (100만 토큰당) |
입력 $2, 출력 $10 (캐시 요금은 6장에서 다룬다) | 가격은 Sonnet 5와 같다 |
| 기본 effort | Claude 앱과 Claude Code는 Medium, Claude Platform(API를 쓰는 개발자용 서비스)은 High | 같은 모델이어도 제품에 따라 결과·시간·비용이 달라진다 |
| 안전장치 | Sonnet 중 처음으로 사이버 안전장치와 대체 모델 전환을 적용한다 | 고위험 사이버 요청은 눈에 보이게 Sonnet 5로 넘어간다. 일상적인 버그 수정은 그대로 가능하다는 설명이다 |
모든 프로젝트에서 30%를 아끼는 건 아니다. 재시도가 많거나 작업 범위가 다르면 절감 폭도 달라진다.
기본 effort도 눈여겨볼 대목이다. 같은 모델이라도 앱은 Medium, API는 High가 기본이라서, 후기를 볼 때는 어떤 환경에서 썼는지도 같이 보자.
숫자를 보기 전에 "내가 이걸 어디서 열어 보나"부터 정리하자. 쓰는 길은 크게 네 가지다.
| 어디서 | 이런 사람에게 | 시작하는 법 | 알아 둘 점 |
|---|---|---|---|
| Claude 웹·앱 (claude.ai, 모바일, 데스크톱) |
글쓰기, 문서 정리, 질문, 간단한 코드 | 새 대화를 열고 모델 선택 메뉴에서 Sonnet 5.5를 고른다 | 요금 페이지 기준으로 Free에는 Sonnet과 Haiku가 있고 Opus는 없다. 지원 문서는 웹, 모바일, 데스크톱, Cowork, Claude for Microsoft 365 같은 제품에서 Sonnet 5.5가 쓰인다고 안내한다 |
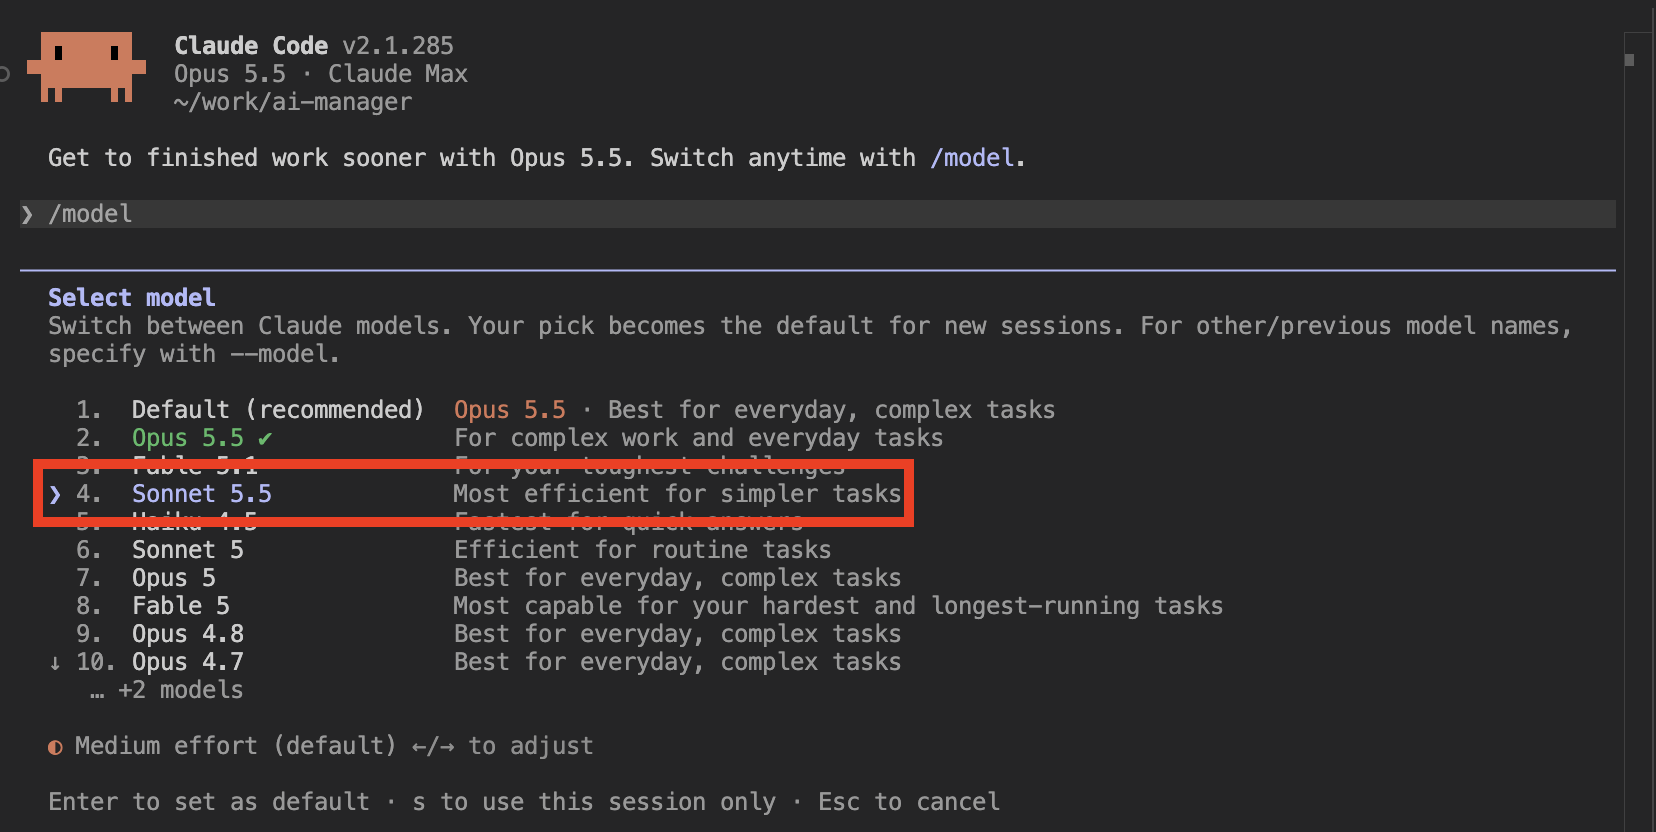
| Claude Code | 터미널에서 코드를 읽고 고치는 작업 | v2.1.284 이상에서 /model sonnet |
Pro 이상 유료 요금제에서 쓸 수 있고, 기본 모델은 Opus 5.5라서 직접 골라야 한다 |
| GitHub Copilot | 이미 Copilot을 쓰는 개발자 | 모델 선택 메뉴에서 Sonnet 5.5를 고른다 | Pro, Pro+, Max, Business, Enterprise에서 쓸 수 있고, 단계적으로 열리는 중이라 아직 안 보일 수 있다. 사용량에 따라 제공사 정가로 과금되고, Business와 Enterprise는 관리자가 정책에서 켜고 끈다 |
| API와 클라우드 | 내 서비스나 자동화에 넣는 개발자 | 모델 이름을 claude-sonnet-5-5로 지정한다 (Amazon Bedrock은 anthropic.claude-sonnet-5-5) |
AWS, Google Cloud, Microsoft Azure에서도 쓸 수 있다고 공식 발표에 나온다. Sonnet 5에서 옮길 때 바꿀 설정이 있다(7장) |
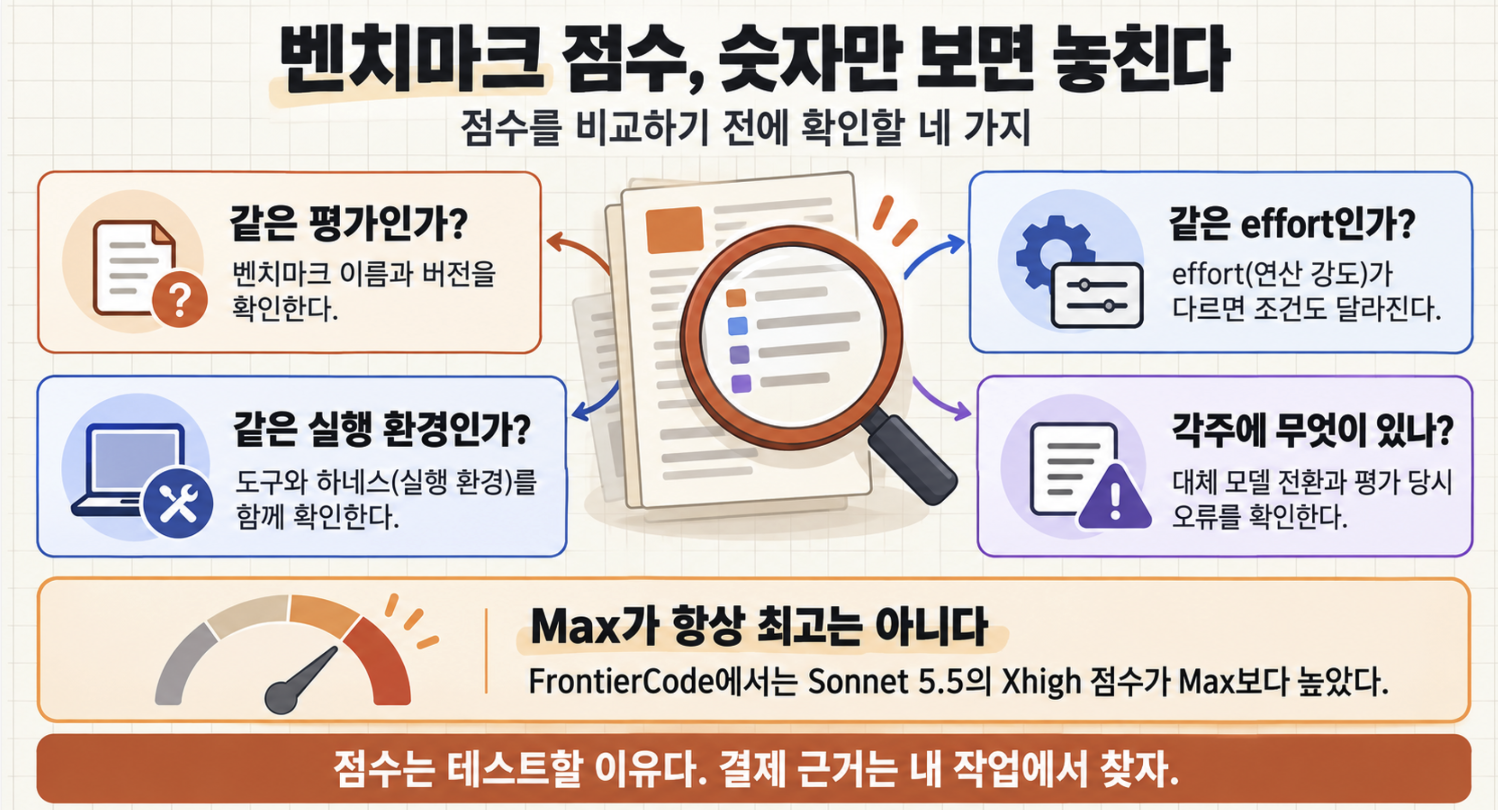
벤치마크는 AI에게 같은 시험을 풀게 하고 점수를 매긴 것이다. 표를 다 외울 필요는 없고 두 가지만 기억하면 된다.
Terminal-Bench는 명령줄에서 여러 단계짜리 전문 과제를 끝내는지 보는 평가다.
점수는 모델 말고 effort, 실행 환경, 벤치마크 버전에 따라서도 달라진다.
| 평가 | 무엇을 보나 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 터미널에서 명령을 이어 가며 여러 단계짜리 과제를 끝내는지 | 70.6% | 10.3% | 66.4% (Xhigh) |
| FrontierCode 1.1 | AI가 고친 코드를 검토 없이 그대로 합쳐도 될 수준인지 | 52.1% (Xhigh) 46.2% (Max) |
42.4% | 54.4% |
| CursorBench 4.0 | 실제 개발 세션에서 뽑은, 지시가 모호하고 파일이 여러 개인 작업 | 55.5% | 34.1% | 57.8% |
| GDPval-AA v2.1 | 44개 직업의 실제 업무 (직장 업무에 가까운 시험, 높을수록 좋음) | 1844 | 1449 | 1846 |
이 표는 Anthropic이 직접 공개한 값이다.
독립 기관이 같은 조건에서 다시 잰 순위표가 아니다.
ex) 위 표의 숫자를 막대그래프로 다시 그려 봤다. 막대 높이만 보지 말고 아래 네 가지를 같이 봐야 한다.

Anthropic 발표 페이지에는 점수와 작업당 비용을 함께 그린 차트가 네 개 있다. 차트 아래 설명을 풀어 쓰면 이렇다.
네 개 모두 Anthropic이 직접 고른 비교라서 독립 검증은 아니다. 그래도 읽는 방법은 단순하다. 점수가 비슷하거나 더 높은데 같은 일을 훨씬 싸게 끝낸다는 이야기다. effort를 무조건 높일 필요가 없다는 말과도 이어진다.
차트는 공식 발표 페이지의 성능 비교 부분에서 직접 볼 수 있다.
ex) 위 네 개를 비율로 다시 그려 봤다. 공식 차트 그림이 아니라 차트 아래 설명의 비율이다.

AI 코드 리뷰 서비스 CodeRabbit이 9월 28일 자체 평가 세트로 Sonnet 5.5와 Sonnet 5를 비교했다.
실제 오픈소스 PR 중 가장 어려운 13건에서 Sonnet 5.5는 Sonnet 5보다 미리 알려 둔 문제를 더 많이 짚었고, 리뷰 시간과 건당 비용도 더 낮았다. 같은 세트에서 Opus 5.5는 Sonnet 5.5보다 더 많이 짚었다.
13건 중 몇 건 차이라 결론으로 삼기는 어렵다. 그래도 범위가 정해진 리뷰에서 Sonnet 5.5가 Sonnet 5보다 빠르고 싸다는 방향은 Anthropic 발표와 같고, Opus 5.5가 더 많이 찾는다는 점도 같이 보인다.
점수가 비슷해도 결국 궁금한 건 내 일에 어느 쪽을 쓰느냐다.
공식 발표는 이렇게 나눈다.
Opus 5.5는 세심한 판단이 필요한 복잡한 작업에 맞고, Sonnet 5.5는 범위가 분명한 일상 작업, 버그 수정, 문서·슬라이드·스프레드시트 제작에 강하다.
| 작업 | 먼저 써 볼 모델 | 이유 |
|---|---|---|
| 범위가 분명한 버그 수정, 테스트가 있는 반복 작업 | Sonnet 5.5 | 공식 발표가 꼽은 강점이고, 결과를 테스트로 바로 확인할 수 있다 |
| 회의록 정리, 보고서 초안, 슬라이드 구성, 표 만들기 | Sonnet 5.5 | 문서·슬라이드·스프레드시트 제작이 강점이라고 공식 발표에 나온다 |
| 한 번에 끝나지 않는 큰 작업, 설계처럼 판단이 중요한 일 | Opus 5.5 | 공식 발표와 프롬프팅 가이드 모두 가장 어려운 장기 작업은 Opus가 낫다고 적었다 |
| 결과가 맞는지 내가 확인하기 어려운 일 | Opus 5.5도 같이 써 보기 | 개인적인 기준이다. 틀려도 티가 안 나는 일일수록 더 강한 모델로 한 번 더 보는 편이 안전하다 |
| 계획은 꼼꼼하게, 구현은 빠르게 | Claude Code의 opusplan |
모델 설정 문서에 따르면 계획 모드에서는 Opus, 실행 단계에서는 Sonnet을 자동으로 쓴다 |
개인적으로는 두 가지만 본다. 할 일의 범위가 분명한지, 그리고 결과를 내가 확인할 수 있는지다.
개인적으로 내가 활용하는 업무들 중 에서는
공식 발표 직전에 Claude Code 모델 목록에 Sonnet 5.5가 보인다는 글이 먼저 올라왔다.
ex) Sonnet 5.5가 Claude Code에 보이기 시작했다는 X 게시물 (출처: X @Angaisb_)
답글에는 작은 수정은 Sonnet 5.5에 맡기고 큰 프로젝트는 Opus로 가고 싶다는 내용.
@_catwu의 출시 글에 달린 답글에서는
Sonnet 5는 거의 못 쓸 정도였는데 5.5는 자기 벤치마크에서 OpenAI의 GPT-6 Astra를 넘는다고 주장했다.
AIbase 보도에 따르면 @chetaslua는 같은 프롬프트로 프런트엔드 애니메이션을 만들어 OpenAI의 GPT-6 Sol과 비교했다. Sonnet 5.5가 만든 파일이 훨씬 컸고, 생성 시간도 훨씬 길어서 90분 제한에 자주 닿았다고 한다.
사이버 안전장치 이야기는 공식 설명과 같이 봐야 한다.
Anthropic은 일상적인 버그 찾기와 수정은 그대로 된다고 하고, 고위험 요청만 Sonnet 5로 넘어간다고 설명한다.
Anthropic 지원 문서에는 Sonnet 5.5가 출시 시점에는 Cyber Verification Program 대상이 아니라고 적혀 있다.
곧 신청할 수 있게 될 예정이라는 설명도 같이 있다.
전환된 응답은 Sonnet 5 요금으로 따로 계산되고, 캐시가 끊긴 만큼은 크레딧으로 보상한다고 한다.
같은 현상을 두고 양쪽 말이 다르니, 보안과 가까운 코드를 다루는 사람은 내 프로젝트로 직접 걸리는지 확인해 보는 수밖에 없다.
Claude Code 모델 설정 문서에 따르면 Sonnet 5.5는 사이버로 분류되면 Sonnet 5로 넘어가고, 생물학 관련 요청은 대체 모델 없이 거절로 끝난다. 전환은 그 턴에만 적용된다.
이 부분은 실제로 한번 보여드리는것도 좋을 것 같다.
ex) Opus5.5 에서의 동작 예시
- 상황 : 나의 경우 실제 개발하던 내 프로젝트를 유지보수할때 보안 취약점 개선을 요청 하기도 한다.
그런데 개선 후 보안 취약점이 개선되었는지 점검을 시도하려고 하면,
이 시도가 막히곤 한다. ( Opus 5.5, Sonnet 5.5 부터는 특히나 이런 시도가 자주 막히곤 한다.)
ex) 내 테스트 DB, 내 테스트 서버를 공격해 달라는 요청에 다음과 같은 보안 Guard가 뜬다.
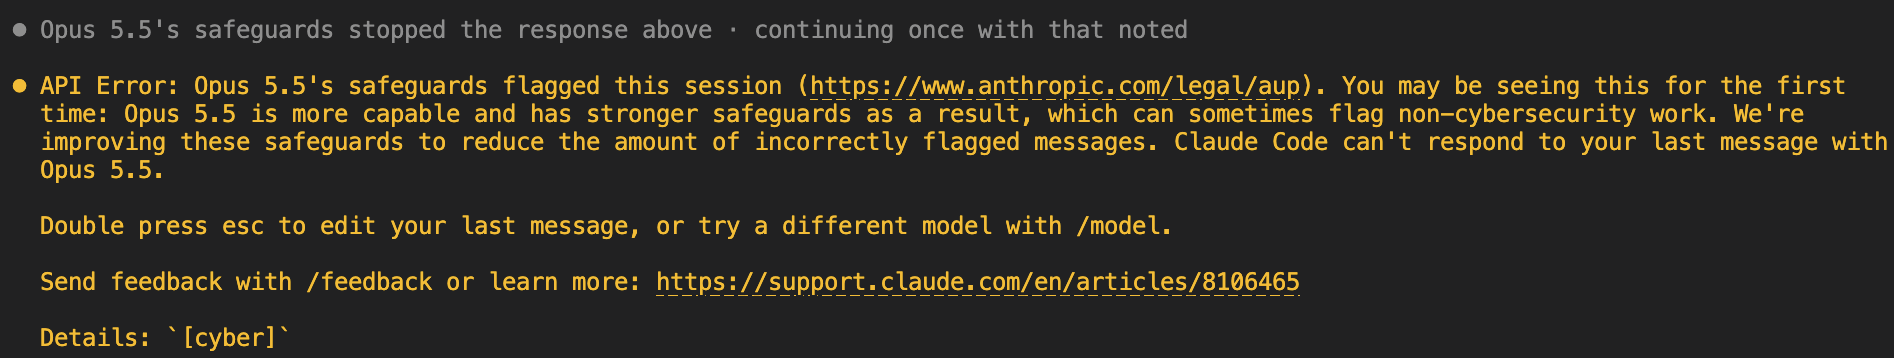
한글화 하자면 다음과 같다.
API 오류: Opus 5.5의 안전장치(safeguards)가 이번 세션을 감지하여 차단했습니다
(https://www.anthropic.com/legal/aup).

이 안내를 처음 보셨을 수도 있습니다.
Opus 5.5는 더욱 뛰어난 성능을 갖춘 만큼 안전장치도 강화되어,
사이버 보안과 관련 없는 작업이 간혹 잘못 차단되기도 합니다.

저희는 이러한 오감지 메시지를 줄이기 위해 안전장치를 지속적으로 개선하고 있습니다.
이에 따라 Claude Code가 Opus 5.5 모델을 사용하여 마지막 메시지에 응답할 수 없습니다.

Esc 키를 두 번 눌러 마지막 메시지를 수정하거나, /model 명령어를 입력해 다른 모델을 사용해 보세요.

/feedback 명령어로 피드백을 보내거나, 다음 링크에서 자세한 내용을 확인하실 수 있습니다: https://support.claude.com/en/articles/8106465

세부 정보: [cyber]
- 비슷한 내용이지만, 조금 다른 응답 > 이런식으로 가드가 될 때도 있다.

한글화 하면..
Opus 5.5의 안전장치(safeguards)가 위의 응답을 중단했습니다
이 점을 유의하고 1회 계속 진행합니다

API 오류: Opus 5.5의 안전장치가 이번 세션을 감지하여 차단했습니다
(https://www.anthropic.com/legal/aup).

이 안내를 처음 보셨을 수도 있습니다.
Opus 5.5는 더욱 뛰어난 성능을 갖춘 만큼 안전장치도 강화되어,
사이버 보안과 관련 없는 작업이 간혹 잘못 차단되기도 합니다.

저희는 이러한 오감지 메시지를 줄이기 위해 안전장치를 지속적으로 개선하고 있습니다.
이에 따라 Claude Code가 Opus 5.5 모델을 사용하여 마지막 메시지에 응답할 수 없습니다.

Esc 키를 두 번 눌러 마지막 메시지를 수정하거나, /model 명령어를 입력해 다른 모델을 사용해 보세요.
/feedback 명령어로 피드백을 보내거나, 다음 링크에서 자세한 내용을 확인하실 수 있습니다:
https://support.claude.com/en/articles/8106465
ex5) Sonnet 5.5에서의 동작 예시
- 내 테스트 DB, 내 테스트 서버를 공격해 달라는 요청에 다음과 같은 보안 Guard가 뜬다.
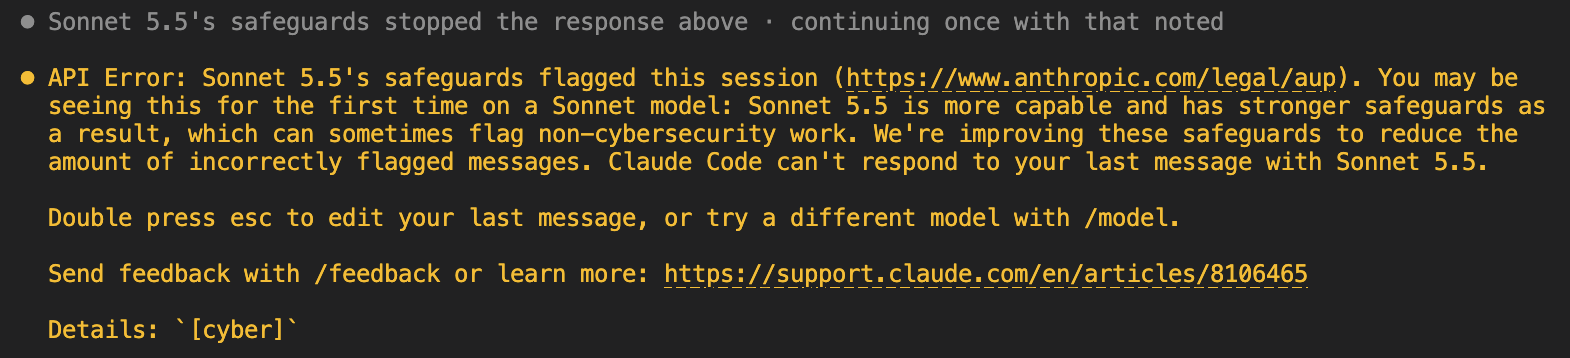
- 한글로 번역하면
Sonnet 5.5의 안전장치(safeguards)가 위의 응답을 중단했습니다
이 점을 유의하고 1회 계속 진행합니다

API 오류: Sonnet 5.5의 안전장치가 이번 세션을 감지하여 차단했습니다
(https://www.anthropic.com/legal/aup).
Sonnet 모델에서 이 안내를 처음 보셨을 수도 있습니다:
Sonnet 5.5는 더욱 뛰어난 성능을 갖춘 만큼 안전장치도 강화되어,
사이버 보안과 관련 없는 작업이 간혹 잘못 차단되기도 합니다.
저희는 이러한 오감지 메시지를 줄이기 위해 안전장치를 지속적으로 개선하고 있습니다.
이에 따라 Claude Code가 Sonnet 5.5 모델을 사용하여 마지막 메시지에 응답할 수 없습니다.
- /config 를 확인해보면 Switch models when a message is flagged 가 Ask each time 으로 되어있다.
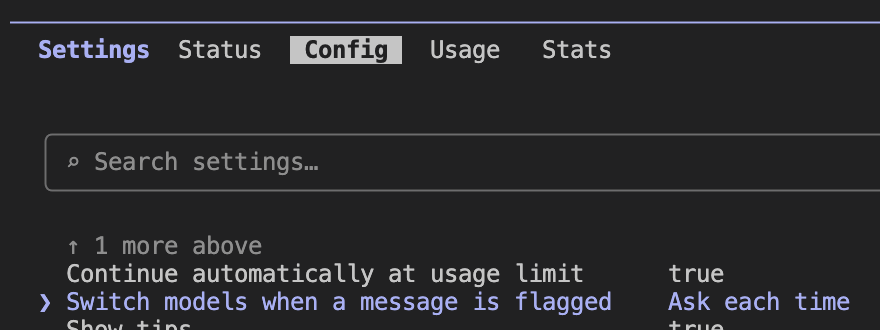
- Switch automatically로 변경해보자.
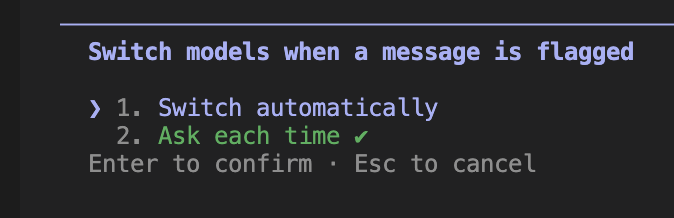
- 다음과 같이 자동으로 sonnet 5.0으로 우회 시도할 것이다. (물론 sonnet 5.0으로도 못한다면 멈출 것 이다.)

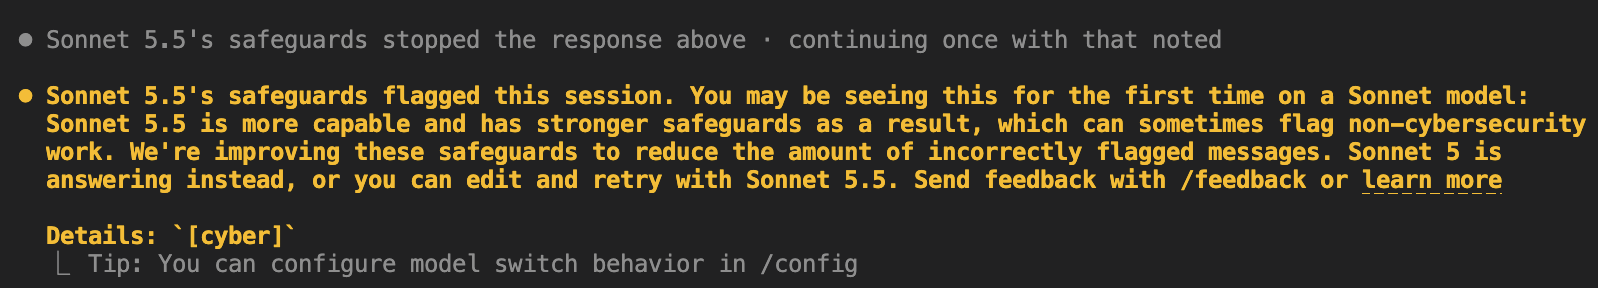
한글로 번역하자면
Sonnet 5.5의 안전장치가 이번 세션을 감지하여 차단했습니다.
Sonnet 모델에서 이 안내를 처음 보셨을 수도 있습니다:
Sonnet 5.5는 더욱 뛰어난 성능을 갖춘 만큼 안전장치도 강화되어,
사이버 보안과 관련 없는 작업이 간혹 잘못 차단되기도 합니다.

저희는 이러한 오감지 메시지를 줄이기 위해 안전장치를 지속적으로 개선하고 있습니다.
대신 Sonnet 5가 응답하고 있으며, 메시지를 수정하여 Sonnet 5.5로 다시 시도할 수도 있습니다.
/feedback 명령어로 피드백을 보내거나 자세한 내용을 확인해 보세요.
>>> 내용을 살펴보면 Sonnet 5가 응답한다고 되엉있다. 자동으로 sonnet5.0 으로 전환하는것을 볼 수 있다.
혹시 API를 사용하고 계시다면 자동 전환이 싫다면 설정 파일에 "switchModelsOnFlag": false를 넣으면 된다.
그러면 전환하지 않고 멈춰서, 직접 모델을 고르거나 수정해서 다시 시도하게 된다.
- 나의 경우는 sonnet5.0 에서도 수행할수 없는 과감한 짓?을 요청하여 거부당했다.

- 다만 이대로 업무를 하게되면 sonnet 5.0으로 일을 하게 되는 것 같으니 조심하자
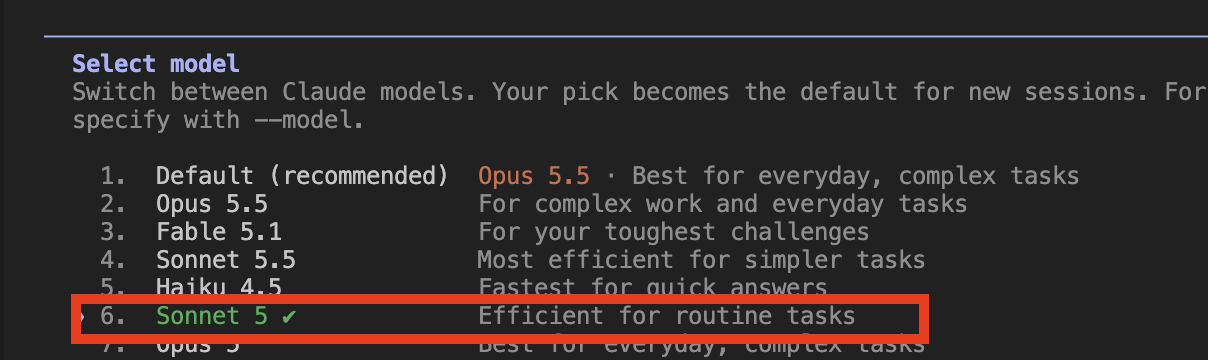
자동으로 sonnet 5로 해당 세션이 변경되어 있는 모습을 볼 수 있었다.
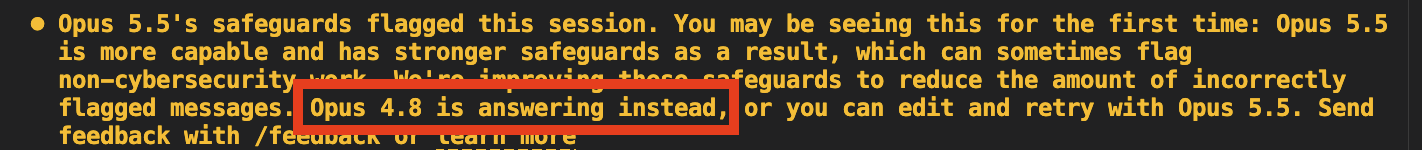
- 혹시나.. 오퍼스 5.5는 저 옵션을 키면 오퍼스 4.8까지 내려가게 된다.
(하지만 오퍼스 4.8은 많은 개발자들에게 극찬을 받고, 아직도 생각보다 해외에서는 극찬을 받는 모델이니 개인적으로는 안심??? 이 된다.)
개발자 Simon Willison은 펠리컨 SVG(벡터 이미지 파일) 그리기를 max effort로 돌렸더니 토큰만 잔뜩 쓰고 결과를 내지 못했다고 적었다. xhigh로 낮추자 41초 만에 그림이 나왔다.
독립 평가 업체 Artificial Analysis도 max effort에서 Sonnet 5.5가 자기들이 잰 모델 중 토큰을 가장 많이 썼다고 밝혔다.
두 사례 모두 FrontierCode에서 Max가 더 낮았던 것과 결이 같다. effort는 높일수록 좋은 게 아니라 작업에 맞춰 고르는 값이다.
Claude Code는 Pro 이상 유료 요금제에 들어 있다.
Claude Code 변경 기록(v2.1.280, 9월 22일)에는 Pro와 Team Standard의 기본 모델을 Sonnet에서 Opus로 바꿨다는 항목이 있다.
Claude Code 모델 설정 문서에도 Pro, Max, Team, Enterprise의 기본 모델이 Opus 5.5로 적혀 있다. 그래서 Sonnet 5.5는 /model sonnet으로 직접 골라야 한다.
미국 웹 요금 기준으로 Pro는 월 $20이고, 연간 결제하면 월 환산 $17($200 선결제)이다. Max 요금제는 Pro의 5배 또는 20배 사용량 중에서 고르는 월 $100부터다. Pro와 Max 모두 요금 비교표상 Opus와 Sonnet을 함께 쓸 수 있다.
| 선택지 | 확인할 점 | 추천하는 테스트 방법 |
|---|---|---|
| 무료 Claude 채팅 | 응답 스타일과 문서 품질을 가볍게 확인한다. Claude Code는 쓸 수 없다 | 자주 쓰는 질문 3개를 기존 모델과 나란히 비교한다 |
| Pro | Claude Code를 쓸 수 있다. 웹·데스크톱·모바일·Claude Code가 한 사용량을 나눠 쓴다 | 한 달 동안 실제 저장소 작업을 측정하고, 5시간·주간 한도에 언제 걸렸는지 기록한다 |
| Max 요금제 | Pro보다 큰 사용량이 필요할 때 고르는 요금제다 | Pro 한도가 실제 작업을 자주 막고, 늘어난 작업의 가치가 비용보다 클 때 검토한다 |
| API | 구독과 별도로 입력·출력 토큰 사용량만큼 청구된다 | 자동화나 CI처럼 호출량을 통제할 수 있을 때 별도 예산과 알림을 걸고 테스트한다 |
Claude Code는 독립된 무제한 상품이 아니다.
Pro와 Max의 사용량은 5시간 단위로 되돌아가는 한도와 주간 한도가 있고, 웹 채팅과 Claude Code가 같은 풀에서 차감된다.
한도에 걸리면 /rate-limit-options에서 초기화를 기다렸다가 이어서 하기, usage credits 추가, 요금제 변경 중에서 고를 수 있다. usage credits는 /usage-credits에서 켠다.
환경 변수 ANTHROPIC_API_KEY가 설정돼 있으면 Claude Code는 구독 대신 그 API 키로 인증한다. 그러면 구독 사용량이 아니라 API 요금이 나간다. 인증 경로부터 확인해보자.
ex) 위 계산을 막대그래프로 그려 봤다. 캐시를 많이 읽는 작업일수록 두 모델의 차이가 줄어드는 게 보인다.
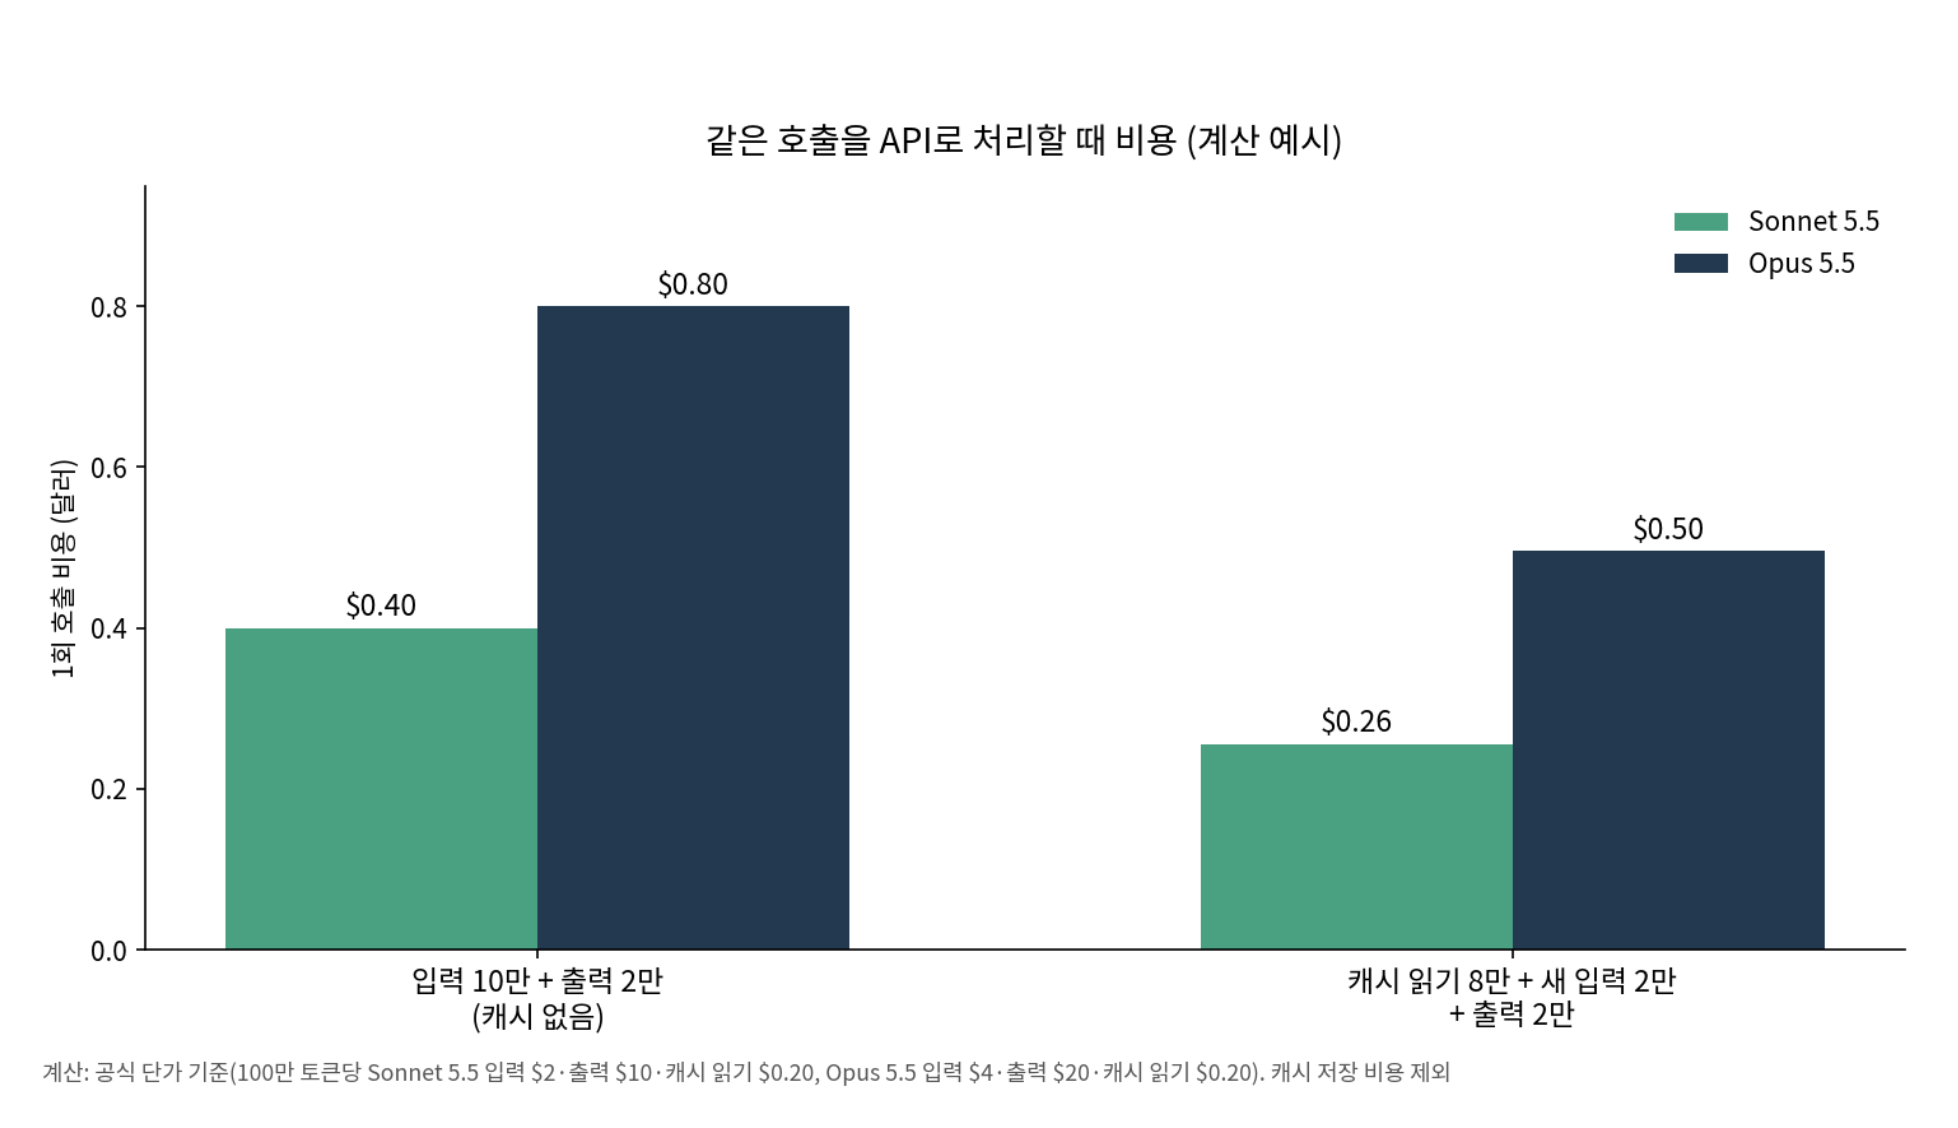
입력과 출력 단가는 Opus 5.5의 절반이지만 캐시 읽기는 같다. 그래서 같은 문맥을 계속 다시 읽는 에이전트 작업일수록 차이가 줄어든다(위 예시 2번).
채팅과 Claude Code만 쓴다면 이 장은 건너뛰어도 된다. API로 직접 호출하는 코드가 있을 때만 보면 된다.
Sonnet 5에서 5.5로 옮길 때는 모델 ID(claude-sonnet-5-5)만 바꾸면 안 된다.
공식 마이그레이션 문서가 요청 설정 몇 개는 바로 400 오류(요청 형식이 잘못됐다는 응답)가 난다고 안내한다.
| 바뀐 것 | Sonnet 5 | Sonnet 5.5 | 이렇게 고친다 |
|---|---|---|---|
| 강제 도구 호출 | tool_choice의 any·tool 허용 |
400 오류 | auto로 두고 도구에 strict: true(입력 형식을 엄격하게 지키게 하는 옵션)를 준다. 프롬프트에 언제 쓸지 적는다 |
| 생각 끄기 | thinking.type: "disabled" |
400 오류 | "between_tools"로 바꾼다. high effort 이하에서만 된다 |
| 응답 읽기 | 첫 블록을 text로 가정해도 됐다 | thinking(생각 과정) 블록이 먼저 올 수 있다 | content를 type별로 읽고, 도구 호출 대화에서는 thinking 블록을 그대로 돌려보낸다 |
| 도구 호출 사이 진행 메모 | 모두 text로 왔다 | 한두 문장이 넘는 메모는 thinking 블록으로 오고 기본 표시는 비어 있다 | 진행 표시가 있는 화면이라면 display: "updates"(베타 기능을 켜는 요청 헤더 thinking-display-updates-2026-08-18)를 쓴다 |
| 캐시 최소 길이 | 1,024 토큰 | 512 토큰 | 짧은 프롬프트도 캐시 대상이 된다. 좋아진 점이다 |
| 토큰 수 | Sonnet 5와 같은 토크나이저 | Sonnet 4.6 이하보다 같은 글이 약 30% 더 많은 토큰 | 예산과 max_tokens를 다시 계산한다. 이미지도 최대 2,576px, 4,784 토큰까지 받아 더 비싸질 수 있다 |
"생각 끄기"부터 눈으로 보자. Sonnet 5에서 disabled로 생각을 껐다면 5.5에서는 아래처럼 바꾼다.
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 16000,
  "thinking": { "type": "between_tools" },
  "output_config": { "effort": "high" },
  "messages": [{ "role": "user", "content": "..." }]
}thinking.type(생각 방식): between_tools는 시작할 때 하는 생각은 끄고, 도구 호출 사이의 진행 메모만 남기는 가장 낮은 설정이다.output_config.effort(연산 강도): 이 설정은 xhigh나 max와 같이 쓰면 400 오류가 난다.max_tokens(최대 토큰): 생각과 답변 텍스트를 모두 포함하고, 생각 토큰도 출력 토큰으로 청구된다.Sonnet 4.6 이하에서 옮긴다면 temperature·top_p·top_k의 기본값 아닌 설정 제거, assistant prefill(답변 앞부분을 미리 채워 보내던 방식) 제거, 생각 예산(budget_tokens) 교체까지 해야 한다.
어떤 모델에서 옮기느냐에 따라 체크리스트가 다르고, 공식 문서에 따로 있다.
직접 고치기 번거롭다면 Claude Code 입력창에 아래 명령을 넣어서 공식 스킬이 대신 옮겨 주게 할 수 있다.
아래 명령의 뜻은 "이 프로젝트를 claude-sonnet-5-5로 옮겨 줘"다. 공식 문서에 따르면 옮길 항목의 체크리스트부터 만든다.
/claude-api migrate this project to claude-sonnet-5-5
공식 프롬프팅 문서는 5.5에서 effort 단계가 다시 조정됐다고 설명한다. Sonnet 5에서 쓰던 값을 옮기지 말고 내 평가 세트로 다시 측정해 보라는 안내다.
시작점도 나와 있다. 범위가 분명한 에이전트 코딩은 Medium부터, 더 어렵고 긴 작업은 High부터, 채팅이나 응답 속도가 중요하면 Medium이나 Low부터 보라고 한다.
주의할 점이 두 가지 있다. 요청마다 상위 effort를 바꾸면 프롬프트 캐시가 무효화된다.
그리고 에이전트 코딩에서는 max_tokens를 모델 최대치인 128,000으로 두고 스트리밍으로 받으라고 권한다.
비용을 줄이는 프롬프트 예시도 문서에 있다. max effort에서 이 문장을 넣었더니 리뷰용 하위 에이전트를 띄우지 않아 세션 비용이 약 3분의 1 줄었고 품질 변화는 없었다고 한다. Anthropic 자체 테스트라서 내 작업에서는 다시 측정해 봐야 한다.
When the work the user asked for is done and its checks pass, stop and report. Don't start extra rounds of review or hardening on your own, and don't launch reviewer sub-agents unless the user asked for a review. If you think a deeper review is worth doing, say so at the end.
위 문장의 뜻은 "요청한 일이 끝나고 검사도 통과하면 멈추고 보고해라. 시키지 않은 추가 리뷰나 보강 라운드를 시작하지 말고, 리뷰를 요청받지 않았다면 리뷰용 하위 에이전트도 띄우지 마라. 더 깊은 리뷰가 필요해 보이면 마지막에 말만 해라"다.
마지막으로 안전장치도 챙겨야 한다.
거절되면 API는 오류가 아니라 stop_reason: "refusal"(거절)로 응답한다.
문서에는 거절된 요청도 정상 응답과 같은 요금으로 청구된다고 적혀 있다.
서버 측 fallback(fallbacks: "default", 베타, Claude API 전용)을 켜면 cyber와 frontier_llm 거절만 Sonnet 5가 다시 처리한다. 그 밖의 거절은 다시 시도하지 않는다.
Claude Code에서 세션 도중 계정을 바꾸는 사람은 공식 발표의 preserved thinking(생각 기록 보존) 설명도 한 번 읽어 보자.
추론 기록이 만든 계정에 묶이도록 바뀌었다.
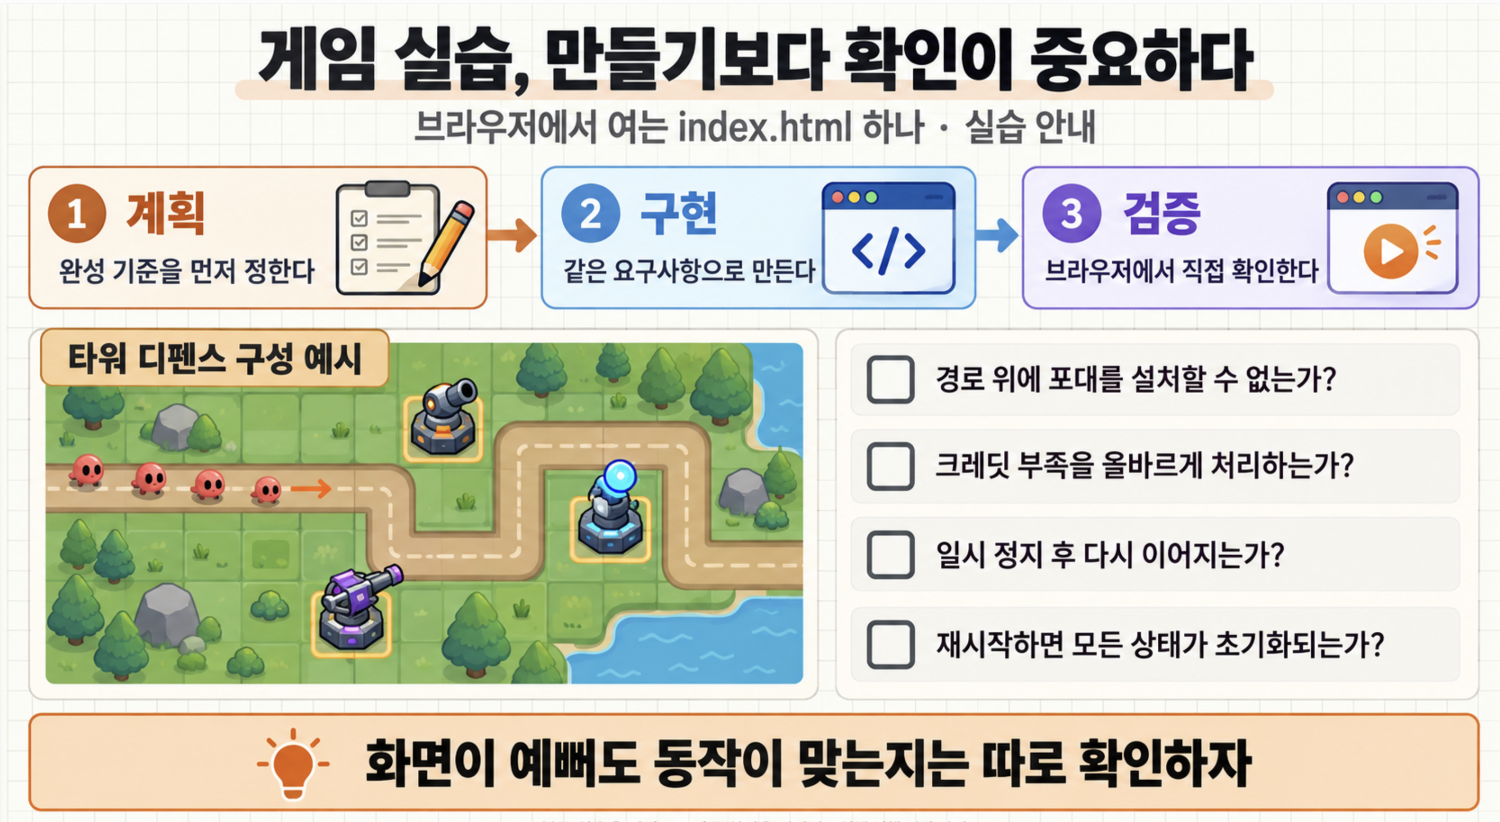
이 실습은 이번 글에서 새로 설계한 프롬프트다. Sonnet 5.5가 같은 결과를 낸다는 보장은 없고, 결과는 직접 실행해서 확인해야 한다. 설치할 것 없이 claude.ai 채팅만 있으면 되고, 코드를 쓰지 않는다면 건너뛰어도 된다.
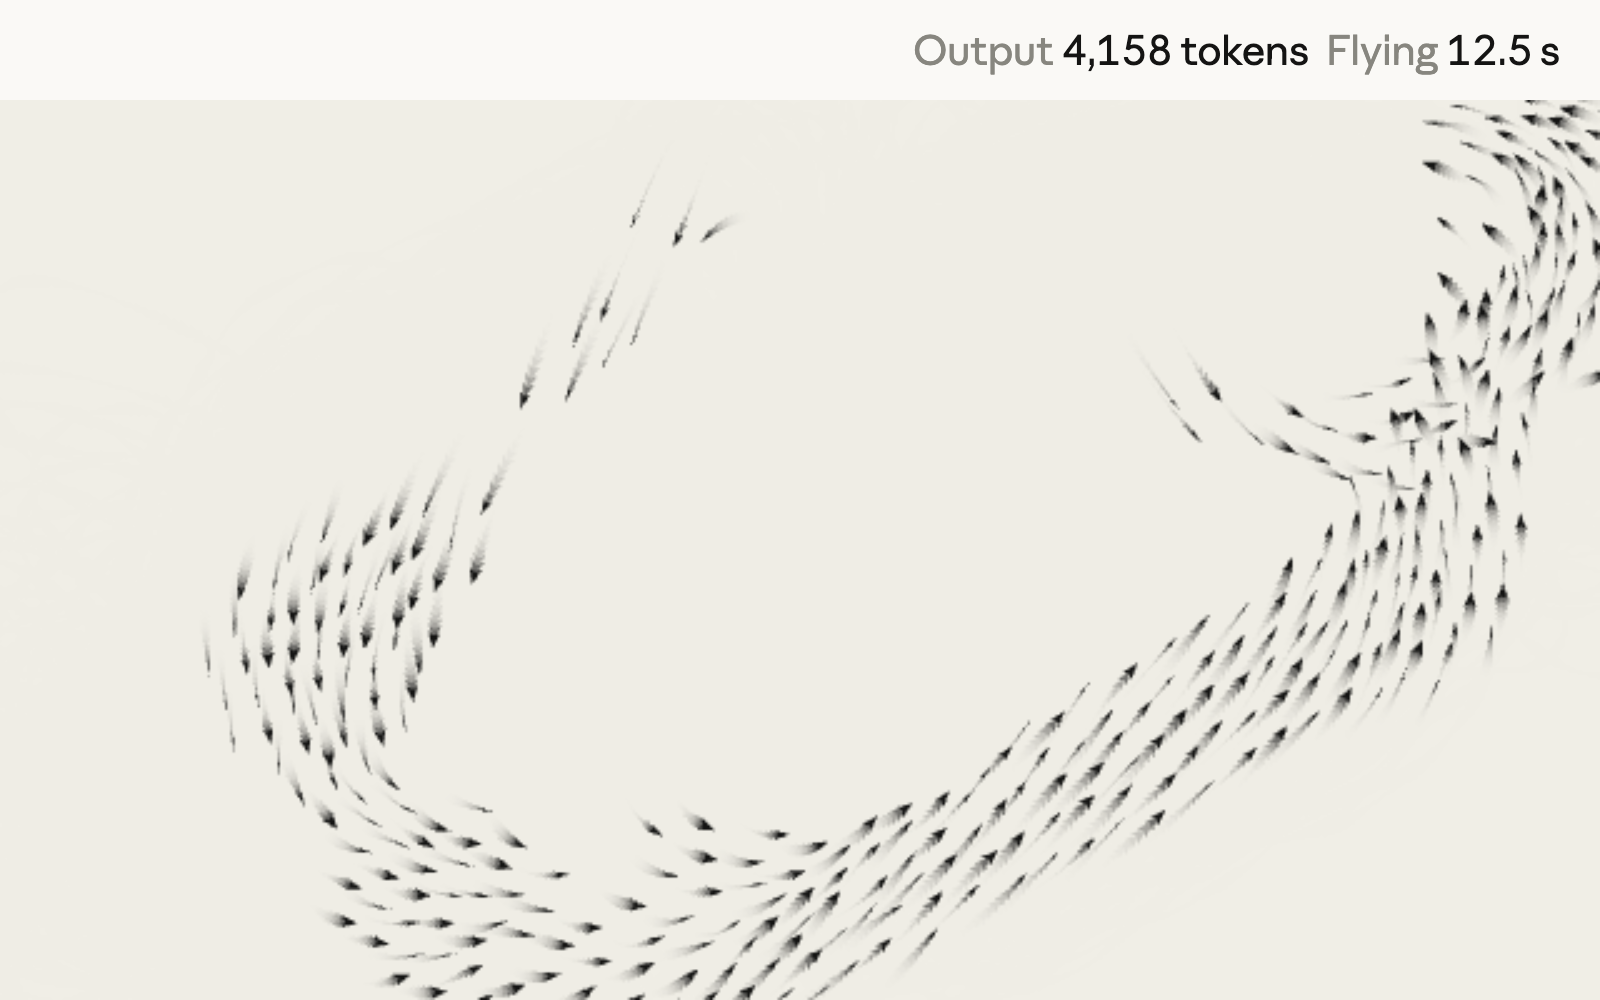
Anthropic 발표 페이지도 속도와 효율을 보여 줄 때 "HTML 파일 하나로 찌르레기 400마리의 군무", "시계 여러 개로 만든 시계(clock of clocks)" 같은 프롬프트를 썼다. 결과가 화면에 바로 보이니 모델을 비교하기 좋은 방식이다.
결과물은 설치 없이 브라우저에서 여는 HTML 파일 하나로 하자.
Canvas 2D(브라우저에서 2차원 그림을 그리는 기능)로 격자 지도를 그리고, 경로를 따라오는 적을 세 종류 포대로 막는 타워 디펜스다. 웨이브는 적이 한 차례 몰려오는 단위를 말한다.
이전 대화가 섞이지 않도록 새 대화에서 시작한다.
입력창 근처의 모델 선택 메뉴에서 Sonnet 5.5를 고르면 된다.
effort(연산 강도)를 고르는 메뉴가 보이면 무엇으로 했는지 적어 두고, 없으면 기본값 그대로 두면 된다.
Claude 앱의 기본 effort는 Medium이다.
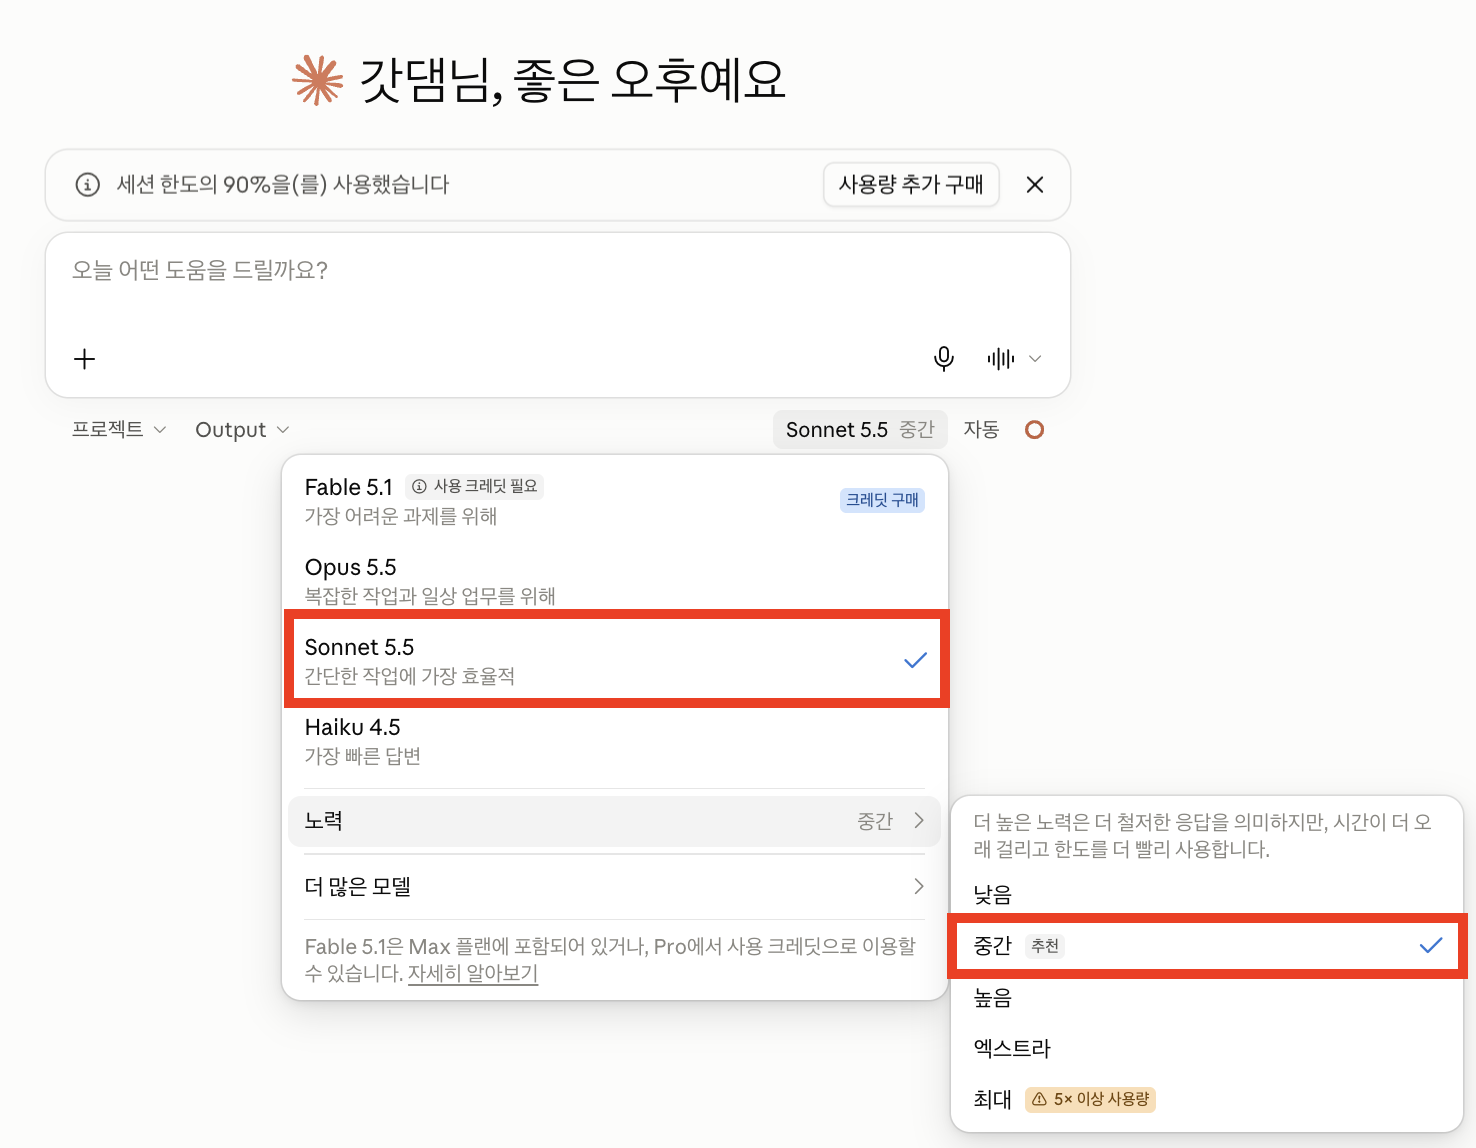
한 번에 만들라고 하면 어디가 틀렸는지 찾기 어렵다.
그래서 계획과 완성 기준을 먼저 받고 시작한다.
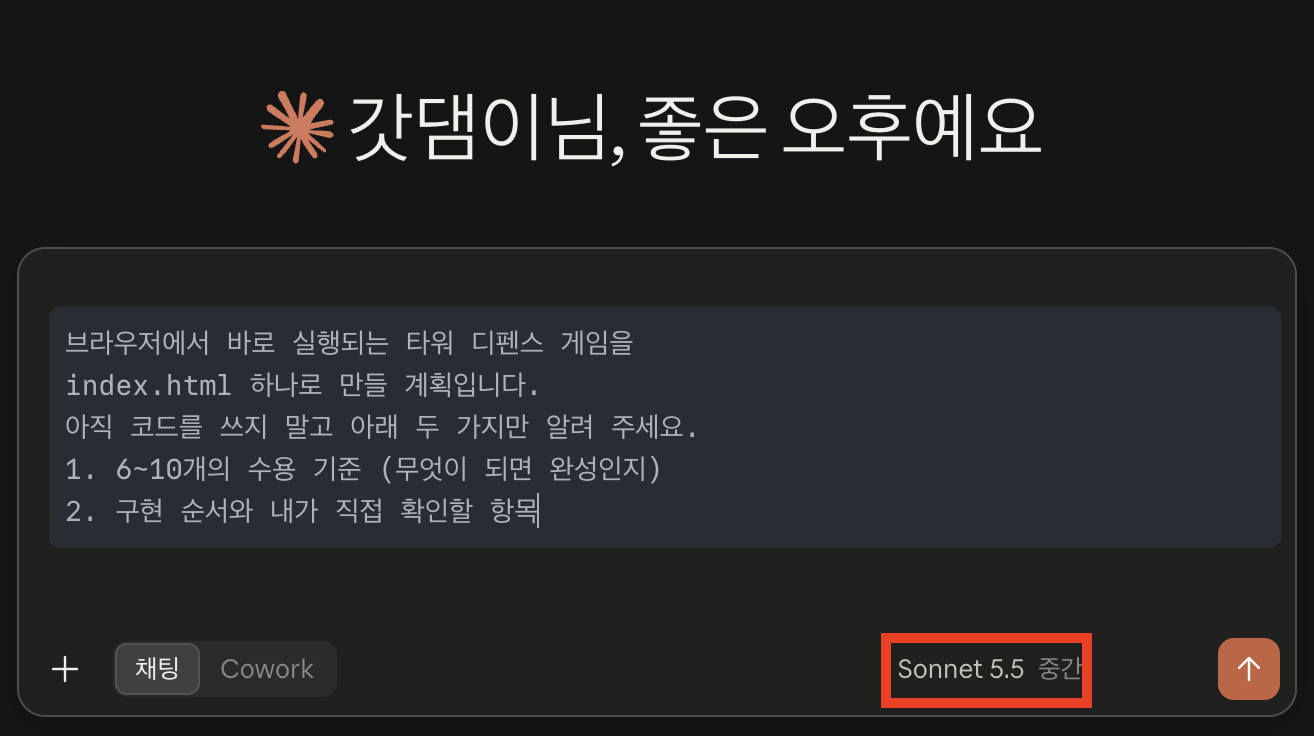
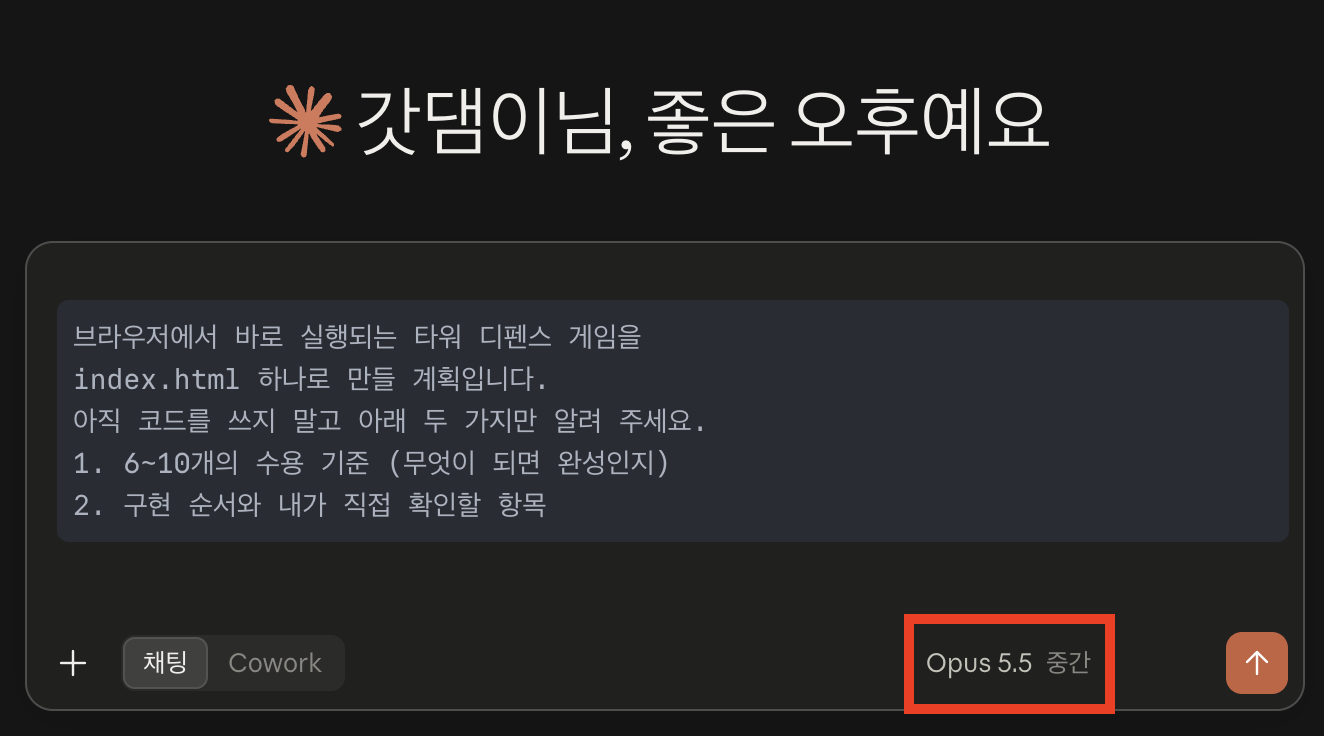
브라우저에서 바로 실행되는 타워 디펜스 게임을
index.html 하나로 만들 계획입니다.
아직 코드를 쓰지 말고 아래 두 가지만 알려 주세요.
1. 6~10개의 수용 기준 (무엇이 되면 완성인지)
2. 구현 순서와 내가 직접 확인할 항목
ex) opus5.5, sonnet 5.5 둘다 시켜본다. effort는 default 설정으로 medium으로 두었다.
계획을 읽고 마음에 들면 아래 프롬프트를 넣는다.
아티팩트는 Claude가 만든 결과물을 답변 옆 창에 따로 띄워 주는 기능이다.
지원 문서에는 HTML도 그 창에서 바로 실행해 볼 수 있고, 무료 요금제를 포함해 모든 요금제에서 쓸 수 있다.
화면에 아티팩트가 안 뜬다면 설정의 Capabilities(기능) 화면에서 "Cloud code execution and file creation" 항목이 켜져 있는지 보자.
앞서 확인한 계획대로 index.html 하나를 만들어 주세요.
화면에서 바로 실행되는 아티팩트로 만들어 주세요.
화면은 Canvas 2D로 그립니다.
외부 라이브러리, 원격 이미지, 원격 폰트, API 호출은 쓰지 않습니다.
12열×8행 지도에 입구에서 출구까지 이어지는 경로를 그려 주세요.
플레이어는 크레딧 320, 코어 내구도 15로 시작합니다.
Pulse, Rail, Cryo 세 종류 포대를 경로 밖 빈 칸에 설치할 수 있게 해 주세요.
가격, 사거리, 피해량, 발사 속도는 종류마다 다르게 하고,
Cryo는 적을 잠시 느리게 만들어 주세요.
경로 위, 이미 설치된 칸, 크레딧이 부족한 설치는 거절하고
이유를 화면에 표시해 주세요.
웨이브는 5개이고, 처치 보상과 출구 도달 시 코어 피해를 넣어 주세요.
침공 시작, 일시 정지와 재개, 1×/2× 속도, 처음부터 버튼을 넣어 주세요.
마우스와 터치로 조작할 수 있고 좁은 화면에서도 쓸 수 있어야 합니다.
끝나면 직접 확인한 것과 확인하지 못한 것을 나눠서 알려 주세요.
브라우저에서 확인하지 않은 동작은 통과했다고 말하지 말고,
내가 확인할 항목을 목록으로 남겨 주세요.
- 결과 : 게임을직접 올리진 않고 미리 디자인만 먼저 보여 드리고자 한다.
- ex) 소넷5.5
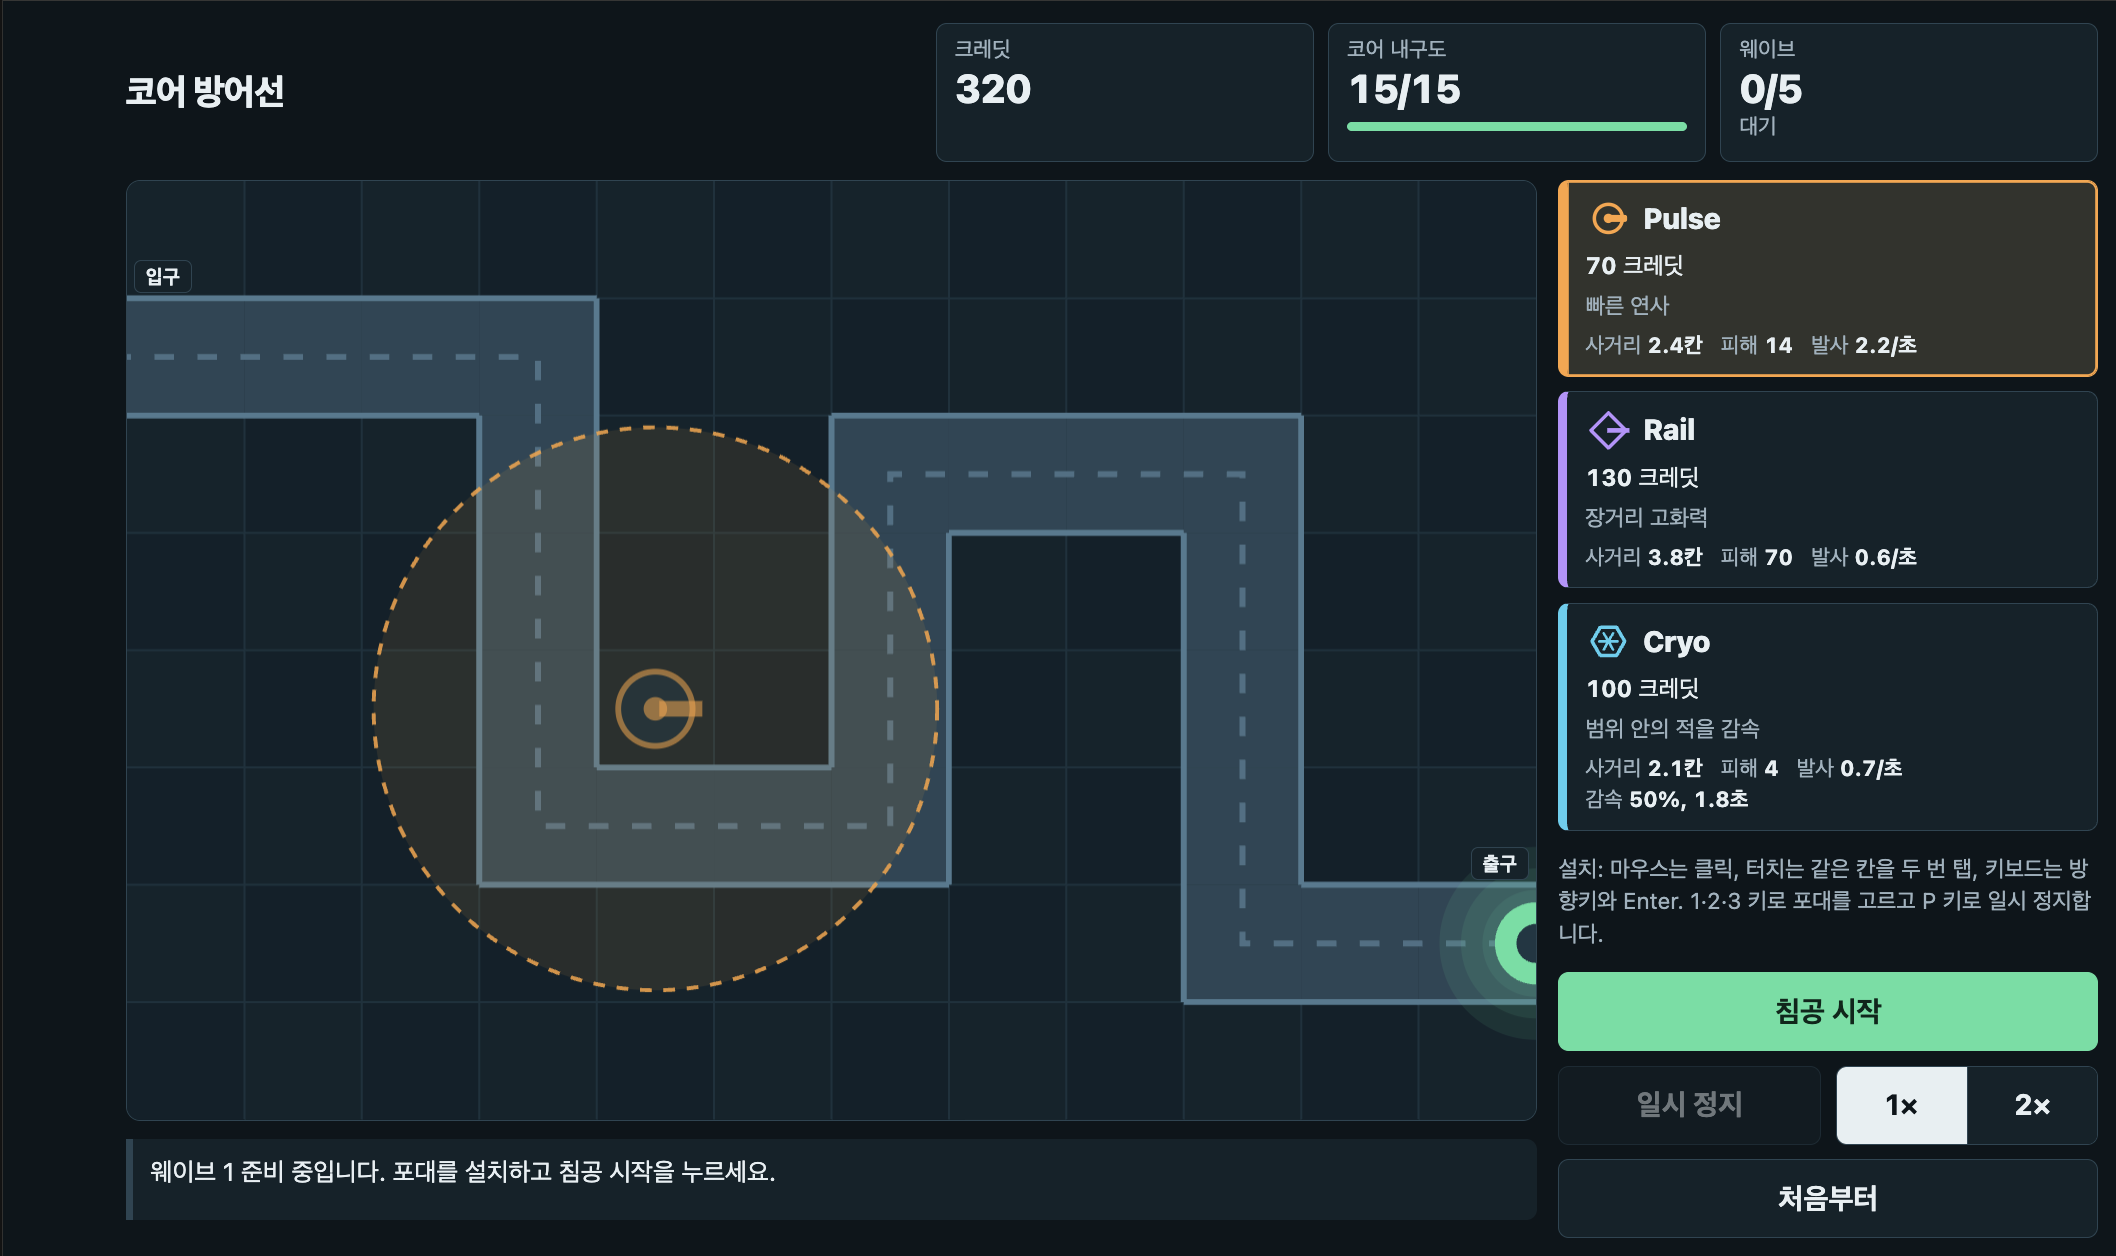
- ex) 오퍼스5.5
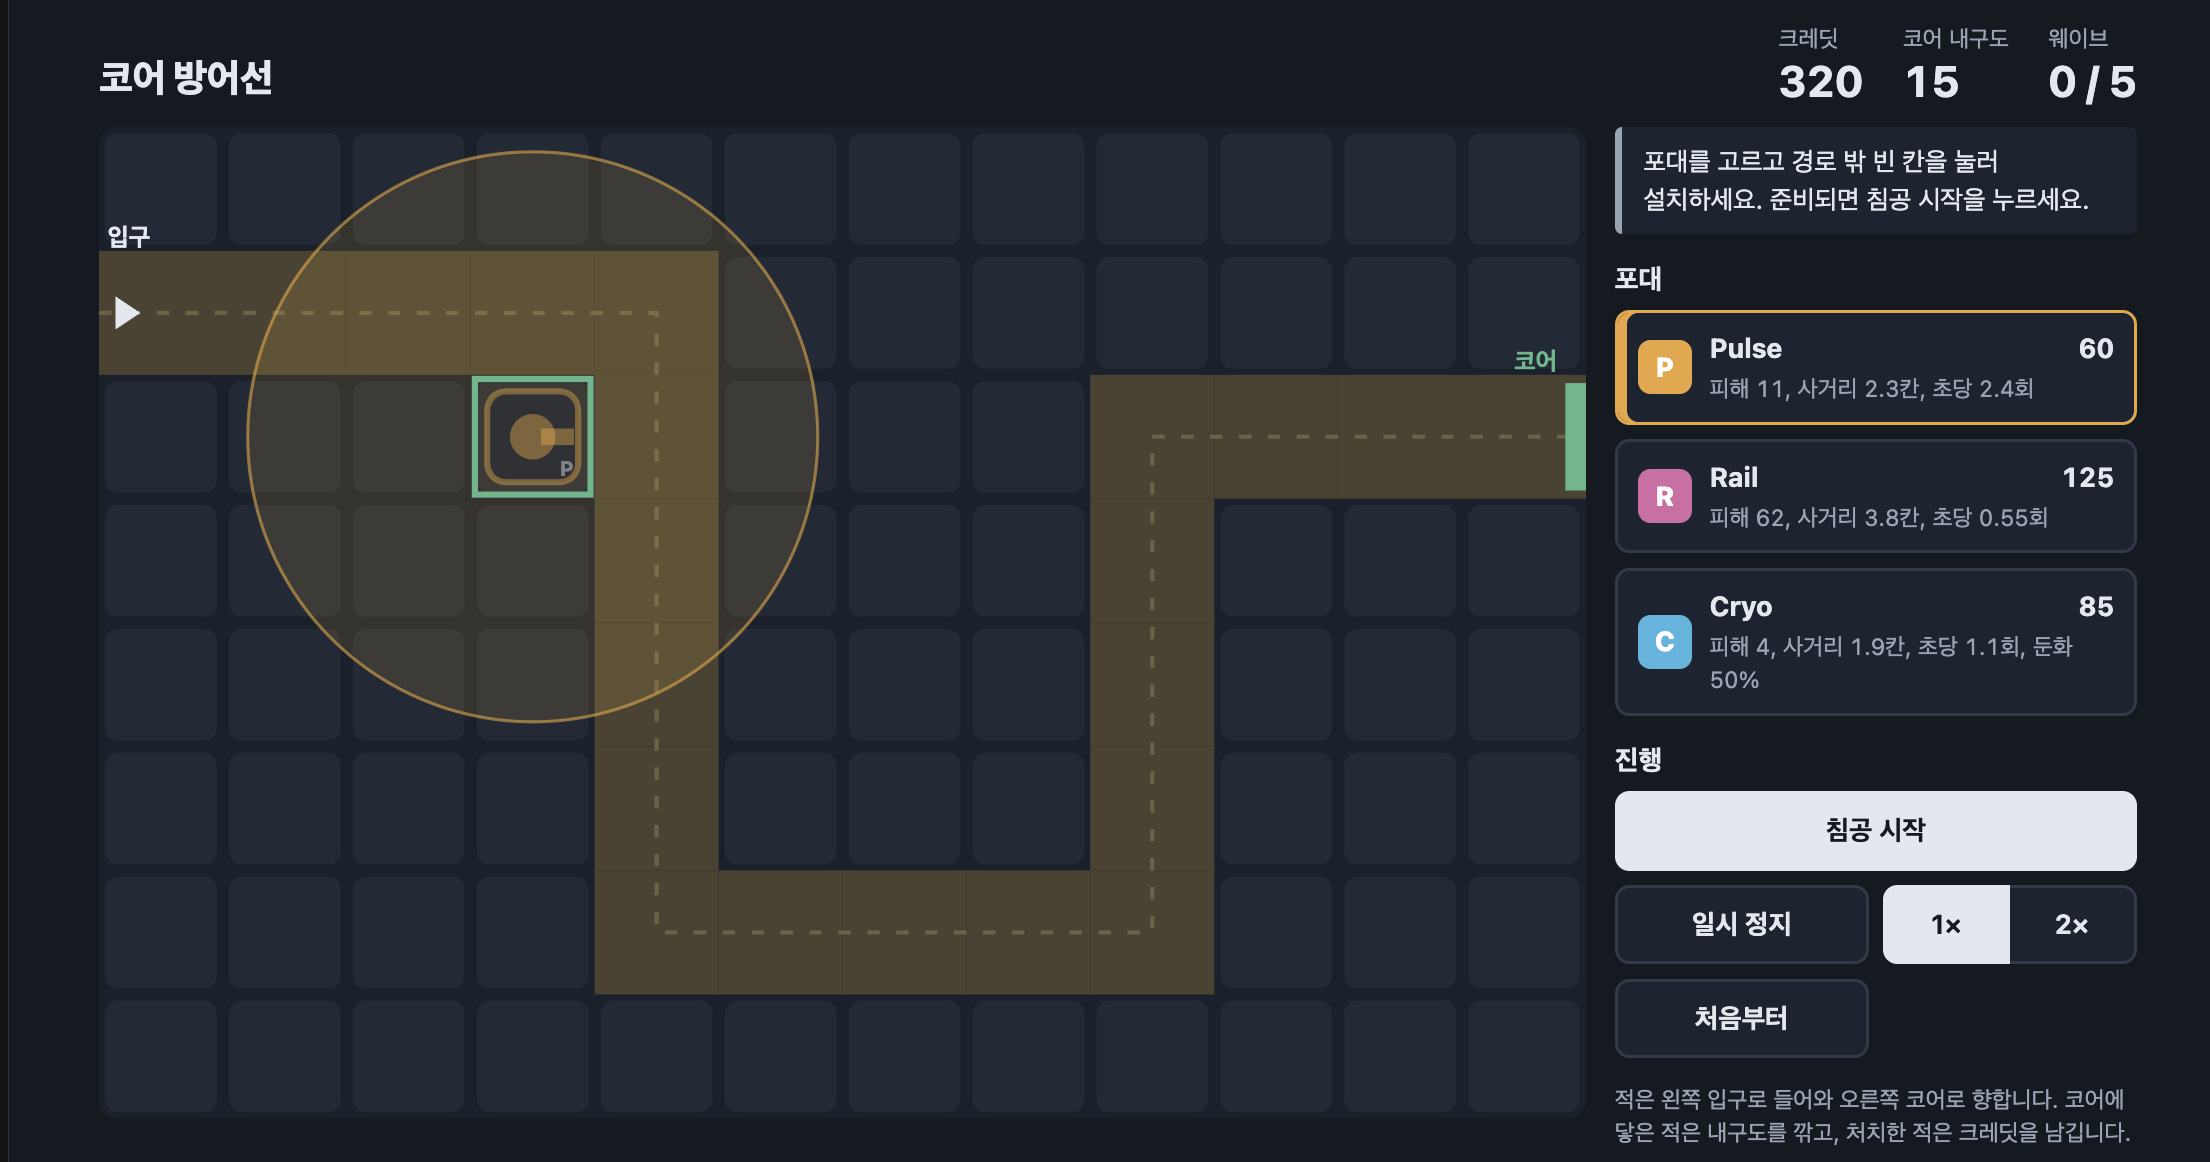
아티팩트 화면에서 바로 눌러 보면 된다.
화면이 좁아서 불편하면 코드를 index.html로 저장해 브라우저에서 열어도 된다.
결과가 이상하다면... 실제로 본 결과를 적어서 하나씩 고치게 하면 된다.
웨이브 시작 버튼을 눌렀는데 적이 나타나지 않습니다.
기대한 결과는 적이 입구에서 나타나 경로를 따라 움직이는 것입니다.
이 동작만 고치고, 고친 부분과 확인 방법을 알려 주세요.
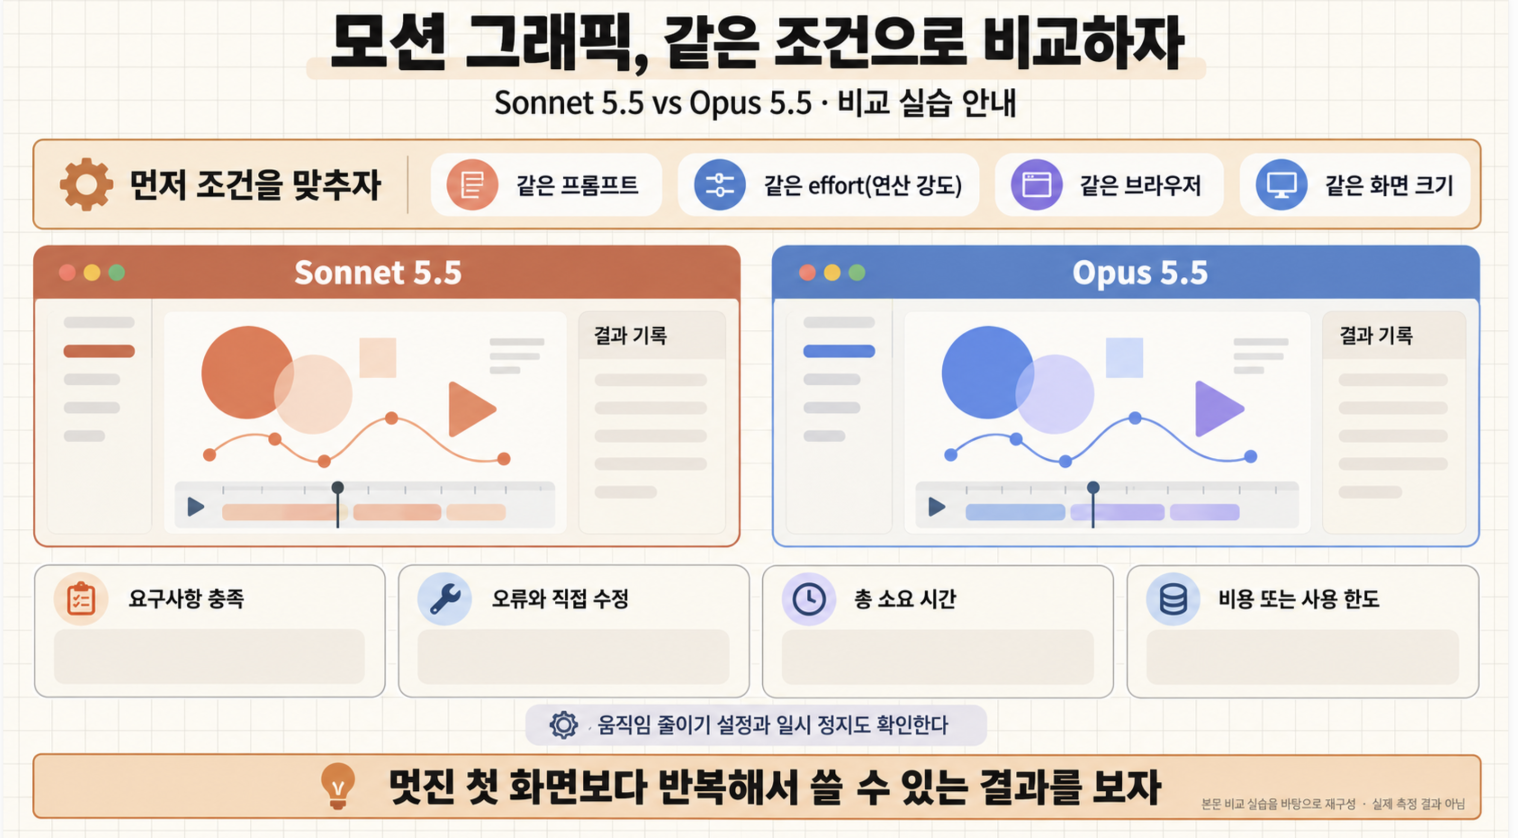
다른 사람의 결과를 옮기지 않고, 내가 직접 두 모델을 비교하는 방법을 정리한 장이다. 코드로 화면을 만들 일이 없다면 건너뛰어도 된다.
전부 Claude 웹에서 할 수 있다. 부담스럽다면 프롬프트를 한 번만 돌려서 두 결과를 눈으로 비교해도 충분하다.
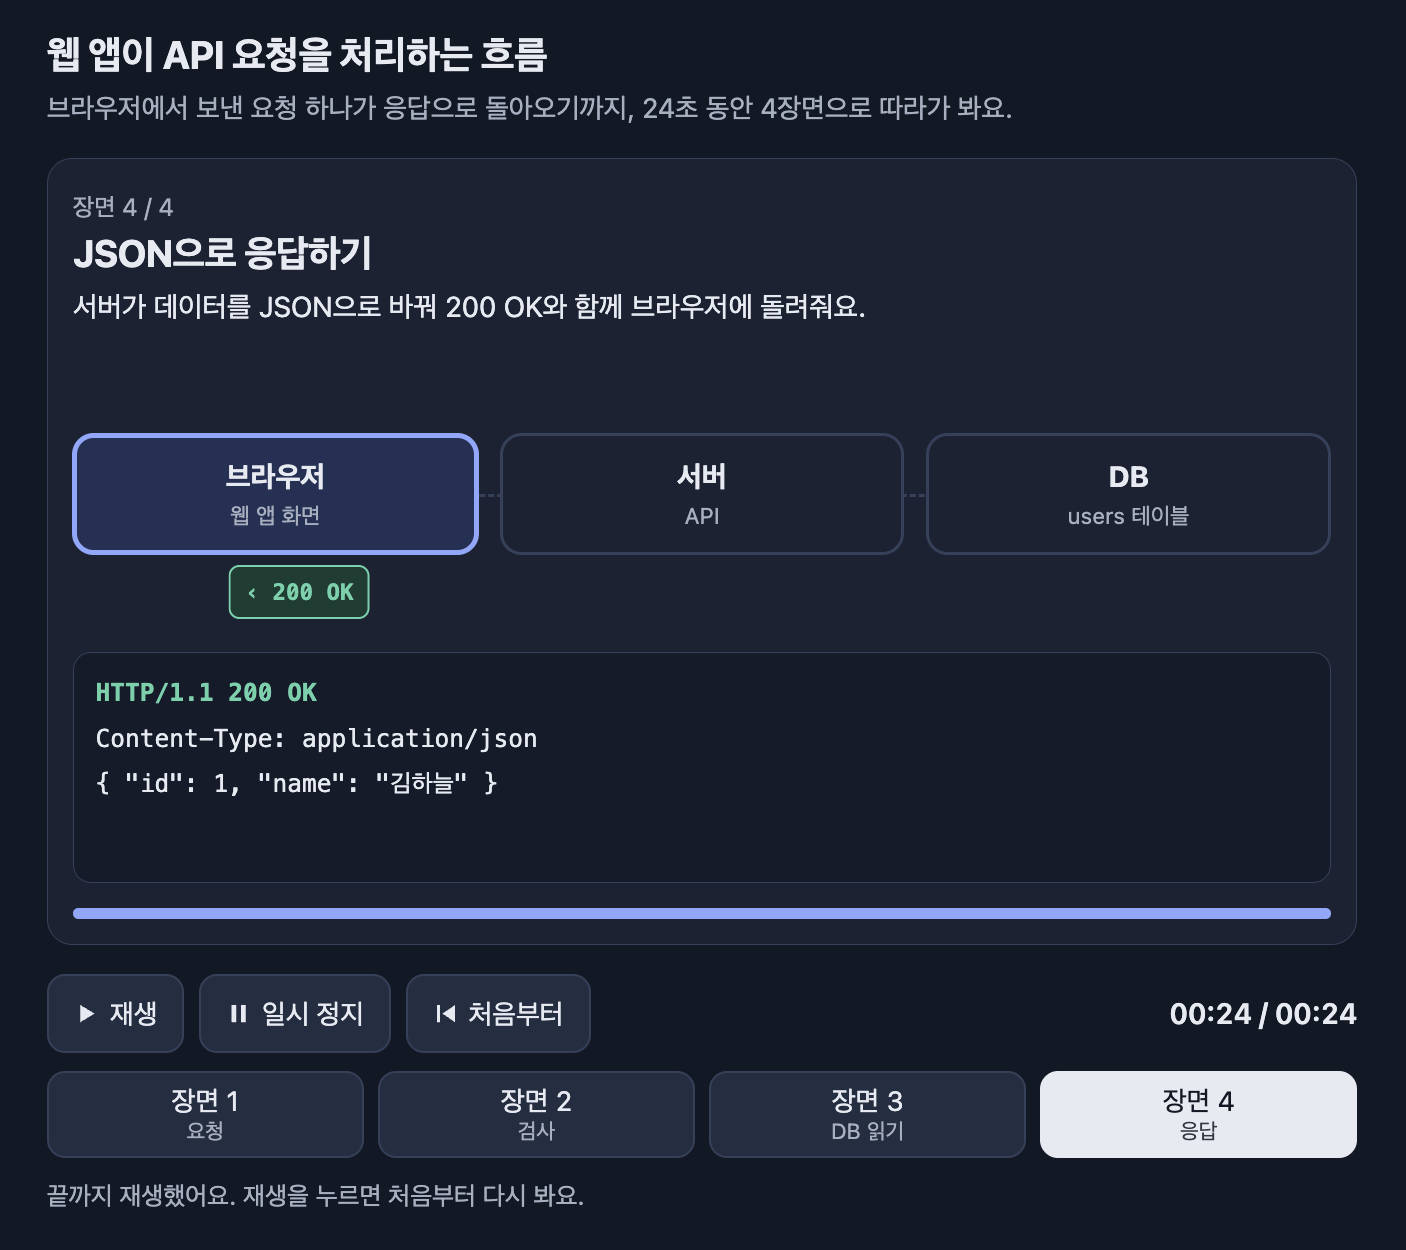
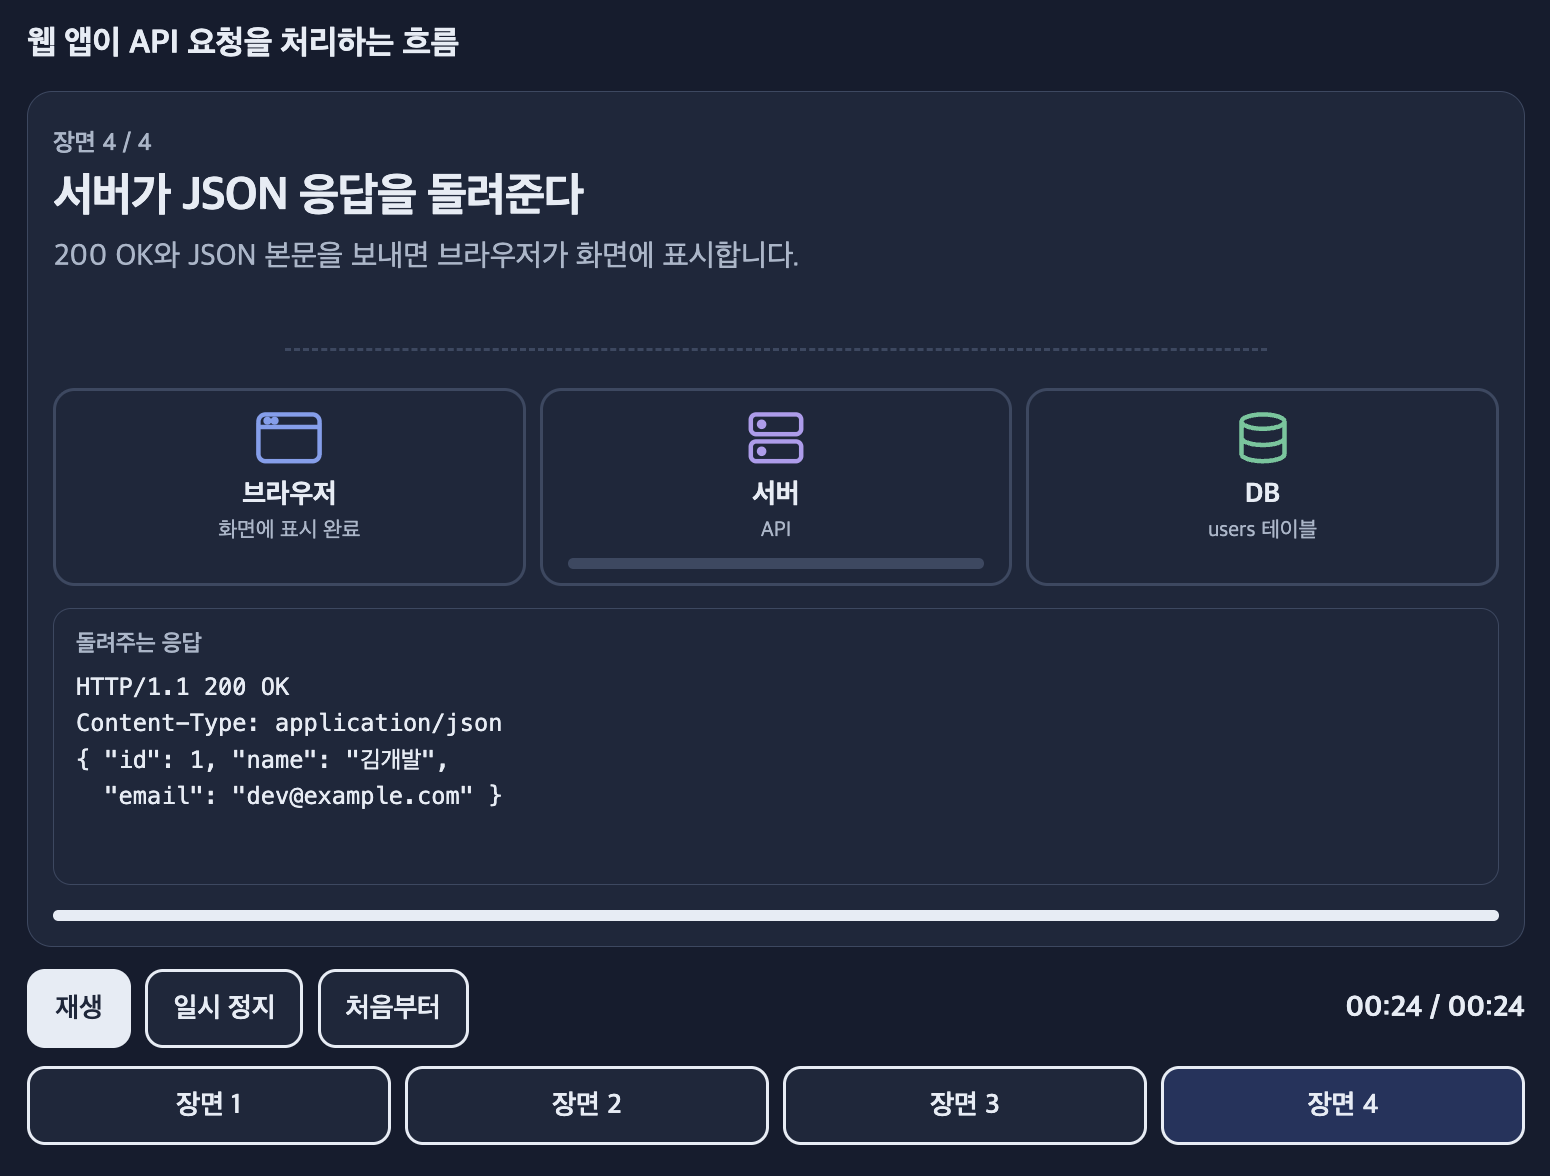
모션 그래픽은 글자, 도형, 화살표 같은 요소를 시간에 맞춰 움직여서 정보를 전달하는 그래픽이다. 카메라로 찍은 영상이 아니라 설명용 화면의 움직임이라고 보면 된다.
개발자라면 발표 자료, 블로그 설명 화면, 서비스 첫 안내 화면에서 만날 일이 많다. "요청이 서버를 거쳐 응답으로 돌아오는 흐름"처럼 말로 풀면 길어지는 내용이 좋은 재료다.
HTML로 만들 수 있는 방법은 여러 가지다.
이번 실습은 설치가 필요 없고 재생·일시 정지를 다루기 쉬운 Web Animations API를 쓴다.
| 방법 | 어떻게 움직이나 | 잘 맞는 경우 | 조심할 점 |
|---|---|---|---|
| CSS 애니메이션 | 스타일 규칙(@keyframes)만으로 움직인다 |
버튼 강조, 단순한 반복 효과 | 현재 시간 표시나 장면 이동은 JavaScript가 필요하다 |
| Web Animations API (이번 실습) |
JavaScript의 element.animate()로 만들고, 돌려받는 Animation 객체로 재생을 제어한다 |
장면 순서, 일시 정지, 처음부터가 필요한 설명 화면 | 브라우저 기본 기능이라 설치는 필요 없다 |
| Canvas + requestAnimationFrame (캔버스에 직접 그리기) |
매 프레임 직접 그린다. 콜백이 받는 시간값으로 진행 정도를 계산해야 화면 주사율이 달라도 속도가 같다 | 파티클, 게임처럼 계산으로 그리는 화면 | 글자와 접근성을 직접 챙겨야 한다. 백그라운드 탭에서는 멈춘다 |
| Remotion | React 코드로 영상을 만들고 영상 파일로 뽑아 준다. Node가 필요하다 | mp4 같은 영상 파일로 내보내야 할 때 | 설치와 렌더링 과정이 있어 이번 글 범위를 벗어난다 |
Web Animations API와 requestAnimationFrame 내용은 MDN 문서에서, Remotion은 공식 문서에서 확인했다.
출처는 글 아래 참고 자료에 있다.
정답이 하나가 아니라서 문제 풀이 점수로는 안 보이던 차이가 드러난다.
시간, 조작 버튼, 반응형 화면, 접근성을 동시에 지켜야 해서 빠뜨린 요구사항이 화면에서 바로 보일 것이다.
다만 한 번의 결과로 어느 쪽이 낫다고 말할 수는 없다. 그래서 아래처럼 조건을 맞추고 여러 번 돌리는 방식으로 비교한다.
움직이는 화면은 멈출 수 있어야 한다. 웹 접근성 지침인 WCAG 2.2의 2.2.2 기준은 자동으로 시작해 5초 넘게 움직이는 정보에 일시 정지·정지·숨김 수단을 요구한다.
운영체제의 "움직임 줄이기" 설정을 따르는 CSS prefers-reduced-motion도 함께 지키는 게 좋다. 아래 프롬프트에 두 가지를 모두 조건으로 넣었다.
비교가 공정하려면 모델 말고는 모든 게 같아야 한다. 아래 네 가지를 맞추고 시작하자.
Claude Code로 비교해도 된다.
그때는 모델마다 폴더를 나누고 /model로 모델을 고르면 된다.
이 프롬프트는 이번 글을 위해 새로 설계한 것이다. 한 줄이 한 가지 요구사항이라 나중에 빠진 게 없는지 세어 보기 쉽다. 버튼 이름을 고정해 둔 것은 두 결과에서 같은 버튼을 찾아 비교하기 쉽게 하려는 것이다.
24초짜리 개발자 교육용 모션 그래픽을 index.html 하나로 만들어 주세요.
화면에서 바로 실행되는 아티팩트로 만들어 주세요.
주제는 "웹 앱이 API 요청을 처리하는 흐름"입니다.
장면은 4개이고 각각 6초입니다.
1. 브라우저가 서버에 요청을 보낸다 (GET /users/1)
2. 서버가 요청을 받아 검사한다
3. 서버가 DB에서 데이터를 읽는다
4. 서버가 JSON 응답을 돌려준다 (200 OK)
장면마다 제목과 한 줄 설명을 화면 글자로 보여 주세요.
소리가 없어도 이해되어야 합니다.
애니메이션은 Web Animations API(element.animate)로 구현해 주세요.
외부 폰트, 이미지, 라이브러리, API 요청 없이 동작해야 합니다.
버튼은 "재생", "일시 정지", "처음부터"와 장면 1~4 선택 버튼을 넣어 주세요.
재생 버튼을 눌러야 시작하고, 일시 정지 뒤에는 같은 위치에서 이어져야 합니다.
현재 시간을 "00:06 / 00:24" 형식으로 보여 주세요.
키보드(Tab, Enter)와 터치로 조작할 수 있어야 하고 포커스가 눈에 보여야 합니다.
OS의 움직임 줄이기 설정(prefers-reduced-motion)이 켜져 있으면
자동으로 움직이지 않고, 장면 선택 버튼으로 각 장면의 정지 화면을 볼 수 있게 해 주세요.
화면 폭 390px에서도 글자가 잘리거나 겹치지 않아야 합니다.
점멸과 빠른 확대·축소는 넣지 마세요.
코드를 쓰기 전에 만들 파일과 검증 방법을 한 문단으로 요약해 주세요.
끝나면 실제로 확인한 것과 확인하지 못한 것을 나눠서 알려 주세요.
(개인적으로 디자인 적인 면은 opus 5.5보다 마음에 드는것 같다.)
ex) 소넷5.5 결과
- https://claude.ai/artifact/D8AcnAHCkYMRbNVNNCyuZg
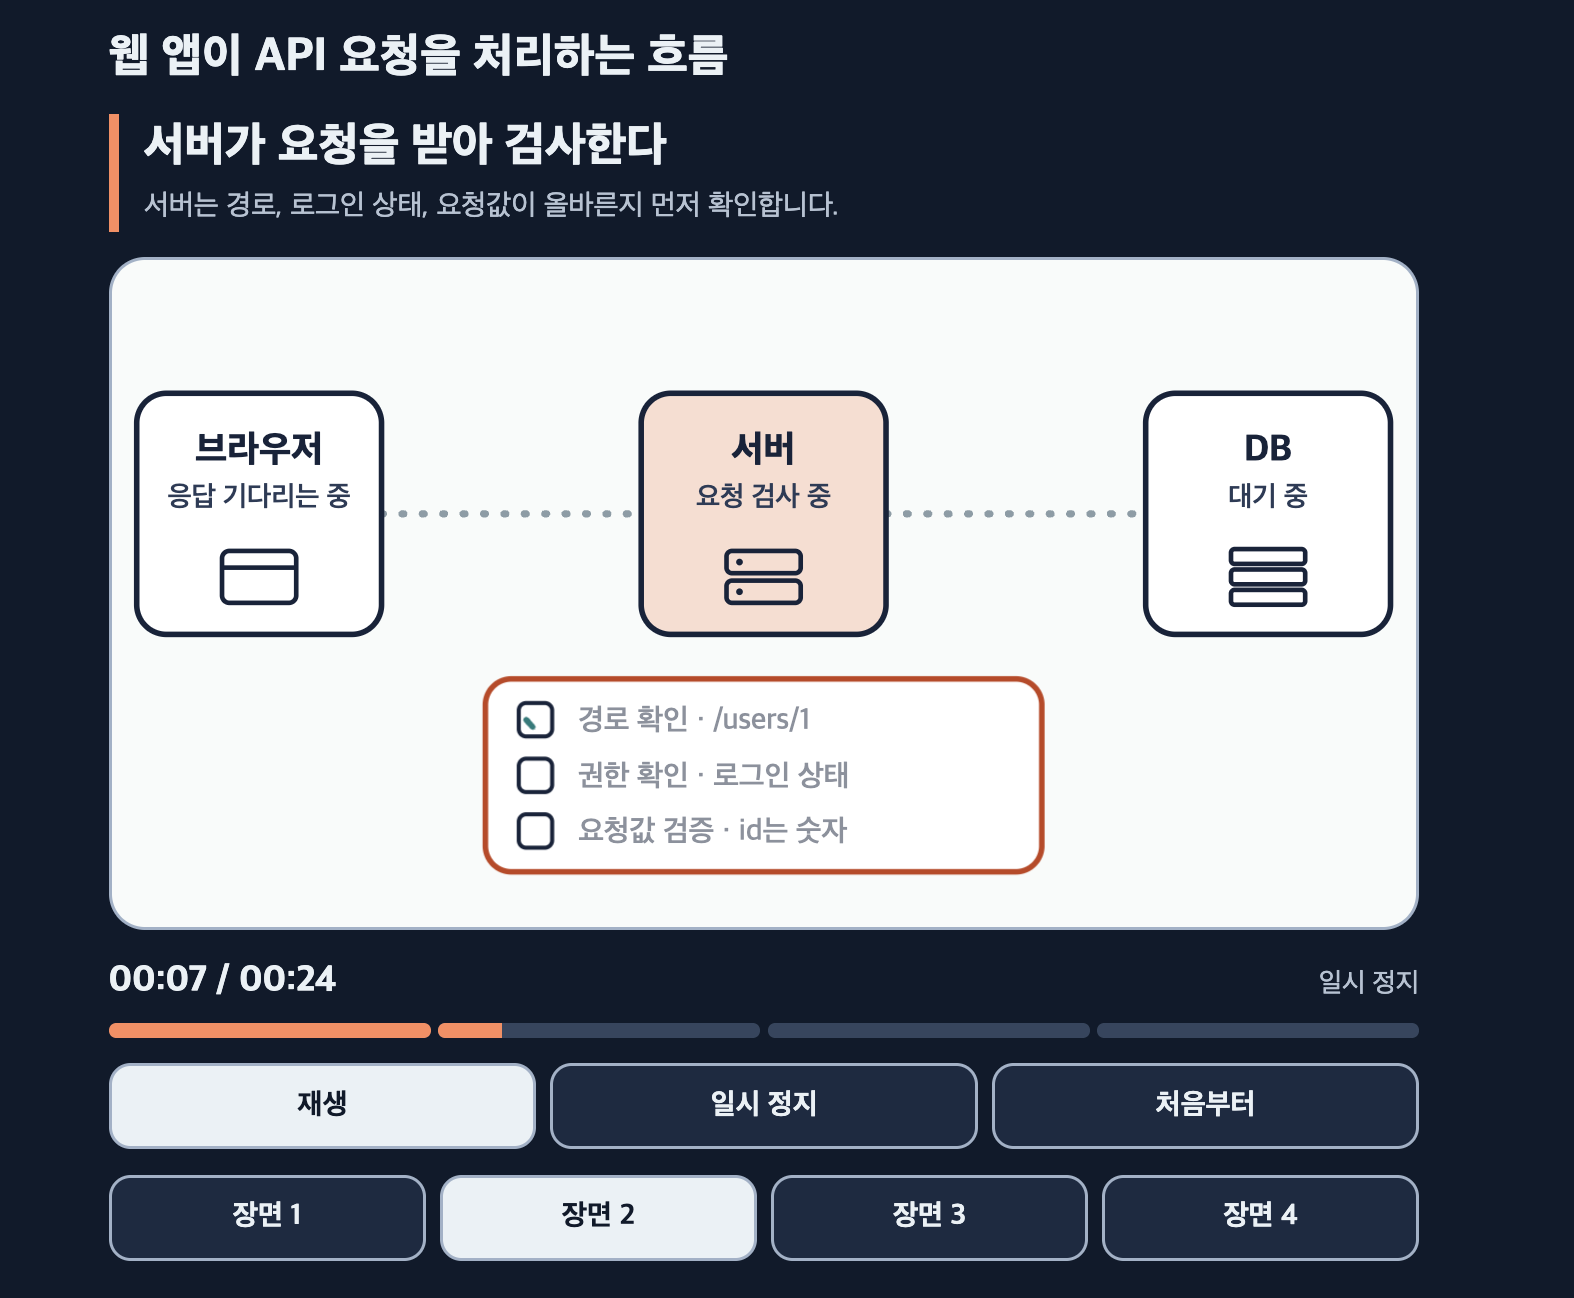
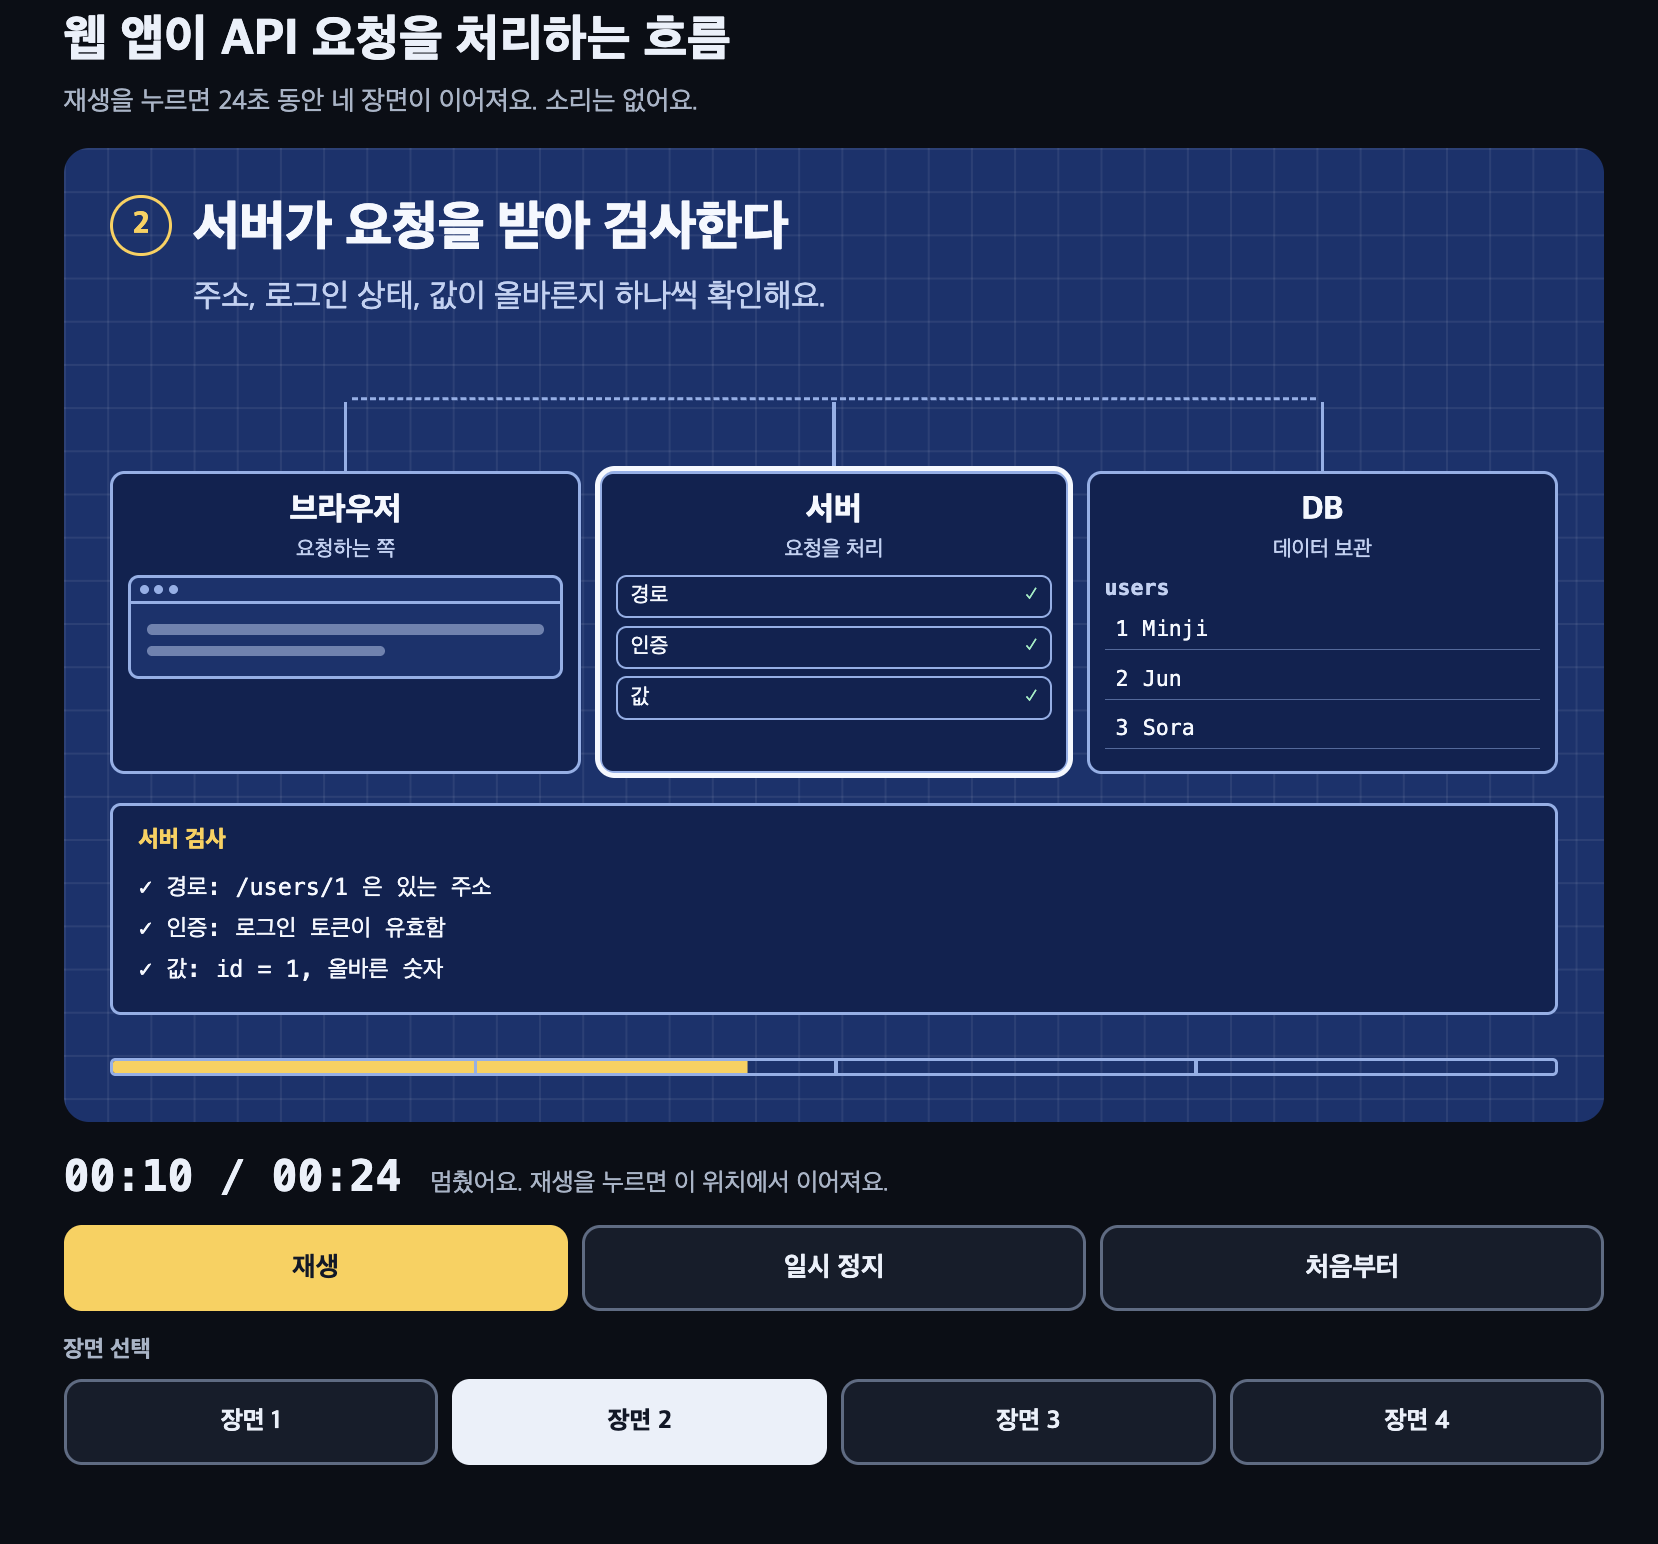
ex) 오퍼스 5.5 결과
- https://claude.ai/artifact/7iCrSfNU6nnMKdgnKCKHKX
| 사용 상황 | 판단 | 이유 |
|---|---|---|
| Claude Code를 매일 쓰는데 작업이 자주 끊긴다 | Pro 한 달 테스트 | 무료 채팅으로 답변 스타일을 먼저 본 다음, 실제 코드 작업과 공유 한도를 직접 확인할 수 있다. Pro의 Claude Code 기본 모델은 Opus로 바뀌었으니 /model로 Sonnet 5.5를 직접 골라 비교하자 |
| 짧은 질문과 문서 초안 정도만 필요하다 | 무료 채팅부터 | 처음부터 유료로 갈 근거가 아직 부족하다 |
| Pro를 거의 안 쓰거나 지금 도구로 충분하다 | 재구독 보류 | 점수가 좋아도 안 쓰면 구독료만 아깝다 |
| Pro 한도에 실제로 자주 걸린다 | 사용량을 기록한 뒤 Max 요금제 검토 | 한도 때문에 막힌 작업이 얼마짜리인지 따져 보고 Max 요금제를 정하자 |
| 이미 Opus 5.5를 잘 쓰고 있다 | 낮은 effort와 하위 에이전트용으로만 테스트 | HN에는 high 이상에서 Opus와 비용이 비슷해 보인다는 의견이 있었고, 공식 발표도 복잡한 작업은 Opus 5.5가 낫다고 적었다. |
| API로 제품이나 자동화에 연결한다 | 구독과 별도로 API 비용 테스트 | 토큰 요금, 재시도, 캐시 적중을 실제 호출 로그로 계산해야 한다 |
| 더 작고 싼 모델이 필요하다 | Haiku 5.5 공개를 기다려 본다 | Anthropic 발표문에 Haiku 5.5가 수주 안에 나온다고 적혀 있다. 가격과 성능은 아직 모른다 |
"재구독할 이유는 생겼지만, 모두에게 권할 데이터는 아직 없다"가 지금의 내 결론이다. Sonnet 5.5는 내 작업에 직접 써 보고 판단할 만한 업데이트다.
무료 채팅은 거의 비용 없이 답변 스타일을 볼 수 있다. Claude Code가 목적이라면 Pro를 한 달 쓰면서 평소 하던 작업 몇 개를 직접 시켜 보는 게 좋다.
Max 요금제는 Pro 한도가 확인된 병목일 때만 고려하자.
요금 페이지에는 Free에 Sonnet과 Haiku가 들어 있고 Opus는 없다고 나온다. 출시 당일 Simon Willison은 Sonnet 5.5가 claude.ai 무료 채팅의 모델이 됐다고 적었지만, 공식 발표문에는 요금제별 제공 여부가 없다. 내 화면의 모델 이름을 확인하는 게 가장 정확하다. Claude Code는 유료 요금제에서만 쓸 수 있다.
토큰 단가는 같다. Anthropic이 말한 "작업당 최대 30%"는 자체 테스트에서 토큰을 덜 쓴 결과이고, 실제 절감 폭은 재시도와 캐시 사용에 따라 달라진다.
아니다. Pro 사용량은 웹 채팅과 Claude Code가 같이 쓰고, 5시간 단위 한도와 주간 한도가 있다. 실제로 얼마나 쓸 수 있는지는 작업, 모델, 대화 길이에 따라 다르다.
모든 작업에서 그렇다고 볼 근거는 없다. 공식 발표도 복잡하고 판단이 오래 이어지는 일은 Opus 5.5가 분명히 낫다고 적었다. 같은 과제와 같은 설정으로 나란히 돌려 보자. 작업별로 어떻게 나눌지는 4장 표를 참고하면 된다.
앱에서는 고위험으로 분류된 요청이 눈에 보이게 Sonnet 5로 넘어간다. 정당한 보안 업무라면 사이버 검증 프로그램(Cyber Verification Program)을 쓰게 되는데, 지원 문서에 따르면 Sonnet 5.5는 출시 시점에 이 프로그램 대상이 아니고 곧 신청할 수 있게 될 예정이다. 넘어간 응답은 Sonnet 5 요금으로 따로 계산된다. HN에는 가입자도 걸린다는 불만이 있으니 내 작업으로 직접 확인해보자.
Anthropic 권장은 범위가 분명한 작업이면 Medium부터, 더 어렵고 긴 작업이면 High부터 시작하는 것이다. Sonnet 5에서 쓰던 값은 단계가 다시 조정됐으니 그대로 옮기지 말자. 높은 단계는 토큰과 시간을 더 쓰고, Sonnet 5.5의 FrontierCode에서는 Max가 Xhigh보다 낮게 나오기도 했다.
Claude Code v2.1.284 이상에서 /model sonnet으로 고른다. Pro, Max, Team, Enterprise의 기본 모델은 Opus 5.5라서 직접 골라야 한다. Anthropic API 계정이 아닌 Bedrock이나 Google Cloud에서는 별칭이 아직 Sonnet 4.6일 수 있으니 모델 ID를 확인하자.
한 줄 정리: Sonnet 5.5는 낮은 effort에서 싸고 빠르게 쓰는 모델이다. 결제는 점수가 아니라 내가 직접 써 본 결과로 정하자.
처음이라면 이 긴 글을 전부 따라 할 필요는 없다. 8장 게임 실습 하나, 또는 무료 채팅에서 자주 쓰는 질문 3개만 돌려 봐도 감은 충분히 온다.
감사합니다. : )
가격, 제품 구성, 사용량 한도는 지역과 시점에 따라 바뀔 수 있다. 구독하기 전에는 공식 요금 페이지와 앱의 현재 사용량 안내를 다시 확인하자.
소중한 공감 감사합니다