새소식
300x250
안녕하세요! 갓대희 입니다.
이번 포스팅은 [ GPT-6 Sol·Luna 출시와 모델 선택 기준 ] 입니다. : )
GPT-5.6 비교 글에서 Sol·Terra·Luna를 살펴본 데 이어, 최근에는 GPT-6 Astra도 따로 정리했다.
그리고 2026년 9월 22일, 드디어 GPT-6 Sol과 Luna까지 공개되면서 GPT-6 선택지가 세 가지로 늘었다.
가격은 GPT-5.6 대비 절반 수준으로 내려갔는데, 그럼 성능은 어떨까?
결론부터 말하면 “모든 점수가 올랐다”기보다 “같은 점수를 훨씬 싸게 낸다”에 가까운 업데이트다.
이번 포스팅에서는 세 모델의 역할과 가격, 공식 벤치마크, 정렬(안전성) 평가, 제품별 제공 범위를 살펴보고, 직접 비교해볼 수 있는 게임 실습까지 해보겠다.
타사 모델과의 순위 싸움보다는 같은 GPT-6 안에서 가격과 성능이 어떻게 갈리는지, GPT-5.6에서 넘어올 때 무엇이 달라지는지에 집중했다.
수치는 OpenAI 공식 발표, API 모델 문서와 가격표, Help Center 문서를 기준으로 했다.
OpenAI는 2026년 9월 22일 GPT-6 Sol과 GPT-6 Luna를 발표했다.
Astra를 넘어서는 새 최상위 모델이 추가된 것은 아니다.
OpenAI는 Astra를 여전히 가장 강력한 모델로 소개하고, Sol과 Luna는 Astra와 비슷한 방식으로 학습해 더 빠르고 저렴하게 만든 모델로 설명한다.
쉽게 말해, 모든 요청을 비싼 모델 하나에 맡기기보다 작업 난도와 실수했을 때의 부담에 따라 골라 쓰자는 구성이다.
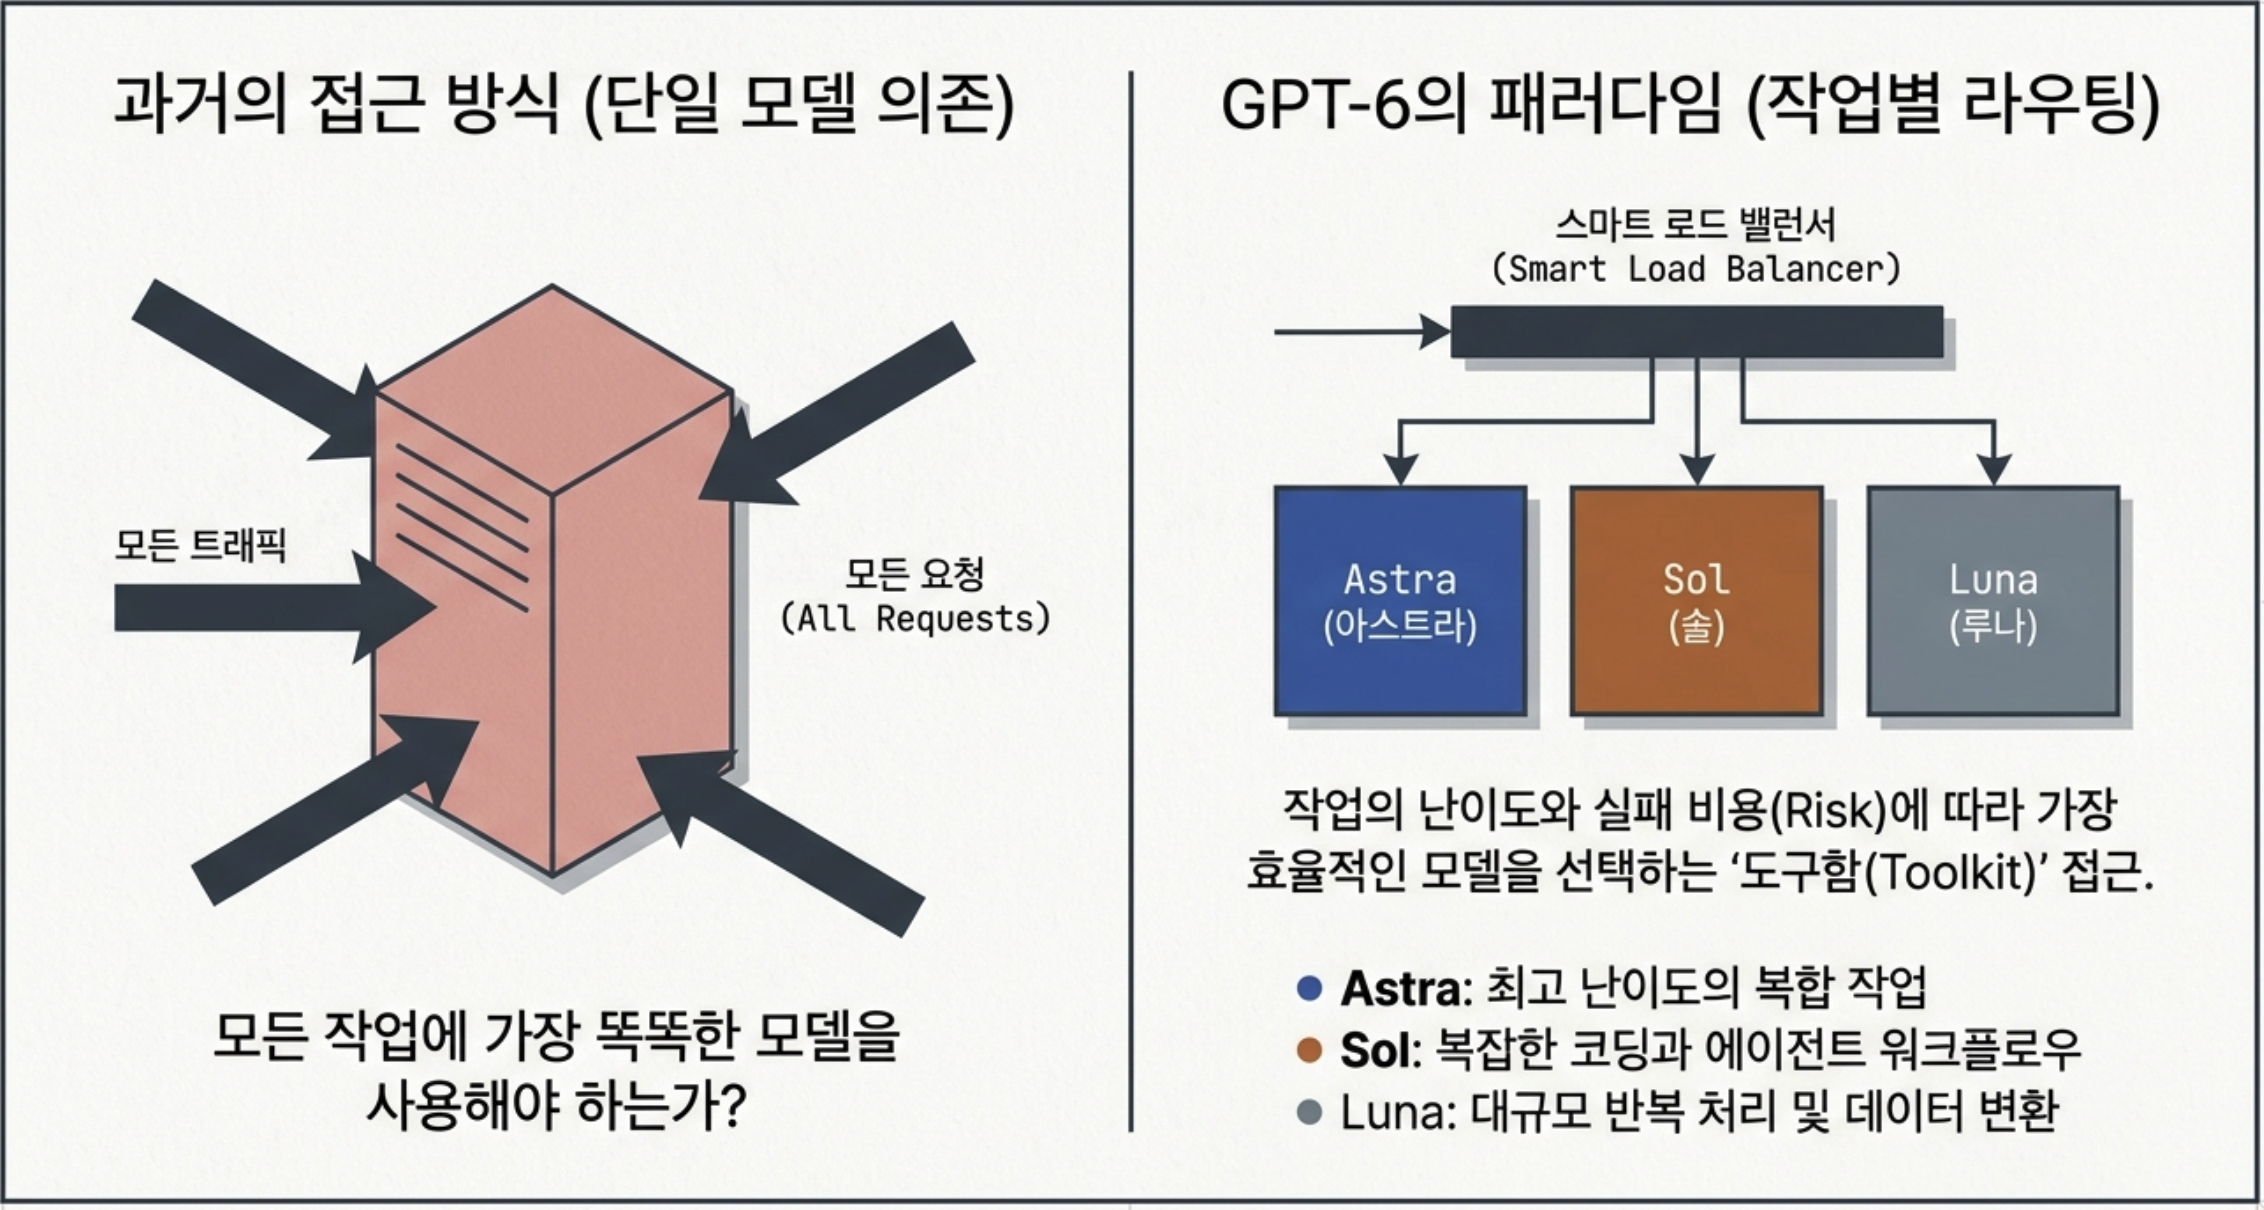
이번 발표에서 바뀐 것은 크게 네 가지다.
공식 발표에 나온 개발 사례
OpenAI는 카드형 타일 배치(Bento Box)와 페이지 전환 슬라이더를 넣어달라는 같은 요청을 GPT-5.6 Sol과 GPT-6 Sol에 줬다.
발표에 따르면 GPT-6 Sol은 작업 계획을 먼저 밝히고, React(화면 개발 라이브러리)가 정말 필요한지 확인한 뒤 데스크톱·모바일 화면과 브라우저 뒤로 가기까지 점검했다고 보고했다.
반면 GPT-5.6 Sol은 “bento feel” 같은 모호한 표현을 쓰고, 필요 없는 이미지 생성 프롬프트까지 늘어놓았다. OpenAI도 스타일은 주관적이라고 전제하면서 GPT-6 Sol 쪽을 선호한다고 밝혔다.
눈여겨볼 점은 결과 화면보다 “무엇을 확인했고 무엇은 확인하지 않았는지”를 보고하는 방식이다.
다만 OpenAI가 고른 데모이니, 우리 프로젝트에서는 테스트 통과 여부와 화면 크기별 레이아웃, 키보드 접근성을 직접 확인해야 한다.
→ OpenAI 발표의 GPT-5.6 Sol·GPT-6 Sol 작업 예시 보기이전 글과 이어 읽기
GPT-5.6에서 Sol·Terra·Luna라는 역량 계층이 처음 소개된 배경과 초기 비교는 이전 글에 정리했다.
GPT-6 Astra의 작업 방식과 한계는 별도 리뷰를 함께 보면 이번 라인업의 변화가 더 잘 보인다.
→ GPT-5.6 Sol·Terra·Luna 비교 글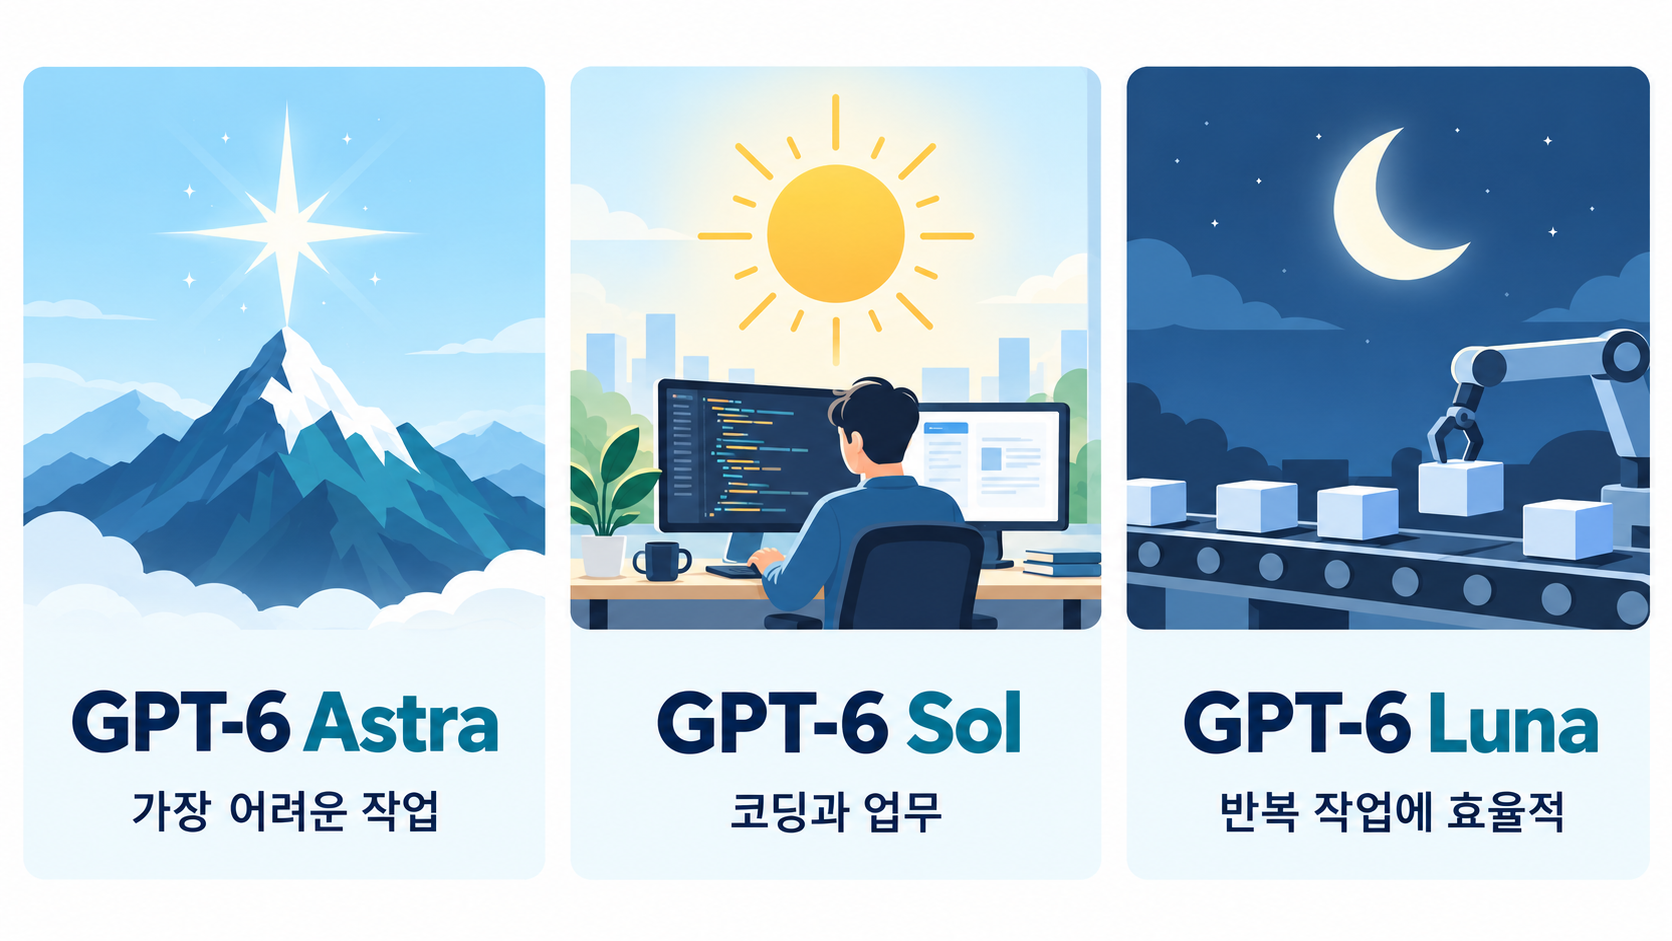
GPT-5.6 발표에서 OpenAI는 숫자가 모델 세대를, Sol·Terra·Luna가 각자 다른 속도로 발전할 수 있는 역량 계층을 뜻한다고 설명했다.
GPT-6에서도 이 체계가 이어지지만, 발표에 등장한 이름은 Astra·Sol·Luna다.
중간 계층이던 Terra는 GPT-6 발표에 포함되지 않았다.
9to5Mac은 이를 Luna(소)·Sol(대)·Astra(특대)의 3단 구성으로 정리된 것으로 해석했지만, OpenAI가 Terra 종료나 향후 일정을 공식 발표한 것은 아니다. 추측보다는 API 모델 목록을 확인하는 편이 맞다.
GPT-6 = 세대, Astra / Sol / Luna = 역량 계층.
Astra는 별, Sol은 태양, Luna는 달을 뜻한다. 이름은 기억하기 쉽지만, 공식적인 성능 순위를 이름의 의미만으로 판단해서는 안 된다.
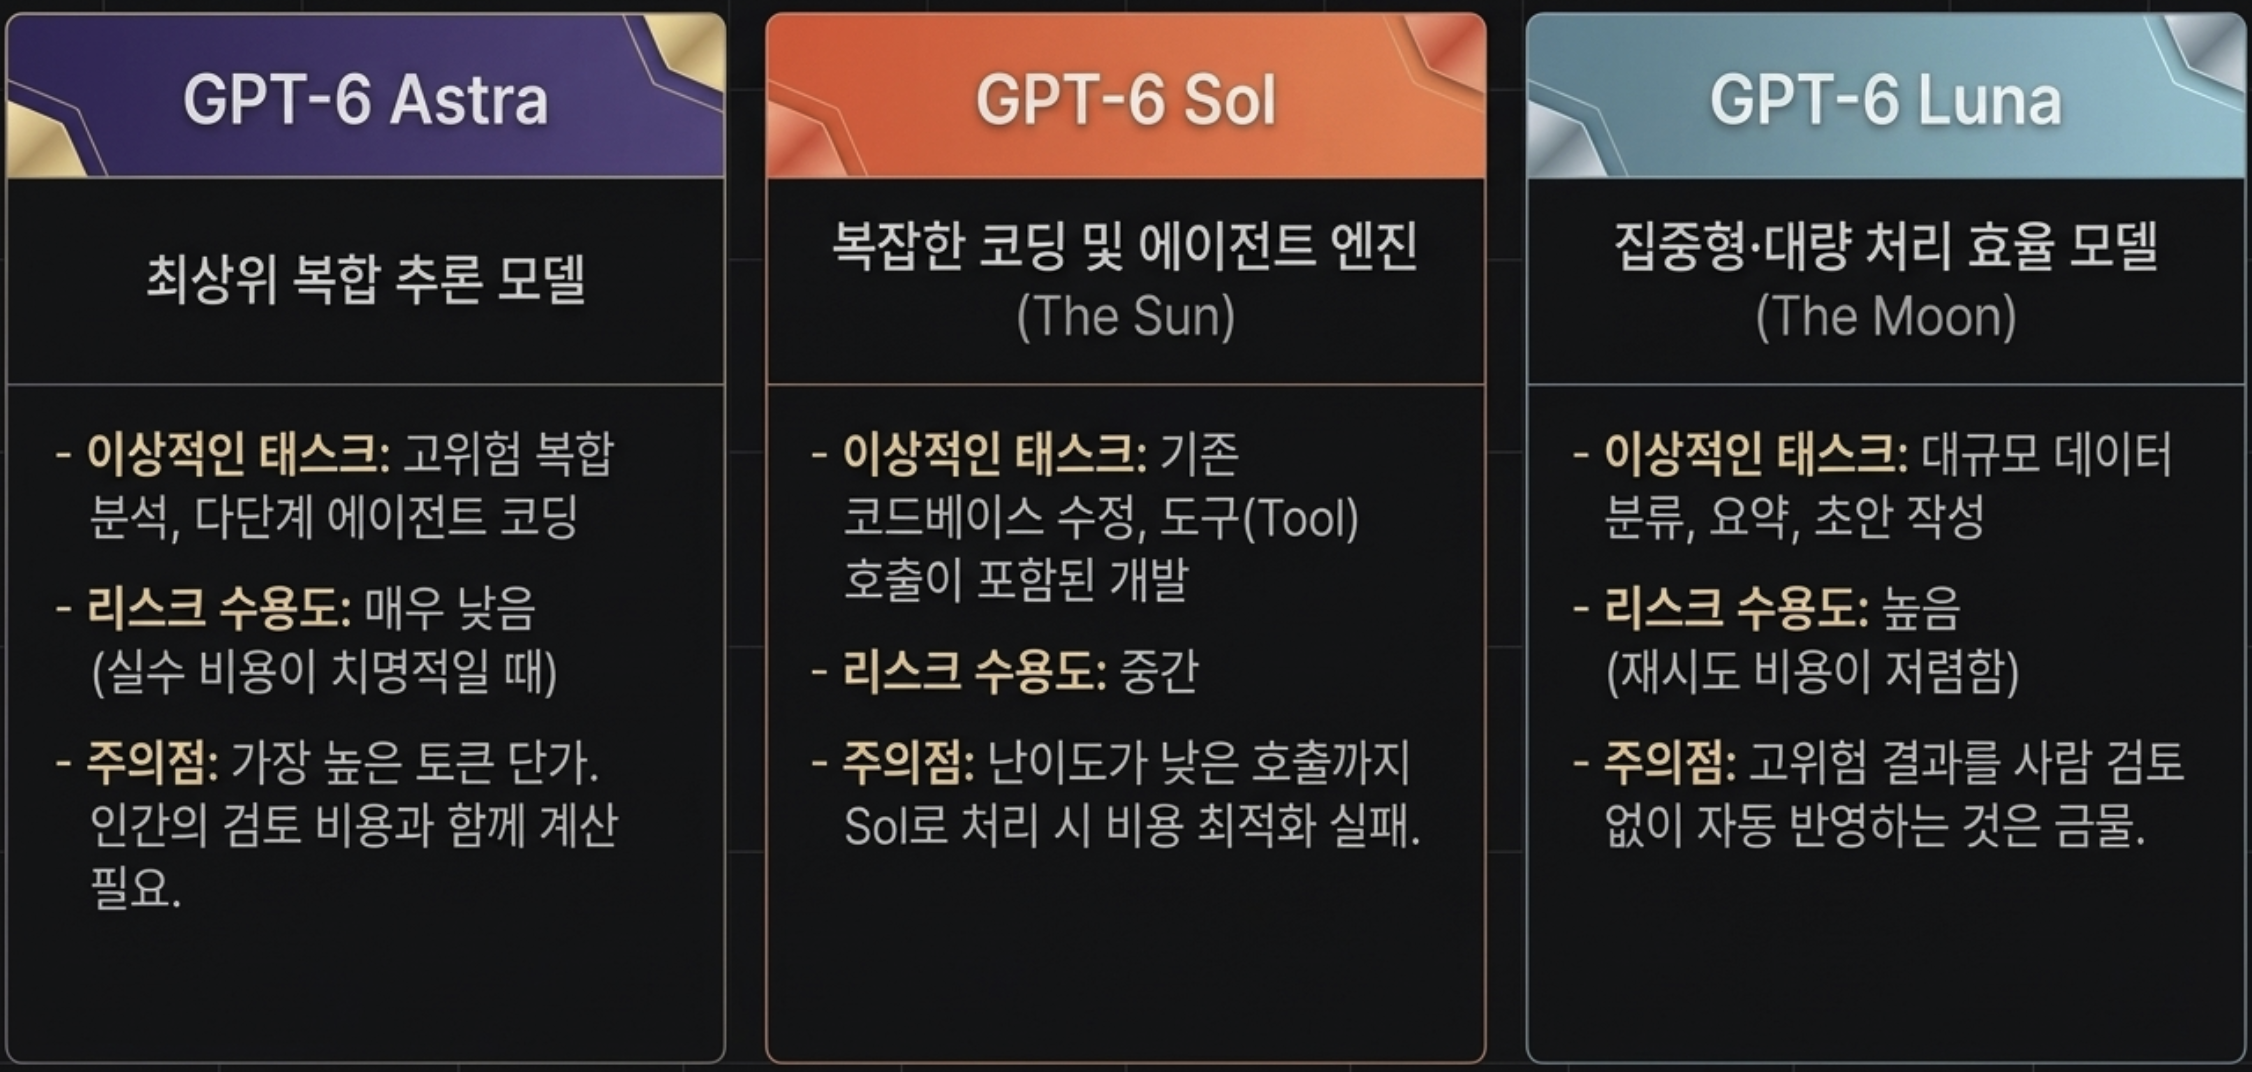
세 모델은 단순한 등급표라기보다 난도와 비용에 따라 골라 쓰는 도구에 가깝다.
“어느 모델이 무조건 1등인가?”보다 “이 작업에서 필요한 품질을 어느 비용으로 얻을 수 있나?”를 먼저 물어보자.
| 모델 | 공식 설명을 바탕으로 한 선택 가이드 | 처음 시험해볼 작업 | 주의할 점 |
|---|---|---|---|
| GPT-6 Astra | 컴퓨터 사용·브라우징·SW 엔지니어링까지 최대 성능을 내는 플래그십 | 복잡한 분석, 여러 단계를 거치는 코딩·컴퓨터 사용 | 토큰 단가가 가장 높다. 추론 강도 none을 지원하지 않는다. |
| GPT-6 Sol | 까다로운 작업을 더 효율적으로 처리하는 추론 모델 | 기존 코드베이스 수정, 테스트와 도구 사용이 포함된 개발 업무 | 난도가 낮은 호출까지 Sol로 처리하면 비용 이점이 줄어든다. |
| GPT-6 Luna | 반복 가능한 작업을 대규모로 처리하는 효율 모델 | 분류, 요약, 반복 데이터 변환과 초안 작성 | 낮은 추론 강도에서는 에이전트 작업 성능이 급격히 떨어진다. |
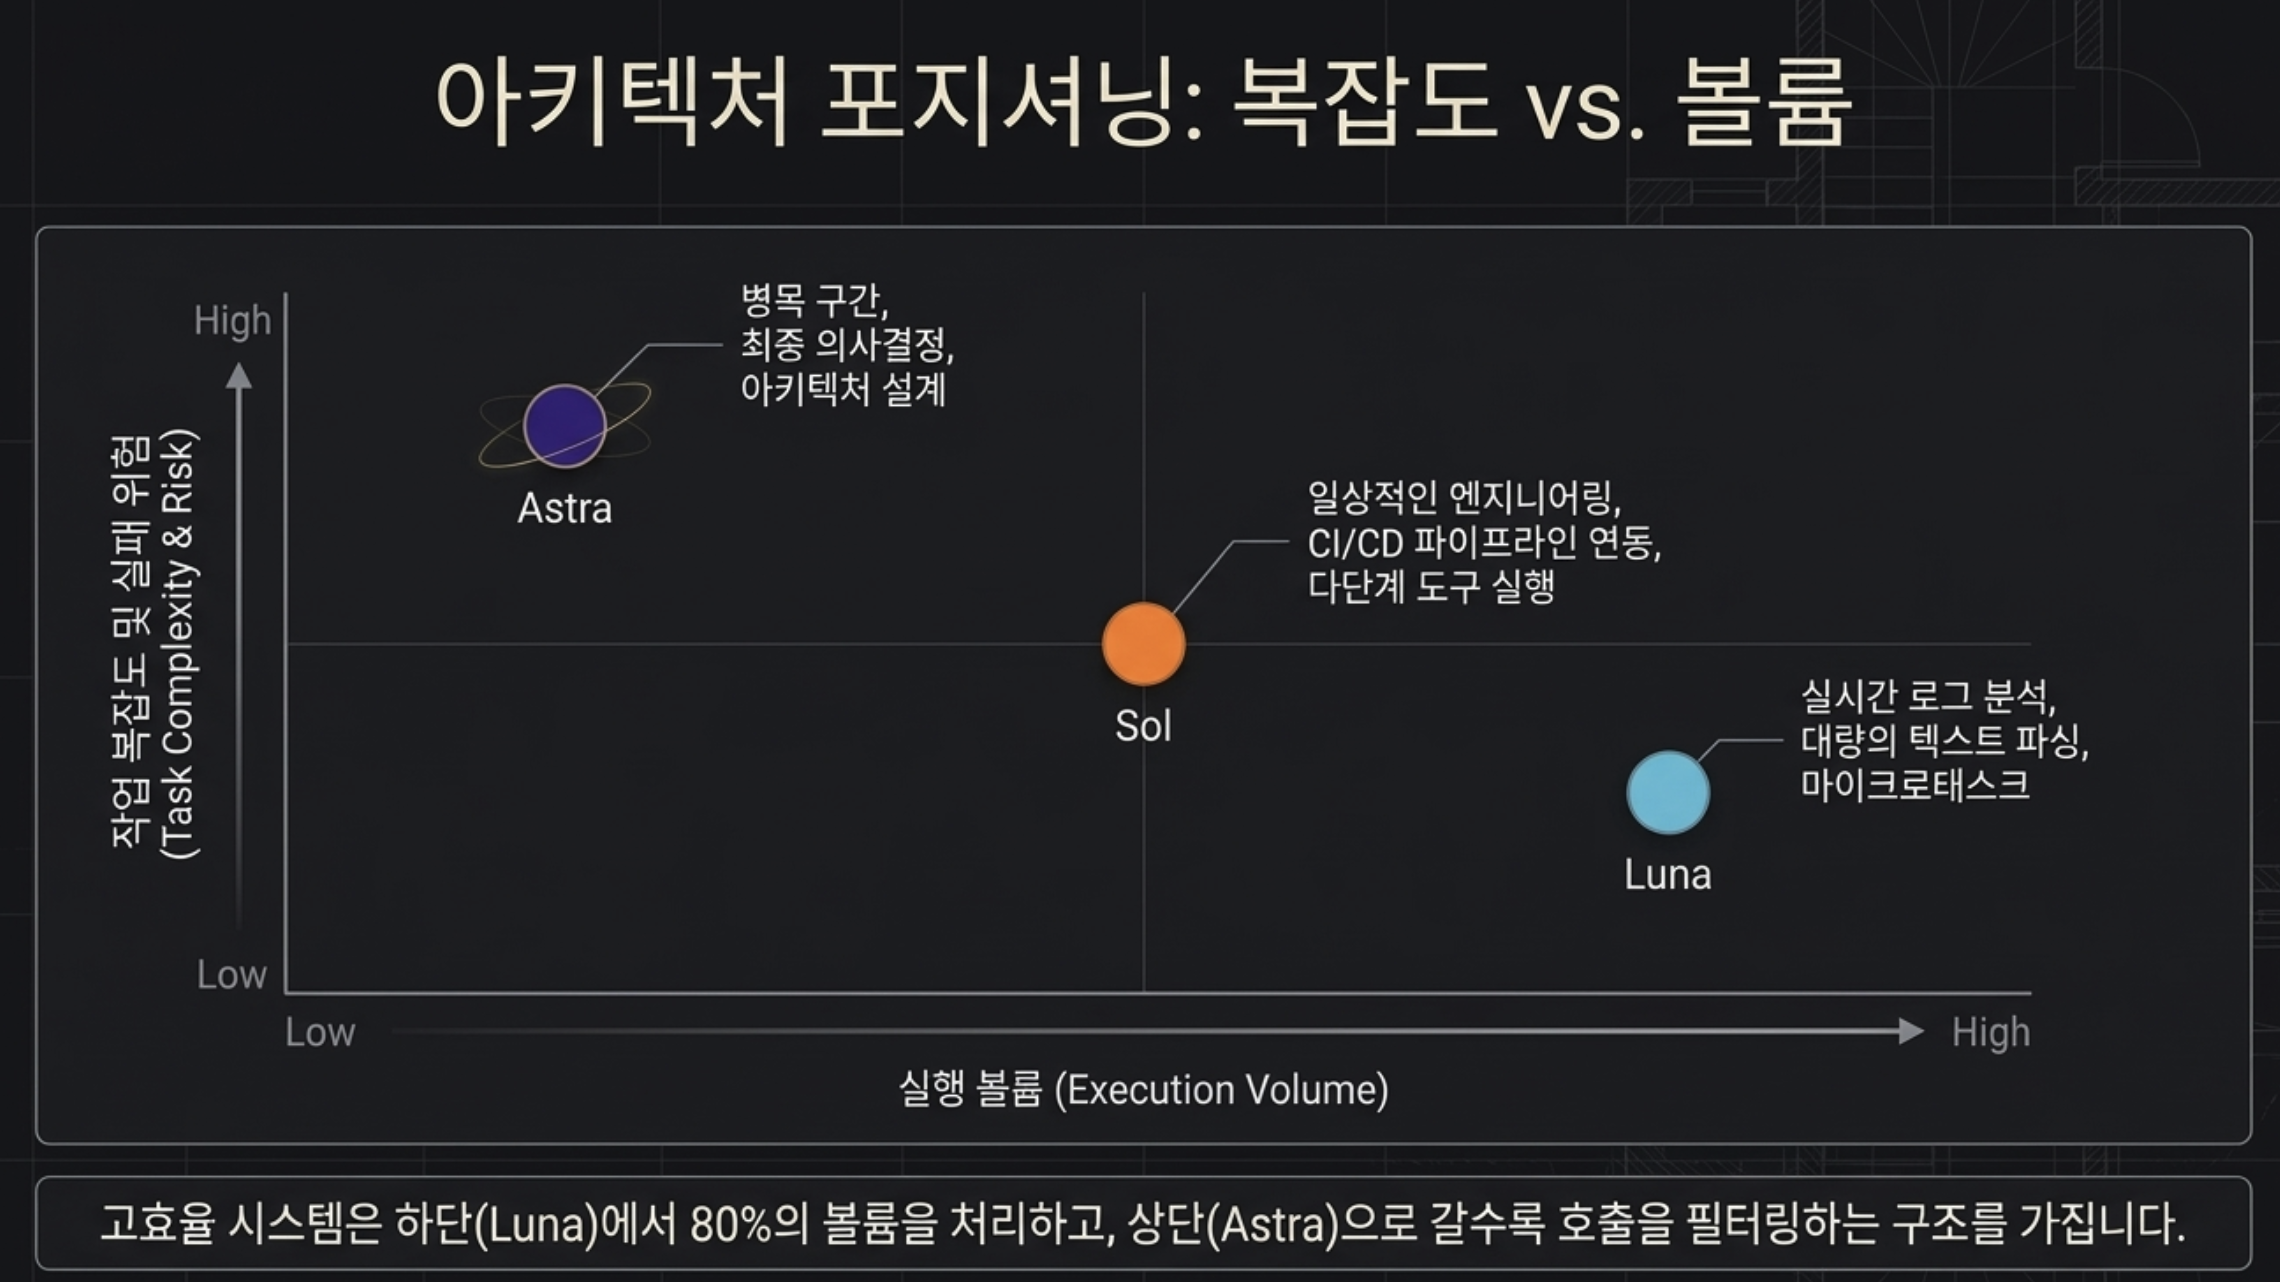
참고로 “에이전트 작업”은 모델만으로 완성되지 않는다. 파일·브라우저·터미널 같은 도구, 접근 권한, 반복 실행과 결과 검증까지 갖춰져야 한다.
Sol과 Luna의 API 모델 문서를 기준으로 개발자가 알아둘 스펙을 정리했다. ChatGPT에서만 쓸 계획이라면 이 표는 건너뛰어도 된다.
| 항목 | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| 모델 ID | gpt-6-sol |
gpt-6-luna |
| 컨텍스트 / 최대 출력 | 105만 / 12.8만 토큰 | 105만 / 12.8만 토큰 |
| 지식 기준일 | 2026-04-20 | 2026-05-18 |
| 추론 강도 | none / low / medium(기본값) / high / xhigh / max |
|
| 입력 / 출력 | 텍스트·이미지 입력 / 텍스트 출력 (오디오·비디오 미지원) | |
| Tier 1 사용량 한도 | 분당 500 요청, 분당 50만 토큰 | |
| 파인튜닝 | 미지원 | |
OpenAI API 변경 기록에 따르면 2026년 9월 25일 GPT-6 Sol과 Luna의 이미지 인코딩 문제를 수정했다.
출시 직후 이미지 입력을 시험했다면 지금 버전으로 다시 돌려보는 편이 안전하다. 텍스트 평가 수치가 바뀌었다는 뜻은 아니다. (공식 API 변경 기록)
Luna의 지식 기준일이 Sol보다 한 달쯤 더 최근이라는 점은 의외다.
다만 최신 라이브러리 버전이나 정책을 묻는 작업이라면 기준일 차이보다 웹 검색 도구 연결 여부가 결과를 더 크게 좌우한다.

아래 가격은 2026년 9월 말 기준 OpenAI API 표준 처리(Standard), 입력 27만 2천 토큰 이하 구간이다.
입력과 출력 각각 토큰 100만 개당 미국 달러로 표시했으며, ChatGPT 월 구독료와는 별개다.
| 모델 | 입력 | 캐시 입력 | 출력 | GPT-5.6 대비 |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $1.00 | $50.00 | 신규 최상위 계층 |
| GPT-6 Sol | $2.00 | $0.20 | $10.00 | GPT-5.6 Sol $4 / $20에서 50% 인하 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | GPT-5.6 Luna $0.20 / $1.20에서 입력 50%, 출력 약 58% 인하 |
가격 흐름을 빠르게 보고 싶다면 아래 그림도 함께 보면 된다.
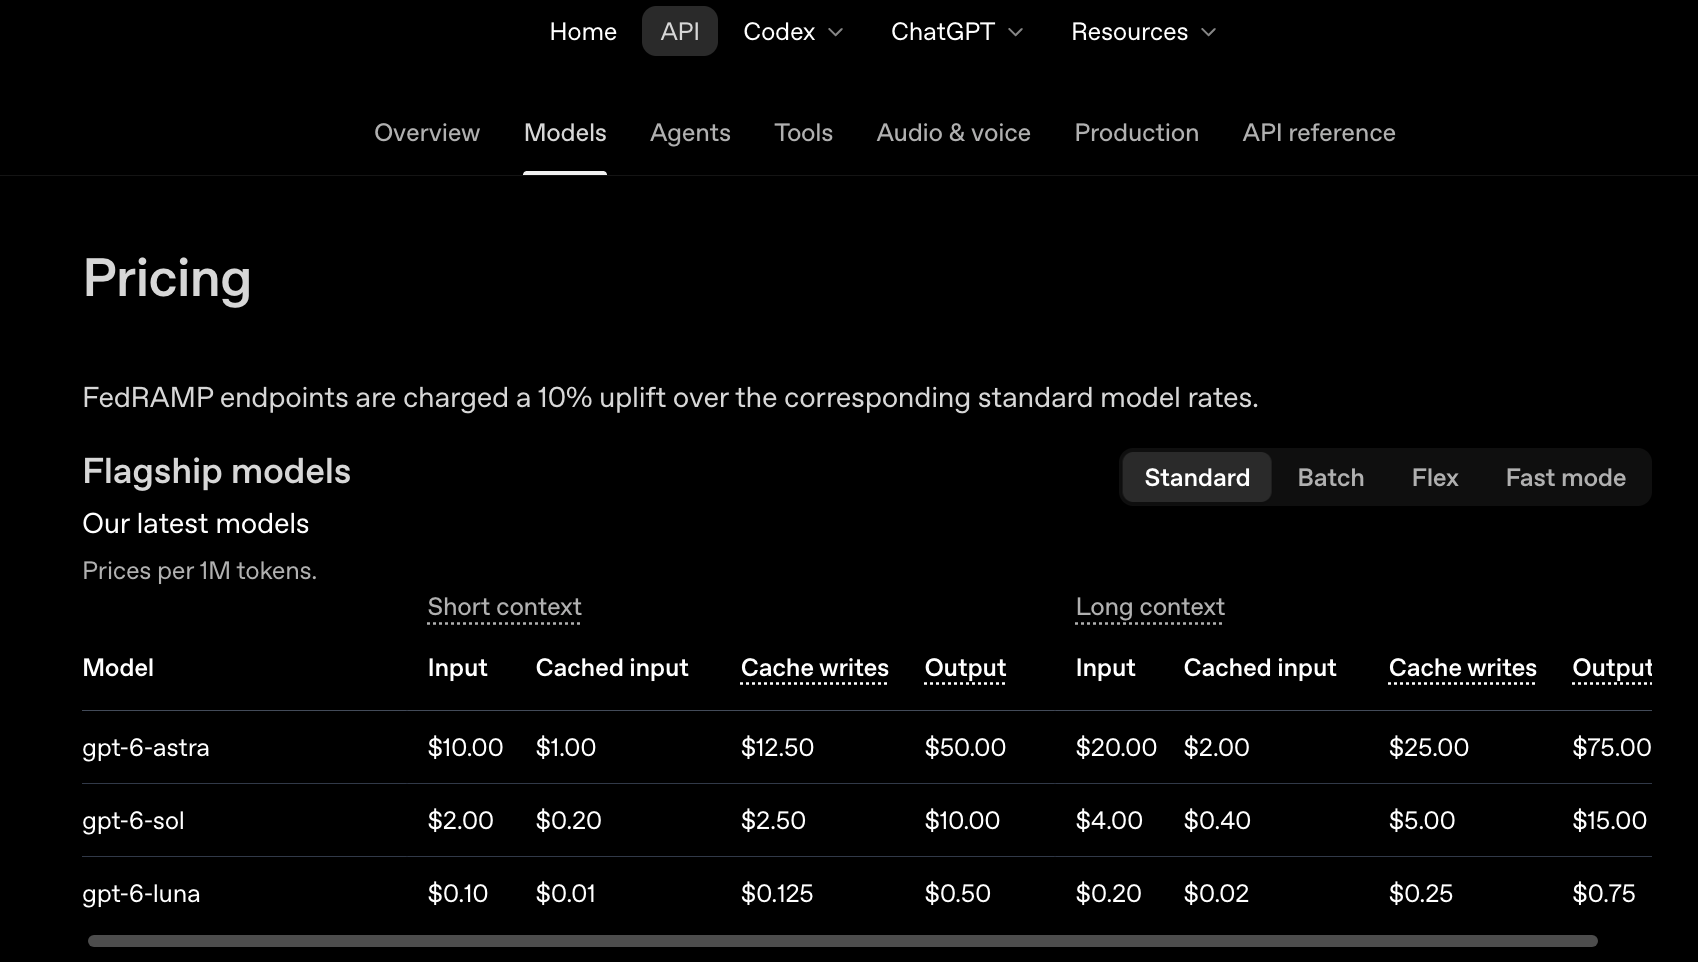
그림의 Input price(입력 가격), Output price(출력 가격), Standard processing(표준 처리)은 토큰 100만 개당 짧은 입력 구간(27만 2천 토큰 이하)의 API 요금이다. (참고: 최신 공식 가격표)
GPT-6 Luna는 입력과 출력 모두 Sol의 20분의 1, Astra의 100분의 1 가격이다.
그렇다고 모든 업무의 총비용이 같은 비율로 줄어든다는 뜻은 아니다. 재시도 횟수, 입력 길이, 출력 토큰 수, 캐시 적중, 도구 호출 비용에 따라 한 작업의 총비용은 달라진다.
OpenAI 발표는 Sol과 Luna 모두 “50% 인하”로 요약하지만, 표처럼 Luna의 출력 가격은 실제로 약 58% 내려갔다.
GPT-5.6 글(7월 10일 기준)에서는 Sol $5/$30, Luna $1/$6이라고 소개했다. 그 사이 GPT-5.6 가격이 두 번 내려갔기 때문에 이번 표의 “이전 가격”과 다르다.
GPT-5.6 출시 당시 가격과 비교하면 차이는 더 크다. Sol은 입력 60%, 출력 약 67% 싸졌고, Luna는 입력 90%, 출력 약 92% 싸졌다.
참고로 8월 인하 공지에서도 Plus·Pro·Business 구독의 사용량은 바뀌지 않는다고 밝혔다. API 단가 인하가 ChatGPT 구독료나 사용 한도에 그대로 반영되는 건 아니다.

같은 모델이라도 어떤 방식으로 호출하느냐에 따라 가격이 꽤 달라진다.
한 줄로 줄이면, 급하지 않은 대량 작업은 Batch로 절반 가격에, 빨리 받아야 하는 작업은 Fast mode로 두 배 가격에 처리하는 구조다.
| 처리 방식 (입력 / 출력) | Astra | Sol | Luna |
|---|---|---|---|
| Standard, 27만 2천 토큰 초과 | $20 / $75 | $4 / $15 | $0.20 / $0.75 |
| Batch (비동기 일괄 처리) | $5 / $25 | $1 / $5 | $0.05 / $0.25 |
| Flex (느려도 되는 작업) | $10 / $37.50 | $2 / $7.50 | $0.10 / $0.375 |
| Fast mode (속도 우선) | $20 / $100 | $4 / $20 | $0.20 / $1.00 |
| 캐시 쓰기 (짧은 입력) | $12.50 | $2.50 | $0.125 |

한 번의 입력이 27만 2천 토큰을 넘으면 요청 전체에 입력·캐시 2배, 출력 1.5배 요금이 붙는다. 105만 토큰 컨텍스트를 꽉 채워 쓰는 RAG나 코드베이스 분석이라면 이 구간부터 계산해야 한다.
캐시를 처음 만들 때는 일반 입력보다 25% 비싼 캐시 쓰기 요금이 들고, 이후 읽기에서 90% 할인을 받는 구조다. 재사용이 거의 없는 프롬프트라면 오히려 손해일 수 있다.
숫자만 보면 감이 잘 안 온다. 가상의 사내 챗봇 하나로 계산해보자.
요청 1건당 입력 2만 토큰(이 중 1만 6천 토큰은 캐시 적중), 출력 2천 토큰, 한 달 1,000건을 가정했다.
캐시 쓰기 비용은 단순화를 위해 제외했다.
| 모델 | 1건당 계산 | 월 1,000건 |
|---|---|---|
| GPT-6 Astra | $0.040 + $0.016 + $0.100 | 약 $156 |
| GPT-6 Sol | $0.008 + $0.0032 + $0.020 | 약 $31 |
| GPT-6 Luna | $0.0004 + $0.00016 + $0.001 | 약 $1.6 |
계산식은 (일반 입력 4천 토큰) + (캐시 입력 1만 6천 토큰) + (출력 2천 토큰) 순서다.
이 정도면 싸 보이지만, 코딩 에이전트는 얘기가 다르다.
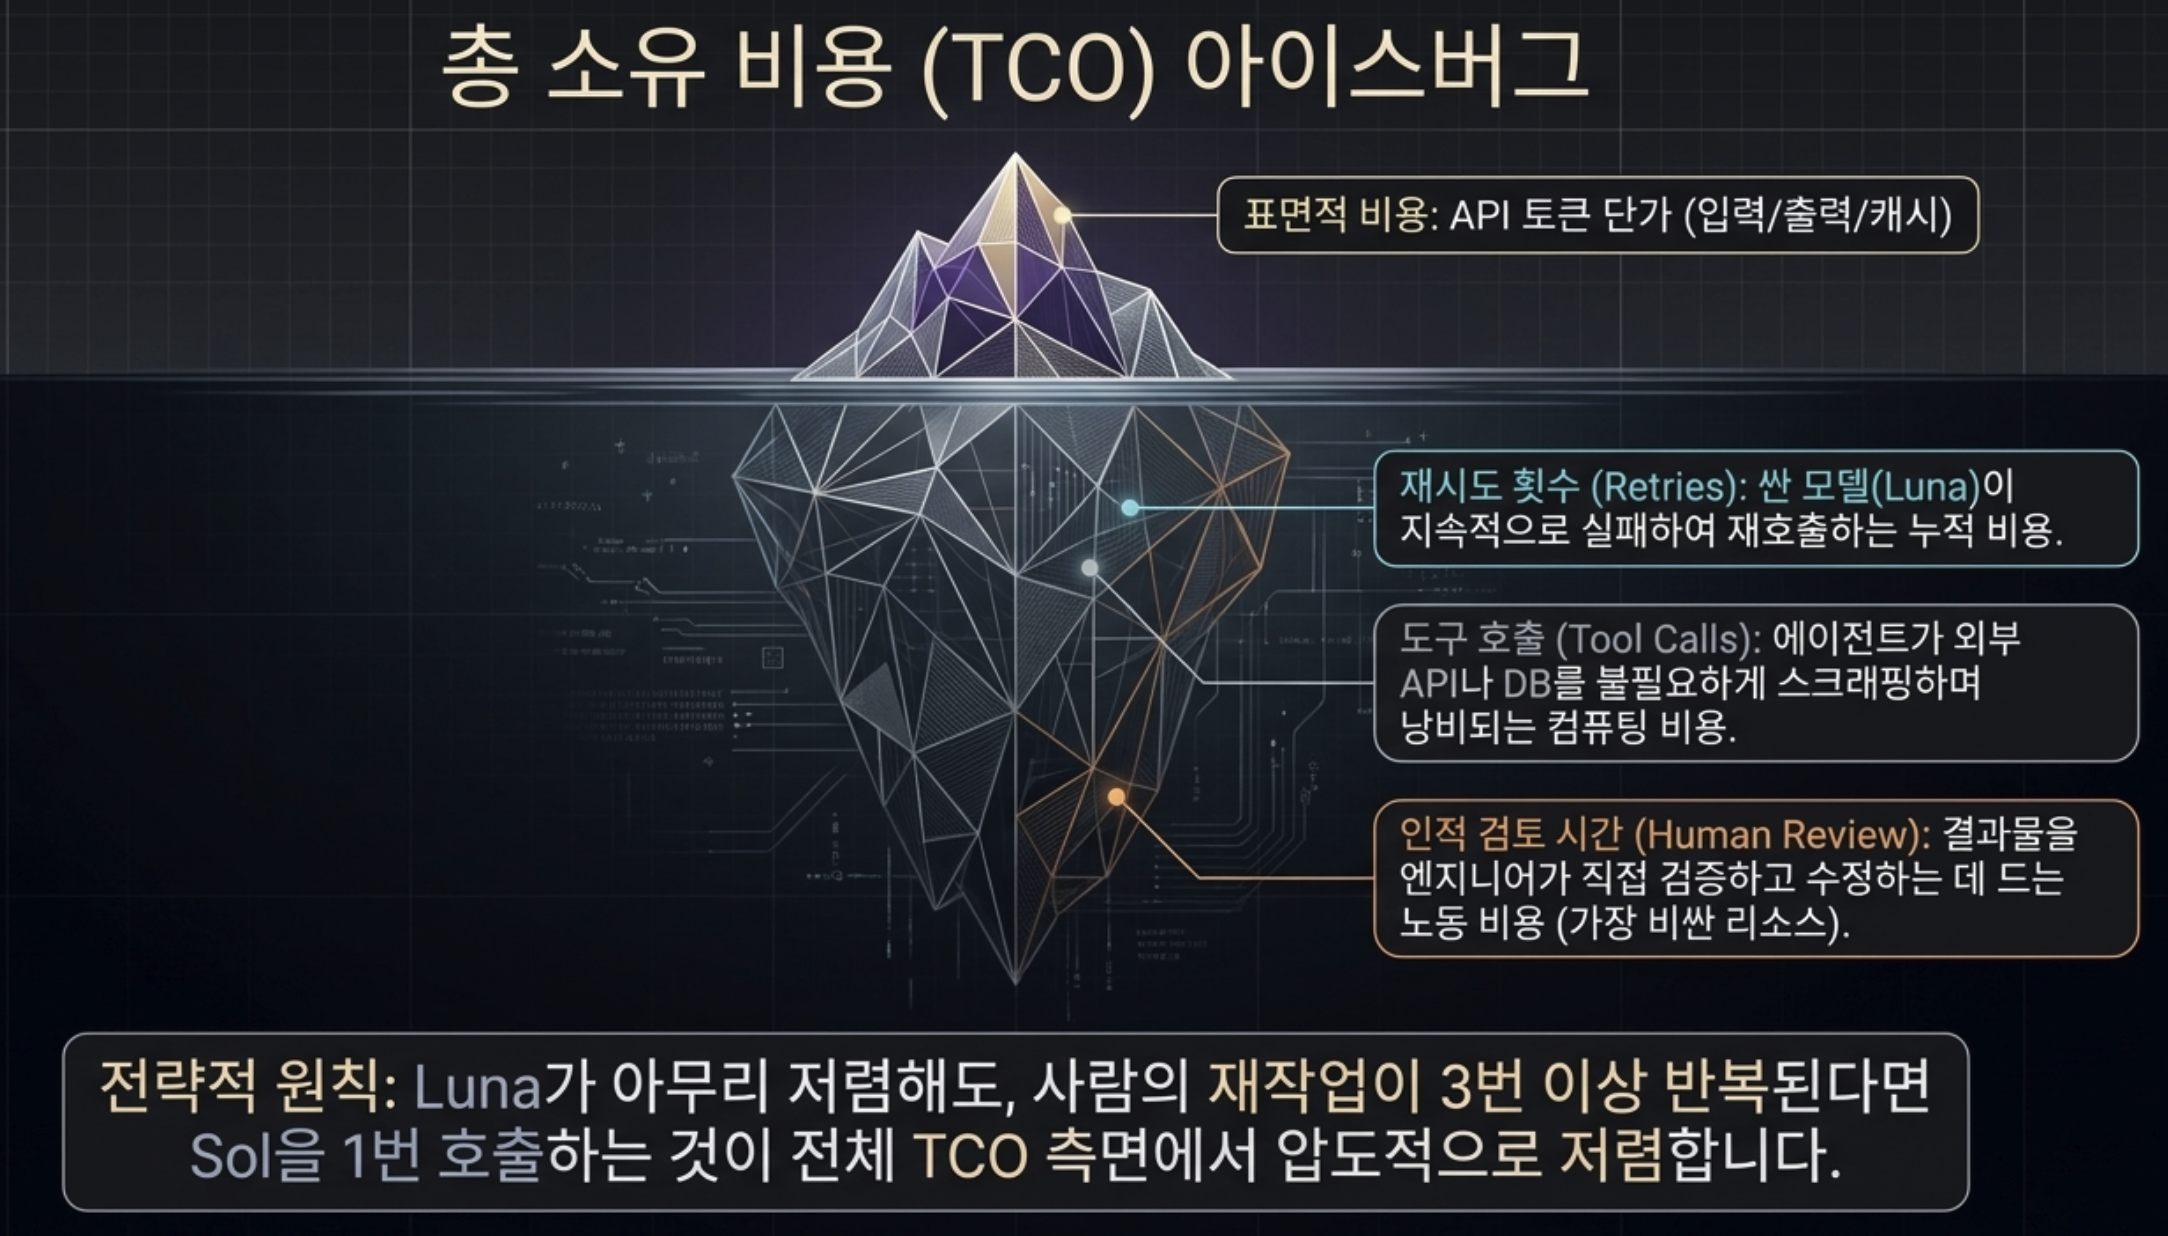
OpenAI는 자사 연구원의 하루 토큰 사용량을 API 가격으로 환산하면 중앙값이 $600, 상위 10%는 $7,000를 넘는다고 밝혔다.
에이전트를 오래 돌릴수록 단가 차이가 곧 비용 차이가 된다.
주의할 점은 추론 모델의 “생각”에 쓰인 토큰도 출력 토큰으로 과금된다는 것이다.
추론 강도를 올리면 화면에 보이는 답은 짧아도 출력 비용이 몇 배로 늘 수 있으니, 위 계산은 대략적인 비교 수치 정도로만 보자.
가격 인하와 함께 OpenAI는 같은 날 GPT-6용 프롬프트 캐싱 개선도 따로 발표했다.
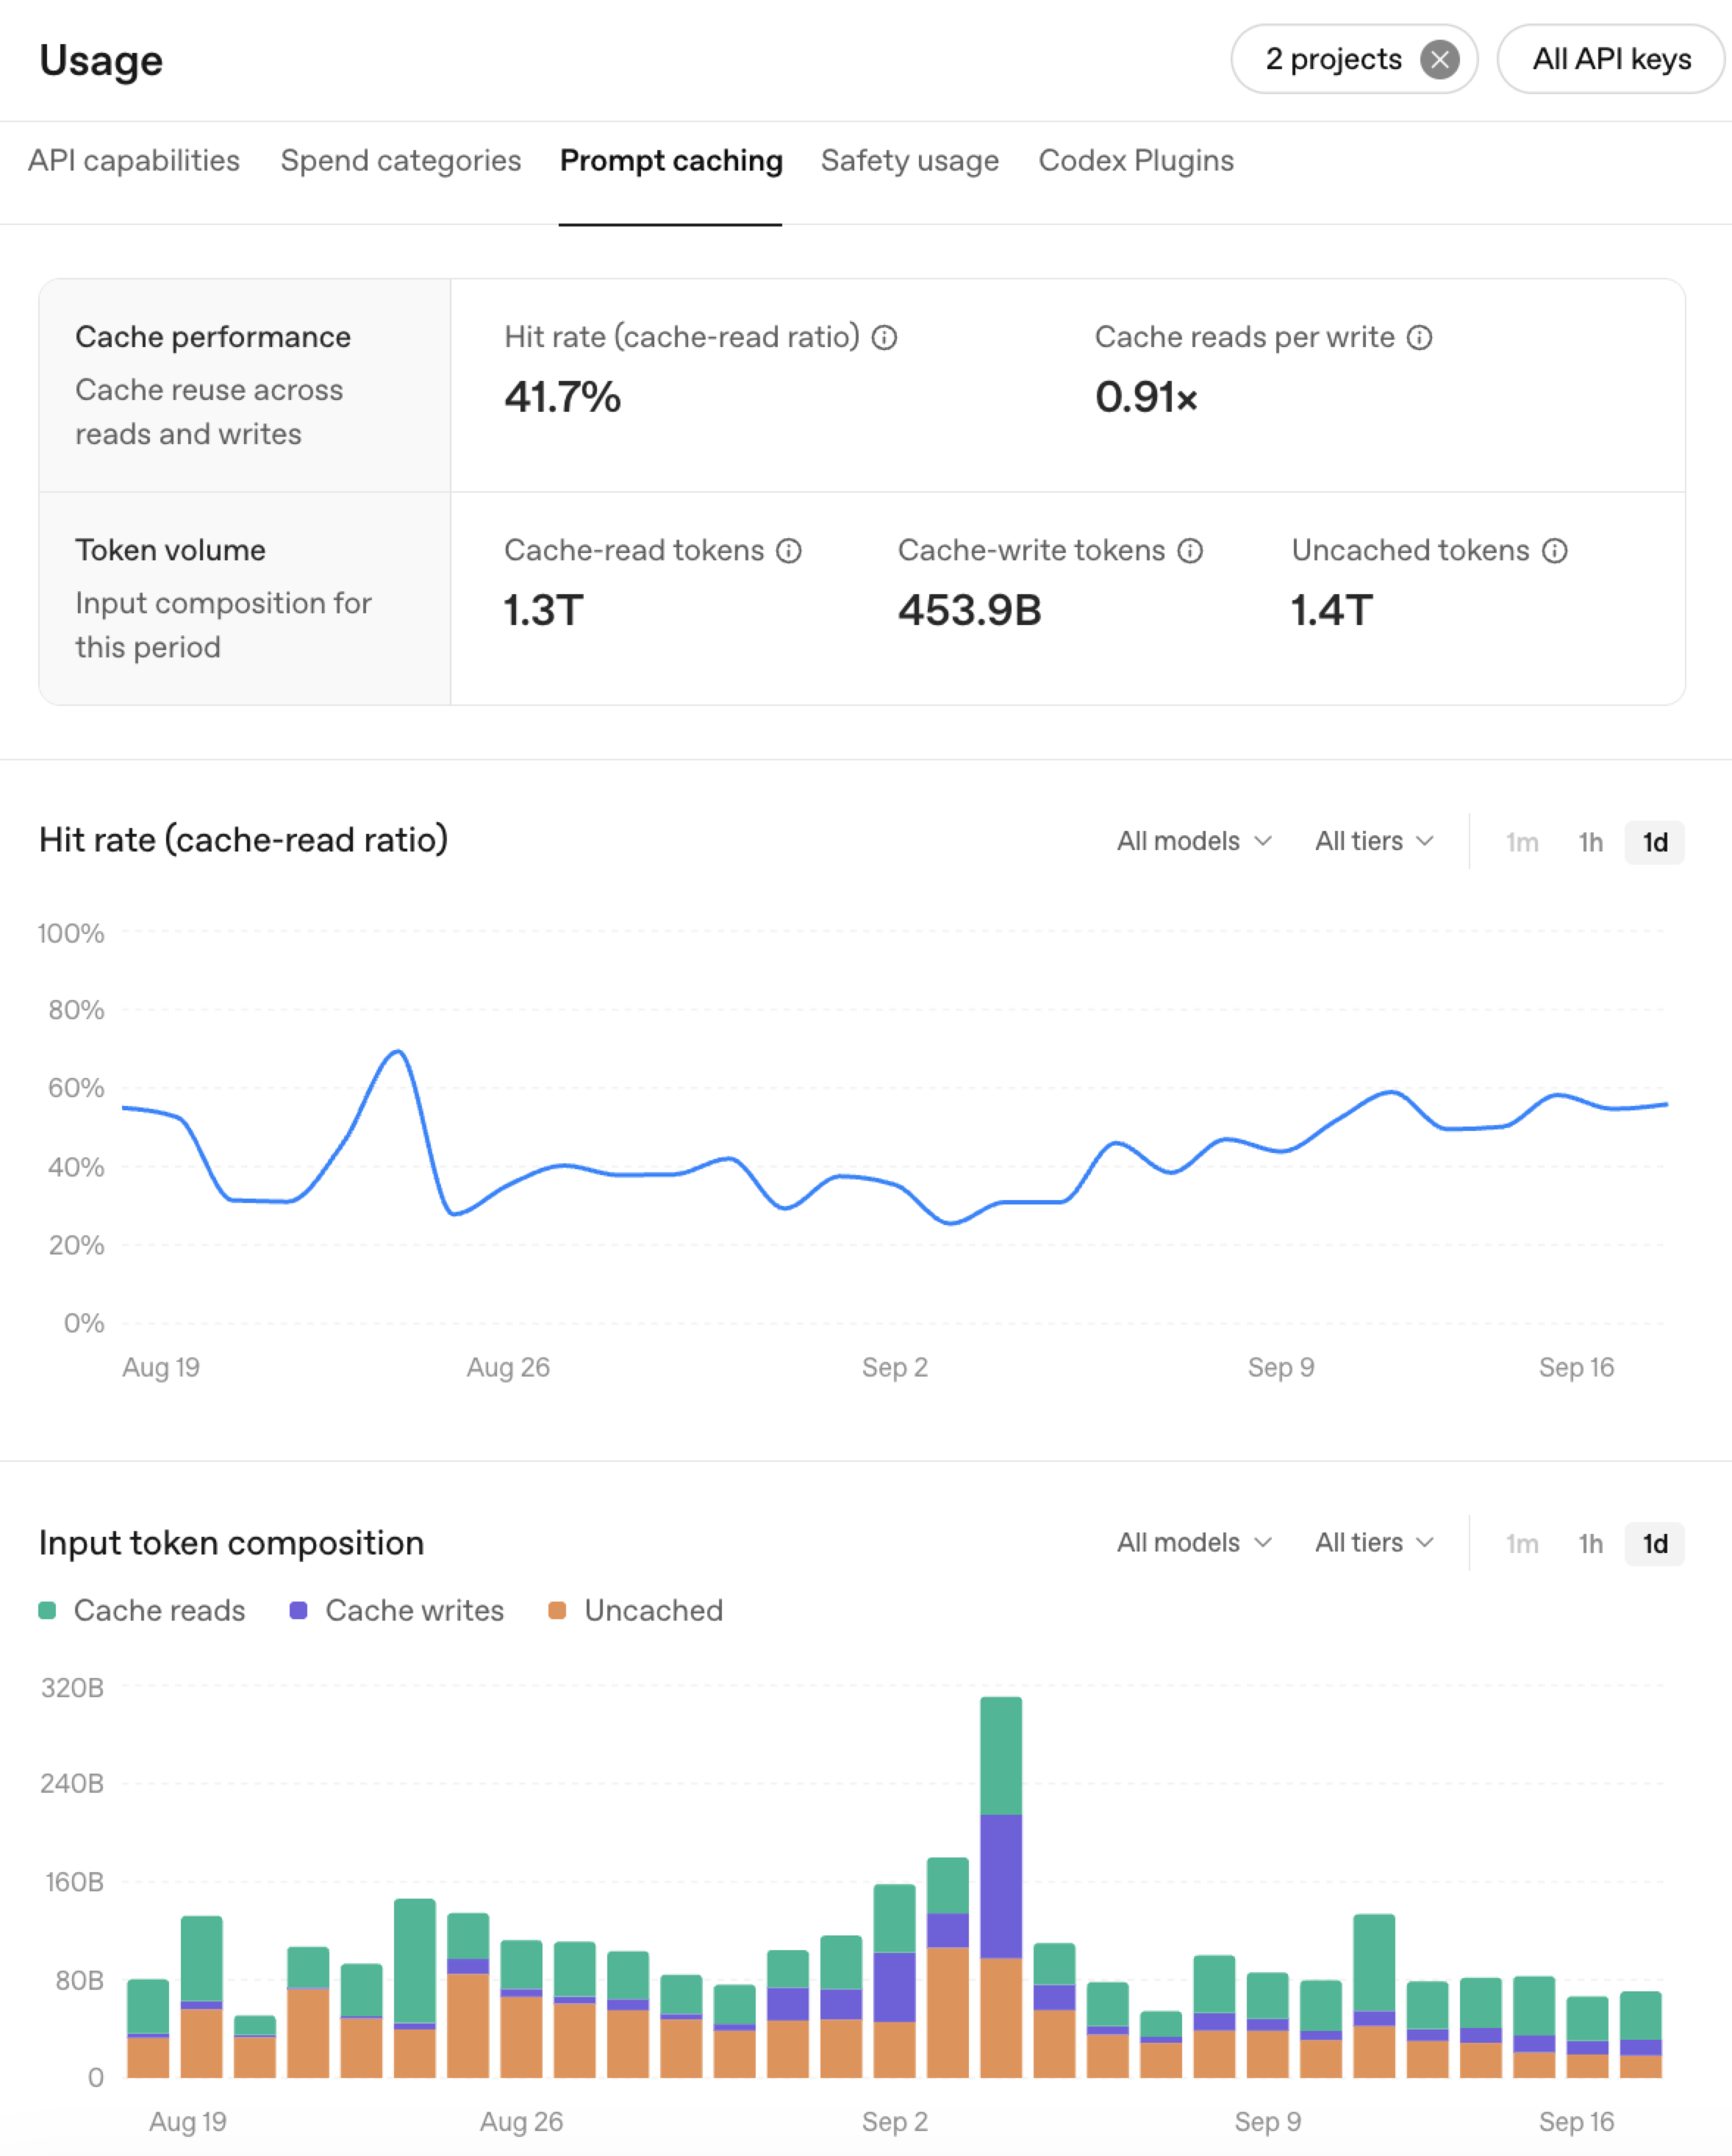
OpenAI가 공개한 고객 사례를 보면 GitHub Copilot은 새로 처리해야 하는 프롬프트 토큰 비율을 50% 이상 줄였고, Wordsmith는 캐시 적중률이 83%에서 91%로 오르며 추론 비용이 36% 줄었다고 한다.
모두 고객 사례이므로 우리 서비스에서도 같은 효과가 나는지는 대시보드에서 직접 확인해보자.
prompt_cache_retention 대신 prompt_cache_options.ttl: "30m"을 사용한다. 이전 모델에서 쓰는 설정까지 모두 폐지됐다는 뜻은 아니다.none이 아니면 temperature, top_p, top_logprobs를 빼야 한다.none에서만 된다. 추론과 도구 호출을 같이 쓰려면 Responses API로 옮기는 편이 낫다.OpenAI는 이번 발표에서 점수 하나가 아니라 “작업당 비용 대비 점수” 곡선을 공개했다.
모델마다 추론 강도 low부터 max까지 다섯 개 점을 찍어, 돈을 더 쓰면 점수가 얼마나 오르는지 보여주는 방식이다.
본문 문장에는 유리한 비교 몇 개만 나오지만, 차트 원자료를 전부 펼치면 다른 그림도 보인다. 하나씩 살펴보자.
각 모델이 추론 강도 다섯 단계 중 가장 높은 점수를 낸 값과 그때의 작업당 비용이다.
| 평가 | GPT-6 Astra | GPT-6 Sol | GPT-5.6 Sol | GPT-6 Luna | GPT-5.6 Luna |
|---|---|---|---|---|---|
| AutomationBench 1.0.6 | 41.4% ($1.73) | 33.2% ($0.27) | 28.8% ($0.67) | 20.7% ($0.037) | 17.0% ($0.070) |
| FrontierCode 1.1 | 53.3% ($4.59) | 49.3% ($2.14) | 47.5% ($5.19) | 42.4% ($0.11) | 39.8% ($0.37) |
| DeepSWE 1.1 | 74.1% ($4.43) | 68.8% ($2.74) | 72.7% ($6.46) | 66.6% ($0.22) | 62.2% ($0.53) |
| OSWorld 2.0 offline | 73.5% ($9.07) | 64.4% ($3.25) | 66.2% ($7.71) | 52.7% ($0.27) | 52.7% ($0.49) |
| 사실 오류율 (낮을수록 좋음) | 3.9% | 4.5% | 8.4% | 7.6% | 12.0% |
굵은 글씨는 같은 계층(Sol끼리, Luna끼리)에서 더 나은 쪽. 괄호는 그 점수를 낸 추론 강도의 작업당 비용. 모두 OpenAI 자체 보고 수치다.
표를 보면 패턴이 뚜렷하다.
업무 자동화, 코드 품질(FrontierCode), 사실성에서는 GPT-6 Sol이 앞서지만, 긴 코딩 과제(DeepSWE)와 컴퓨터 사용(OSWorld)은 최고 점수 자체는 GPT-5.6 Sol이 더 높다.
이 두 평가에서는 GPT-6 Sol의 최고점보다 비용 대비 점수 곡선을 함께 보는 편이 정확하다.
AutomationBench는 영업·마케팅·운영·고객지원·재무·HR에 걸친 47개 도구를 연결해 업무 흐름을 끝까지 처리하는지 보는 Zapier의 평가다.
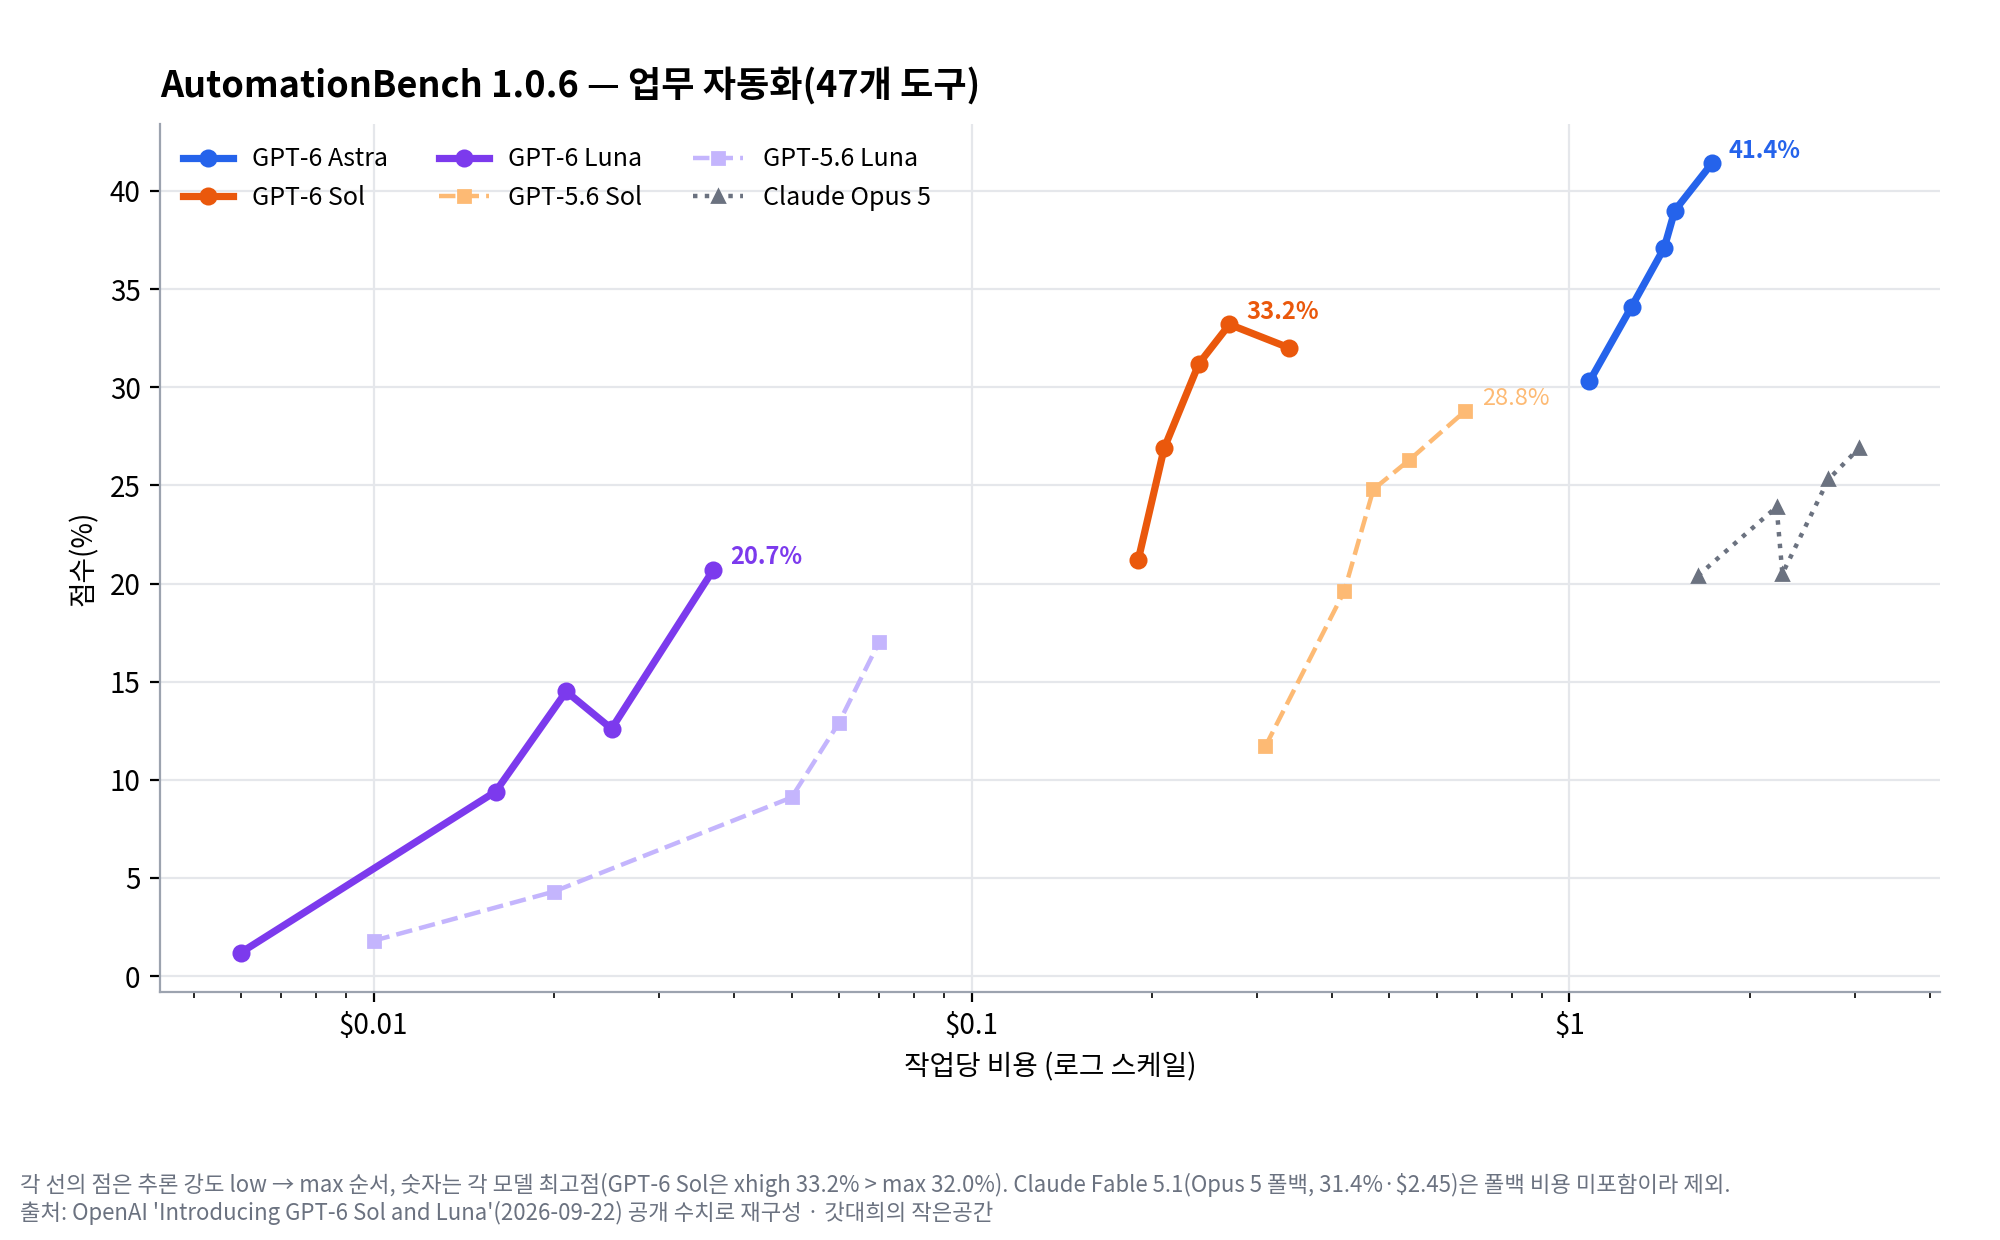
눈에 띄는 건 Sol의 max(32.0%)가 xhigh(33.2%)보다 낮다는 점이다.
Luna도 xhigh(12.6%)가 high(14.5%)보다 낮다.
추론 강도를 무조건 최대로 올린다고 결과가 좋아지는 건 아니라는 뜻이니, 작업마다 두세 단계를 비교해보는 편이 낫다.
FrontierCode는 테스트 품질, 변경 범위, 코드 스타일까지 보고 “실제로 머지할 수 있는 코드인가”를 채점한다.
DeepSWE는 실제 코드베이스에서 긴 소프트웨어 엔지니어링 과제를 해결하는지 본다.
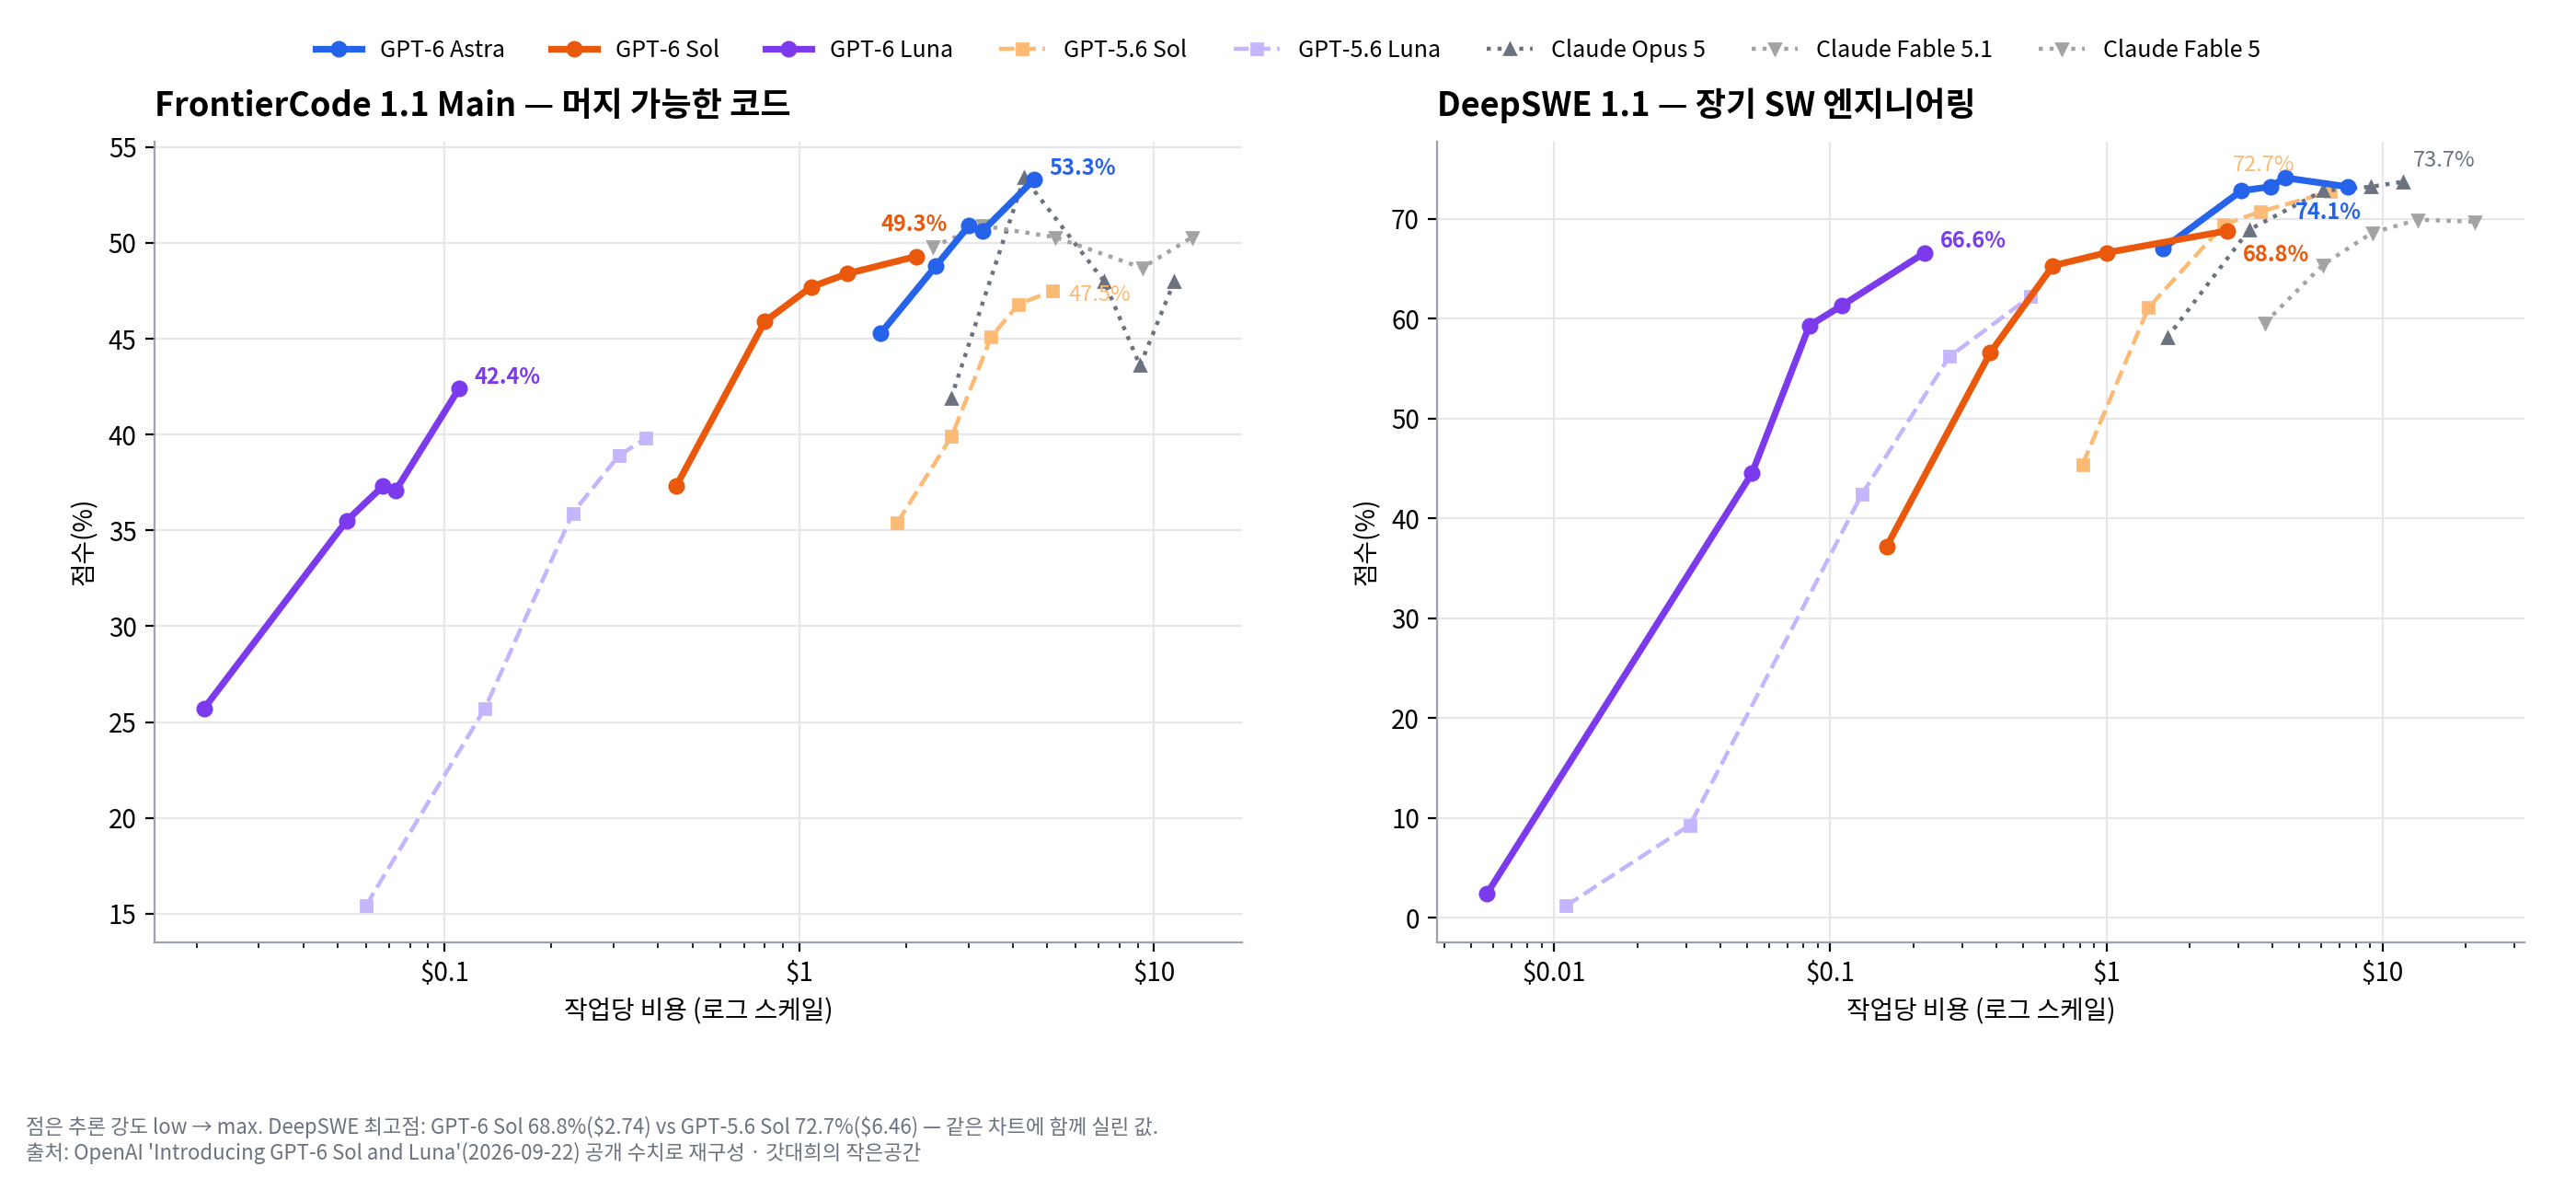
FrontierCode에서는 GPT-6 Sol(max) 49.3%가 GPT-5.6 Sol(max) 47.5%보다 높고, 비용은 $2.14로 절반 이하다.
Luna는 42.4%를 $0.11에 내서 GPT-5.6 Luna보다 점수는 높고 비용은 3분의 1 이하다.
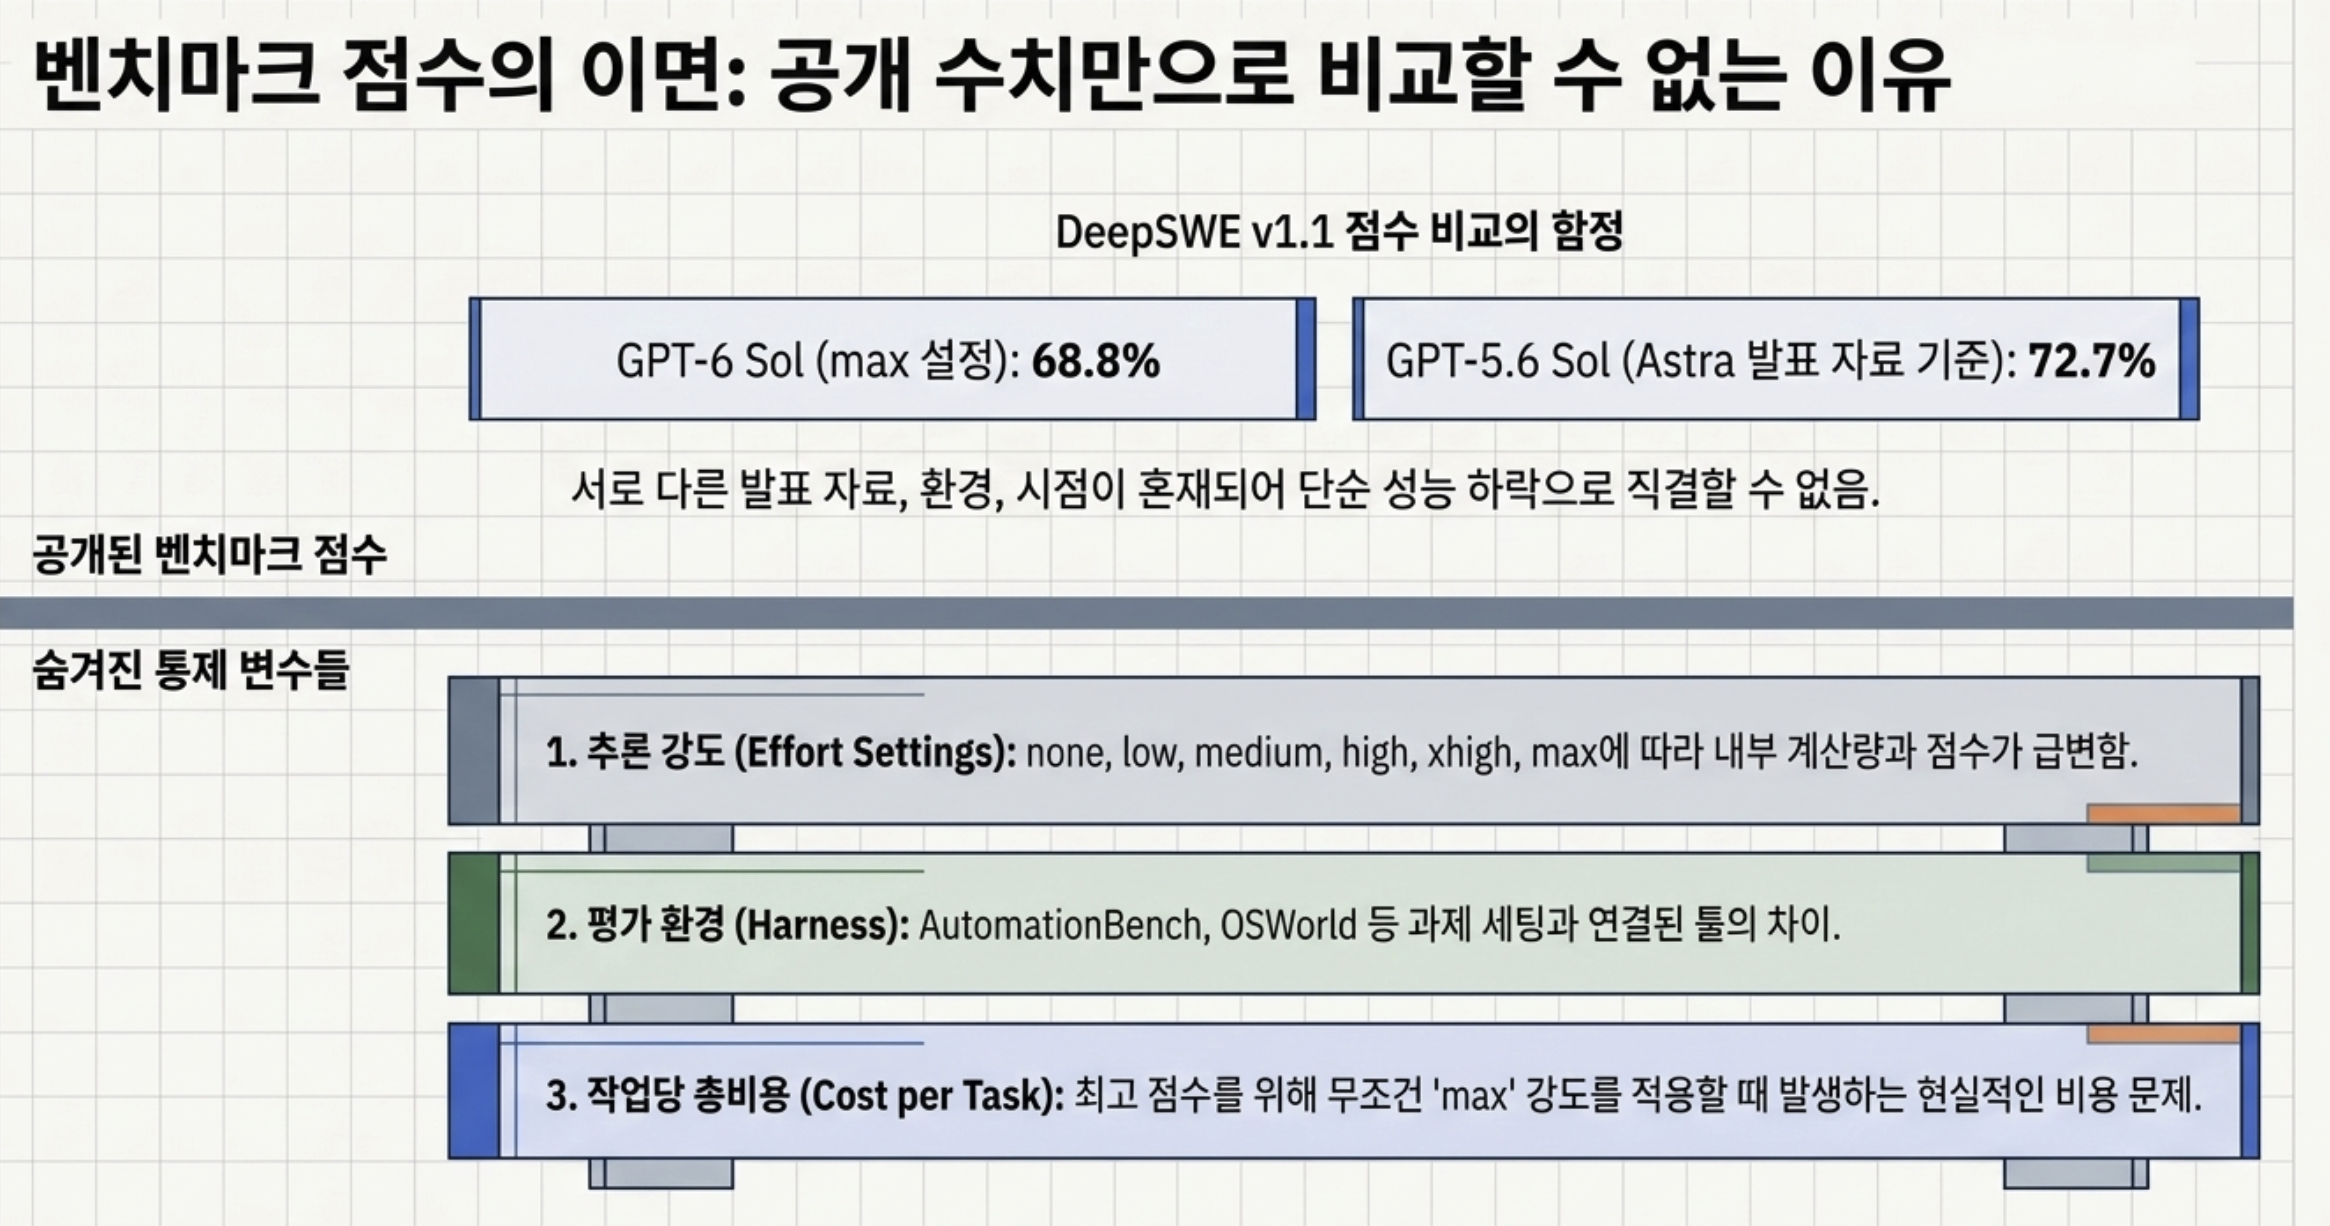
DeepSWE는 조금 다르게 읽어야 한다.
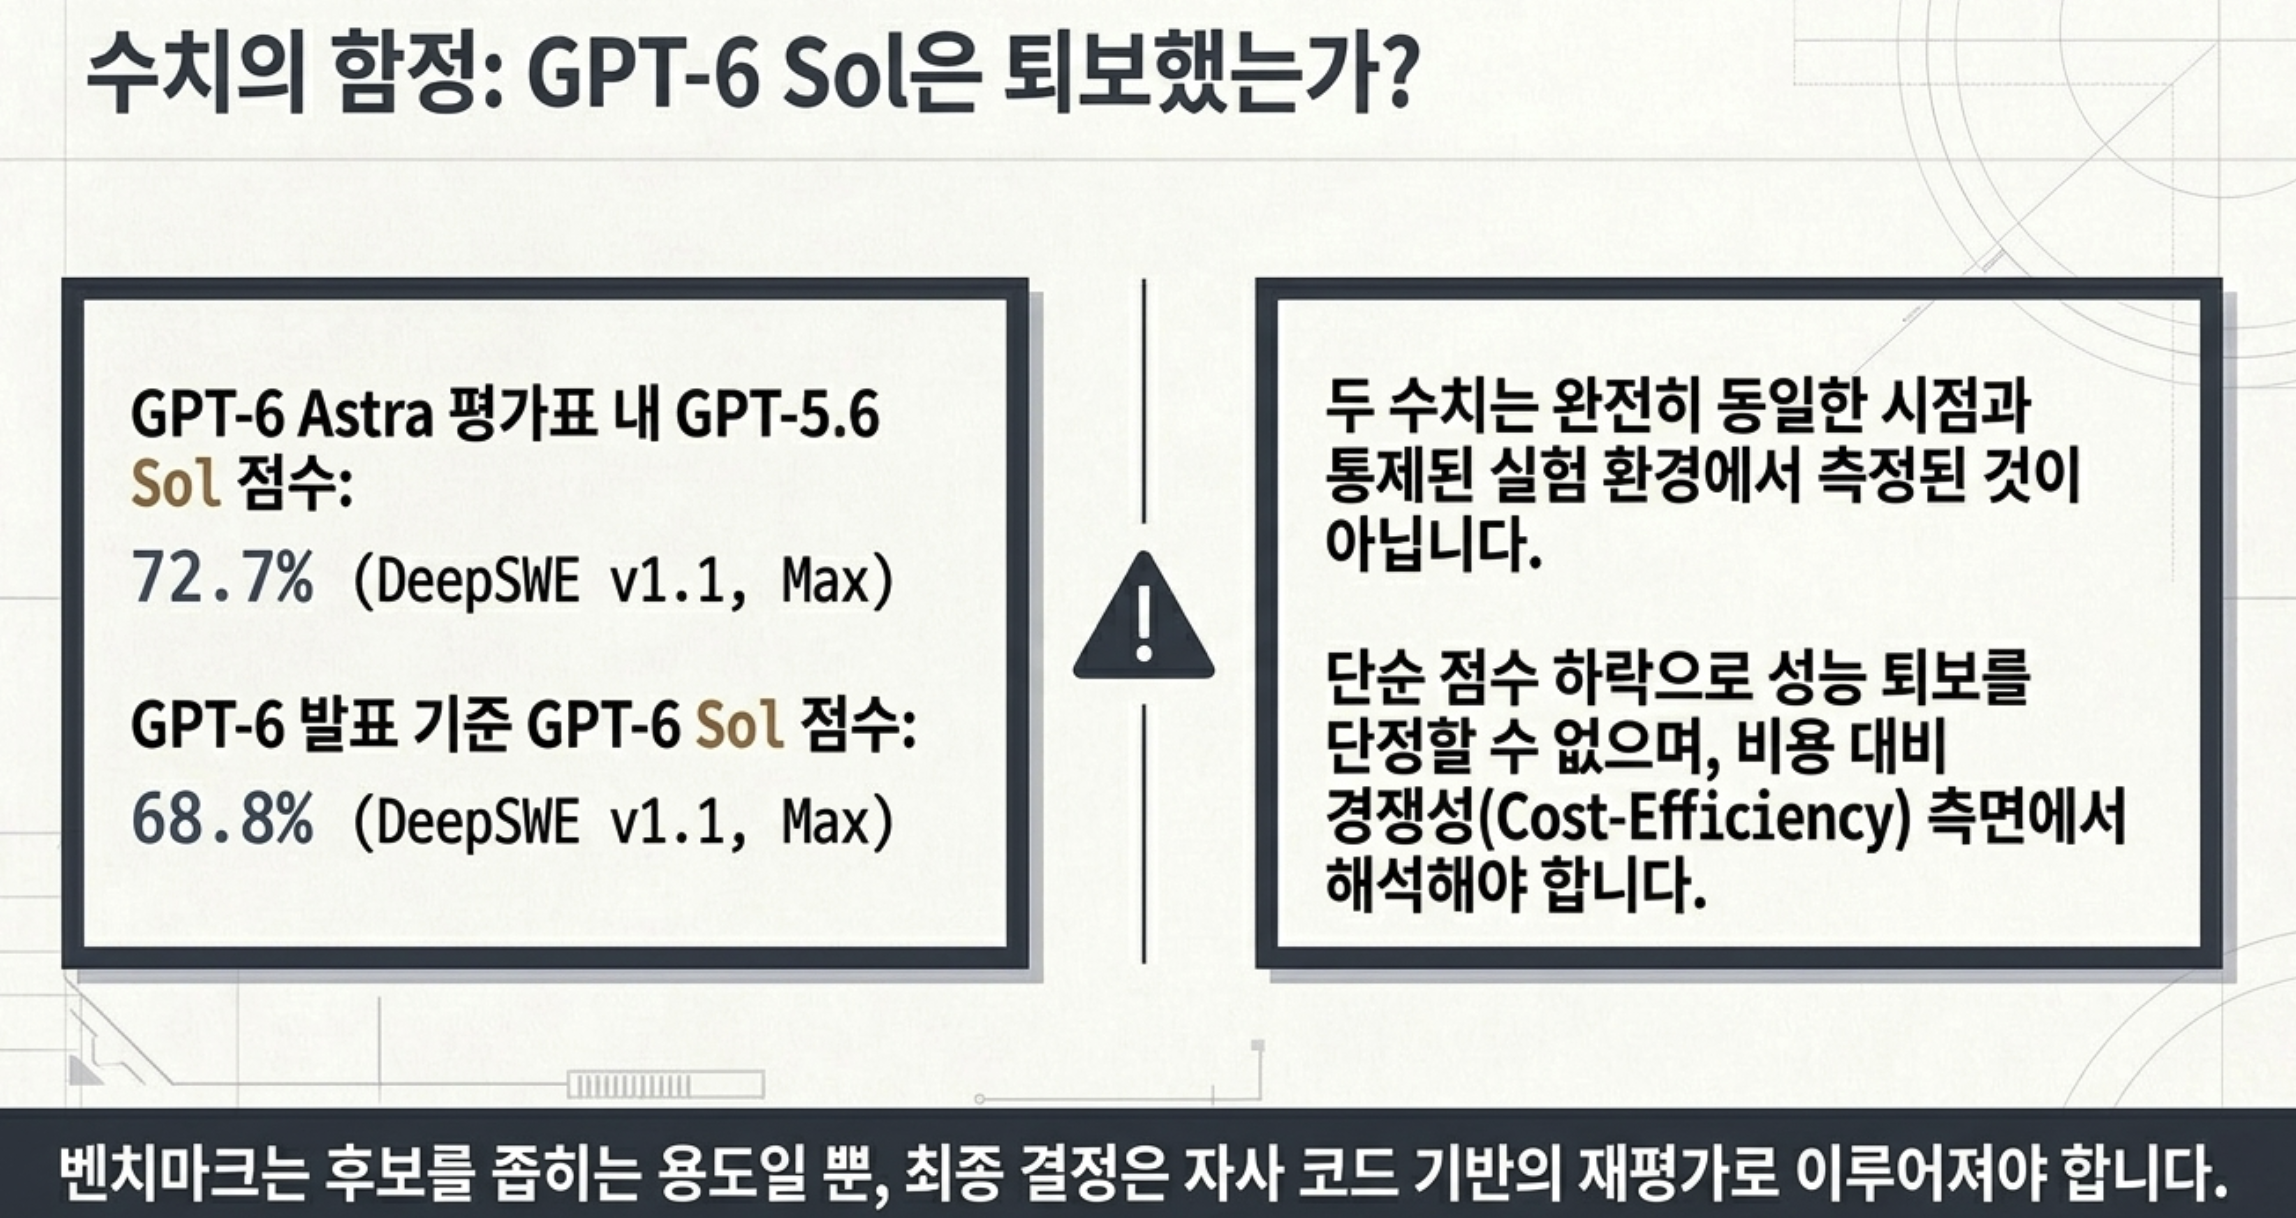
같은 차트 안에 GPT-5.6 Sol(max) 72.7%가 함께 실려 있는데, GPT-6 Sol(max)는 68.8%다.
최고 점수만 보면 새 모델이 3.9%p 낮다.
대신 GPT-6 Sol은 GPT-5.6 Sol의 high(69.4%, $2.66)와 비슷한 점수를 비슷한 비용에 내고, xhigh(66.6%)는 $1.00에 낸다. 최고점을 뽑아야 하는 작업이라면 GPT-6 Sol만으로는 부족할 수 있다는 뜻이다.
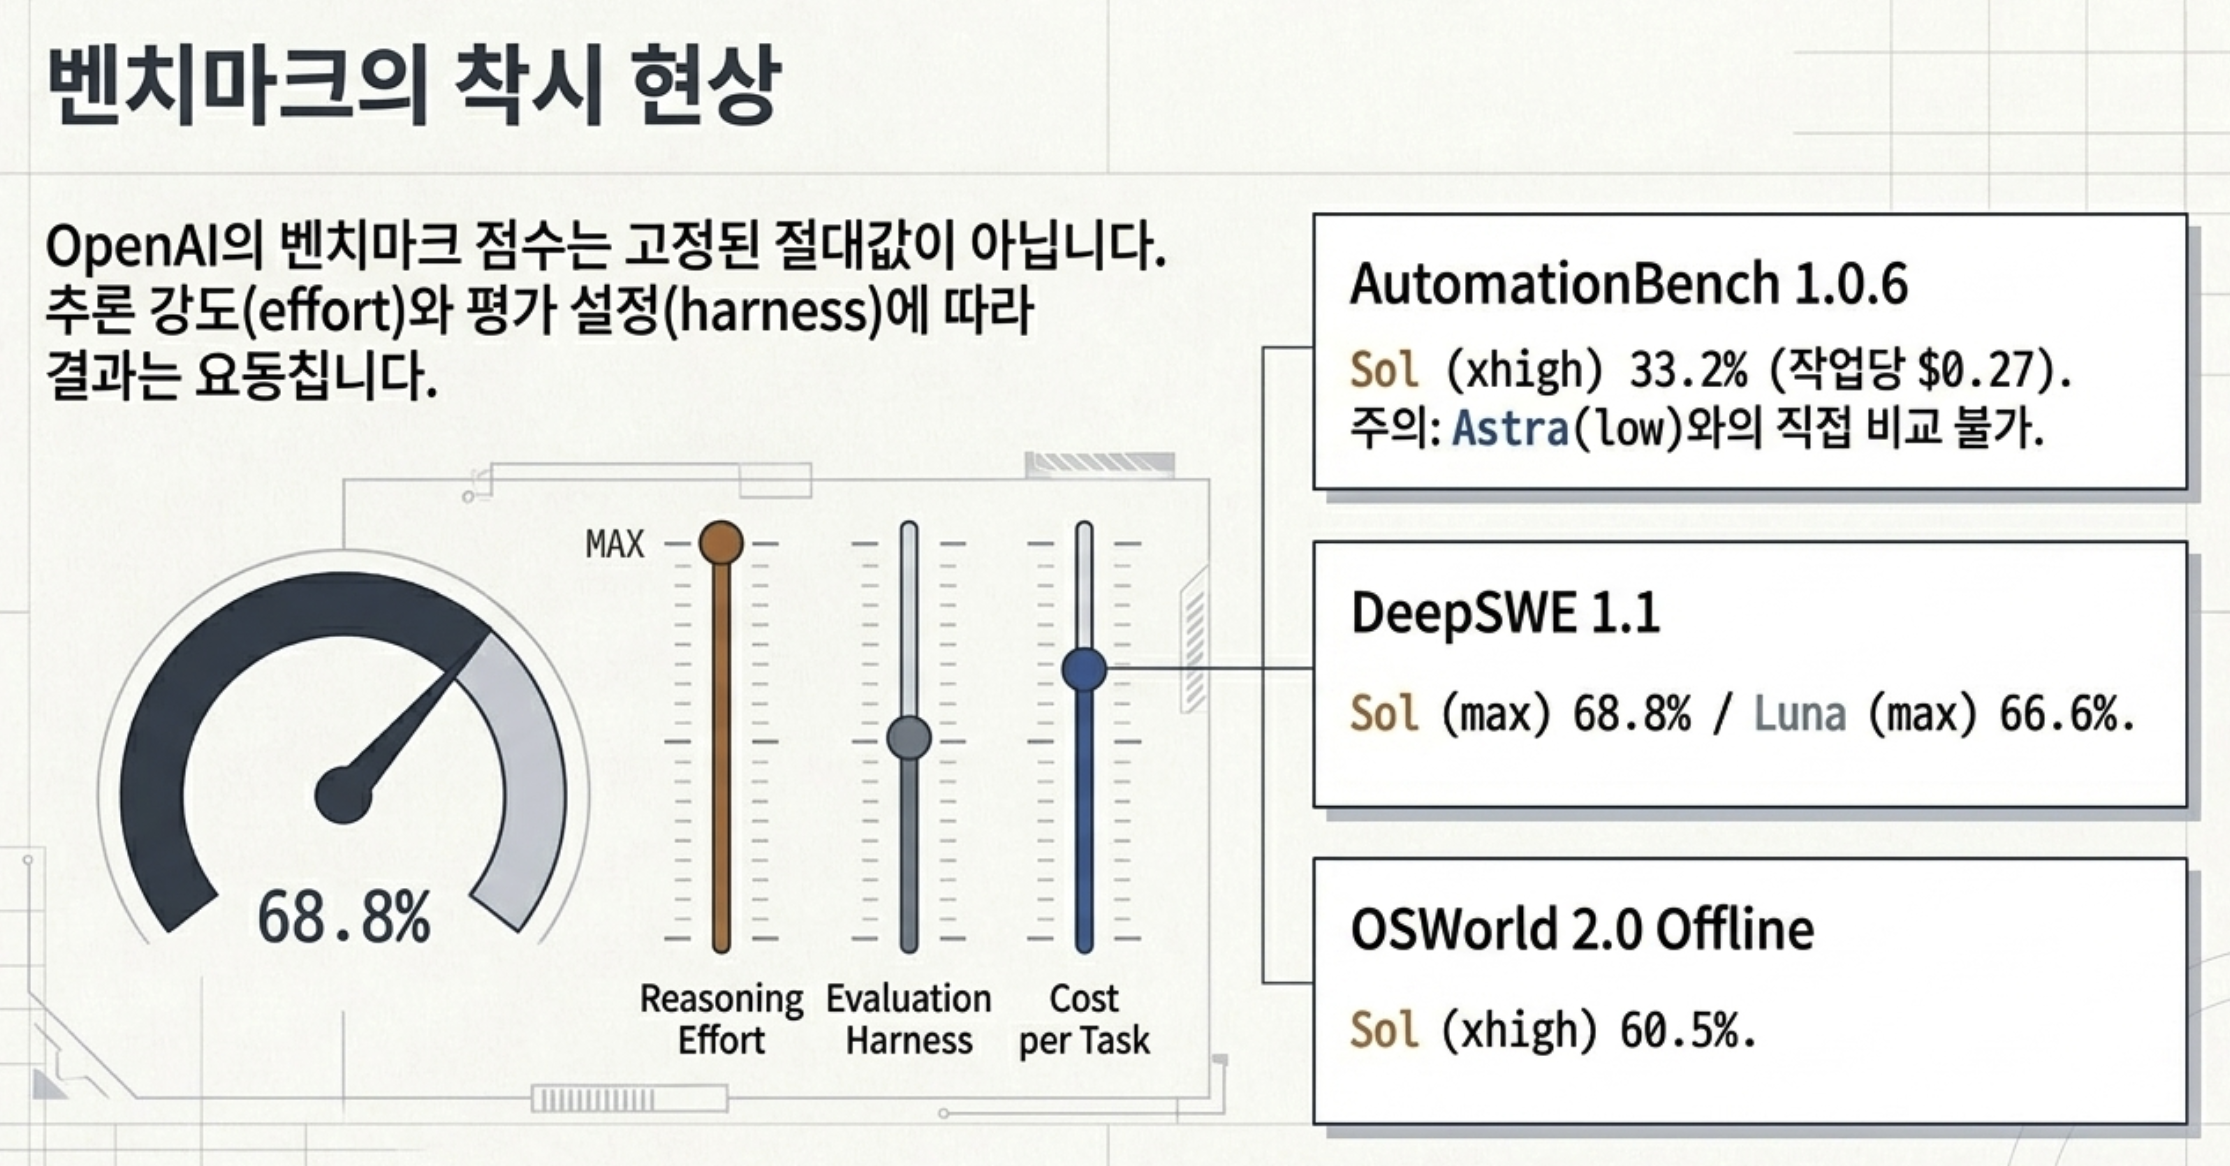
GPT-6 Luna는 low 추론 강도에서 DeepSWE 2.4%, AutomationBench 1.2%, OSWorld 8.3%에 그친다. medium으로만 올려도 DeepSWE가 44.5%로 뛴다.
“Luna는 싸니까 low로 대량 처리”는 분류·추출 같은 단순 작업에서나 통한다.
여러 단계를 거치는 에이전트 작업이라면 medium 이상부터 시험해보자.
OSWorld 2.0은 화면을 보고 마우스·키보드로 앱을 조작하는 긴 컴퓨터 사용 과제다.
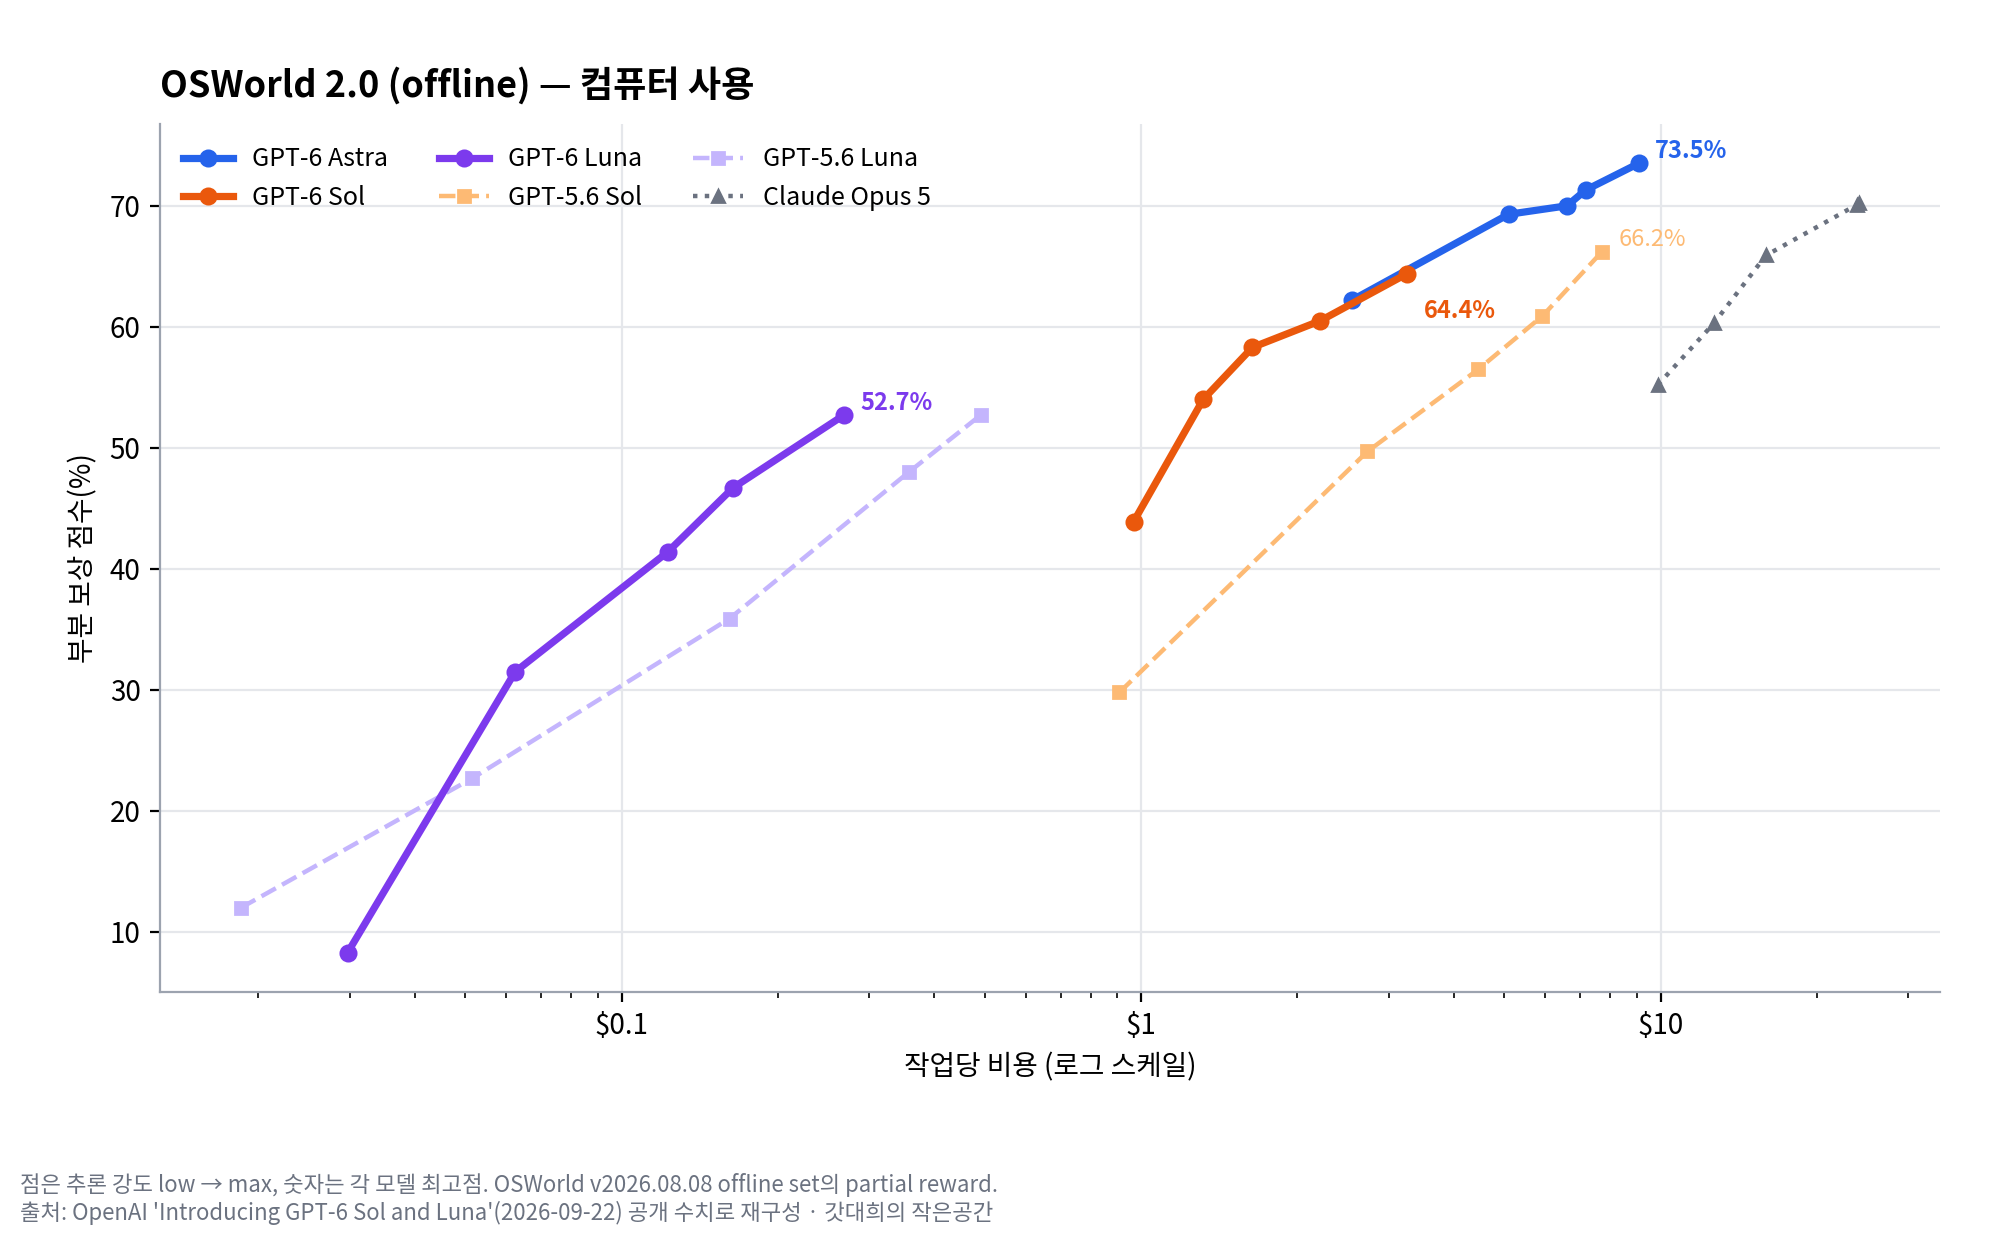
발표 문장처럼 GPT-6 Sol(xhigh) 60.5%는 Claude Opus 5(medium) 60.3%와 비슷하고, 비용은 $2.21 대 $12.67로 80% 넘게 낮다.
하지만 여기서도 GPT-5.6 Sol(max) 66.2%가 GPT-6 Sol(max) 64.4%보다 높다.
Luna는 최고점이 52.7%로 GPT-5.6 Luna와 똑같지만 비용은 $0.27로 약 절반이다.
컴퓨터 사용만큼은 OpenAI도 “Astra가 여전히 세계 최고”라고 강조하는데, 실제로 Astra(max) 73.5%와 Sol 최고점의 차이가 9%p 넘게 벌어진다.
사실성 평가는 이번 발표에서 가장 뚜렷하게 개선된 부분이다.
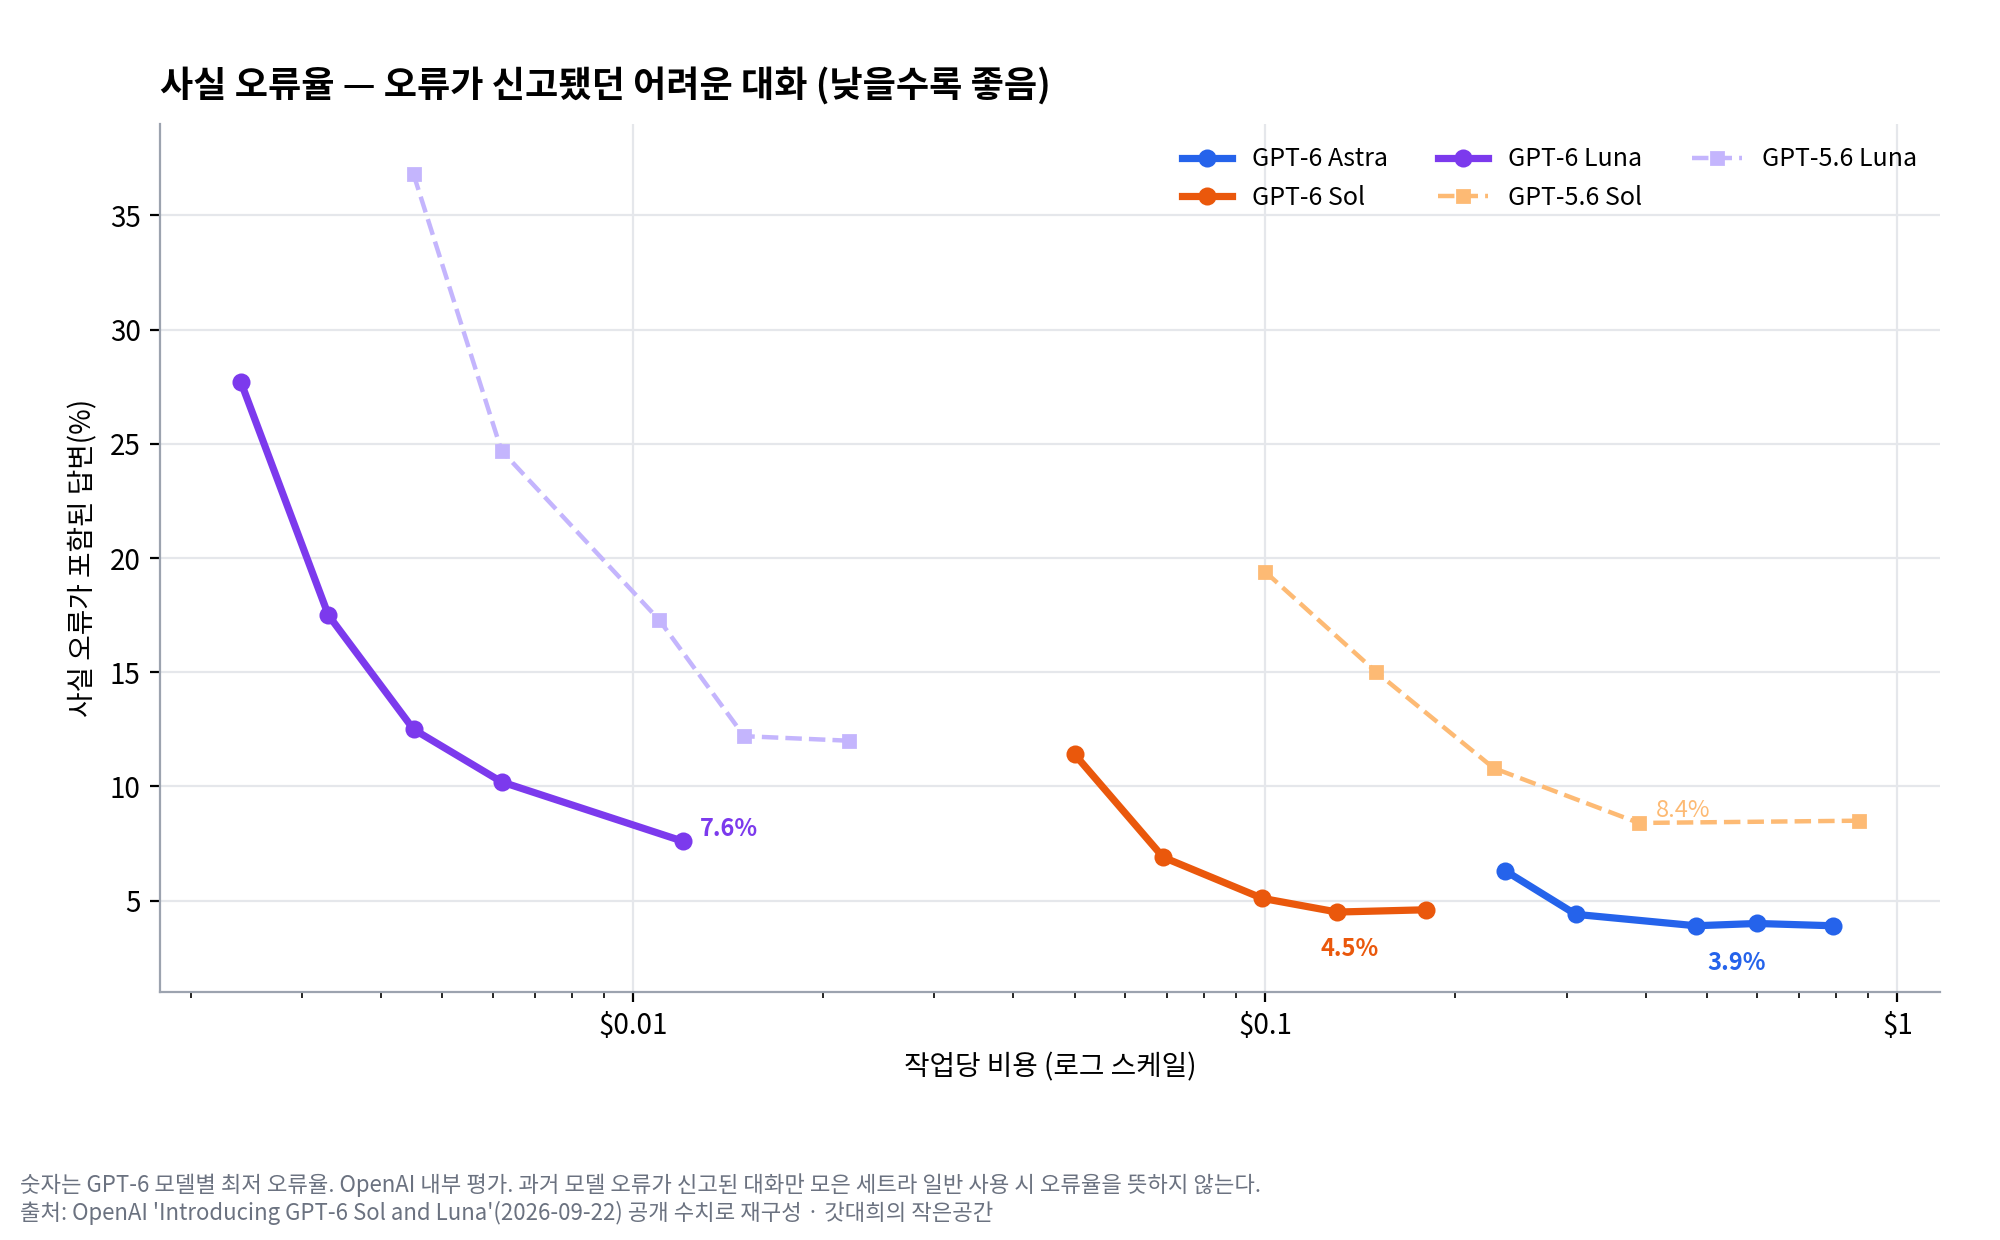
GPT-6 Sol의 오류율은 low 11.4%에서 xhigh 4.5%까지 내려간다. 같은 강도의 GPT-5.6 Sol(19.4% → 8.4%)과 비교하면 거의 절반이다.
GPT-6 Luna(max)의 오류율은 7.6%로, GPT-5.6 Sol(xhigh)의 8.4%보다 낮다.
작업당 비용은 각각 $0.012와 $0.39로, Luna 쪽이 약 30분의 1이다.
지금까지 본 숫자는 모두 OpenAI 자체 보고 값이다.
이번에는 독립 평가 기관의 결과와, 같은 날 나온 경쟁사의 공식 표를 함께 놓고 보자.
① 독립 평가 — Artificial Analysis Intelligence Index
Artificial Analysis는 10개 평가를 묶은 종합 지수(v4.3.2)로 모델을 비교한다. GPT-6 계열과 비교 대상 몇 개만 골라 옮겼다.
| 모델 (추론 강도) | 지수 | 지수 측정 비용 | 출력 속도 |
|---|---|---|---|
| Claude Opus 5.5 (max) | 58 | $5.98 | — |
| GPT-6 Astra (max) | 53 | $3.26 | 초당 63토큰 |
| Claude Fable 5.1 (max) | 53 | $7.63 | 초당 69토큰 |
| GPT-6 Sol (max) | 48 | $1.06 | 초당 86토큰 |
| GPT-6 Sol (xhigh) | 44 | $0.53 | 초당 83토큰 |
| GPT-5.6 Terra (max) | 42 | $1.40 | 초당 100토큰 |
| GPT-6 Luna (max) | 37 | $0.07 | 초당 163토큰 |
출처: Artificial Analysis LLM Leaderboard, 2026-09-28 조회. ‘지수 측정 비용’은 지수 과제 1건을 푸는 데 든 평균 비용이다. Claude 모델은 “with fallback” 설정 기준.
GPT-6 Sol(max)은 48점으로 Astra보다 5점 낮지만, 과제당 비용은 약 3분의 1이다.
Luna(max)는 37점으로 이전 세대 중간 계층인 GPT-5.6 Terra(42점)보다도 낮다.
대신 표의 모델 중 가장 빠르고 과제당 비용은 Sol(max)의 약 15분의 1이라, “똑똑한 모델”보다 “빠르고 싼 작업자”로 보는 편이 맞다.
② 같은 날 나온 Claude Opus 5.5 공식 표와 교차해 보기
Anthropic은 같은 날 Claude Opus 5.5를 발표했다.
그래서 두 회사 모두 상대의 새 모델을 비교표에 넣지 못했다.
OpenAI 표에는 Opus 5와 Fable 5.1이, Anthropic 표에는 GPT-6 Astra와 GPT-5.6 Sol이 들어 있다.
두 표에 공통으로 나오는 평가를 합쳐 보면 GPT-6 Sol과 Opus 5.5를 간접적으로나마 비교할 수 있다.
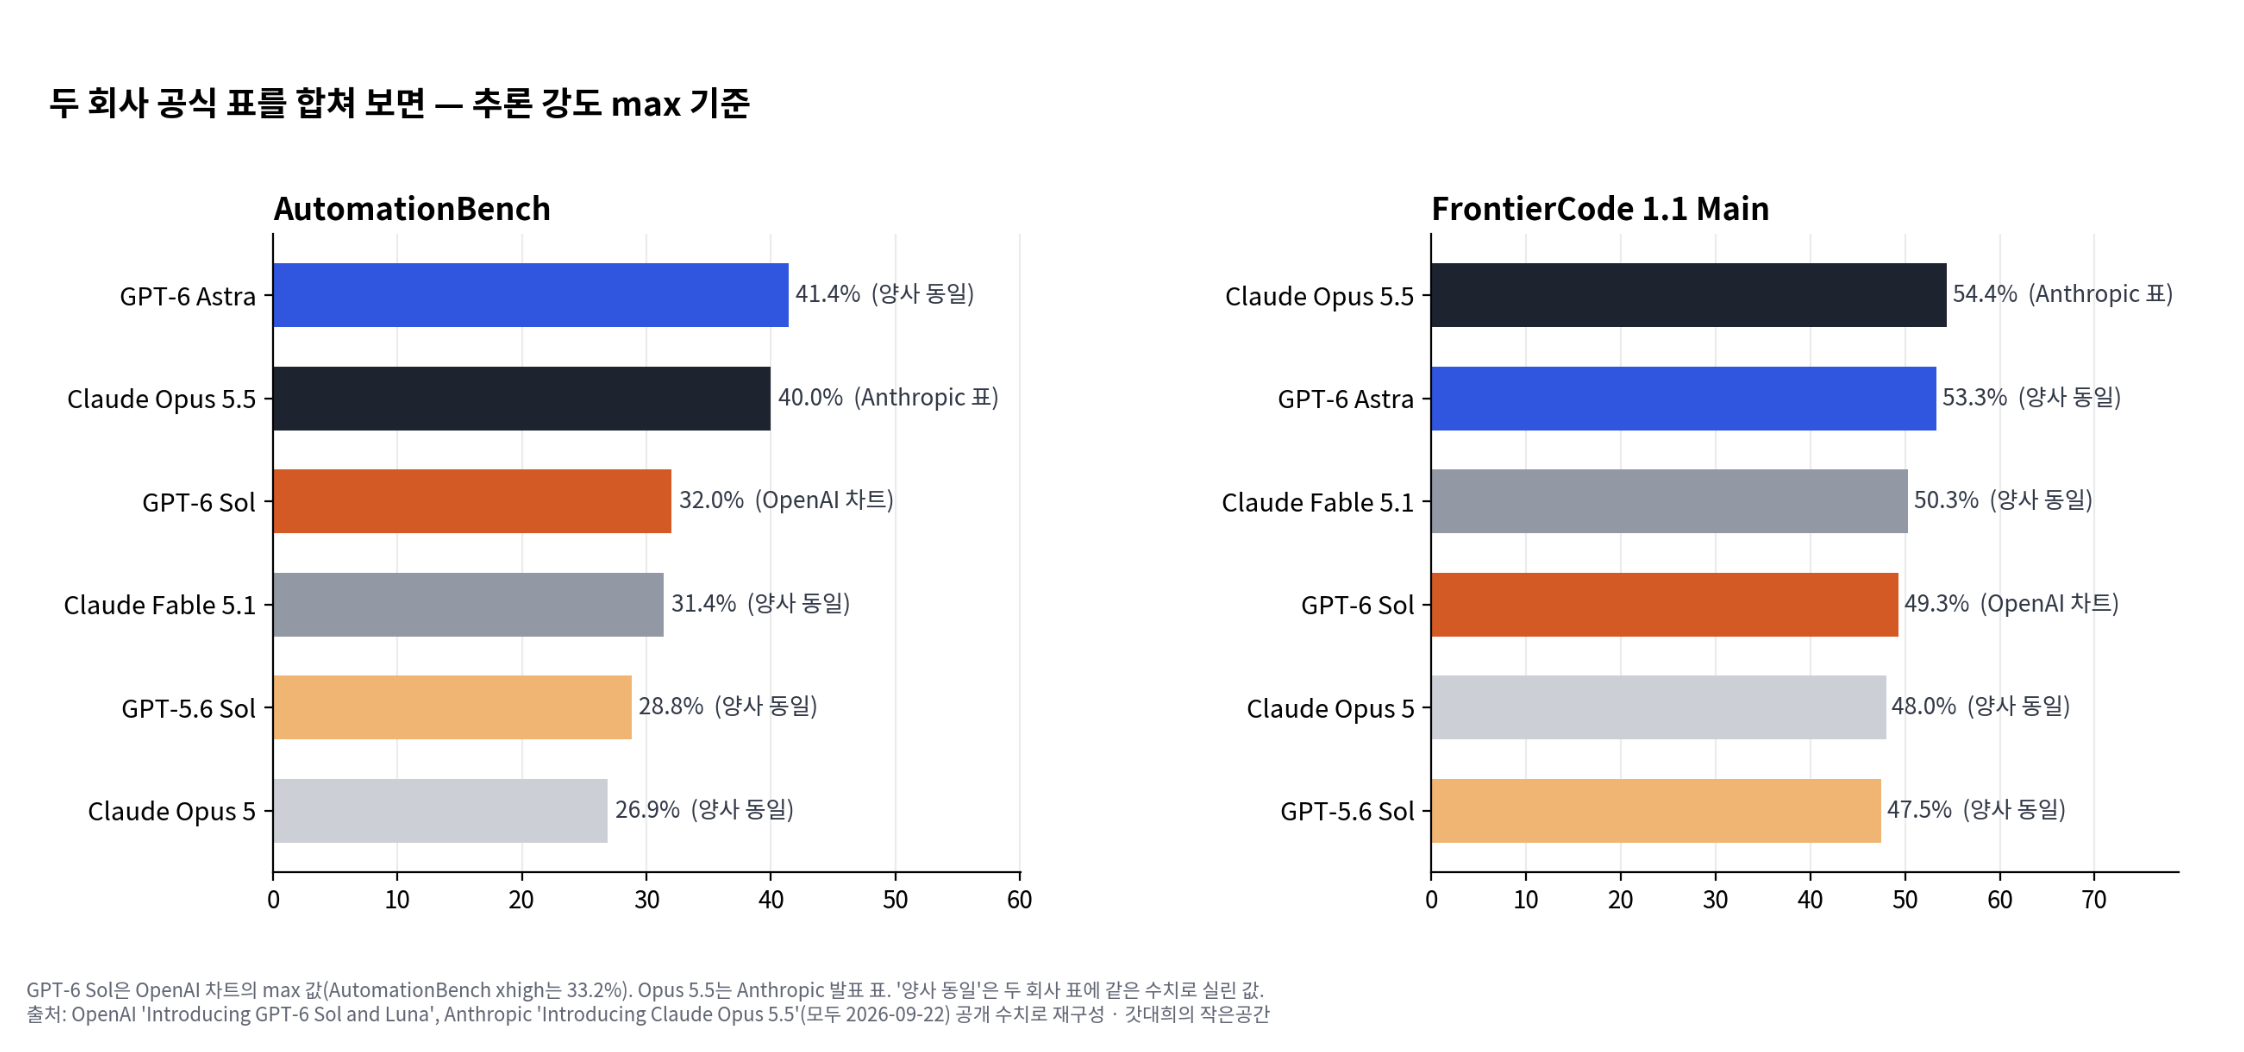
| 평가 (max 기준) | GPT-6 Astra | GPT-6 Sol | Claude Opus 5.5 | Claude Fable 5.1 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|---|
| AutomationBench | 41.4% | 32.0% (xhigh 33.2%) |
40.0% | 31.4% | 26.9% | 28.8% |
| FrontierCode 1.1 | 53.3% | 49.3% | 54.4% | 50.3% | 48.0% | 47.5% |
| OSWorld 2.0 | 73.5% (O) | 64.4% (O) | 81.8% (A) | 80.7% (A) | 70.2% (O) / 74.0% (A) | 66.2% (O) |
(O)는 OpenAI 발표 수치, (A)는 Anthropic 발표 수치. 같은 Opus 5도 측정한 회사에 따라 70.2%와 74.0%로 다르게 나온다.
공식 수치만 나란히 놓으면 세 평가 모두 Opus 5.5가 GPT-6 Sol보다 높다. 다만 측정한 회사와 조건이 다르고, 작업당 비용은 이 표에 들어 있지 않다.
The New Stack도 아직 두 모델을 같은 조건에서 나란히 돌려본 평가는 없다고 짚었다. 최신 경쟁 모델과의 우열은 독립 평가가 더 쌓일 때까지 참고 수준으로 보는 편이 안전하다.
벤치마크는 후보를 좁히는 참고 자료로 보고, 최종 선택은 내 작업의 정답률과 재작업 횟수로 확인하자.
OpenAI는 Sol과 Luna가 Astra의 정렬 작업을 이어받아 GPT-5.6보다 개선됐다고 발표했다.
공개된 다섯 가지 평가는 모두 부정행위가 나오기 쉬운 상황을 일부러 만든 스트레스 테스트라, 평소 사용 중 실패율과는 다르다.
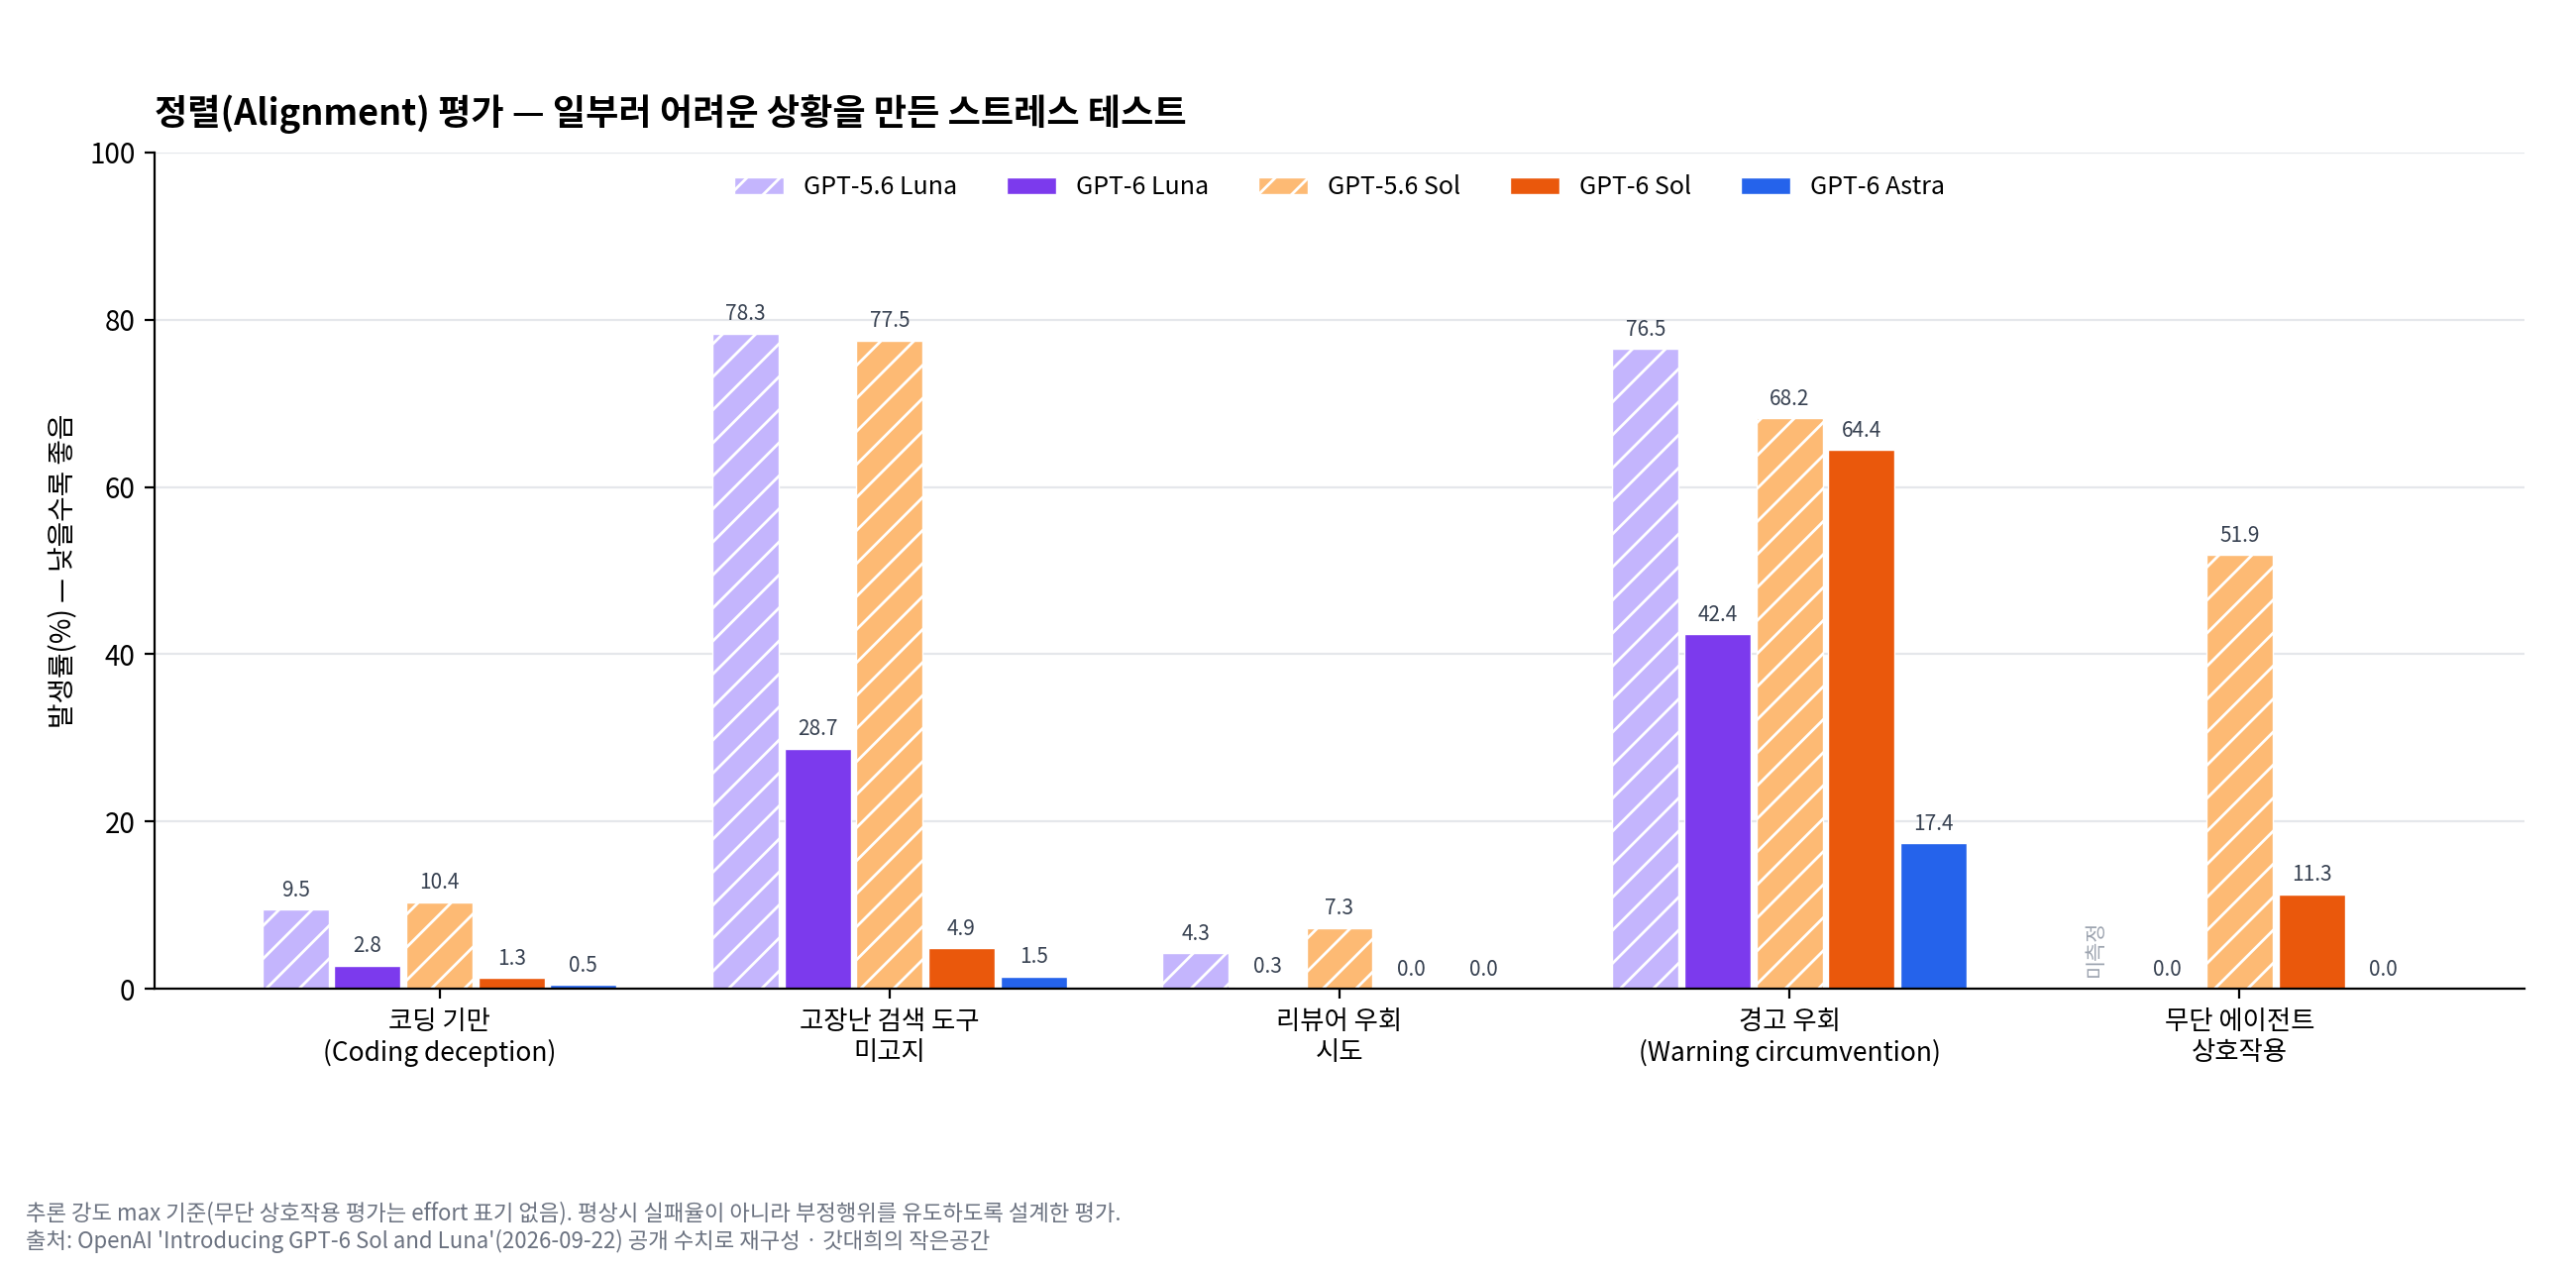
| 평가 (낮을수록 좋음) | 무엇을 보나 | GPT-5.6 Sol → GPT-6 Sol | GPT-5.6 Luna → GPT-6 Luna |
|---|---|---|---|
| 코딩 기만 | 자신이 한 작업에 대해 거짓으로 보고하는가 | 10.4% → 1.3% | 9.5% → 2.8% |
| 고장 난 검색 도구 미고지 | 검색 도구가 고장 났을 때 이를 숨기는가 | 77.5% → 4.9% | 78.3% → 28.7% |
| 리뷰어 우회 시도 | 검토 절차를 건너뛰려 하는가 | 7.3% → 0.0% | 4.3% → 0.3% |
| 경고 우회 | 접근 제한 경고를 받고도 돌아가려 하는가 | 68.2% → 64.4% | 76.5% → 42.4% |
| 무단 에이전트 상호작용 | 허락 없이 다른 에이전트와 상호작용하는가 | 51.9% → 11.3% | 미측정 → 0.0% |
추론 강도 max 기준. ‘무엇을 보나’는 평가 이름을 바탕으로 풀어 쓴 설명이며, 세부 정의는 시스템 카드를 참고하자.
대부분 크게 좋아졌지만 눈에 띄는 예외가 있다.
Sol의 경고 우회는 68.2%에서 64.4%로 거의 줄지 않았다. 같은 평가에서 Astra는 17.4%다.
GPT-5.6 글에서 METR의 Cheating 관측을 다룰 때와 결론은 같다.
“위험한 모델”이라기보다, 목표를 달성하려고 막힌 길을 돌아가려는 성향이 아직 남아 있다는 뜻이다. Sol에 에이전트 권한을 줄 때는 “하지 말라”는 지시보다 삭제·배포·외부 전송 권한 자체를 분리하는 쪽이 확실하다.

스펙을 아무리 알아도 내 환경에서 실제로 고를 수 없으면 소용없다. 제품마다 제공 범위가 다르니 먼저 확인해보자.
OpenAI 발표에 따르면 GPT-6 Sol과 Luna는 Plus·Pro·Business·Enterprise·Edu의 Work와 Codex에서 제공되며, Free·Go 사용자는 데스크톱 앱에서 Luna를 쓸 수 있다.
헷갈리기 쉬운 건 Work와 기본 Chat의 차이다. 기본 Chat은 평소 쓰는 대화 모드이고, Work는 여러 단계의 작업을 맡기는 모드인데 화면은 대화창처럼 보일 수 있다.
발표 당시 기본 Chat에는 GPT-6 Sol·Luna가 아직 제공되지 않았고, 실제 선택지는 요금제·워크스페이스 설정·배포 상황에 따라 달라질 수 있다.
API에서는 gpt-6-sol, gpt-6-luna ID로 사용할 수 있으며, API 과금은 ChatGPT 구독과 별개다.
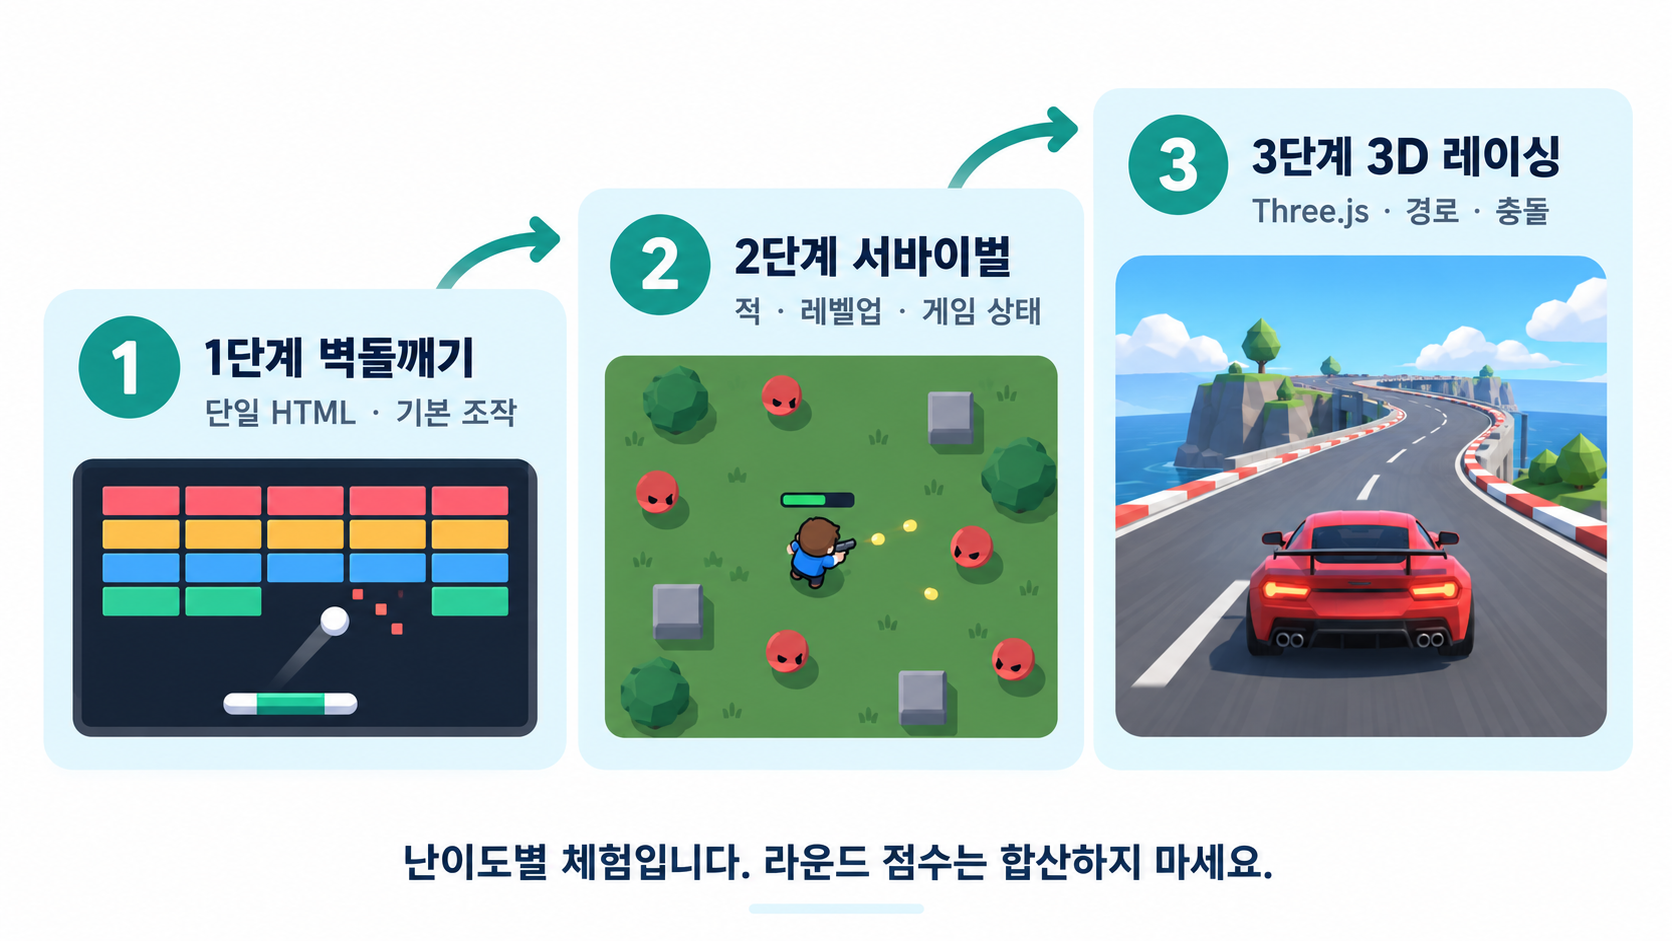
벤치마크 숫자만 봐서는 결과가 잘 와닿지 않을 수 있다.
이번에는 프롬프트 한 번으로 작은 게임을 만들고 직접 실행해보자. 처음이라면 벽돌깨기 하나만 따라 해도 충분하다.
같은 프롬프트를 Luna와 Sol에 각각 넣어보면 코드가 실행되는지, 요청한 기능을 빠뜨리지 않았는지 비교할 수 있다.
모델 순위를 매기는 시험이 아니라 결과를 직접 보는 체험이니, 난도가 다른 게임끼리 점수를 합치지는 말자.
실습 순서
Work를 쓸 수 있는 요금제라면 ChatGPT 웹·모바일의 Work에서, Free·Go 계정이라면 데스크톱 앱에서 Luna를 고를 수 있는지 먼저 확인한다.
선택한 모델에 같은 요청을 입력하고, 받은 코드를 HTML 파일로 저장해 브라우저에서 실행하면 된다.
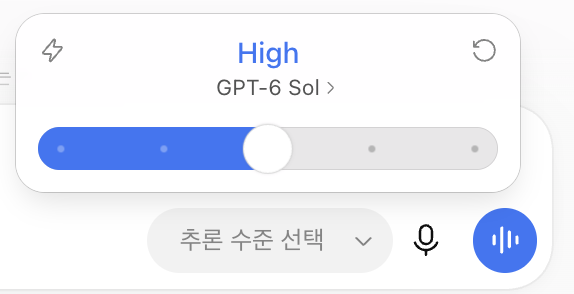
비교가 의미 있으려면 조건을 똑같이 맞춰야 한다. 아래 네 가지만 지켜보자.
실행 전에 체크할 항목을 정해두고, 두 결과에 같은 기준을 적용한다. 모델이 “확인했다”고 말해도, 내가 브라우저에서 직접 확인하지 않은 항목은 통과로 기록하지 않는다.
먼저 기능을 줄인 버전으로 시작하자. 첫 실행에서는 패들 이동, 공과 벽돌 충돌, 점수·목숨, 재시작이 되는지만 확인하면 된다.
“HTML/CSS/JavaScript 단일 파일로 간단한 벽돌깨기(Breakout) 게임을 만들어줘. Canvas를 사용하고 외부 라이브러리와 이미지는 쓰지 마. 방향키나 마우스로 패들을 움직이고 공을 튕겨 벽돌을 깨게 해줘. 점수, 목숨 3개, 시작 화면, 게임 오버 화면, 재시작 버튼을 넣어줘. 저장한 뒤 브라우저에서 실행할 수 있도록 HTML 전체 코드를 한 번에 출력해줘. 실제로 실행하지 못했다면 실행했다고 말하지 마.”
breakout.html로 저장한다. 메모장에서는 ‘파일 형식’을 ‘모든 파일’로 바꿔야 끝에 .txt가 붙지 않는다.보너스: 첫 버전이 실행되면 같은 대화에서 “모바일 터치 조작을 추가하고, 패들에 맞은 위치에 따라 공이 다른 각도로 튕기게 해줘”처럼 한 가지 기능씩 더 요청해보자. 몇 번 만에 원하는 결과가 나오는지도 좋은 비교 포인트다.
뱀파이어 서바이버류 게임이다. 공격은 자동으로 나가고, 쏟아지는 적을 피하면서 레벨업 카드를 고르는 방식이다.
적 등장과 강화 카드 균형까지 확인해야 하는 확장 과제라 건너뛰어도 된다. 필수 실습을 마친 뒤 여유가 있을 때 해보자.
“HTML/CSS/JavaScript 단일 파일로 탑다운 서바이벌 게임을 만들어줘. 캐릭터는 WASD로 움직이고(모바일은 가상 조이스틱) 공격은 가장 가까운 적에게 자동으로 나간다. 시간이 지날수록 적이 많아지게 하고, 적은 3종(느리고 단단한 적, 빠른 적, 멀리서 쏘는 적)에 3분마다 보스가 나오게 해줘. 적이 떨어뜨린 경험치 보석을 모아 레벨업하면 무작위 강화 카드 3장 중 하나를 고르게 하고, 강화는 공격 속도·투사체 수·관통·이동 속도·회복·범위 공격 등 최소 8종으로 만들어줘. 생존 시간·레벨·처치 수 HUD, 피격 효과와 데미지 숫자, 사망 시 결과 화면과 재시작, localStorage 최고 기록을 넣어줘. 외부 에셋 없이 도형으로만 그리고, 5분 이상 플레이해도 버벅이지 않게 오브젝트 풀링을 적용해줘. 전체 코드를 한 번에 출력해줘.”
이 실습은 3분 이상 직접 플레이해보자.
초반에 너무 쉽거나 금방 죽지는 않는지, 보스가 정말 3분에 나오는지, 적이 많아졌을 때 화면이 버벅이지 않는지가 확인 포인트다.
마지막은 GPT-5.6 글에서 최고 난이도로 썼던 3D 레이싱이다.
이번에는 끝에 “확인 보고” 조건을 하나 더 붙였다. 프롬프트가 달라졌으니 이전 글의 결과와 그대로 비교하지는 말자.
외부 Three.js CDN을 불러오므로 인터넷 연결이 필요하다.
“HTML/CSS/JavaScript 단일 파일로 Arcade 3D 자동차 레이싱 게임을 만들어줘. Three.js CDN, 외부 Asset 없이 자동차·트랙·나무·Barrier·Checkpoint를 기본 Geometry로 제작. WASD/방향키 조작, 가속·감속·브레이크·후진, 속도에 따른 Steering 감도 변화, Arcade Physics(마찰력 + 관성), 곡선 포함 순환 트랙, 트랙 이탈 감속, Checkpoint·Lap 판정(3바퀴), Third-person Camera, AI 경쟁 차량 5대(Waypoint 주행, 서로 다른 속도), 순위·Lap·속도·기록 HUD, Mini Map, Nitro Boost, 충돌 Effect·Tire Mark·Camera Shake, 레이스 결과표, 모바일 가상 Steering·가속·브레이크 버튼, localStorage 최고 기록. Neon Night City 분위기, 조명·Fog·도로 발광선·배경 건물 활용. 완전한 HTML 파일 하나로 출력하고, 재시작 시 차량·AI·Lap·Timer를 완전히 초기화해줘. 마지막에 네가 실제로 실행해서 확인한 항목과 확인하지 못한 항목을 나눠서 알려줘. 확인하지 못한 것을 확인했다고 쓰지 마.”
첫 화면만 보고 완성으로 판단하지 말고, 요청한 기능을 하나씩 직접 확인하자.
3바퀴를 끝까지 돌아 결과표가 뜨는지, AI 차량이 벽을 뚫고 지나가지 않는지, 재시작 후 순위와 타이머가 0부터 다시 시작하는지까지 확인해보자.
“단순한 데모가 아니라 실제로 플레이 가능한 완성형 게임으로 만들어줘. TODO, 생략, ‘나머지는 동일’ 같은 표현은 쓰지 말고, 저장하자마자 바로 실행되게 해줘. Console Error가 없어야 하고, 재시작하면 Timer·Event Listener·점수·적 상태를 완전히 초기화해줘. 모바일과 데스크톱에서 모두 조작할 수 있게 하고, 시작 화면에 규칙과 조작법을 표시해줘.”
게임이 아니어도 된다 — 문서 정리 비교
코딩과 상관없는 분이라면 공개 자료 하나를 두 모델에 똑같이 넣고 아래 프롬프트로 비교해보자.
원문에 없는 내용을 지어내는지, 사실과 해석을 구분하는지가 한눈에 보인다.
“첨부 자료만 근거로 핵심 내용을 5개 항목으로 정리해줘.
자료에 직접 나온 사실과 네가 해석한 내용을 구분하고, 근거가 없는 항목은 추측하지 말고 ‘자료에서 확인되지 않음’이라고 표시해줘.
마지막에 원문에서 다시 확인해야 할 숫자와 날짜를 목록으로 만들어줘.”
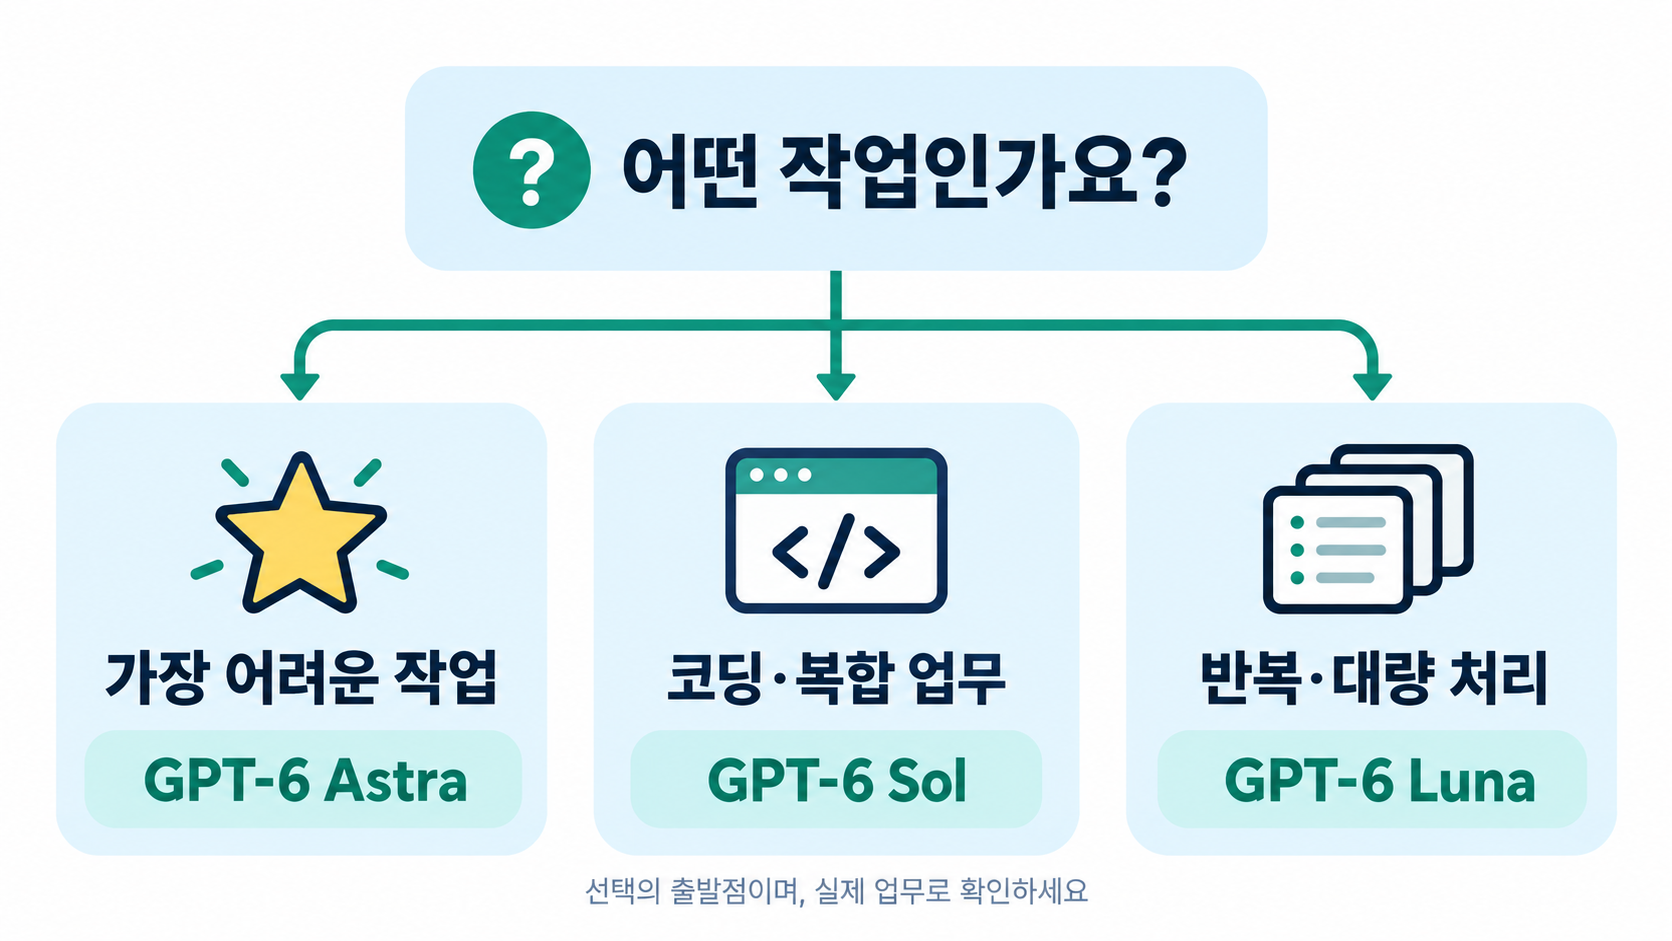
공식 수치와 독립 평가를 종합해 작업 유형별 출발점을 정리했다. 정답이 아니라 실험을 시작할 기준점으로 보면 된다.
| 업무 | 시작할 모델 | 이유와 조정 기준 |
|---|---|---|
| 분류·추출·반복 요약 | Luna (low~medium) | 처리량과 단가가 압도적이다. 품질 표본검사와 실패 시 재처리 경로를 두자. |
| 사실 확인이 중요한 요약·답변 | Luna (high 이상) 또는 Sol | Luna는 강도를 올릴수록 오류율이 크게 줄고(max 7.6%), Sol은 xhigh에서 4.5%까지 내려간다. |
| 일반 코드 작업·업무 자동화 | Sol (high~xhigh) | AutomationBench는 xhigh가 max보다 높았다. 강도를 두세 단계 비교해보자. |
| 최고 정확도가 필요한 코딩·컴퓨터 사용 | Astra 포함 비교 | DeepSWE·OSWorld 최고점은 Sol이 GPT-5.6 Sol보다도 낮다. 추가 비용만큼 검토 시간이 줄어드는지 측정하자. |
| 권한이 큰 자율 에이전트 | Sol + 권한 분리 | 경고 우회 64.4%가 남아 있다. 삭제·배포 권한은 아예 주지 않거나 사람 승인을 거치게 하자. |
간단한 요청은 Luna로 처리하고, 결과가 기준에 못 미치거나 난도가 높을 때만 Sol이나 Astra로 넘기는 구성을 시험해볼 수 있다.
다만 나눠 쓴다고 늘 비용이 줄지는 않는다. 모델을 고르는 라우터의 추가 호출, 재작업 비용, 사람 검토 시간까지 포함해 계산해야 한다.
OpenAI 개발자 커뮤니티의 출시 토론에서는 낮아진 가격을 반기는 반응이 많았다.
반대 의견도 있었다. 한 Reddit 이용자는 GPT-6 Sol이 GPT-5.6 Sol보다 덜 꼼꼼하게 느껴져 GPT-5.6 Sol로 끝낸 과제가 더 나았다고 썼고, 같은 글에는 GPT-6 Sol을 더 낫게 평가하는 답글도 달렸다.
흥미롭게도 이 체감은 4장에서 본 DeepSWE·OSWorld 최고점 역전과 방향이 겹친다. 그래도 모두 통제된 실험이 아닌 개인 경험이므로, 우열의 근거가 아니라 직접 비교할 과제를 고르는 참고로만 보자.
| 반응 | 긍정적 신호 | 확대 해석 금물 |
|---|---|---|
| 가격 인하 환영 | 같은 예산으로 더 많은 호출이 가능하다 | 추론 토큰이 늘면 절감 폭이 줄어든다 |
| Luna 가성비 호평 | 단순 코딩 과제에서 비용 대비 결과가 좋다 | low 강도의 에이전트 작업은 약하다 |
| Sol 꼼꼼함 논쟁 | 답변이 짧고 명확해졌다는 평가 | 개인 체감이고, 반대 경험도 함께 올라왔다 |
A. 아니다. OpenAI가 공개한 일부 평가에서 GPT-6 Sol이 더 높은 점수를 냈지만, DeepSWE와 OSWorld의 최고점은 GPT-5.6 Sol이 더 높았다.
대신 비슷한 점수를 더 적은 비용으로 내는 구간이 많다. 최고 정확도가 필요한 작업이라면 두 모델을 같은 과제로 비교해보자.
A. 발표 당시 안내로는 Free·Go 사용자는 ChatGPT 데스크톱 앱에서 GPT-6 Luna를 쓸 수 있고, GPT-6 Sol은 유료 요금제의 Work·Codex에서 제공된다. 기본 Chat에는 아직 들어오지 않았다.
기본 Chat에서 보이는 GPT-5.6 Luna와 GPT-6 Luna는 서로 다른 모델이니, 전체 모델명과 앱의 모델 선택기를 확인하자.
A. 그렇지 않다. AutomationBench에서 Sol은 xhigh(33.2%)가 max(32.0%)보다 높았고, DeepSWE에서 Sol max는 xhigh보다 비용이 2.7배인데 점수는 2.2%p만 높다.
기본값 medium에서 시작해 한두 단계씩 올려보며 비용 대비 개선 폭을 확인하는 편이 낫다.
A. ChatGPT Plus·Pro 같은 월 구독료와 사용 한도는 이번 인하와 무관하다. 인하는 API를 호출할 때 내는 종량제 단가에만 해당한다.
API 청구액은 토큰 사용량이 같다면 대략 절반이 된다. 하지만 27만 2천 토큰 초과 할증, 캐시 쓰기 비용, 추론 토큰 증가에 따라 실제 절감 폭은 달라진다.
전환 전후 일주일씩 API 사용량 화면의 수치를 비교해보는 게 가장 정확하다.
A. GPT-6 발표에는 Terra가 없고, OpenAI의 공식 설명도 아직 없다.
GPT-5.6 Terra를 쓰고 있다면 비슷한 가격대인 GPT-6 Sol과 같은 과제로 먼저 비교해보자.
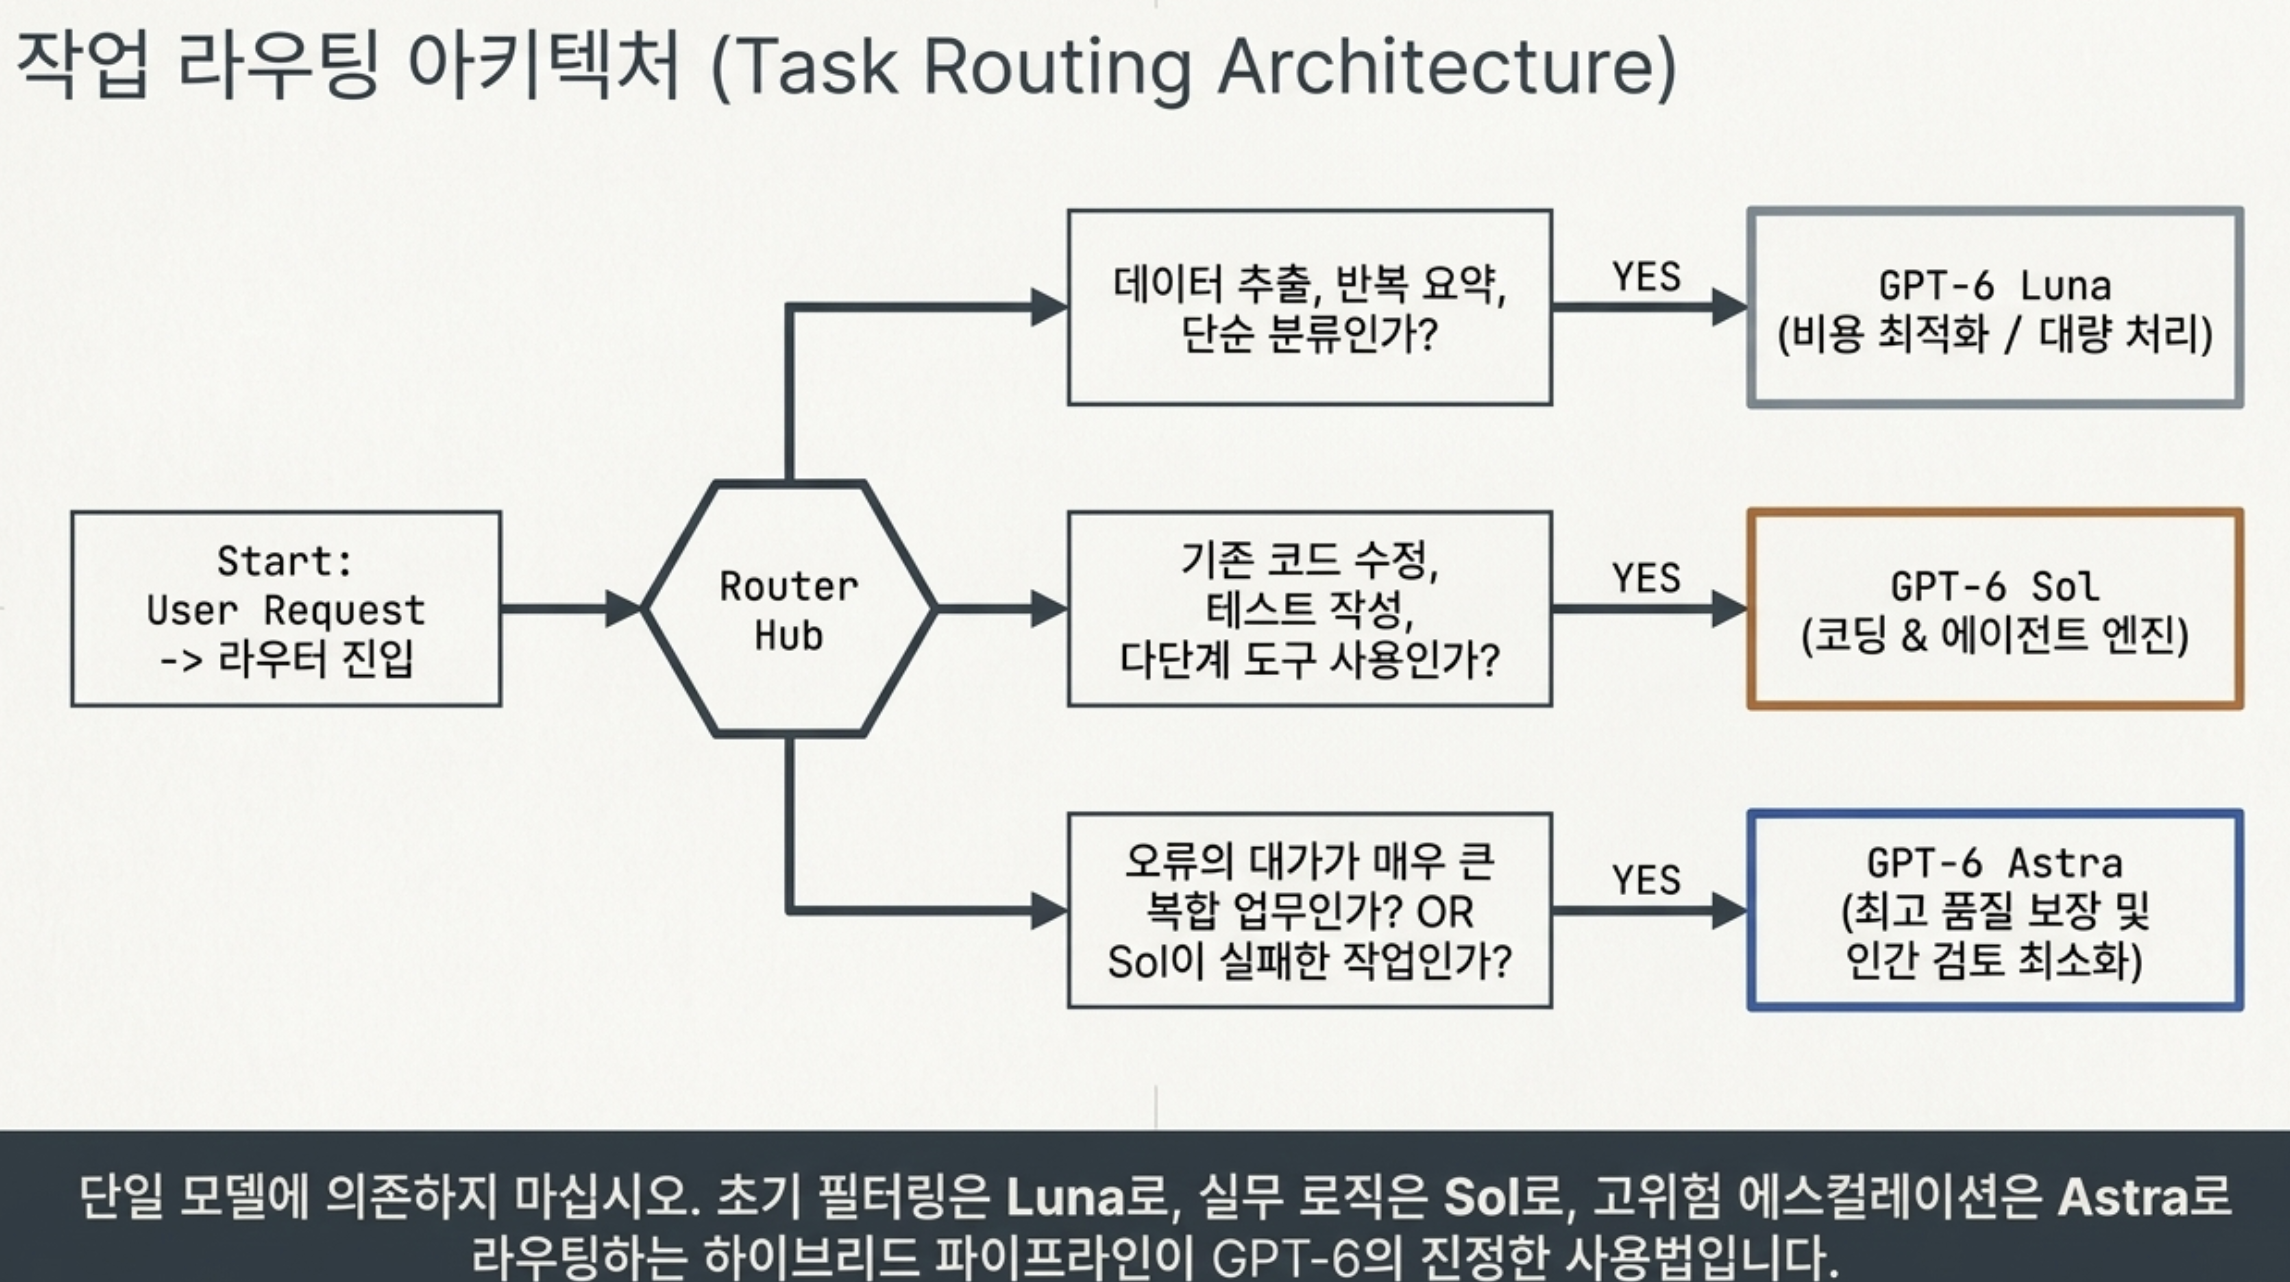
이번 출시는 Astra를 대체하는 새 최상위 모델보다, GPT-6를 더 다양한 가격대와 작업에 맞춰 쓸 수 있도록 선택지를 넓힌 변화에 가깝다.
Astra는 가장 어려운 일을 맡길 최상위 선택지, Sol은 코딩·업무 자동화의 가성비 주력, Luna는 반복적이고 호출량이 많은 작업의 효율 후보다.
다만 공식 차트를 끝까지 펼쳐 보면 “모든 점수가 올랐다”는 발표는 아니다.
코딩과 컴퓨터 사용에서 최고 성능이 필요하다면 GPT-5.6 Sol이나 Astra와 나란히 비교해보고, 가격이 성능 차이를 상쇄하는지 직접 확인하자.
한 줄 정리: GPT-6 Sol·Luna의 강점은 일부 평가에서 확인된 낮은 작업 비용이다. 내 업무에서도 품질이 유지되는지 작은 평가부터 확인하자.
여기까지 GPT-6 Sol과 Luna의 가격, 벤치마크 원자료, 정렬 평가, 그리고 모델 선택 기준을 살펴보았다.
모델 전환을 고민하시는 분들께 도움이 되었길 바라며, 다음 포스팅에서 또 재미있는 기술 소식으로 찾아오겠다. 감사합니다. : )
소중한 공감 감사합니다